부분최소제곱 (PLS)
개요
부분최소제곱(PLS)은 지도 차원축소 방법이다. PCR이 설명변수의 분산만 보고 성분을 만드는 것과 달리, PLS는 설명변수와 반응변수의 공분산을 최대화하는 성분을 만든다.
PCR과의 결정적 차이
| PCR | PLS | |
|---|---|---|
| 성분 구성 | 비지도: \(X\)의 분산 최대화 | 지도: \(X\)와 \(y\)의 공분산 최대화 |
PLS 알고리즘
1단계: 설명변수와 반응변수의 표준화
2단계: 잠재성분의 반복적 구성
주성분을 한꺼번에 뽑는 PCR과 달리, PLS는 \(X\)와 \(y\)의 공분산을 최대화하며 성분을 순차적으로 만든다.
실제로 \(w_1\)은 \(X_{\text{scaled}}^\top y_{\text{centered}}\)에 비례한다. 즉 각 설명변수와 반응변수의 상관에 비례하는 가중치다.
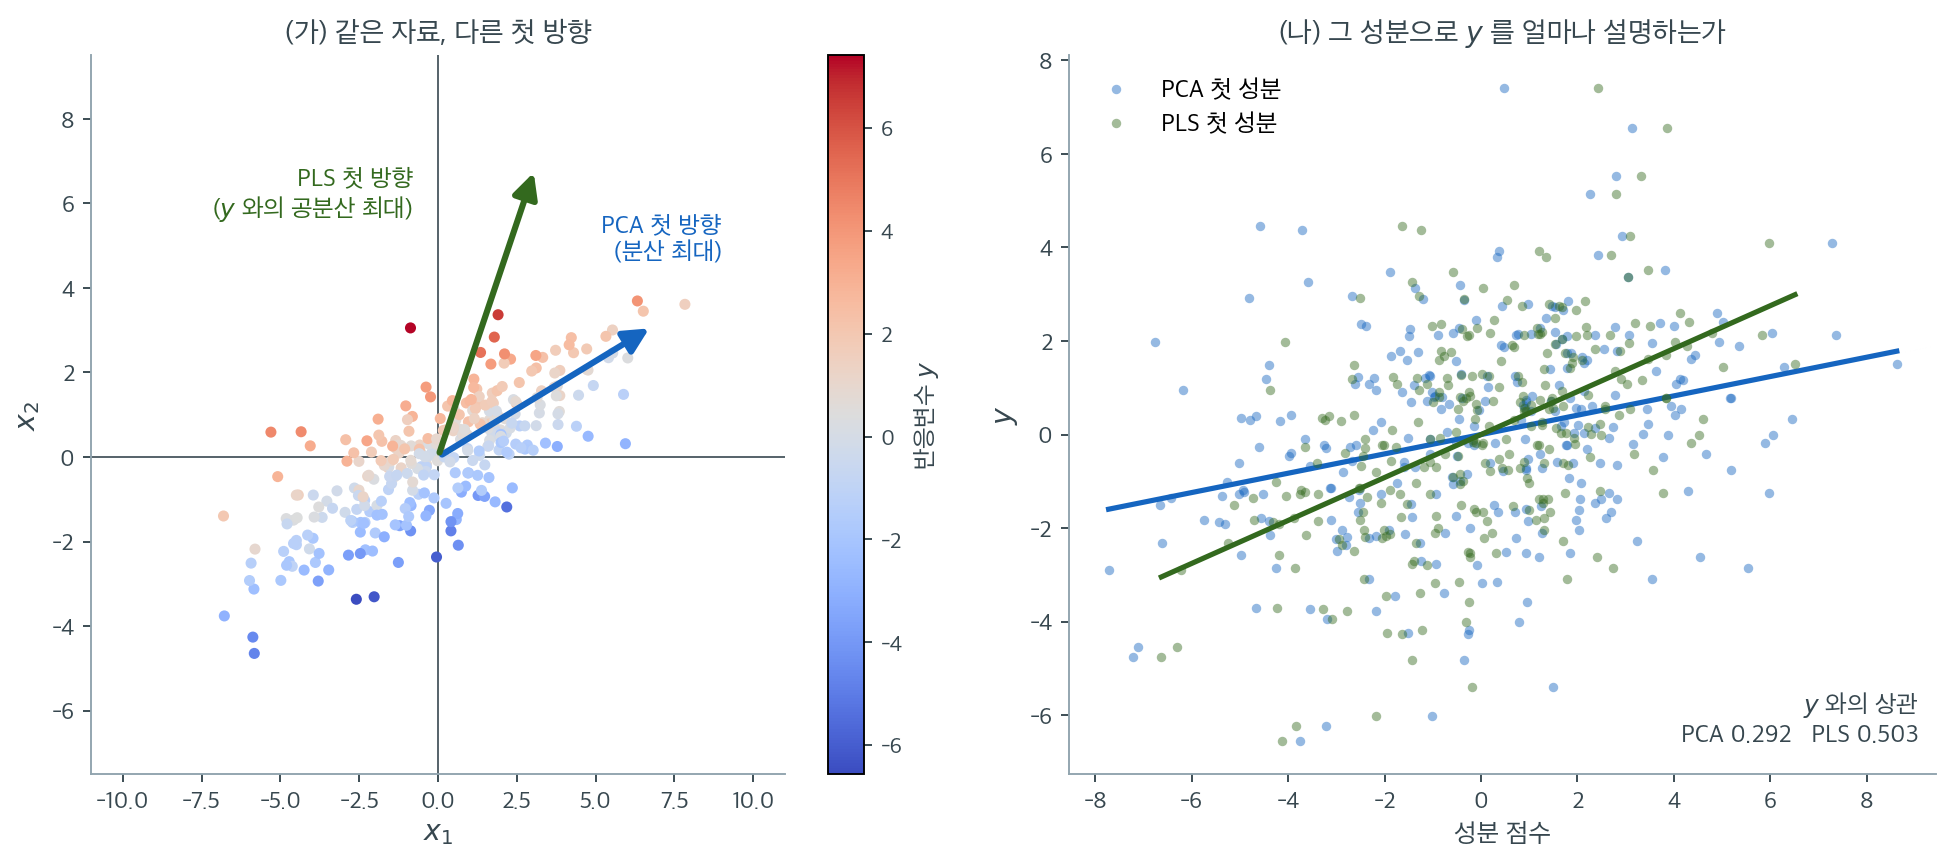
설명변수가 둘뿐인 자료로 두 방향을 한 그림에 그렸다. 점의 색이 반응변수 \(y\)의 값이다. 자료는 오른쪽 위로 길게 늘어져 있고, 그 긴 방향이 분산이 가장 큰 방향이다. PCA는 그 방향 \((0.911,\ 0.413)\)을 첫 성분으로 고른다(파란 화살표).
그런데 색의 배치를 보라. 빨간 점과 파란 점은 긴 방향을 따라 섞여 있고, 오히려 그 방향을 가로지르는 쪽으로 색이 갈린다. \(y\)의 신호가 분산이 작은 방향에 숨어 있는 것이다. PLS가 고르는 방향 \((0.411,\ 0.912)\)(초록 화살표)이 바로 색이 변하는 쪽을 가리킨다. 두 방향의 각도는 \(41.3^\circ\)나 된다.
오른쪽은 그 결과다. PCA 성분의 분산은 \(9.14\)로 PLS 성분의 \(5.47\)보다 \(1.7\)배 크지만, \(y\)와의 상관은 \(0.292\)로 PLS의 \(0.503\)보다 훨씬 작다. 분산이 크다는 것과 예측에 쓸모 있다는 것은 다른 이야기다. 회귀선의 기울기 차이가 그대로 설명력의 차이다.
이것이 PCR의 근본적 약점이며 PLS의 존재 이유다. PCA의 첫 방향은 \(\mathbf{X}^\top\mathbf{X}\)의 최대 고유벡터로 \(\mathbf{y}\)가 식에 들어가지 않는다. PLS의 첫 방향은 \(\mathbf{X}^\top\mathbf{y}\) 그 자체다. 다만 \(\mathbf{X}^\top\mathbf{y}\)는 각 변수와 \(y\)의 주변 관계만 보므로, 다른 변수를 조건으로 할 때만 드러나는 구조는 첫 성분에서 놓친다. 성분을 여럿 쓰는 이유가 거기에 있다.
이후 성분은 잔차에 대해 같은 과정을 반복한다.
- \(T_m\)으로 \(X\)를 설명한 부분을 제거한다(수축, deflation)
- \(T_m\)으로 \(y\)를 설명한 부분을 제거한다
- 잔차 \(X^{(m)}\)과 \(y^{(m)}\)의 공분산을 최대화하는 \(w_m\)을 구성한다
이 반복적 수축이 각 성분으로 하여금 이전 성분이 설명하지 못한 \(y\)의 변동을 담게 한다.
3단계: PLS 성분에 회귀
4단계: 교차검증으로 성분 수 선택
NIPALS 알고리즘
비선형 반복 부분최소제곱(NIPALS)이 표준 계산 방법이다.
X̃ = X_scaled,  ỹ = y_centered
m = 1..M 에 대해:
   a. w_m = X̃' ỹ / ||X̃' ỹ||        (가중벡터)
   b. t_m = X̃ w_m                   (성분 점수)
   c. β_m = t_m' ỹ / (t_m' t_m)     (회귀계수)
   d. ỹ = ỹ - β_m t_m               (y 잔차 수축)
   e. p_m = X̃' t_m / (t_m' t_m)     (적재)
   f. X̃ = X̃ - t_m p_m'             (X 잔차 수축)
각 반복이 행렬-벡터 곱만 쓰므로 성분당 \(O(np)\)로 효율적이다.
장점과 단점
장점
- 지도학습 — 성분이 반응변수를 예측하도록 선택된다
- 적은 성분 — PCR보다 적은 성분으로 같은 성능에 도달하는 경우가 많다
- 고차원에 강함 — \(p \gg n\)에서도 잘 작동한다
- \(X\)–\(y\) 공분산 구조 반영
- 실무 검증 — 화학계량학에서 수십 년간 검증되었다
- 계산 효율 — NIPALS가 반복적이고 효율적이다
단점
- 해석 가능성 — 성분이 여전히 원 변수의 선형결합이다
- 이론의 미비 — OLS보다 점근 결과가 적다
- 표준화 의존 — 표준화가 필요하고 결과에 영향을 준다
- 성분 수 조정 필요
- 과적합이 빠르다 — \(y\)를 이미 썼으므로 성분을 늘릴 때 PCR보다 빨리 나빠진다
PLS, PCR, 능형, 라쏘의 비교
| 방법 | 접근 | \(y\) 사용 | 희소성 | 주 용도 |
|---|---|---|---|---|
| 능형 | 계수 축소 | 아니오(벌점에서) | 없음 | 다중공선성 |
| 라쏘 | 계수 축소 + 선택 | 아니오(벌점에서) | 있음 | 변수선택 |
| PCR | 차원축소 | 아니오 | 없음 | \(p \gg n\) |
| PLS | 차원축소 | 예 | 없음 | \(p \gg n\), 예측 |
언제 PLS를 쓰는가
- 설명변수가 매우 많고 강하게 상관되어 있다(분광 자료, 센서 배열, 유전자 발현)
- 예측 정확도가 개별 계수 해석보다 중요하다
- \(p > n\)이다
- 신호가 \(X\)의 주된 분산 방향에 있지 않을 수 있다
실무적 고려
전처리. 설명변수와 반응변수를 모두 표준화한다. sklearn.cross_decomposition.PLSRegression은 기본적으로 scale=True이다.
초모수 조정. 성분 수를 교차검증으로 고른다. 대개 1부터 \(\min(n, p)\)까지 훑는다.
모형 검증. 성분 수를 CV로 골랐다면 그 CV 오차를 최종 성능으로 보고하지 말고 별도의 검정집합을 써야 한다.
연습문제
연습문제 1. PLS의 첫 가중벡터가 \(X^\top y\)에 비례한다는 사실을 확인하고, 그것이 무엇을 뜻하는지 설명하라.
풀이
제약 \(\|w\| = 1\) 아래에서 \(\text{Cov}(Xw, y) \propto w^\top X^\top y\)를 최대화하는 문제다. 코시-슈바르츠 부등식에 의해 최대는 \(w\)가 \(X^\top y\)와 같은 방향일 때 달성되므로
이다.
import numpy as np
from sklearn.cross_decomposition import PLSRegression

rng = np.random.default_rng(0)
n, p = 100, 8
X = rng.normal(0, 1, (n, p))
y = X @ np.array([2., -1., 0.5, 0, 0, 0, 0, 0]) + rng.normal(0, 1, n)

Xc = X - X.mean(0); yc = y - y.mean()
pls = PLSRegression(1, scale=False).fit(Xc, yc)
w = (Xc.T @ yc); w /= np.linalg.norm(w)
print(f"{np.abs(np.abs(pls.x_weights_[:, 0] @ w) - 1):.2e}")   # 0 에 가깝다
출력:
6.66e-16
해석. \(X^\top y\)의 \(j\)번째 성분은 \(\mathbf{x}_j^\top\mathbf{y}\), 즉 변수 \(j\)와 반응변수의 (중심화된) 내적이다. 따라서 첫 PLS 성분은 각 변수를 \(y\)와의 상관 크기에 비례하는 가중치로 더한 것이다.
이것이 PCR과의 차이를 가장 선명하게 보여준다. PCA의 첫 성분은 \(X^\top X\)의 최대 고유벡터로 \(y\)가 전혀 들어가지 않는다. PLS의 첫 성분은 \(X^\top y\)로 \(y\)가 직접 들어간다.
주의할 점: 이 가중치는 주변 상관에 기반하므로, 다른 변수를 조건부로 한 부분상관은 반영하지 않는다. 그래서 PLS도 억제변수(suppressor) 같은 구조는 첫 성분에서 놓칠 수 있고, 그것이 성분을 여럿 쓰는 이유다.
연습문제 2. PLS의 성분 수를 늘릴 때 PCR보다 빨리 과적합하는 현상을 확인하고 그 이유를 설명하라.
풀이
PCR과 PLS 개관 연습문제 1의 표를 성분 수에 따라 다시 읽으면 된다.
| 성분 수 | PCR \(R^2\) | PLS \(R^2\) |
|---|---|---|
| 1 | 0.428 | 0.806 |
| 2 | 0.548 | 0.844 (정점) |
| 3 | 0.849 (정점) | 0.837 |
| 5 | 0.845 | 0.794 |
| 7 | 0.837 | 0.746 |
PLS는 정점 이후 \(0.844 \to 0.746\)으로 12%p 떨어지고, PCR은 \(0.849 \to 0.837\)로 1%p만 떨어진다.
이유. PLS의 성분은 \(y\)를 써서 만들어진다. 성분을 하나 추가할 때마다 \(y\)의 잔차와 \(X\)의 잔차의 공분산을 최대화하는데, 신호가 이미 소진되면 그 공분산은 잡음에서 오는 우연한 상관이다. 성분이 잡음에 맞춰지므로 표본외 성능이 빠르게 나빠진다.
PCR의 성분은 \(y\)를 보지 않으므로 이런 방식으로 잡음에 적합되지 않는다. 성분을 추가하면 단지 잡음 방향을 회귀에 넣는 것이고, 그 효과는 자유도 하나를 쓰는 정도로 완만하다.
실무적 함의: PLS에서 성분 수 선택은 PCR에서보다 더 중요하다. 그리고 그 선택에 쓴 CV 오차를 최종 성능으로 보고하면 낙관적으로 편향된다. 별도의 검정집합이나 중첩 교차검증이 필요하다.
정리하며
PLS는 설명변수와 반응변수의 공분산을 최대화하는 성분을 구성하는 지도 차원축소 방법이다. 성분을 만들 때 \(y\)를 쓰므로 PCR보다 적은 성분으로 같은 예측 성능에 도달하는 경우가 많다. NIPALS 알고리즘이 효율적인 계산을 제공한다. 대가는 과적합이 더 빠르다는 것이며, 성분 수를 반드시 교차검증으로 정해야 한다.