지도학습
지도학습은 레이블이 붙은 입력–출력 쌍으로 모형을 훈련시켜, 레이블이 없는 새 입력에 대해 출력을 예측하게 한다. 목표 — \(\mathbf{x}\)로부터 \(y\)를 예측한다 — 가 명확하고, 손실을 관측할 수 있으며, 성공 기준이 모호하지 않기 때문에 현대 자료 분석에서 지배적인 패러다임이다. 신용평가, 수요예측, 부정 탐지, 의료 진단, 기계 번역, 그리고 대부분의 이미지 인식 시스템이 내부적으로는 지도학습기다.
정의 1. 지도학습
\((\mathbf{X}, Y)\)가 \(\mathbf{X} \in \mathcal{X} \subseteq \mathbb{R}^p\), \(Y \in \mathcal{Y}\)인 결합분포를 갖는 확률변수라고 하자. 이 결합분포에서 i.i.d.로 뽑은 훈련 표본 \(\mathcal{D}_n = \{(\mathbf{x}_i, y_i)\}_{i=1}^n\)을 관측하고, 기대손실(또는 위험)
을 최소화하는 함수 \(\hat{f} : \mathcal{X} \to \mathcal{Y}\)를 찾는다. 여기서 \(L : \mathcal{Y} \times \mathcal{Y} \to \mathbb{R}_{\ge 0}\)은 문제에 따라 정해지는 손실함수다. 두 가지 표준 과제는 \(Y\)의 유형에 따라 갈린다.
- 회귀: \(\mathcal{Y} = \mathbb{R}\). 표준 손실은 제곱오차 \(L(y, \hat{y}) = (y - \hat{y})^2\)이며, 그 위험 최소화 함수는 조건부 평균 \(f^*(\mathbf{x}) = \mathbb{E}[Y \mid \mathbf{X} = \mathbf{x}]\)이다.
- 분류: \(\mathcal{Y} = \{1, \ldots, K\}\). 표준 손실은 0–1 손실 \(L(y, \hat{y}) = \mathbf{1}\{y \ne \hat{y}\}\)이며, 그 위험 최소화 함수는 베이즈 분류기 \(f^*(\mathbf{x}) = \arg\max_k P(Y = k \mid \mathbf{X} = \mathbf{x})\)이다.
\(R(f)\)는 알려지지 않은 결합분포에 의존하므로, 이를 경험위험
으로 대체하고 선택한 가설 공간 \(\mathcal{F}\) 위에서 최소화한다. 이 절차를 경험위험 최소화(ERM)라 한다.
두 과제, 하나의 틀
정의 1은 회귀와 분류를 한 문장으로 묶어 놓았다. 둘이 정말로 같은 틀인지 보려면 나란히 그려 보는 것이 빠르다. 아래 두 그림은 서로 다른 모의자료에 똑같은 절차를 적용한 것이다. 레이블이 붙은 훈련자료로 \(\hat f\) 를 적합하고, 떼어놓은 시험자료로 채점하고, 정답을 모르는 새 입력 \(x^*\) 에 쓴다.
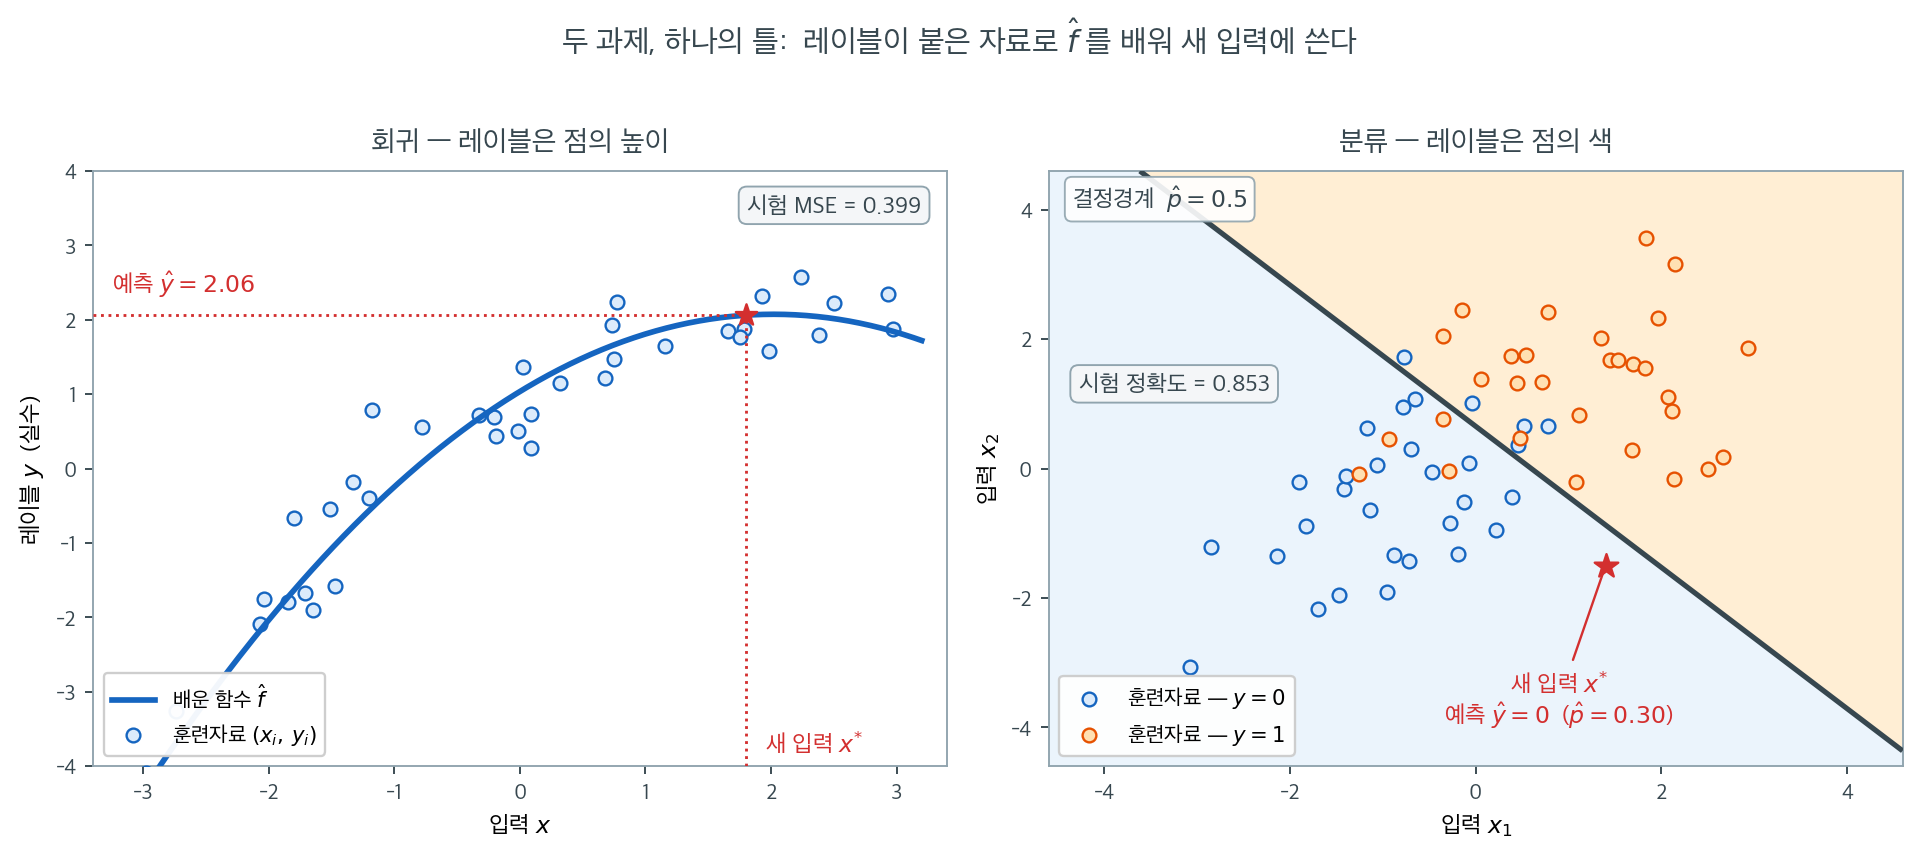
바뀐 것은 레이블 \(y\) 가 무엇이냐 하나뿐이다. 왼쪽에서 레이블은 실수여서 점의 높이로 나타나고, 오른쪽에서 레이블은 범주여서 점의 색으로 나타난다. 그래서 배운 함수 \(\hat f\) 가 왼쪽에서는 자료를 가로지르는 곡선으로 보이고 오른쪽에서는 두 색을 가르는 경계선으로 보인다. 생긴 모습이 다를 뿐, 둘 다 입력공간의 모든 점에 출력을 하나씩 붙이는 함수다.
성적표의 모양도 레이블을 따라간다. 왼쪽은 제곱오차를 평균해 시험 MSE \(0.399\) 를 얻었고, 오른쪽은 0–1 손실을 평균해 시험 정확도 \(0.853\) 을 얻었다. 왼쪽의 \(0.399\) 는 사실상 더 내려갈 데가 없는 값이다. 자료를 만들 때 넣은 잡음의 분산이 \(\sigma^2 = 0.36\) 이므로 아무리 좋은 \(\hat f\) 라도 그 아래로는 갈 수 없다. 두 숫자는 서로 비교할 수 없지만, 둘 다 손실을 시험자료에서 평균한 \(\hat R_n\) 이라는 점에서 같은 종류의 물건이다.
별표로 표시한 \(x^*\) 가 이 틀의 목적지다. 왼쪽에서는 \(\hat y = 2.06\) 이라는 실수를 내놓고(자료를 만든 참 평균은 \(1.81\) 이다), 오른쪽에서는 \(\hat p = 0.30\) 을 문턱 \(0.5\) 와 비교해 \(\hat y = 0\) 이라는 범주를 내놓는다. 이 점에는 채점할 정답이 없다. 지도학습이 쉬운 것은 정답이 늘 있어서가 아니라, 정답이 붙은 자료를 미리 충분히 모아 두었으므로 정답이 없는 곳에서 쓸 함수를 그 자료로 골라낼 수 있기 때문이다.
편향–분산 분해
지도학습의 근본적인 긴장은 편향–분산 분해로 포착된다. 고정된 점 \(\mathbf{x}_0\)에서 제곱오차 회귀에 대해,
가 성립한다. 기댓값은 훈련 표본 \(\mathcal{D}_n\) 과 \(\mathbf{x}_0\) 에서 새로 관측되는 \(Y\) 양쪽에 대해 취한 것이다. 세 항 가운데 마지막 것은 어떤 방법으로도 줄일 수 없다. \(\sigma^2 = \mathrm{Var}(Y \mid \mathbf{X} = \mathbf{x}_0)\) 은 자료생성 과정 자체의 잡음이므로, 설령 \(f^*\) 를 정확히 알아낸다 해도 예측오차는 \(\sigma^2\) 에서 멈춘다. 편향과 분산만 적어 놓고 "오차를 \(0\) 으로 보낼 수 있다"고 읽는 것이 이 분해에서 가장 흔한 오독이다(6.1절 추정량의 품질에서 다시 다룬다).
단순한 모형(선형회귀, 얕은 트리)은 편향이 크고 분산이 작다. 유연한 모형(심층 신경망, 큰 앙상블)은 편향이 작고 분산이 크다. 지도학습의 기예는 주어진 표본 크기에서 편향과 분산이 유리하게 맞바뀌도록 모형 복잡도를 고르는 데 있다.
작업 흐름
- 자료 분할: 훈련 / 검증 / 시험(예: 60/20/20), 또는 훈련+검증 부분에 \(k\)-겹 교차검증 적용(13.8절, 18.5절).
- 모형 족 \(\mathcal{F}\) 선택: 선형, 트리 기반, 커널 기반, 신경망, 앙상블.
- ERM으로 적합: 경험위험을 최소화하되, 복잡도를 제어하기 위해 흔히 정칙화 벌점 \(\lambda \cdot \Omega(f)\)를 더한다(18장).
- 초모수 조정(벌점 강도, 트리 깊이, 학습률): 검증 자료에서 수행.
- 시험 자료에서 평가 — 모든 모형 결정을 확정한 뒤 정확히 한 번만 쓴다.
- 배포 후 모니터링: 분포 이동을 감시한다.
세 덩어리의 역할은 서로 바꿔 쓸 수 없다. 훈련자료는 \(\hat f\) 의 모수를 정하고, 검증자료는 모형과 초모수를 고르며, 시험자료는 이미 확정된 하나의 \(\hat f\) 를 채점할 뿐이다. 검증자료에서 가장 좋았던 점수를 그대로 최종 성능으로 보고하면, 여러 후보 가운데 최댓값을 고른 만큼 선택 편의가 섞여 낙관적인 값이 된다. 얼마나 부풀려지는지는 연습문제 8에서 수치로 확인한다. 시험자료를 보고 모형을 손보는 순간 그것은 더 이상 시험자료가 아니라 또 하나의 검증자료가 된다.
지도학습이 사촌들보다 쉬운 이유
비지도학습과 강화학습에 비해 지도학습 문제는 세 가지 구조적 이점을 누린다.
- 관측 가능한 손실: 모든 예측에 비교할 참값 레이블이 있으므로 \(\hat{R}_n(f)\)를 계산할 수 있다.
- 독립적인 지도 신호: 각 \((\mathbf{x}_i, y_i)\)가 자체적인 학습 신호를 제공하며, 강화학습에서와 같은 시간적 공로 배분 문제가 없다.
- 정직한 평가: 훈련 중 정보가 새지 않는 한, 떼어놓은 시험 자료가 일반화 오차의 불편추정값을 준다.
다만 세 이점 모두 시험 자료가 배포 환경과 같은 분포에서 왔다는 전제 위에 서 있다. 시험 분포가 훈련 분포와 다르거나(공변량 이동, 개념 이동) 레이블 자체가 체계적으로 편향되면 그 전제가 깨진다. 이때 지도학습은 소리 없이 실패한다. 손실을 관측할 수 있다는 바로 그 사실이 안심을 주는 탓에, 지표는 여전히 좋아 보이는데 현장에서만 틀린다.
보기 1. 지도학습. 대출 \(1{,}000\)건의 연체를 맞히는 이진 분류다. 참 로그오즈가 \(-3 + 0.01(50-\text{소득}) + 5(\text{dti}-0.3)\)이고, 앞 \(700\)건으로 로지스틱 회귀를 적합해 뒤 \(300\)건에서 평가한다.
(1) 참 로그오즈를 절편·소득·dti의 계수로 다시 적으시오. 적합된 계수가 그 세 값과 맞는가.
(2) "아무것도 연체하지 않는다"고만 답하는 모형의 시험 정확도는 얼마인가. 적합한 모형과 견주시오.
풀이
(1) 해석적으로. 괄호를 풀어 정리하면
이므로 참 계수는 \((\beta_0, \beta_{\text{소득}}, \beta_{\text{dti}}) = (-4.0,\ -0.01,\ 5.0)\)이다.
(2) 해석적으로. 시험자료의 연체율을 \(\bar d\)라 하면 언제나 "연체 없음"이라 답하는 모형의 정확도는 정확히 \(1 - \bar d\)다. 이 수가 어떤 분류기도 넘어야 할 바닥이며, 희귀사건 자료에서는 그 바닥이 \(0.95\)를 넘는 일이 흔하다.
(1)(2) 수치적으로.
import numpy as np
from scipy.optimize import minimize
from scipy.special import expit  # logistic function

np.random.seed(42)
n = 1000

# === 자료 생성: 대출 연체를 맞히는 이진 분류 문제 ===
# 설명변수 둘을 만든다.
#   income  연소득(천 달러). clip(10)으로 하한을 둔다
#   dti     소득 대비 부채 비율(debt-to-income). 0.01~1.0으로 자른다
income = np.random.normal(60, 20, n).clip(10)
dti = np.random.normal(0.3, 0.15, n).clip(0.01, 1.0)

# 참 구조를 로그오즈로 적는다.
#   소득이 낮을수록(50 - income이 클수록) 연체 확률이 오르고
#   부채비율이 높을수록(dti - 0.3이 클수록) 크게 오른다
log_odds = -3 + 0.01 * (50 - income) + 5 * (dti - 0.3)

# expit(z) = 1/(1+e^{-z}). 로그오즈를 0~1 사이 확률로 바꾼다.
prob = expit(log_odds)

# 각자 자기 확률로 동전을 던져 실제 연체 여부(정답 레이블)를 정한다
default = np.random.binomial(1, prob)

# === 훈련/시험 분할 ===
# 앞 700개로 배우고 뒤 300개로 평가한다.
# 지도학습의 성적은 반드시 **보지 않은 자료**에서 재야 한다.
train, test = np.arange(700), np.arange(700, n)
X = np.column_stack([np.ones(n), income, dti])   # 절편 열을 앞에 붙인다

# === 적합: 음의 로그가능도를 최소화한다 ===
def neg_log_lik(beta):
    """로지스틱 회귀의 음의 로그가능도.

    한 관측의 로그가능도는  y*z - log(1 + e^z)  이다 (z는 로그오즈).
    log1p(exp(z))는 log(1+exp(z))를 수치적으로 안정하게 계산한다.
    최소제곱과 달리 닫힌 해가 없어 수치 최적화가 필요하다.
    """
    z = X[train] @ beta
    return -np.sum(default[train] * z - np.log1p(np.exp(z)))

# BFGS: 기울기를 근사해 내려가는 준뉴턴법
result = minimize(neg_log_lik, np.zeros(3), method="BFGS")
beta_hat = result.x

# === 평가: 시험자료에서의 정확도 ===
probs_test = expit(X[test] @ beta_hat)   # 예측 확률
preds = (probs_test > 0.5).astype(int)   # 0.5를 문턱으로 0/1 판정
accuracy = np.mean(preds == default[test])
print(f"Test accuracy:        {accuracy:.3f}")
print(f"Default rate (test):  {default[test].mean():.3f}")
print(f"Coefficients:         {beta_hat.round(4)}")

# --- (1)(2) 의 이론값과 맞추어 본다 ---
beta_true = np.array([-4.0, -0.01, 5.0])
p_hat = expit(X[train] @ beta_hat)
info = X[train].T @ (X[train] * (p_hat * (1 - p_hat))[:, None])
se = np.sqrt(np.diag(np.linalg.inv(info)))
print(f"참 계수:              {beta_true}")
print(f"SE:                   {se.round(4)}")
print(f"z (추정 - 참)/SE:     {((beta_hat - beta_true) / se).round(2)}")
print(f"훈련 연체 수 {default[train].sum()} / 700,  시험 연체 수 {default[test].sum()} / 300")
print(f"모형이 '연체'로 판정한 시험 건수: {preds.sum()}")
print(f"'연체 없음'만 답하는 모형의 정확도: {1 - default[test].mean():.3f}")
출력:
Test accuracy:        0.957
Default rate (test):  0.043
Coefficients:         [-3.6561 -0.0273  6.0932]
참 계수:              [-4.   -0.01  5.  ]
SE:                   [0.7291 0.0094 1.2631]
z (추정 - 참)/SE:     [ 0.47 -1.84  0.87]
훈련 연체 수 37 / 700,  시험 연체 수 13 / 300
모형이 '연체'로 판정한 시험 건수: 0
'연체 없음'만 답하는 모형의 정확도: 0.957
계수는 세 개 모두 참값과 맞는다. \(z\) 값이 \(0.47\), \(-1.84\), \(0.87\)로 전부 \(2\) 안이다. 소득 계수의 추정값 \(-0.0273\)이 참값 \(-0.01\)의 세 배처럼 보이지만, 표준오차가 \(0.0094\)라 \(1.84\) 표준오차 차이일 뿐이다. 훈련자료 \(700\)건에 연체가 \(37\)건뿐이니 이만한 불확실성은 당연하다.
정확도 쪽은 사정이 전혀 다르다. 모형의 시험 정확도 \(0.957\)과 "연체 없음"만 답하는 모형의 정확도 \(0.957\)이 소수 셋째 자리까지 같다. 같을 수밖에 없다. 모형이 시험 \(300\)건 가운데 "연체"로 판정한 것이 단 한 건도 없기 때문이다. 예측 확률이 전부 \(0.5\) 아래였고, 그래서 두 모형이 내놓은 판정이 글자 그대로 동일하다.
여기서 갈라 보아야 할 것이 있다. 모형은 좋고 평가가 나쁘다. 계수 셋이 모두 참값과 맞으니 모형은 자료생성과정을 제대로 배웠다. 다만 문턱 \(0.5\)가 연체율 \(4\%\)짜리 자료에 맞지 않을 뿐이다. 문턱을 낮추거나, 정밀도·재현율·ROC-AUC처럼 문턱에 의존하지 않는 지표를 쓰거나, 거짓양성과 거짓음성의 비용 차이를 반영해야 한다.
클래스가 불균형할 때 정확도만 보면 오도된다. 대출의 10%만 부도가 난다면 "부도 없음"이라고만 답하는 모형도 정확도가 90%가 될 수 있다. 실제 평가에는 정밀도, 재현율, ROC-AUC, 또는 거짓양성과 거짓음성의 비대칭적 비용을 반영한 비용가중 손실이 필요하다(19.3절 모형 평가). 연습문제 9에서 수치로 확인한다.
연습문제
연습문제 1. 다음 각 과제를 지도학습, 비지도학습, 강화학습으로 분류하고, 지도학습이라면 회귀인지 분류인지 밝혀라.
(a) 과거 가격과 거래량 자료로 내일의 주식 종가를 예측하기. (b) 미리 정해진 범주 없이 구매 행동에 따라 고객을 세그먼트로 묶기. (c) 출구에 도달하면 보상하고 충돌하면 벌점을 주어 로봇에게 미로 탐색을 가르치기. (d) 레이블이 붙은 받은편지함으로 이메일을 스팸인지 아닌지 분류하는 모형 훈련하기. (e) 레이블이 붙은 부정 사례가 전혀 없을 때 이상 신용카드 거래 탐지하기. (f) 어떤 환자가 앞으로 1년간 재입원할 횟수 추정하기.
풀이
(a) 지도학습 — 회귀(연속형 목표). (b) 비지도학습 — 군집화, 레이블 없음. (c) 강화학습 — 보상에 이끌리는 순차적 의사결정. (d) 지도학습 — 이진 분류. (e) 비지도학습 — 레이블 없는 이상치 탐지(레이블이 일부 있다면 준지도학습일 수 있다). (f) 지도학습 — 계수형 회귀(포아송 회귀가 자연스러운 선택이다).
연습문제 2. \(L(y, \hat{y}) = (y - \hat{y})^2\)을 제곱오차 손실이라 하자. 모든 가측 함수 \(f\) 위에서 위험 \(R(f) = \mathbb{E}[L(Y, f(\mathbf{X}))]\)을 최소화하는 함수 \(f^*\)가 \(f^*(\mathbf{x}) = \mathbb{E}[Y \mid \mathbf{X} = \mathbf{x}]\)임을 보여라.
풀이
\(\mathbf{X} = \mathbf{x}\)로 조건을 걸고 점별로 최소화한다. 고정된 \(\mathbf{x}\)에 대해 \(\mathbb{E}[(Y - c)^2 \mid \mathbf{X} = \mathbf{x}]\)을 최소화하는 \(c \in \mathbb{R}\)을 찾는다. 전개하면
첫 항은 \(c\)에 의존하지 않고, 둘째 항은 \(c = \mathbb{E}[Y \mid \mathbf{X} = \mathbf{x}]\)에서 최소가 된다. 이것이 모든 \(\mathbf{x}\)에 대해 성립하므로 전역 최소화 함수는 \(f^*(\mathbf{x}) = \mathbb{E}[Y \mid \mathbf{X} = \mathbf{x}]\)이다. \(\square\)
연습문제 3. \(K\)-클래스 분류에서 0–1 손실에 대해, 베이즈 분류기 \(f^*(\mathbf{x}) = \arg\max_k P(Y = k \mid \mathbf{X} = \mathbf{x})\)가 기대 오분류율을 최소화함을 보여라.
풀이
임의의 분류기 \(f\)에 대해
이다. 이를 점별로 최소화하려면 \(f(\mathbf{x}) \in \{1, \ldots, K\}\) 위에서 \(P(Y = f(\mathbf{x}) \mid \mathbf{X} = \mathbf{x})\)를 최대화해야 하며, 그 결과 \(f^*(\mathbf{x}) = \arg\max_k P(Y = k \mid \mathbf{X} = \mathbf{x})\)가 선택된다. \(\mathbf{X}\)에 대해 적분하면 전역 최솟값을 얻는다. \(\square\)
연습문제 4. 어떤 은행이 2015–2019년 신청자 자료로 신용평가 모형을 학습시켜 떼어놓은 2019년 표본에서 92%의 시험 정확도를 얻었다. 2024년에 배포하자 정확도가 71%에 그쳤다. 이 하락을 설명할 수 있는 서로 다른 기제 세 가지와 각각에 대한 진단 방법을 제시하라.
풀이
- 공변량 이동: \(\mathbf{X}\)의 분포가 변했다(예: 팬데믹 이후 소득 분포). 진단: KS 검정이나 PSI(모집단 안정성 지수)로 훈련 자료와 2024년 자료의 특성 주변분포를 비교한다.
- 개념 이동: 조건부 \(P(Y \mid \mathbf{X})\)가 변했다(부도 행동이 새로운 경제 여건에 반응한다). 공변량 분포만 변한 것이 아니므로 재가중으로는 고칠 수 없다. 진단: 최근 레이블 자료로 모형을 다시 적합해 계수나 변수 중요도를 비교한다.
- 훈련 중 자료 누출: 배포 시점에는 쓸 수 없는 특성이 훈련에 사용되었다(예: 실제로는 부도 이후에 기록된 "현재 잔액"). 진단: 특성 파이프라인을 감사하고 결정 시점 이전의 특성만으로 재학습한다.
그 밖에 타당한 기제로는 피드백 루프(모형 자신의 결정이 신청자 구성을 바꿈), 원래 훈련 자료의 표집편향, 레이블 품질 변화("부도"의 정의가 개정됨) 등이 있다.
연습문제 5. 같은 자료에 두 회귀 모형을 적합했다. - 모형 A: 선형회귀, 훈련 MSE \(= 12\), 시험 MSE \(= 15\). - 모형 B: 심층 신경망, 훈련 MSE \(= 2\), 시험 MSE \(= 25\).
편향–분산 분해를 사용해 각 모형의 특징을 규정하라. 어느 것을 배포하겠으며, 다음으로 무엇을 시도하겠는가?
풀이
모형 A는 훈련 오차가 크고 시험 오차는 그보다 조금 클 뿐이다. 과소적합(높은 편향, 낮은 분산) 상태다. 가설 공간이 지나치게 제한적이다.
모형 B는 시험 자료보다 훈련 자료를 훨씬 잘 적합한다. 과적합(낮은 편향, 높은 분산) 상태이며 잡음을 외운 것이다.
모형 A를 배포한다. MSE 15는 일반화되는 값인 반면, 모형 B의 훈련 MSE 2는 허상이다. 다음 단계로는 중간 정도 유연성의 모형(그래디언트 부스팅 트리, 정칙화된 신경망, 커널 능형회귀)을 시도하거나, 모형 B에 정칙화·조기 종료·자료 증강을 적용해 분산을 줄인다.
연습문제 6. 모형을 자신의 훈련 자료로 평가하면 왜 위험을 지나치게 낙관적으로 추정하게 되는가? \(\hat{f}\)가 \(\hat{R}_n\)을 최소화하도록 선택되었을 때 \(\hat{R}_n(\hat{f})\)와 \(R(\hat{f})\)의 관계로 답을 형식화하라.
풀이
훈련 자료는 두 역할을 한다. 추정량 \(\hat{f}\)를 결정하고(\(\mathcal{F}\) 위에서 \(\hat{R}_n\)을 최소화하도록 선택된다), 그다음 \(\hat{R}_n(\hat{f})\)를 계산하는 데 다시 쓰인다. \(\hat{f}\)가 \(\hat{R}_n\)을 가능한 한 작게 만들도록 선택되었으므로 경험위험은 참된 위험을 과소평가한다.
등호는 \(\mathcal{F}\)가 함수 하나만 포함할 때만 성립한다. 이 격차가 훈련오차의 낙관성이며, \(\mathcal{F}\)의 실효 복잡도가 커질수록 커진다. 떼어놓은 시험 자료는 이 의존을 끊는다. 시험 자료는 \(\hat{f}\)를 고르는 데 쓰이지 않았으므로 \(\hat{R}_{\text{test}}(\hat{f})\)는 \(R(\hat{f})\)의 불편추정값이다. 정직한 평가를 위해 훈련/시험 분할(또는 교차검증)이 타협할 수 없는 이유가 이것이다. \(\square\)
연습문제 7. 본문의 편향–분산 분해를 모의실험으로 확인하라. 세 모형에 대해 편향², 분산, 잡음을 각각 추정하고 그 합이 실제 예측오차와 맞는지 보라.
풀이
고정된 점 \(x_0\)에서
이다. 각 항을 훈련 자료를 여러 번 새로 뽑아 추정한다.
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.tree import DecisionTreeRegressor

rng = np.random.default_rng(0)
f = lambda z: np.sin(1.5 * z)
x0 = np.linspace(-2, 2, 50)
sigma, B, n = 0.5, 800, 40

models = [("선형회귀", lambda: LinearRegression()),
          ("깊이 3 트리", lambda: DecisionTreeRegressor(max_depth=3, random_state=0)),
          ("완전 성장 트리", lambda: DecisionTreeRegressor(random_state=0))]

print(f"{'모형':>16}{'편향^2':>10}{'분산':>10}{'잡음':>9}{'합':>10}{'실제 MSE':>11}")
for label, make in models:
    preds = np.empty((B, len(x0)))
    mse = 0.0
    for b in range(B):
        X = rng.uniform(-2, 2, (n, 1))
        y = f(X[:, 0]) + rng.normal(0, sigma, n)
        preds[b] = make().fit(X, y).predict(x0.reshape(-1, 1))
        y0 = f(x0) + rng.normal(0, sigma, len(x0))       # 새 시험 관측
        mse += np.mean((preds[b] - y0) ** 2)
    bias2 = np.mean((preds.mean(0) - f(x0)) ** 2)
    var = np.mean(preds.var(0))
    print(f"{label:>16}{bias2:>10.4f}{var:>10.4f}{sigma ** 2:>9.4f}"
          f"{bias2 + var + sigma ** 2:>10.4f}{mse / B:>11.4f}")
출력:
              모형      편향^2        분산       잡음         합     실제 MSE
            선형회귀    0.1795    0.0232   0.2500    0.4527     0.4512
         깊이 3 트리    0.0020    0.1314   0.2500    0.3834     0.3840
        완전 성장 트리    0.0010    0.2553   0.2500    0.5063     0.5089
분해가 맞는다. 마지막 두 열이 소수점 둘째 자리까지 일치하며, 남은 차이(\(0.003\) 이하)는 \(B = 800\) 번의 반복에서 오는 몬테카를로 오차다.
| 모형 | 편향² | 분산 | 잡음 | 합 |
|---|---|---|---|---|
| 선형회귀 | \(\mathbf{0.180}\) | \(0.023\) | \(0.25\) | \(0.453\) |
| 깊이 \(3\) 트리 | \(0.002\) | \(0.131\) | \(0.25\) | \(\mathbf{0.383}\) |
| 완전 성장 트리 | \(0.001\) | \(\mathbf{0.255}\) | \(0.25\) | \(0.506\) |
세 모형이 정확히 다른 방식으로 실패하거나 성공한다.
- 선형회귀는 편향이 지배한다(\(0.180\)). \(\sin\)을 직선으로 근사할 수 없기 때문이며, 훈련 자료가 바뀌어도 추정이 거의 흔들리지 않아 분산은 \(0.023\)뿐이다.
- 완전 성장 트리는 분산이 지배한다(\(0.255\)). 편향은 거의 \(0\)이지만 훈련 자료의 잡음까지 따라가므로 표본이 바뀌면 예측이 크게 달라진다.
- 깊이 \(3\) 트리가 둘 사이에서 최적이다. 편향을 거의 없애면서 분산을 절반으로 눌렀다.
잡음 \(\sigma^2 = 0.25\)는 세 줄 모두에서 같다. 어떤 모형도 이 값 아래로 내려갈 수 없으며, 이것이 베이즈 오차다. 시험 MSE가 \(0.25\) 근처라면 개선의 여지가 거의 없다는 뜻이다.
주의: 이 분해는 제곱오차 손실에서만 이렇게 깔끔하다. 0–1 손실이나 교차엔트로피에서는 유사한 분해가 있지만 항들이 이렇게 단순히 더해지지 않는다. \(\square\)
연습문제 8. 연습문제 6의 낙관적 편향은 교차검증에도 적용된다. 초모수를 고르는 데 쓴 교차검증 점수를 성능 추정값으로 보고하면 어떻게 되는가?
풀이
import numpy as np
from sklearn.svm import SVC
from sklearn.model_selection import GridSearchCV, cross_val_score

rng = np.random.default_rng(1)
grid = {"C": [0.01, 0.1, 1, 10, 100], "gamma": [0.001, 0.01, 0.1]}

naive, nested = [], []
for _ in range(60):
    X = rng.normal(0, 1, (120, 20))
    y = rng.integers(0, 2, 120)                  # 특성과 아무 관계가 없다

    gs = GridSearchCV(SVC(), grid, cv=5).fit(X, y)
    naive.append(gs.best_score_)                 # 선택에 쓴 점수를 그대로 보고
    nested.append(cross_val_score(
        GridSearchCV(SVC(), grid, cv=5), X, y, cv=5).mean())   # 중첩 교차검증

print("신호가 전혀 없는 자료 (참 정확도 0.50)")
print(f"  선택에 쓴 CV 점수를 그대로 보고: {np.mean(naive):.4f}")
print(f"  중첩 교차검증:                   {np.mean(nested):.4f}")
출력:
신호가 전혀 없는 자료 (참 정확도 0.50)
  선택에 쓴 CV 점수를 그대로 보고: 0.5681
  중첩 교차검증:                   0.5214
참 정확도가 \(0.50\)인데 순진한 보고는 \(0.568\)을 준다. 자료에 아무 신호가 없는데도 \(7\)%포인트를 만들어 냈다. 중첩 교차검증은 \(0.521\)로 훨씬 정직하다.
왜 부풀려지는가. 연습문제 6의 논리가 그대로 적용된다. 초모수 조합 \(15\)개 각각에 대해 CV 점수를 계산한 뒤 최댓값을 골랐다. 최댓값은 평균보다 크며, 그 차이가 곧 낙관적 편향이다. \(\hat{R}\)을 최소화하도록 고른 것을 \(\hat{R}\)로 평가하면 언제나 이런 일이 생긴다.
조합이 많을수록 심해진다. 요즘 자동화된 초모수 탐색은 수백~수천 개 조합을 시도하는데, 그만큼 편향도 커진다.
중첩 교차검증의 구조.
- 바깥 루프: 자료를 \(K\)겹으로 나눠 성능을 평가한다.
- 안쪽 루프: 바깥 루프의 훈련 부분만으로 초모수를 고른다.
핵심은 바깥 시험 겹이 초모수 선택에 전혀 관여하지 않았다는 것이다. 계산 비용이 \(K\)배로 늘어나는 것이 대가다.
더 간단한 대안은 처음부터 자료를 셋으로 나누는 것이다. 훈련(적합), 검증(선택), 시험(단 한 번의 최종 평가). 시험 자료를 여러 번 들여다보는 순간 그것은 검증 자료가 되고, 보고된 성능은 다시 낙관적이 된다. \(\square\)
연습문제 9. 양성 비율이 \(1\%\)인 문제에서 정확도가 왜 무의미한지 보이고, 어떤 지표를 대신 써야 하는지 논하라.
풀이
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (accuracy_score, precision_score, recall_score,
                             roc_auc_score, average_precision_score)

rng = np.random.default_rng(0)
n = 50_000
y = (rng.random(n) < 0.01).astype(int)               # 양성 1%
x = (rng.normal(0, 1, n) + 1.5 * y).reshape(-1, 1)
tr, te = np.arange(35_000), np.arange(35_000, n)

proba = LogisticRegression().fit(x[tr], y[tr]).predict_proba(x[te])[:, 1]
pred = (proba > 0.5).astype(int)

print(f"항상 '음성'이라 답하는 모형의 정확도 {1 - y[te].mean():.4f}")
print(f"학습된 모형의 정확도                 {accuracy_score(y[te], pred):.4f}")
print(f"  정밀도 {precision_score(y[te], pred, zero_division=0):.4f}"
      f"   재현율 {recall_score(y[te], pred):.4f}")
print(f"  ROC-AUC {roc_auc_score(y[te], proba):.4f}"
      f"   PR-AUC {average_precision_score(y[te], proba):.4f}"
      f"  (무작위 기준 {y[te].mean():.4f})")

print("\n임계값을 낮추면")
for th in (0.5, 0.1, 0.05, 0.02):
    p = (proba > th).astype(int)
    print(f"  {th:>4}: 정밀도 {precision_score(y[te], p, zero_division=0):.4f}"
          f"   재현율 {recall_score(y[te], p):.4f}")
출력:
항상 '음성'이라 답하는 모형의 정확도 0.9895
학습된 모형의 정확도                 0.9896
  정밀도 0.6667   재현율 0.0127
  ROC-AUC 0.8779   PR-AUC 0.1714  (무작위 기준 0.0105)

임계값을 낮추면
   0.5: 정밀도 0.6667   재현율 0.0127
   0.1: 정밀도 0.2564   재현율 0.2548
  0.05: 정밀도 0.1184   재현율 0.4013
  0.02: 정밀도 0.0613   재현율 0.6943
정확도는 아무것도 말해 주지 않는다. 아무것도 학습하지 않고 전부 "음성"이라 답하면 \(0.9895\)이고, 학습된 모형은 \(0.9896\)이다. 차이가 \(0.0001\)이다. 그런데 이 모형은 실제 양성의 \(1.3\%\)밖에 잡지 못한다(재현율 \(0.0127\)).
ROC-AUC도 조심해야 한다. \(0.878\)로 꽤 좋아 보이지만, ROC 곡선의 가로축인 거짓양성률은 음성 표본 수로 나눈 값이라 음성이 압도적으로 많으면 작게 유지되기 쉽다.
PR-AUC가 진실을 말한다. \(0.171\)인데, 무작위 추측의 기준선이 양성 비율 \(0.0105\)이므로 약 \(16\)배 개선이라는 뜻이다. 실제로 유용한 정보이며, 동시에 "완벽과는 거리가 멀다"는 사실도 함께 말해 준다.
임계값은 \(0.5\)일 이유가 없다. 표에서 보듯 임계값을 낮추면 재현율이 \(0.013 \to 0.694\)로 오르고 정밀도는 \(0.667 \to 0.061\)로 떨어진다. 어디를 고를지는 통계가 아니라 비용이 정한다.
암 검진처럼 놓치는 비용이 크면 임계값을 낮추고, 스팸 분류처럼 정상 메일을 버리는 비용이 크면 높인다.
불균형 자료의 점검표
- 정확도 대신 정밀도·재현율·PR-AUC를 보고한다.
- 혼동행렬 전체를 제시한다. 요약 지표 하나로는 부족하다.
- 임계값을 비용에서 유도하고 그 근거를 밝힌다.
- 확률이 잘 보정되어 있는지 확인한다. 비용 기반 임계값은 확률이 진짜일 때만 옳다.
- 과대표집이나 클래스 가중은 재현율을 올리는 대신 확률을 왜곡한다. 필요하면 사후 보정을 함께 한다. \(\square\)
연습문제 10. 연습문제 2를 일반화하라. 손실함수를 바꾸면 최적 예측이 어떻게 달라지는가? 제곱오차, 절대오차, 핀볼 손실에 대해 답하고 수치로 확인하라.
풀이
상수 \(c\)로 \(Y\)를 예측할 때 각 손실을 최소화하는 \(c\)는 다음과 같다.
| 손실 | 최적 예측 |
|---|---|
| \((y-c)^2\) | 평균 \(\mathbb{E}[Y]\) |
| \(\lvert y-c\rvert\) | 중앙값 |
| 핀볼 \(\rho_\tau(y-c)\) | \(\tau\) 분위수 |
절대오차의 경우 유도. \(\mathbb{E}\lvert Y-c\rvert\)를 \(c\)로 미분하면
이고, 이것이 \(0\)이 되는 곳이 \(P(Y<c) = P(Y>c) = 1/2\), 곧 중앙값이다.
핀볼 손실 \(\rho_\tau(u) = \max\{\tau u,\ (\tau-1)u\}\)는 과소예측에 \(\tau\), 과대예측에 \(1-\tau\)의 벌점을 준다. 같은 방식으로 미분하면 최적점이 \(\tau\) 분위수가 된다.
import numpy as np

rng = np.random.default_rng(1)
y = rng.lognormal(0, 1, 200_000)              # 오른쪽으로 크게 치우친 분포
print(f"평균 {y.mean():.4f}   중앙값 {np.median(y):.4f}"
      f"   90% 분위수 {np.quantile(y, 0.9):.4f}")

grid = np.linspace(0.1, 4, 400)
losses = {
    "제곱오차": [np.mean((y - c) ** 2) for c in grid],
    "절대오차": [np.mean(np.abs(y - c)) for c in grid],
    "핀볼 (tau=0.9)": [np.mean(np.maximum(0.9 * (y - c), -0.1 * (y - c)))
                       for c in grid],
}
targets = {"제곱오차": y.mean(), "절대오차": np.median(y),
           "핀볼 (tau=0.9)": np.quantile(y, 0.9)}
print()
for name, vals in losses.items():
    print(f"  {name:>15} 최소화 상수 {grid[int(np.argmin(vals))]:.4f}"
          f"   이론값 {targets[name]:.4f}")
출력:
평균 1.6438   중앙값 0.9979   90% 분위수 3.5769

             제곱오차 최소화 상수 1.6444   이론값 1.6438
             절대오차 최소화 상수 0.9992   이론값 0.9979
     핀볼 (tau=0.9) 최소화 상수 3.5797   이론값 3.5769
세 손실이 각각 \(1.64\), \(1.00\), \(3.58\)을 최적으로 지목하고 이론값과 맞는다. 같은 자료에 대해 최적 예측이 세 배 넘게 차이 난다.
함의가 크다.
- "최적 예측"이라는 말은 손실함수를 명시해야 뜻을 갖는다. 연습문제 2가 조건부 평균을 답으로 준 것은 제곱오차를 썼기 때문이다. 손실을 바꾸면 답이 바뀐다.
- 치우친 분포에서 특히 중요하다. 배달 시간, 소득, 대기 시간처럼 오른쪽 꼬리가 긴 자료에서 평균과 중앙값은 크게 다르다. "평균 배달 시간 \(30\)분"과 "절반은 \(22\)분 안에 도착"은 다른 약속이다.
- 제곱오차는 이상치에 민감하다. 오차를 제곱하므로 큰 오차 하나가 여러 작은 오차를 압도한다. 절대오차(또는 후버 손실)가 로버스트한 대안이다.
- 분위수 회귀는 핀볼 손실을 여러 \(\tau\)에 대해 최소화해 조건부 분포 전체를 그린다. 평균 하나가 아니라 "이 조건에서 상위 \(10\%\)는 얼마인가"까지 답할 수 있다.
비대칭 비용에는 비대칭 손실을 쓰라. 재고를 적게 잡는 손해가 많이 잡는 손해보다 크다면 \(\tau > 0.5\)인 핀볼 손실이 맞는 목적함수다. 평균을 예측한 뒤 여유분을 더하는 것보다 원칙적이다. \(\square\)
정리하며
지도학습은 레이블이 붙은 쌍에서 \(\mathbf{x}\mapsto y\) 를 배우는 일이며, 그 전부가 위험 최소화라는 한 문장으로 적힌다.
- 목표는 기대손실 \(R(f)=\mathbb{E}[L(Y,f(\mathbf{X}))]\) 이다. 결합분포를 모르므로 경험위험 \(\hat R_n(f)\) 로 대체하고 가설 공간 \(\mathcal F\) 위에서 최소화한다(ERM).
- 손실이 최적 예측을 정한다. 제곱오차의 답은 조건부 평균 \(\mathbb{E}[Y\mid\mathbf{X}=\mathbf{x}]\) 이고, 0–1 손실의 답은 베이즈 분류기 \(\arg\max_k P(Y=k\mid \mathbf{X}=\mathbf{x})\) 다. 손실함수를 고르는 것이 곧 무엇을 최적이라 부를지 정하는 일이다.
- \(\hat R_n\) 과 \(R\) 의 간극이 이 패러다임의 모든 어려움이다. 훈련자료에서 잘 맞는 것과 새 자료에서 잘 맞는 것은 다르며, 그 간극을 다스리는 것이 정칙화·교차검증·모형선택이다.
- 성공 기준이 모호하지 않다는 점이 지도학습이 지배적인 이유다. 손실을 관측할 수 있으므로 개선 여부를 객관적으로 잴 수 있다.
그러나 레이블이 필요하다. 레이블을 얻는 비용과 그 레이블이 무엇을 측정한 것인지가 실무의 병목이며, 1.4절 알고리즘 편향과 피드백 루프에서 볼 대리변수 문제가 정확히 여기서 발생한다. 레이블이 값싸게 구해지는 듯 보이는 경우 — 다음 낱말, 가린 조각처럼 자료 자신에서 목표를 만들어 내는 자기지도학습 — 도 학습 자체는 여전히 이 절의 틀 안에 있다.
또 하나 잊지 말 것. 지도학습이 잘 해내는 일은 예측이다. \(\hat f\) 가 \(\mathbb{E}[Y \mid \mathbf{X} = \mathbf{x}]\) 를 아무리 잘 맞혀도 그것은 "\(\mathbf{x}\) 인 사람의 \(Y\) 는 얼마인가"에 대한 답이지 "\(\mathbf{x}\) 를 바꾸면 \(Y\) 가 얼마나 변하는가"에 대한 답이 아니다. 조건부와 개입의 차이는 12장 상관과 인과에서 다룬다.
다음 쪽 비지도학습은 레이블이 없을 때로 넘어간다. 손실을 관측할 수 없으므로 "무엇이 잘된 것인가"라는 물음 자체가 달라진다.