통제실험
통제실험은 인과관계를 확립하는 표준적인 방법으로, 무작위 배정과 변수 조작을 통해 처리효과를 교란요인으로부터 분리해 낸다. 이를 떠받치는 두 기둥이 무작위화와 눈가림이다. 무작위화는 관측된 변수와 관측되지 않은 변수가 처리군 사이에서 평균적으로 균형을 이루도록 함으로써 교란을 막는다. 눈가림은 인간의 기대가 만드는 효과 — 대상자에게 나타나는 위약효과, 측정에서의 관찰자 편향, 자료 처리 과정의 선택에서 나타나는 분석자 편향 — 를 막는다. 이 둘을 결합한 것이 이중눈가림 무작위 대조시험(RCT) 이며, 의학에서 인과적 증거의 규제상 표준이자 심리학·교육학·정책 연구의 기준점이다.
정의 1. 통제실험
통제실험(controlled experiment) 은 연구자가 하나 이상의 독립변수(처리)를 조작하고, 대상을 처리군과 대조군에 무작위로 배정하며, 종속변수에 미치는 효과를 측정하는 연구 설계다. 대조군은 위약이나 표준 처치를 받고, 처리군은 개입을 받는다. 무작위 배정은 교란요인이 집단 사이에 기댓값 차원에서 고르게 분포되도록 만든다(한 번의 배정에서 균형이 잡힌다는 보장이 아니다 — 아래 "무작위화가 달성하지 못하는 것" 참조).
무작위화(randomization) 는 우연 기제(난수 발생기, 밀봉 봉투, 컴퓨터 생성 배정)에 따라 대상을 처리군 또는 대조군에 배정하는 것이다. 모든 대상은 각 집단에 배정될 알려진 0이 아닌 확률을 가지며, 배정은 그들의 특성과 독립이다.
눈가림(blinding, 맹검) 은 알고 있으면 시험을 왜곡할 수 있는 당사자들로부터 집단 배정을 감춘다. 표준적인 수준은 다음과 같다.
| 수준 | 대상자가 아는가? | 치료 임상의가 아는가? | 결과 평가자 / 분석자가 아는가? |
|---|---|---|---|
| 공개(open-label) | 예 | 예 | 예 |
| 단일눈가림 | 아니오 | 예 | 예 |
| 이중눈가림 | 아니오 | 아니오 | 예 |
| 삼중눈가림 | 아니오 | 아니오 | 아니오 |
임상의는 배정을 알지만 결과를 채점하는 사람은 모르는 결과평가자 눈가림 시험도 있다. 완전한 이중눈가림이 비현실적일 때(예: 수술적 개입) 유용한 절충안이다.
관찰연구에 대한 통제실험의 핵심 장점은 단순한 연관성이 아니라 인과관계를 확립할 수 있다는 점이다. 무작위화는 집단 사이의 어떤 체계적 차이(나이, 건강, 사회경제적 지위)든 평균적으로 상쇄되도록 보장하므로, 관측된 결과의 차이를 처리 덕분으로 돌릴 수 있다.
위약효과(placebo effect) — 처치를 받고 있다는 믿음에서 비롯되는 실제 호전 — 는 대조군에 겉모습이 똑같은 비활성 처치를 줌으로써 통제한다. 위약 대조가 없으면 처리효과와 심리적 효과가 뒤섞인다.
| 통제실험 | 관찰연구 | |
|---|---|---|
| 집단 배정 | 연구자(무작위) | 대상자(자기선택) |
| 교란 | 무작위화로 최소화 | 잠재적 교란요인이 많음 |
| 인과적 주장 | 가능 | 연관성만 가능 |
한계로는 윤리적 제약(해로운 처치를 배정할 수 없음), 실험실 환경의 인위성, 높은 비용과 시간, 그리고 엄격히 통제된 조건에서 나온 결과의 제한된 일반화 가능성이 있다.
무작위화가 달성하는 것
무작위 배정 아래에서 처리 지시변수 \(T\)는 잠재적 결과 \((Y(0), Y(1))\)과 통계적으로 독립이다.
이 독립성 덕분에 관측된 집단 평균의 차이가 평균 인과효과 \(\mathbb{E}[Y(1)] - \mathbb{E}[Y(0)]\)의 불편추정량이 된다. 그에 못지않게 중요한 점은 무작위화가 \(p\)-값에 확률론적 근거를 준다는 것이다. 처리효과가 없다는 귀무가설 아래에서 검정통계량의 분포는 자료에 대한 어떤 모형도 참조하지 않고 오직 무작위화 방식만으로 결정된다.
무작위화가 달성하지 못하는 것
무작위화는 집단을 기댓값 차원에서 균형 잡는다. 특정한 한 번의 무작위화는 공변량이 불균형한 결과를 낳을 수 있으며, 특히 소규모 연구는 더 아픈 환자가 모두 한쪽 군에 몰리는 "운 나쁜" 배정에 취약하다. 대응책은 다음과 같다.
- 층화(블록) 무작위화: 예후 관련 공변량으로 정의된 층 안에서 무작위화하여 균형을 보장한다.
- 표본 크기 확대: 불균형의 크기가 \(1/\sqrt{n}\)로 줄어든다(표준화 차이의 표준편차가 \(\sqrt{2/n}\)이다). 고정된 기준선을 넘을 확률은 그보다 훨씬 빠르게 줄어든다.
- 사전 지정된 공변량 보정: 무작위화 여부와 무관하게 중요한 공변량을 분석 모형에 포함한다.
그림으로 보는 무작위 배정
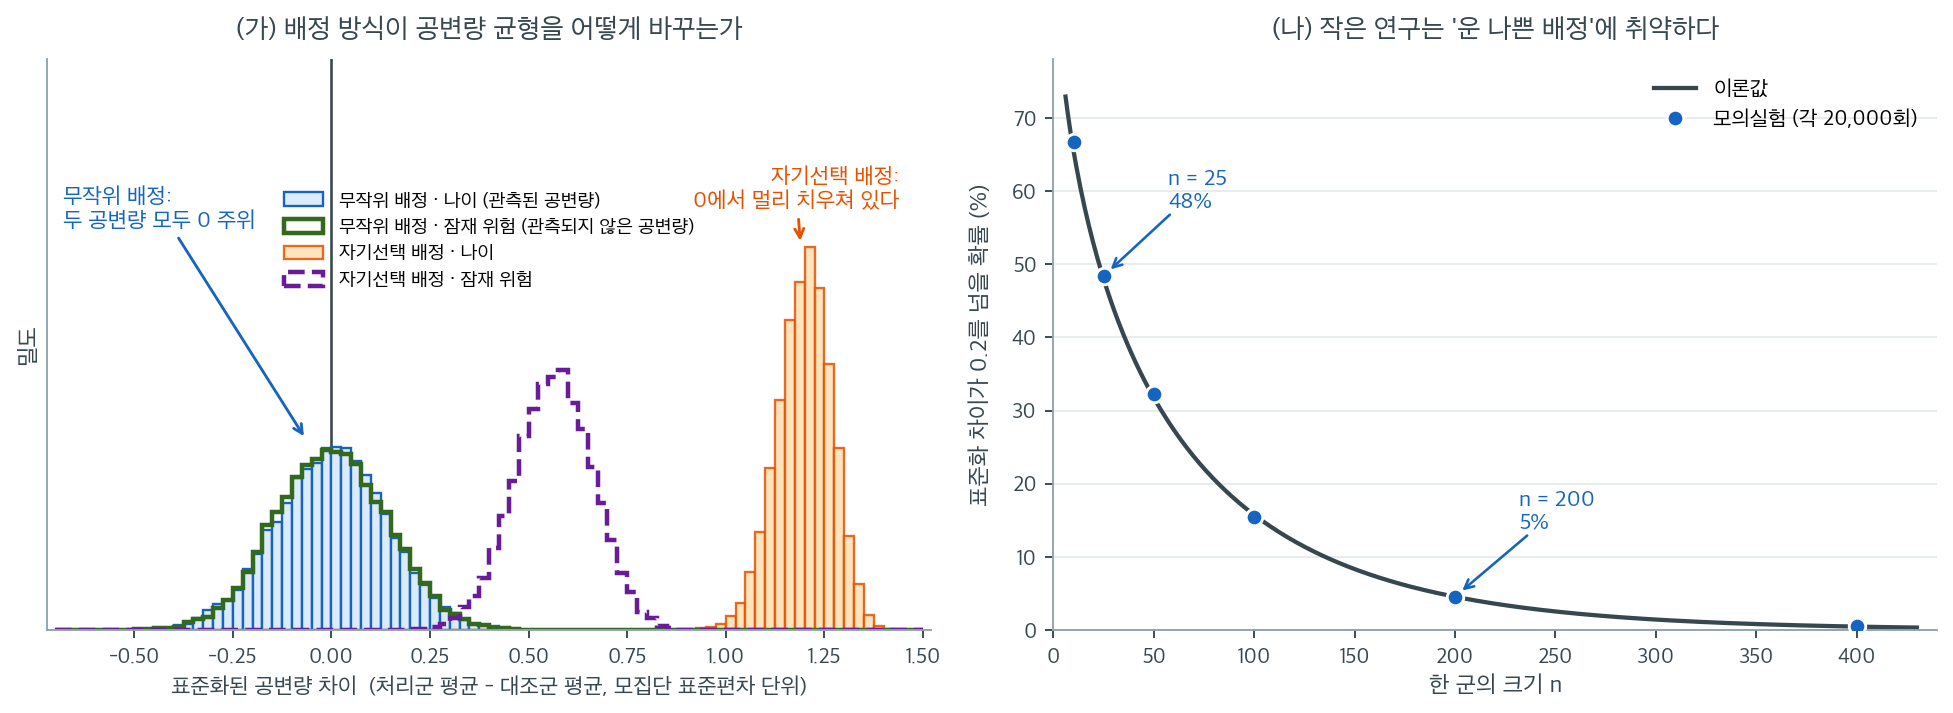
왼쪽 그림은 같은 사람 \(200\)명을 두 가지 방식으로 두 군에 나누는 일을 각각 \(20{,}000\)번 되풀이한 결과다. 사람마다 두 가지 특성을 붙여 두었다. 하나는 연구자가 기록하는 나이이고, 다른 하나는 아무도 측정하지 않는 잠재 위험 점수다(나이와 상관 \(0.5\)로 만들었다). 가로축은 두 군의 평균 차이를 모집단 표준편차로 나눈 값이다.
무작위로 반씩 나누면 두 분포가 겹친 채 \(0\) 위에 올라앉는다. 나이의 평균 불균형은 \(+0.001\), 측정되지 않은 위험 점수의 평균 불균형은 \(+0.000\)이고 표준편차는 각각 \(0.142\)와 \(0.141\)로 사실상 같다(이론값 \(\sqrt{2/100} = 0.141\)). 무작위 배정은 그 변수를 우리가 보고 있는지 묻지 않는다. 나이를 재든 안 재든 동전은 똑같이 던져지고, 그래서 균형도 똑같이 잡힌다. 오른쪽에 떨어져 있는 두 봉우리는 나이가 많을수록 처리를 받기 쉬운 자기선택 배정의 결과다. 나이는 평균 \(+1.20\) 표준편차, 잠재 위험은 \(+0.56\) 표준편차만큼 치우친다. 연구자는 앞의 것은 보정할 수 있지만 뒤의 것은 존재조차 모른다. 이것이 관찰연구가 아무리 공변량을 많이 넣어도 빠져나오지 못하는 자리다.
오른쪽 그림은 같은 이야기의 반대쪽 면이다. 무작위 배정이 주는 것은 평균이 \(0\)이라는 사실이지 이번 배정이 균형 잡혔다는 보장이 아니다. 표준화 차이의 표준편차는 \(\sqrt{2/n}\)이므로, 흔히 쓰는 기준선인 \(0.2\)를 넘을 확률은 한 군이 \(25\)명일 때 \(48\)%, \(100\)명일 때 \(16\)%, \(200\)명일 때 \(4.6\)%, \(400\)명일 때 \(0.5\)%다. 한 군이 \(25\)명인 예비시험에서는 눈에 띄는 불균형이 나오는 쪽이 오히려 정상이다. 앞에서 층화 무작위화와 사전 지정된 공변량 보정을 권한 이유가 이 곡선에 그려져 있다.
다만 불균형 자체가 시험을 무효로 만들지는 않는다. 무작위화가 하는 일은 불균형을 없애는 것이 아니라 불균형의 분포를 알려지게 만드는 것이다. 왼쪽 그림의 파란 분포는 우리가 계산할 수 있는 대상이고, 주황 분포는 계산할 수 없는 대상이다. \(p\)-값이 의지하는 것이 바로 전자의 존재다.
눈가림이 달성하는 것
- 대상자 눈가림은 위약효과 — 처치를 받는다는 믿음이 실제로 일으키는 호전 — 를 통제한다. 이것이 없으면 위약효과가 약리학적 효과와 뒤섞인다.
- 임상의 눈가림은 차별적 진료(예: 처리군에 더 세심한 추적관찰)와 차별적 측정(예: 처리군에 다소 유리하게 평가를 기록하는 것)을 막는다.
- 분석자 눈가림은 자료 정제, 제외 기준, 분석 명세에서 자료에 의존한 선택을 막는다. "갈래길의 정원"에 대한 공식적인 대응책이다.
대조군이 없으면: 문맥정맥 션트
간경변 환자의 문맥압을 낮추기 위한 문맥정맥 션트(portacaval shunt) 수술은 1950–60년대에 널리 시행되었다. Grace, Muench, Chalmers(1966)는 이 수술을 평가한 연구 51편을 모아, 각 연구의 설계와 그 연구가 내린 결론의 열의를 교차분류했다.
| 설계 | 열의: 강함 | 보통 | 없음 | 합계 |
|---|---|---|---|---|
| 대조군 없음 | 24 | 7 | 1 | 32 |
| 대조군 있으나 무작위화 안 함 | 10 | 3 | 2 | 15 |
| 무작위 대조 | 0 | 1 | 3 | 4 |
표를 대각선으로 읽어야 한다. 설계가 허술할수록 수술을 열렬히 지지한다.
- 대조군이 아예 없는 32편 중 24편(75%) 이 "효과가 위험을 확실히 능가한다"고 결론지었다.
- 무작위 대조 시험 4편 중 강한 열의를 보인 것은 한 편도 없었고, 3편은 아무런 이득을 찾지 못했다.
이 표가 무서운 이유
같은 수술, 같은 시대, 같은 종류의 환자다. 달랐던 것은 연구자가 무엇과 비교했는가 하나뿐이다.
대조군 없이 수술한 환자만 추적하면 무슨 일이 벌어지는가? 외과의는 수술을 견딜 만한 환자를 고른다. 너무 위중한 환자는 수술대에 올리지 않는다. 그렇게 선택된 환자들이 잘 지내는 것을 보고 "수술이 효과 있다"고 결론짓는다. 실제로 작동한 것은 수술이 아니라 환자 선택이었을 수 있다.
핵심은 이것이다. 연구자들은 부정직하지 않았다. 51편 모두 성실한 임상의가 쓴 것이다. 그런데도 설계가 결론을 체계적으로 밀어냈다. 편향은 나쁜 의도가 아니라 나쁜 비교에서 나온다.
실무적 함의: 어떤 처치에 대한 문헌을 읽을 때 결론의 개수를 세지 말고 설계별로 나누어 세라. "연구 30편이 효과를 보고했다"는 문장은, 그 30편이 모두 대조군 없는 연구라면 아무것도 말해주지 않는다.
- Grace, N. D., Muench, H., & Chalmers, T. C. (1966). "The Present Status of Shunts for Portal Hypertension in Cirrhosis." Gastroenterology, 50(5), 684–691. (표는 Freedman, Pisani, & Purves, Statistics (4th ed.), 1장의 정리를 따랐다.)
대조군이 있어도 무작위화가 없으면: 1954년 소크 백신 시험
션트 표의 둘째 줄 — 대조군은 있으나 무작위화하지 않은 연구 — 이 실제로 무엇을 잘못하는지 보여 주는 사례가 있다. 1954년 소크 소아마비 백신 시험은 통계학 역사상 가장 잘 설계된 대조 실험 중 하나이며, 같은 해에 같은 백신을 두 가지 다른 설계로 동시에 시험했다는 점에서 특히 값지다. 두 설계를 나란히 놓으면 무작위화가 정확히 무엇을 사는지 볼 수 있다.
설계 A — 무작위 이중눈가림 대조실험. 부모의 동의를 받은 아동을 무작위로 백신군과 위약군에 배정했다.
| 집단 | 인원 | 소아마비 발생률 (10만 명당) |
|---|---|---|
| 백신군 | 200,000 | 28 |
| 위약 대조군 | 200,000 | 71 |
| 동의하지 않음 | 350,000 | 46 |
설계 B — NFIP 설계(무작위화 없음). 2학년생에게 백신을 제안하고, 1·3학년생 전체를 대조군으로 삼았다.
| 집단 | 인원 | 소아마비 발생률 (10만 명당) |
|---|---|---|
| 2학년, 백신 접종 | 225,000 | 25 |
| 1·3학년 (대조군) | 725,000 | 54 |
| 2학년, 동의하지 않음 | 125,000 | 44 |
두 설계 모두 백신이 효과 있다고 말한다. 그러나 효과의 크기가 다르다. 무작위 설계는 \(71 \to 28\)로 발생률이 \(61\)% 감소했다고 말하고, NFIP 설계는 \(54 \to 25\)로 \(54\)% 감소했다고 말한다.
이 표에서 가장 중요한 줄은 '동의하지 않음'이다
각 표의 세 번째 줄을 보라. 부모가 동의하지 않은 아동의 발생률이 대조군보다 낮다(\(46 < 71\), \(44 < 54\)).
상식과 어긋나 보인다. 동의 여부가 아이의 감염 위험을 바꿀 리 없지 않은가? 바꾸지 않는다. 다만 동의하는 부모와 동의하지 않는 부모가 다른 사람들이었다.
소아마비는 위생 상태가 좋은 가정의 아이에게 더 위험한 병이었다. 위생이 나쁜 환경에서 자란 아이는 영아기에 가벼운 감염을 겪으며 항체를 얻는 경우가 많았기 때문이다. 그런데 시험 참여에 동의한 쪽은 교육 수준과 소득이 높은 가정이었다. 즉 동의한 아이들이 애초에 더 위험군이었다.
이것이 NFIP 설계를 망가뜨린다. 그 설계의 "백신군"은 동의한 2학년생(고위험)이고 "대조군"은 1·3학년생 전체(동의자 + 비동의자가 섞인 저위험)이다. 서로 다른 모집단을 비교한 것이다. 이 편향은 백신 효과를 과소평가하는 방향으로 작용했고, 실제로 NFIP 추정치(\(54\)%)가 무작위 추정치(\(61\)%)보다 작다.
무작위 설계는 이 문제가 없다. 동의한 아동만 모아 놓고 그 안에서 무작위 배정했으므로, 백신군과 위약군이 같은 모집단에서 나왔다. 동의하지 않은 아동은 아예 비교에서 빠진다.
교훈: 자기선택은 결과와 상관된 방향으로 작동하며, 그 방향을 미리 알기 어렵다. 여기서는 마침 효과를 과소평가했지만 반대로 뒤집힐 수도 있었다. 무작위화는 이 문제를 보정하는 것이 아니라 발생하지 않게 한다.
무작위화된 쪽이 허가의 근거가 되었고, 비무작위 쪽은 그 이후로 줄곧 교육용 사례가 되었다.
출처와 수치에 관하여
표의 수치는 Freedman, Pisani, & Purves, Statistics (4th ed.), 1장의 정리를 따른 것으로 모든 소아마비 사례의 발생률이며 인원은 반올림한 값이다.
원자료(Francis et al., 1955)에서 마비성 소아마비만 세면 다음과 같다. 무작위 설계: 백신군 200,745명 중 33건(10만 명당 16.4), 위약군 201,229명 중 115건(57.1), 미접종 338,778명 중 121건(35.7). NFIP 설계: 접종 221,998명 중 38건(17.1), 대조군 725,173명 중 330건(45.5), 미동의 123,605명 중 43건(34.8).
어느 쪽으로 세든 '동의하지 않음' 집단이 대조군보다 낮다는 핵심 양상은 그대로다.
- Francis, T. Jr., et al. (1955). "An Evaluation of the 1954 Poliomyelitis Vaccine Trials." American Journal of Public Health, 45(5 Pt 2), 1–63.
임상시험의 단계 — 무작위화와 눈가림은 언제 들어오는가
소크 시험은 백신 하나의 운명을 한 번의 거대한 실험으로 결판냈다. 오늘날의 신약은 그렇게 하지 않는다. 표본을 키워 가며 단계를 나누어 검증한다. 중요한 것은 단계마다 묻는 질문이 다르고, 질문이 다르므로 설계도 다르다는 점이다. 이 절의 두 기둥이 모든 단계에 있는 것이 아니다.
| 단계 | 묻는 질문 | 전형적 대상 | 무작위화 | 눈가림 |
|---|---|---|---|---|
| 1상 | 안전한가? 용량은 얼마인가? | 건강인 20–80명 | 대개 없음 | 대개 없음 |
| 2상 | 약리효과가 있는가? 적정 용량은? | 환자 100–200명 | 도입 | 도입 |
| 3상 | 확증: 임상적 이득이 있는가? | 환자 수백–수천 명 | 필수 | 원칙적으로 이중눈가림 |
| 4상 | 시판 후 장기 안전성·유효성 | 시판 인구 전체 | 대개 없음 | 없음 |
1상은 두 기둥이 모두 없는 단계다. 얼핏 허술해 보이지만 그렇지 않다. 1상이 묻는 것은 인과 대비가 아니라 내약성과 체내동태이며, 비교할 대조군 자체가 설계에 없다(단일군 용량상승). 무작위화는 그 자체가 목적이 아니라 인과 대비를 만들기 위한 도구이므로, 인과 대비를 묻지 않는 단계에는 할 일이 없다.
3상에서는 이 절의 내용이 그대로 법조문이 된다. 미국 연방규정 21 CFR 314.126은 허가의 근거가 되는 "적절하고 잘 통제된 시험(adequate and well-controlled study)"의 요건을 규정하는데, 그 조문은 다음을 명시한다.
- 시험의 목적은 "약의 효과를 질병의 자연 경과, 위약효과, 편향된 관찰 같은 다른 영향으로부터 구별해 내는 것"이다. — (a)
- "환자를 처리군과 대조군에 배정하는 방법은 편향을 최소화하고 관련 변수에 대해 두 군의 비교 가능성을 보장해야 한다. 통상 동시대조 시험에서 배정은 층화 여부와 무관하게 무작위화로 이루어진다." — (b)(4)
- "대상자, 관찰자, 그리고 자료 분석자 쪽의 편향을 최소화하기 위한 적절한 조치를 취한다." 시험계획서는 "눈가림 같은" 그 절차를 기술해야 한다. — (b)(5)
(b)(5)가 대상자와 관찰자에서 멈추지 않고 분석자까지 명시한다는 점에 주목하라. 위의 눈가림 수준 표에서 삼중눈가림에 해당하는 열이 규제 요건에 들어 있는 것이다.
"확증시험 2건"은 재현성을 제도로 만든 것이다. FDA는 1962년 이래 법정 요건인 "실질적 증거(substantial evidence)"를 통상 두 건 이상의 독립적인 확증시험으로 해석해 왔다. 어림셈으로 보면 그 뜻이 분명하다. 각 시험이 단측 \(\alpha = 0.025\)로 수행된다고 하면, 효과가 없는 약이 두 시험을 모두 통과할 확률은 대략
이다. 규제기관은 한 시험의 유의수준을 이 값까지 조이는 대신 독립적 반복을 요구하는 쪽을 택했다. 두 선택은 숫자로는 비슷해 보여도 통계적으로 같지 않다. 유의수준을 조이는 것은 우연한 1종오류만 막지만, 독립적 반복은 그 밖의 것 — 한 시험에만 있는 자료 처리 관행, "갈래길의 정원"에서 우연히 유리하게 열린 선택, 단일 기관의 측정 습관 — 까지 걸러낸다. 그런 것들이 서로 다른 시험에서 같은 방향으로 두 번 연속 작동하기는 어렵기 때문이다.
이 어림셈을 곧이곧대로 받아들이지 말 것
\(0.025^2\)은 논리를 보여 주는 계산이지 규제 판단의 절차가 아니다. 두 시험은 같은 회사가 비슷한 프로토콜과 겹치는 기관에서 수행하는 경우가 많아 완전히 독립이 아니며, 규제기관은 두 \(p\)-값을 곱해서 판단하지 않는다. 또 1997년 FDAMA 이후로는 시험 1건과 확증증거의 조합으로도 실질적 증거가 인정될 수 있다. 그래도 바탕에 깔린 원리는 그대로다. 하나의 \(p\)-값이 아니라 독립적인 증거들의 수렴을 요구한다.
4상이 필요한 이유는 표본크기 계산에 있다. 3상에서 3,000명을 관찰했다고 하자. 참 발생률이 10,000분의 1인 중대한 이상반응의 기대 건수는 \(0.3\)건이다. 한 건도 보지 못한 채 허가가 나는 것이 정상이다. 8장의 "3의 법칙" 을 적용하면 이 상황이 정량화된다. \(n\)명 중 0건이 관측되었을 때 참 발생률의 근사적인 95% 상한은 \(3/n\)이므로, \(n = 3{,}000\)이면 상한은 \(1/1{,}000\)이다. 즉 허가 시점에 우리가 배제할 수 있는 것은 1,000명에 한 명보다 흔한 위해뿐이다. 그보다 드문 위해는 시판 후 수십만 명이 노출되어야 비로소 보인다.
다만 4상과 시판 후 자료는 대개 무작위화되어 있지 않다. 누가 그 약을 복용하는지는 의사와 환자가 정하며, 대개 더 아픈 환자가 더 적극적인 약을 받는다. 앞 절에서 다룬 관찰연구의 문제가 고스란히 돌아오는 것이다(이 형태의 교란을 적응증에 의한 교란(confounding by indication) 이라 한다). 시판 후 감시는 3상이 볼 수 없는 것을 보지만, 그 대가로 3상이 가졌던 인과적 지위를 잃는다.
한국의 경우. 식품의약품안전처(식약처)는 2016년 국제의약품규제조화위원회(ICH)의 정회원이 되었고, 그에 따라 단계 구조와 시험 실시 기준이 FDA·EMA와 정합되어 있다. 단계 구분(1–4상)은 사실상 동일하며 용어만 다르다.
| 미국 FDA | 한국 식약처 | |
|---|---|---|
| 시험 개시 승인 | IND | 임상시험계획승인(IND) |
| 시험 실시 기준 | ICH E6 (GCP) | 의약품 임상시험 관리기준(KGCP) |
| 윤리 심의 | IRB | 임상시험심사위원회(IRB) |
| 허가 신청 | NDA / BLA | 품목허가 신청 |
| 시판 후 안전관리 | REMS 등 | 위해성관리계획(RMP) |
통계를 다루는 사람에게 정말 중요한 것은 기관의 이름이 아니라, 어느 규제 체계에서든 공통으로 요구하는 한 가지다. 분석계획서를 자료를 보기 전에 확정해야 한다(ICH E9, 임상시험의 통계적 원칙). 사전 지정이 없으면 무작위화와 눈가림으로 설계에서 막아 낸 편향이 분석 단계에서 그대로 새어 들어온다. 분석자 눈가림이 세 번째 기둥인 이유가 여기에 있다.
규정 인용에 관하여
조문 인용은 21 CFR 314.126(적절하고 잘 통제된 시험의 특성)과 FD&C Act 505(d)(실질적 증거)를 옮긴 것이다. 대상자 수는 관례적인 범위이며 시험마다 크게 다르다. 1상의 20–80명, 2상의 100–200명은 식약처 의약품안전나라의 단계 정의를 따랐다.
규제 세부는 개정된다. 한국의 재심사 제도는 2025년 2월 폐지되어 위해성관리계획(RMP)으로 일원화되었다. 반면 이 절이 말하는 통계적 논리 — 단계마다 질문이 다르다, 확증에는 반복이 필요하다, 표본크기가 볼 수 있는 위해의 한계를 정한다 — 는 규정 개정과 무관하게 유지된다.
보기 1. 통제실험. 처리효과를 알고 있는 상태에서 자료를 만들고 되찾아 본다. 그다음 참 효과는 그대로 둔 채 배정 방식만 바꾼다. 중증도 \(S \sim U(0,10)\)이 결과를 \(-2S\)만큼 떨어뜨리고, 의사가 중증 환자에게 처리를 더 주어 \(P(T=1 \mid S) = \sigma(S-5)\)가 된다. 참 처리효과는 \(+3\)이다.
(1) 무작위 배정일 때 추정값의 표준오차를 구하시오(\(n = 200\)씩, \(\sigma = 8\)).
(2) 교란된 배정에서 단순 평균차가 수렴하는 값을 구하시오. 참값 \(+3\)에서 얼마나, 어느 방향으로 벗어나는가.
풀이
(1) 해석적으로. 두 독립 표본평균의 차이이므로
이다. 무작위 배정의 값어치는 이 한 줄에 있다. 배정이 결과와 독립이므로 단순 평균차가 인과효과의 불편추정이 되고, 그 흔들림의 크기도 \(\sigma\)와 \(n\)만으로 정해진다.
(2) 해석적으로. 교란된 배정에서는 단순 평균차가
로 갈린다. 둘째 항이 교란이 만든 몫이다.
\(S\)가 \(5\)를 중심으로 대칭이고 \(\sigma(s-5) + \sigma(5-s) = 1\)이므로 \(P(T=1) = 1/2\)이고 두 조건부 분포가 서로 거울상이다. 적분하면
로 차이가 \(4.3743\)이다. 따라서
부호가 뒤집힌다. 처리는 결과를 \(3\)만큼 좋게 하는데 자료는 \(5.75\)만큼 나쁘게 한다고 말한다. 중증 환자가 처리군에 몰려 있기 때문이고, 이 치우침은 표본을 아무리 늘려도 사라지지 않는다.
(1)(2) 수치적으로.
import numpy as np
from scipy import stats

np.random.seed(42)
n_per_group = 100
true_effect = 5.0        # 우리가 심어 놓은 참 처리효과. 실제로는 알 수 없는 값이다

# 무작위 배정된 실험을 모의생성한다.
# 두 집단을 같은 분포에서 뽑되 처리군에만 true_effect 만큼을 더한다.
# 이것이 곧 "무작위 배정"의 수학적 의미다.
# 배정이 결과와 무관하므로 두 집단은 처리 여부를 빼면 통계적으로 동일하다.
control = np.random.normal(50, 10, n_per_group)
treatment = np.random.normal(50 + true_effect, 10, n_per_group)

# 독립표본 t 검정: 두 집단의 평균이 같다는 귀무가설을 검정한다
t_stat, p_value = stats.ttest_ind(treatment, control)

# 처리효과의 추정값. 무작위 배정 덕분에 이 단순한 차이가 곧 인과효과의 추정이 된다.
diff = treatment.mean() - control.mean()
print(f"Control mean:   {control.mean():.2f}")
print(f"Treatment mean: {treatment.mean():.2f}")
print(f"Difference:     {diff:.2f} (true effect = {true_effect})")
print(f"t-statistic:    {t_stat:.3f}")
print(f"p-value:        {p_value:.4f}")
출력:
Control mean:   48.96
Treatment mean: 55.22
Difference:     6.26 (true effect = 5.0)
t-statistic:    4.755
p-value:        0.0000
같은 참 효과를 두고 무작위 배정과 비무작위(교란된) 배정을 나란히 돌려 보면, 배정 방식 하나가 추정값을 어떻게 바꾸는지 보인다.
"""참 효과는 같은데 배정 방식만 다르게 두 번 돌려 본다."""

import numpy as np
from scipy import stats

rng = np.random.default_rng(42)
n = 200
treatment_effect = 3.0     # 두 경우 모두 참 효과는 +3.0으로 같다

# === 경우 1: 제대로 무작위 배정한 실험 ===
# 배정이 환자의 어떤 특성과도 무관하다.
# 따라서 두 집단은 처리 여부를 빼면 평균적으로 동일하고,
# 단순한 평균 차이가 곧 인과효과의 불편추정이 된다.
control = rng.normal(50, 8, n)
treatment = rng.normal(50 + treatment_effect, 8, n)
t_stat, p_val = stats.ttest_ind(treatment, control)
print(f"[Randomized] estimated effect = {treatment.mean() - control.mean():+.2f} "
      f"(true = {treatment_effect}), p = {p_val:.4f}")

# === 경우 2: 교란된(무작위가 아닌) 배정 ===
# 중증도라는 교란요인을 넣는다. 0(가벼움)에서 10(심각함)까지.
severity = rng.uniform(0, 10, 2 * n)

# 의사가 중증 환자에게 처리를 더 많이 준다 — 현실에서 자연스러운 행동이다.
# 로지스틱 함수라 중증도 5를 기준으로 처리 확률이 50%를 넘어간다.
prob_treat = 1 / (1 + np.exp(-(severity - 5)))
assigned = rng.binomial(1, prob_treat).astype(bool)

# 결과는 두 힘이 겹쳐 결정된다.
#   -2 * severity      중증일수록 결과가 나쁘다 (교란요인의 직접 효과)
#   +3 * assigned      처리가 결과를 좋게 한다  (우리가 알고 싶은 참 효과)
outcome = 50 - 2 * severity + treatment_effect * assigned + rng.normal(0, 5, 2 * n)

# 이제 무작위 실험에서 하던 대로 단순 평균 차이를 내 본다.
# 처리군에 중증 환자가 몰려 있으므로 이 값은 인과효과가 아니다.
est = outcome[assigned].mean() - outcome[~assigned].mean()
print(f"[Confounded] estimated effect = {est:+.2f}  (severity confounds)")

# --- (2) 의 이론값과 맞추어 본다 ---
from scipy.integrate import quad

sig = lambda u: 1 / (1 + np.exp(-u))
den = quad(lambda s: sig(s - 5) / 10, 0, 10)[0]
num = quad(lambda s: s * sig(s - 5) / 10, 0, 10)[0]
E1, E0 = num / den, (5 - num) / (1 - den)
print(f"이론 P(T=1) = {den:.4f},  E[S|T=1] = {E1:.4f},  E[S|T=0] = {E0:.4f}")
print(f"이론 교란 추정값 = 3 - 2*({E1 - E0:.4f}) = {3 - 2 * (E1 - E0):+.4f}")
print(f"관측 E[S|T=1] = {severity[assigned].mean():.4f},  "
      f"E[S|T=0] = {severity[~assigned].mean():.4f}")
se = np.sqrt(outcome[assigned].var(ddof=1) / assigned.sum()
             + outcome[~assigned].var(ddof=1) / (~assigned).sum())
print(f"교란 추정값의 SE = {se:.4f};  무작위 쪽 이론 SE = 8*sqrt(2/200) = {8 * np.sqrt(2 / 200):.4f}")
출력:
[Randomized] estimated effect = +3.40 (true = 3.0), p = 0.0000
[Confounded] estimated effect = -5.06  (severity confounds)
이론 P(T=1) = 0.5000,  E[S|T=1] = 7.1871,  E[S|T=0] = 2.8129
이론 교란 추정값 = 3 - 2*(4.3743) = -5.7485
관측 E[S|T=1] = 7.2556,  E[S|T=0] = 2.8069
교란 추정값의 SE = 0.6766;  무작위 쪽 이론 SE = 8*sqrt(2/200) = 0.8000
두 예측이 모두 맞는다. 무작위 쪽 추정값 \(+3.40\)은 참값 \(3\)에서 \(0.50\) 표준오차(\(0.80\)) 떨어져 있다. 교란 쪽 추정값 \(-5.06\)은 이론이 말하는 극한 \(-5.7485\)에서 \(1.02\) 표준오차(\(0.6766\)) 안이다.
조건부 중증도도 이론 \(7.1871\) / \(2.8129\)에 관측 \(7.2556\) / \(2.8069\)로 맞는다. 처리군과 대조군의 평균 중증도가 \(4.4\)만큼 벌어져 있고, 그것에 \(-2\)를 곱한 \(-8.7\)이 참 효과 \(+3\)을 눌러 부호를 뒤집었다.
위쪽 블록의 첫 실험도 같은 자로 읽는다. 참 효과 \(5\)에 대해 추정값이 \(6.26\)인데, \(\sigma = 10\), \(n = 100\)이므로 표준오차가 \(10\sqrt{2/100} = 1.414\)다. \(0.89\) 표준오차 차이이고, \(t = 4.755\)는 그 추정값을 표준오차로 나눈 값 그대로다.
무작위 배정이 사는 것은 정확도가 아니라 해석이다. 두 설계 모두 \(n\)이 \(200\)으로 같고 교란된 쪽의 표준오차(\(0.68\))가 오히려 작다. 그런데 한쪽은 참값을 맞히고 다른 쪽은 부호까지 틀린다. 정밀한 오답은 부정확한 정답보다 위험하다.
연습문제
연습문제 1. 어떤 제약회사가 신약을 시험하기 위해 신청한 자원자 100명에게 약을 투여한다. 신청하지 않은 별도의 100명이 대조군 역할을 한다. 이 실험 설계의 핵심 결함을 지적하라.
풀이
핵심 결함은 자기선택 편향(무작위 배정의 부재)이다. 신청한 자원자는 신청하지 않은 사람과 체계적으로 다를 수 있다 — 건강에 더 신경 쓰거나, 증상이 더 심하거나, 약이 효과가 있으리라는 믿음이 더 강할 수 있다. 두 집단 사이에서 관측된 어떤 차이든 약 자체보다는 이런 기존 차이 때문일 수 있다. 제대로 된 무작위 대조시험이라면 200명 전원을 처리군 또는 대조군에 무작위 배정하여, 관측된 특성과 관측되지 않은 특성 모두에서 두 집단이 비교 가능하도록 만든다.
연습문제 2. 무작위 대조시험(RCT)과 자연실험의 차이를 설명하라. 각각의 예를 하나씩 들어라.
풀이
무작위 대조시험에서는 연구자가 무작위 기제(동전 던지기, 난수 발생기 등)를 사용해 대상을 처리군과 대조군에 능동적으로 배정한다. 예: 환자를 신약군과 위약군에 무작위로 배정하는 것.
자연실험에서는 외부 사건이나 정책이 연구자의 개입 없이 "마치 무작위 배정인 것처럼" 처리군과 대조군을 만들어낸다. 예: 학교 바우처 추첨제에서 당첨자(처리군)와 탈락자(대조군)가 연구자가 아니라 우연에 의해 결정되는 경우.
핵심 차이는 통제권이다. RCT에서는 연구자가 배정을 통제하고, 자연실험에서는 자연이나 정책이 변동을 제공한다. RCT가 비윤리적이거나 비현실적일 때 자연실험은 가치가 있지만, 그 타당성은 "무작위나 다름없다"는 가정이 얼마나 그럴듯한지에 달려 있다.
연습문제 3. 어떤 연구에서 개인지도 수업에 참석한 학생이 그렇지 않은 학생보다 시험에서 15점 높은 점수를 받았다. 학교는 개인지도가 15점의 향상을 유발한다고 결론지었다. 개인지도의 인과효과가 없더라도 이 결과를 설명할 수 있는 교란요인으로 무엇이 있을까?
풀이
인과효과 없이도 이 연관성을 설명할 수 있는 교란요인이 여럿 있다.
- 동기: 개인지도에 참석하는 학생은 성공하려는 동기가 더 강해서, 참석하지 않았더라도 더 높은 점수를 받았을 수 있다.
- 기존 능력: 개인지도는 이미 기초가 탄탄한 학생을 끌어들일 수 있다.
- 공부 시간: 개인지도에 참석하는 학생은 혼자서도 더 오래 공부할 수 있다.
- 부모의 관여: 개인지도를 마련해 주는 가정의 학생은 집에서도 다른 학업 지원을 받을 수 있다.
- 교사의 추천: 교사가 이미 성적이 오르고 있는 학생에게 개인지도를 권할 수 있다.
개인지도에 대한 무작위 배정(또는 설득력 있는 도구변수나 자연실험)이 없다면, 15점 차이는 개인지도의 인과효과와 선택효과를 함께 반영한다.
연습문제 4. 통제실험의 맥락에서 내적 타당도와 외적 타당도를 정의하라. 내적 타당도는 높지만 외적 타당도는 낮은 실험이 있을 수 있는가?
풀이
내적 타당도는 연구 모집단 안에서 처리와 결과 사이의 인과관계를 실험이 얼마나 잘 확립하는지를 나타낸다. 적절한 무작위화, 교란요인의 부재, 체계적 편향의 부재에 달려 있다.
외적 타당도(일반화 가능성)는 그 결과가 연구 범위를 넘어선 모집단·상황·조건에 얼마나 적용되는지를 나타낸다.
그렇다. 내적 타당도는 높지만 외적 타당도는 낮은 실험이 있을 수 있다. 예를 들어 대학생을 대상으로 세심하게 무작위화한 실험실 실험은 인과효과를 입증하지만(높은 내적 타당도), 대학생이 나이·교육·사회경제적 지위에서 대표성이 없기 때문에 그 효과가 더 넓은 모집단으로 일반화되지 않을 수 있다(낮은 외적 타당도). 이 긴장은 실험 설계의 근본적인 문제다. 엄격히 통제된 환경은 내적 타당도를 높이지만 일반화 가능성을 제한할 수 있다.
연습문제 5. 어떤 요인실험이 두 개의 이항 요인(A: 낮음 / 높음, B: 낮음 / 높음)을 변화시켜 총 4개의 처리 조합을 만들고, 조합마다 25명씩 배정한다. 이 설계에서 추정할 수 있으나 두 개의 별도 단일요인 실험으로는 얻을 수 없는 양 두 가지를 제시하라.
풀이
요인설계로는 다음을 추정할 수 있다.
- A와 B의 주효과(다른 요인의 수준에 걸쳐 평균) — 이것은 단일요인 설계로도 얻을 수 있다.
- 상호작용 효과 A × B: A의 효과가 B의 수준에 의존하는지 여부. 예를 들어 약물 + 식단 연구에서 그 약이 고단백 식단에서만 효과가 있음을 발견할 수 있는데, 이런 상호작용은 별도의 단일요인 실험으로는 탐지할 수 없다.
- 같은 총 \(n\)에서 주효과의 정밀도 향상: 각 주효과 대비는 단일요인 설계의 50명(25 대 25)이 아니라 100명 전원(50 대 50)을 사용한다.
요인설계에 대한 피셔의 논거(그의 기초 저작 Design of Experiments, 1935)는, 상호작용이 자연에서 흔하고 종종 과학적으로 가장 흥미로운 발견인데도 "한 번에 한 요인씩" 실험해서는 보이지 않는다는 것이다.
연습문제 6. 어떤 임상시험이 새 진통제가 기존 진통제보다 나은지를 검증한다.
(a) 이 시험에서 무작위 배정의 목적을 설명하라. (b) 단일눈가림, 이중눈가림, 삼중눈가림 설계를 정의하라. 어느 것을 추천하며 그 이유는 무엇인가? (c) 새 약은 알약이고 기존 약은 주사제라면 눈가림에 어떤 문제가 생기는가? 연구자는 이를 어떻게 해결할 수 있는가?
풀이
(a) 무작위 배정은 알려진 교란요인(나이, 체중, 기저 통증)과 알려지지 않은 교란요인을 기댓값 차원에서 처리군 사이에 고르게 분산시킨다. 그 결과 평균 결과의 차이는 인과적 처리효과의 불편추정량이 되며, 귀무가설 아래 분포가 무작위화 자체로 결정되는 타당한 \(p\)-값을 갖는다.
(b) 단일눈가림: 대상자가 모른다. 이중눈가림: 대상자와 치료 임상의가 모두 모른다. 삼중눈가림: 대상자, 임상의, 분석자가 모두 모른다. 위약효과(대상자의 기대)와 관찰자 편향(임상의가 통증 평가에서 무의식적으로 새 약을 유리하게 볼 가능성)을 모두 통제하려면 최소한 이중눈가림을 추천한다.
(c) 투여 경로가 다르면 눈가림이 깨진다. 대상자는 자신이 알약을 삼켰는지 주사를 맞았는지 안다. 표준적인 해법은 이중위약(double-dummy) 이다. 모든 대상자가 두 가지를 각각 하나씩 받되 그중 하나는 위약이다. 신약군은 진짜 알약과 생리식염수 주사를 받고, 기존약군은 위약 알약과 진짜 주사를 받는다.
연습문제 7. 어떤 시험이 환자 200명을 무작위화하여 100명을 처리군에, 100명을 대조군에 배정했다. 우연히 처리군의 평균 나이는 65세, 대조군은 55세가 되었다. 이 시험은 무효인가? 올바른 대응은 무엇인가?
풀이
이 시험은 무효가 아니다. 무작위화는 올바르게 수행되었고, 이런 차이는 특히 중간 규모 표본에서 우연히 생길 수 있는 종류의 불균형이다.
올바른 대응(선호 순):
- 사전 지정된 공변량 보정: 나이를 분석의 공변량으로 포함한다(공분산분석 또는 회귀). 이는 흔히 정밀도를 높이고 우연한 불균형을 보정한다.
- 보정 전과 보정 후 결과를 모두 보고: 결론이 일치한다면 그 불균형이 결과를 좌우하고 있을 가능성은 낮다.
- 층화 무작위화(향후 설계를 위한 개선): 다음 시험에서는 나이로 층화하여 우연한 불균형이 생기지 않도록 한다.
해서는 안 되는 일: 불균형을 확인한 뒤 다시 무작위화하거나, 기저 불균형에 대한 \(p\)-값을 비교해 보정 여부를 결정하는 것. 둘 다 설계를 무효로 만든다.
연습문제 8. 기관마다 환자 구성이 다른 다기관 시험에서 블록(층화) 무작위화가 단순 무작위화보다 선호되는 이유를 설명하라.
풀이
단순 무작위화는 기관 내에서 처리군 인원이 불균형해질 수 있다. 우연히 어떤 기관은 대부분 처리군 환자를 등록하고 다른 기관은 대부분 대조군을 등록할 수 있다. 기관마다 환자 구성이나 추적관찰의 질도 다르다면, 이 불균형은 기관 효과와 처리효과를 뒤섞는다.
층화 무작위화는 각 기관 안에서 무작위화한다(보통 크기 4나 6의 고정 블록: TTCC, TCTC, CTCT 등). 그러면 각 기관은 거의 1:1 비율을 보장받아 기관이 잠재적 교란요인이 되지 않는다. 대가는 무작위화 절차가 다소 복잡해지는 것이고, 이득은 더 효율적인 추정과 해석하기 쉬운 분석이다.
연습문제 9. 어떤 수술 시험에서는 집도의를 눈가림할 수 없다. 이로 인해 생기는 타당도 위협과 최선의 부분적 완화책을 논하라.
풀이
집도의는 의식적이든 아니든 시험군에 따라 기술, 주의, 수술 후 관리를 달리할 수 있다. 대상자 또한 부수적인 단서로 자신의 배정을 짐작하게 되어 대상자 눈가림이 훼손될 수 있다.
부분적 완화책:
- 결과평가자 눈가림이 핵심이다. 배정을 모르는 독립 평가자가 결과(통증, 관절 가동범위, 눈가림된 영상)를 채점하게 한다.
- 활성 비교군 설계: "수술 대 수술 없음" 대신 두 수술 절차를 비교하여 두 군 모두 겉보기에 비슷한 시술을 받게 한다. 윤리적으로 허용되는 경우 일부 개입에 대해서는 가짜 수술 시험(마취와 절개는 하되 실제 시술은 하지 않음)이 쓰이기도 했다.
- 사전 지정된 수술 프로토콜: 군에 따라 달라질 수 있는 재량을 최소화한다.
- 감사 기록: 시술을 영상으로 기록하거나 수술실에 독립 관찰자를 둔다.
이런 장치를 갖추더라도 수술 시험의 잔여 편향은 일반적으로 약물 시험보다 크다. 이를 상쇄하려면 효과가 강해야 한다.
연습문제 10. 어떤 약물 시험이 환자는 눈가림했지만 임상의는 눈가림하지 않았다. 처리군 환자는 위약군에는 없는 흔한 부작용(구강건조, 가벼운 메스꺼움)을 겪는다. 이것이 왜 눈가림의 무결성을 위협하며, 그 결과는 무엇인가?
풀이
부작용은 환자의 눈가림을 간접적으로 "푼다". 구강건조와 메스꺼움을 느낀 환자는 자신이 활성약을 복용 중임을 정확히 짐작하고, 위약군은 부작용이 없다는 사실로 마찬가지로 자신의 상태를 알게 된다. 이를 기능적 눈가림 해제라 한다.
결과:
- 위약효과가 더 이상 균형을 이루지 않는다. 한쪽 집단만 이익을 기대한다.
- 대상자가 짐작한 배정에 따라 결과(특히 피로나 기분 같은 주관적 결과)를 다르게 보고할 수 있다.
- 순응도가 갈릴 수 있다. 자신이 위약군이라고 믿는 대상자는 중도 탈락하거나 다른 치료를 찾을 수 있다.
완화책: 치료 효과 없이 부작용 양상만 흉내 내는 활성 위약(예: 항콜린성 약물 연구에서 저용량 아트로핀)을 쓰고, 기대 효과에 덜 민감한 객관적 결과 지표를 사용한다.
연습문제 11. 배정대로 분석(ITT, intention-to-treat) 은 임상시험 보고의 관례다. 실제로 처치를 받았는지와 무관하게 각 대상자를 무작위 배정된 집단으로 분석하는 것이다. 추정되는 처리효과를 희석하는 것처럼 보이는데도 ITT가 (비순응자를 제외하는) 프로토콜 준수 분석보다 선호되는 이유를 설명하라.
풀이
무작위화가 보장하는 것은 배정된 집단 사이의 비교 가능성이지, 실제로 처치를 받은 집단 사이의 비교 가능성이 아니다. 순응 자체가 예후와 상관될 수 있는 하나의 행동이다. 더 아픈 환자는 부작용 때문에 약을 끊을 수 있고, 더 건강한 환자는 복용을 잊을 수 있으며, 동기가 강한 환자는 더 잘 따를 수 있다. 프로토콜 준수 분석은 비순응이 정보를 담고 있는 바로 그 환자들을 버림으로써 무작위화를 깨뜨리고 교란을 다시 불러들인다.
ITT는 원래의 무작위 집단을 보존하며, 처치에 배정되는 것의 효과, 즉 분자의 효과가 아니라 정책의 인과효과를 추정한다. 이것이 규제당국과 정책결정자가 실제로 필요로 하는 바다. 약이 승인되면 현실의 환자들도 비슷한 순응 양상을 보일 것이기 때문이다. ITT 추정값은 보통 더 보수적이지만(귀무가설에 더 가깝지만) 불편이고 외적 타당도를 갖는다.
흔히 함께 쓰이는 것이 도구변수 방법으로 추정하는 순응자 평균 인과효과(CACE) 다. 무작위 배정을 실제 처치 수령에 대한 도구변수로 사용한다. CACE는 무작위화를 위반하지 않으면서 순응자들 사이에서의 효과를 제공한다.
연습문제 12. (설계의 특징인) 무작위화와 (분석의 특징인) 부트스트랩 재표집을 구분하라. 인과추론에 전자는 필요하지만 후자는 그렇지 않은 이유는 무엇인가?
풀이
무작위화는 결과를 측정하기 전에 수행된다. 우연 기제로 대상을 처리군에 실제로 배정하는 행위이며, 이를 통해 배정과 기존 특성 사이에 통계적 독립성이 만들어진다. 인과추론은 이 독립성 위에 서 있다.
부트스트랩 재표집은 결과를 측정한 후에 수행된다. 관측된 자료를 반복 재표집하여 통계량의 표집 변동성을 추정하는 분석 기법이다. 자료생성 과정을 바꾸지 않으며, 관측된 연관성이 인과적인지에 대해 아무 정보도 주지 않는다.
부트스트랩은 관찰자료로 추정한 회귀계수의 불확실성을 정량화할 수 있지만, 그 계수가 미측정 교란으로 편향되어 있다면 부트스트랩 신뢰구간은 편향된 값 주변의 불확실성을 보여줄 뿐이다. 아무리 재표집해도 비무작위 표본은 고쳐지지 않는다. 인과성에는 (설계에서의) 개입이나 (분석에서의) 강한 식별 가정이 필요하며, 정밀한 추정만으로는 얻어지지 않는다.
연습문제 13. 어떤 제약사가 규제기관에 이렇게 제안한다. "확증시험을 두 건 수행하는 것은 비용과 시간이 너무 많이 듭니다. 대신 시험을 한 건만 하되 유의수준을 \(\alpha = 0.000625\)(단측)로 훨씬 엄격하게 적용하겠습니다. 1종오류 확률이 같으니 증거의 강도도 같습니다."
(a) 이 주장의 산술적 근거는 무엇인가? (b) 규제기관이 이 제안을 거절할 통계적 이유를 대라. (c) 반대로, 시험 2건을 요구하는 쪽의 약점은 무엇인가?
풀이
(a) 각 시험을 단측 \(\alpha = 0.025\)로 수행할 때 효과 없는 약이 두 시험을 모두 통과할 확률은 두 시험이 독립이라면 \(0.025^2 = 6.25 \times 10^{-4}\)이다. 제약사는 단일 시험의 유의수준을 이 값으로 잡으면 전체 1종오류 확률이 같아진다고 주장하는 것이다.
(b) 1종오류 확률이 같다고 해서 증거가 같지 않다. \(\alpha\)는 귀무가설이 참이고 모형 가정이 모두 맞을 때의 우연한 오류만 통제한다. 시험 2건이 추가로 걸러 내는 것은 그 밖의 실패 양식이다.
- 분석의 자유도. 한 시험 안에서 이루어진 자료 의존적 선택(제외 기준, 결측 처리, 하위집단 강조)은 그 시험의 \(p\)-값을 낙관적으로 만든다. 유의수준을 조여도 이 편향은 함께 조여지지 않는다. 독립적인 두 번째 시험은 다른 사람이 다른 선택을 하고도 같은 결론에 이르는지를 묻는다.
- 단일 실패점. 한 기관의 측정 습관, 한 배치의 약, 한 하위 인구에 특유한 효과는 한 시험을 통째로 왜곡할 수 있다. 이것들은 \(\alpha\)가 모형화하는 대상이 아니다.
- 일반화 가능성. 서로 다른 환자 구성과 기관에서 반복되었다는 사실 자체가 허가 대상 인구에 대한 정보다.
요컨대 \(\alpha\)를 조이는 것은 우연에 대한 방어이고, 반복은 우연과 절차 모두에 대한 방어다.
(c) 두 가지가 있다.
- 독립성이 실제로는 성립하지 않는다. 같은 회사가 같은 프로토콜로 겹치는 기관에서 수행하는 두 시험은 공통의 설계 결함을 공유하므로 \(0.025^2\)은 낙관적인 계산이다. 실제 규제 판단은 두 \(p\)-값을 곱하는 절차가 아니다.
- 윤리적·현실적 비용. 희귀질환처럼 환자가 부족하거나 대조군 배정이 윤리적으로 어려운 경우 시험 2건은 불가능할 수 있다. 1997년 FDAMA가 시험 1건과 확증증거의 조합을 허용한 이유가 여기에 있다. 이때도 논리는 유지된다. 두 번째 시험이 하던 역할(독립적 증거의 수렴)을 기전 자료, 약력학 지표, 관련 적응증의 결과 같은 다른 종류의 증거가 대신하는 것이다.
연습문제 14. 어떤 약이 3상 시험에서 총 3,000명에게 투여되었고 중대한 간독성은 한 건도 관찰되지 않았다. 허가 후 200만 명이 이 약을 복용한다.
(a) "3의 법칙"을 써서 3상 자료가 배제할 수 있는 간독성 발생률의 범위를 말하라. (b) 참 발생률이 20,000분의 1이라면 3상에서 기대되는 사례 수는 몇 건인가? 시판 후에는? (c) 이 위해를 잡아내는 시판 후 자료는 3상 자료와 어떤 점에서 증거로서 열등한가?
풀이
(a) \(n\)명에서 사건이 0건 관측되었을 때 참 발생률 \(p\)의 근사적 95% 상한은 \(3/n\)이다. \(n = 3{,}000\)이므로 상한은
이다. 즉 3상 자료로 배제할 수 있는 것은 1,000명에 한 명보다 흔한 간독성뿐이다. 그보다 드문 위해에 대해서는 이 시험이 사실상 아무 말도 하지 않는다. "이상반응이 관찰되지 않았다"는 문장이 "안전하다"를 뜻하지 않는 이유다.
(b) 참 발생률 \(p = 1/20{,}000\)일 때 기대 사례 수는 \(np\)이다.
- 3상: \(3{,}000 \times \dfrac{1}{20{,}000} = 0.15\)건. 한 건도 보지 못할 확률이 약 \(e^{-0.15} \approx 86\)%이다. 아무것도 못 보는 것이 정상적인 결과다.
- 시판 후: \(2{,}000{,}000 \times \dfrac{1}{20{,}000} = 100\)건. 이제는 확실히 보인다.
표본크기가 볼 수 있는 것의 한계를 정한다. 4상과 시판 후 감시는 3상의 부실함 때문에 존재하는 것이 아니라, 어떤 표본크기로도 볼 수 없는 영역이 원리적으로 남기 때문에 존재한다.
(c) 시판 후 자료에는 무작위화가 없다. 누가 이 약을 복용하는지는 의사와 환자가 정하며, 대개 더 아프거나 다른 약을 이미 여러 개 복용 중인 환자가 새 약을 받는다(적응증에 의한 교란). 따라서 복용자에게서 간독성이 더 많이 관찰되어도 그것이 약 때문인지, 애초에 간이 나쁜 환자가 이 약을 받았기 때문인지 자료만으로는 구분되지 않는다.
여기에 보고 편향이 더해진다. 자발적 이상사례 보고는 심한 사례, 언론에 오르내린 위해, 최근에 허가된 약에 치우쳐 수집된다. 분모(실제 노출자 수)도 정확히 알기 어렵다.
정리하면 3상은 정밀하지만 근시안이고, 시판 후 감시는 시야가 넓지만 편향되어 있다. 둘은 서로를 대체하지 않으며, 규제 체계가 두 단계를 모두 두는 이유가 바로 이 상보성이다.
정리하며
통제실험은 연관성을 인과효과로 바꾸는 유일한 일반적 장치이며, 두 기둥 위에 서 있다.
- 무작위화. 배정을 우연에 맡기면 나이·건강·소득뿐 아니라 측정하지 않은 변수까지 평균적으로 균형이 맞는다. 관찰연구의 식별 전략들이 가정으로 사들여야 했던 것을 설계로 공짜로 얻는 셈이다.
- 눈가림. 위약효과(대상자), 관찰자 편향(측정), 분석자 편향(자료 처리)을 각각 막는다. 공개·단일·이중·삼중의 단계가 그 세 곳 중 어디까지 가렸는지를 가리킨다.
- 위약 대조. 대조군에 겉모습이 같은 비활성 처치를 주지 않으면 처리효과와 심리적 효과가 뒤섞인다.
- 수술처럼 완전한 이중눈가림이 불가능한 경우에는 결과평가자 눈가림이 현실적인 절충이다.
무작위화가 보장하는 것은 "평균적으로"이지 "이번 표본에서"가 아니다. 한 번의 무작위 배정에서도 우연히 불균형이 생길 수 있고, 그 불확실성을 정량화하는 것이 이 책의 나머지가 하는 일이다. 표본이 작을수록 이 우연의 여지가 크다.
다음 절 표본조사는 처리를 배정하지 않고 대표성 있게 관측하는 설계를 다룬다. 무작위화의 역할이 여기서는 "집단 간 균형"이 아니라 "모집단에 대한 도달"로 바뀐다.