Q-Q 그림 신뢰띠 모의실험
개요
맨 Q-Q 그림은 해석하기 어려울 수 있다. 완전한 정규성 아래에서도 표집변동 때문에 점들이 기준선 주위로 흩어지기 때문이다. 모의실험으로 만드는 점별 신뢰띠는 시각적 포락선을 제공한다. 띠 안의 점들은 정규성이라는 귀무가설과 일관되고, 띠 밖의 점들은 진짜 이탈을 시사한다. 이 페이지는 모의실험 기반 구성을 설명하고 치우친 자료에서 시연한다.
모수적 붓스트랩을 통한 구성
관측 표본 \(x_1, \ldots, x_n\)이 주어졌을 때 알고리즘은 다음과 같다.
-
모수를 추정한다. \(\hat{\mu} = \bar{x}\)와 \(\hat{\sigma} = s\)(Bessel 보정을 한 표본표준편차)를 계산한다.
-
이론적 분위수를 계산한다. \(i = 1, \ldots, n\)에 대해 플로팅 위치 \(p_i = (i - 0.5)/n\)을 써서
\[ q_i = \Phi^{-1}(p_i). \] -
관측 자료를 정렬한다. 순서통계량을 \(x_{(1)} \leq x_{(2)} \leq \cdots \leq x_{(n)}\)이라 하자.
-
귀무가설 아래에서 모의생성한다. \(b = 1, \ldots, B\)에 대해
- \(x_1^{*(b)}, \ldots, x_n^{*(b)} \overset{\text{iid}}{\sim} \mathcal{N}(\hat{\mu}, \hat{\sigma}^2)\)를 뽑는다.
- 정렬하여 모의 순서통계량 \(x_{(1)}^{*(b)} \leq \cdots \leq x_{(n)}^{*(b)}\)를 얻는다.
-
포락선을 계산한다. 각 순위 \(i\)에 대해 \(\{x_{(i)}^{*(1)}, \ldots, x_{(i)}^{*(B)}\}\)의 2.5백분위수와 97.5백분위수를 취한다.
\[ L_i = Q_{0.025}\bigl(x_{(i)}^{*(1)}, \ldots, x_{(i)}^{*(B)}\bigr), \qquad U_i = Q_{0.975}\bigl(x_{(i)}^{*(1)}, \ldots, x_{(i)}^{*(B)}\bigr). \] -
그린다. \((q_i, x_{(i)})\)를 산점으로, 적합선 \(y = \hat{\mu} + \hat{\sigma}\, q\)를, 음영 영역 \([L_i, U_i]\)를 표시한다.
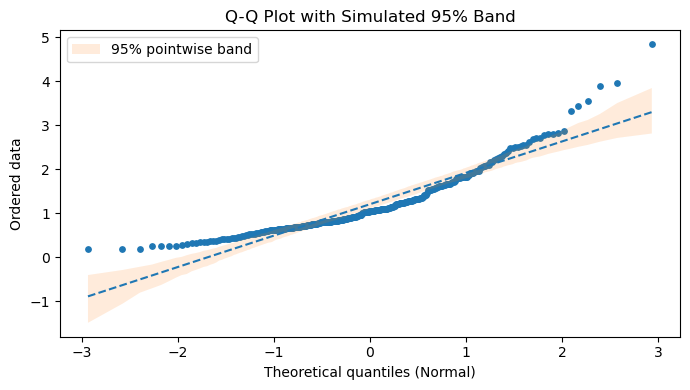
보기 1. Q-Q 그림에 95% 띠 얹기. 대수정규\((\mu = 0,\ \sigma = 0.6)\)에서 \(n = 300\)개를 뽑아, 적합된 정규분포에서 \(B = 600\)번 다시 뽑는 모수적 붓스트랩으로 95% 점별 띠를 그린다.
(1) 띠를 벗어난 점이 몇 개이며 어느 순위 구간인가. 세어 보시오. 벗어남이 흩어져 있는가, 몰려 있는가.
(2) 띠의 폭이 가운데와 양 끝에서 각각 얼마인가. 몇 배 차이인가.
(3) 띠의 아래 경계가 음수인 구간이 있다. 자료는 대수정규라 모두 양수인데 어떻게 된 일인가.
(4) 표본왜도를 대수정규의 이론값과 견주시오. 대수정규\((0, \sigma^2)\)의 왜도는 \((e^{\sigma^2} + 2)\sqrt{e^{\sigma^2} - 1}\) 이다.
풀이
(4) 의 이론값만 먼저 계산해 둔다. \(\sigma^2 = 0.36\)이므로 \(e^{0.36} = 1.43333\)이고
이다. 표준편차의 이론값은 \(\sqrt{(e^{\sigma^2}-1)e^{\sigma^2}} = \sqrt{0.43333 \times 1.43333} = 0.7881\), 평균은 \(e^{\sigma^2/2} = 1.1972\)다. 나머지는 읽기 문제다.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

def qq_with_band(x, B=800, seed=42):
    """Q-Q 그림에 모의실험으로 만든 95% 띠를 얹는다.

    Q-Q 그림의 점들은 웬만큼 흔들리기 마련이라, 직선에서 조금 벗어난 것이
    문제인지 아닌지 눈으로는 알기 어렵다. 적합한 정규분포에서 같은 크기의
    표본을 B 번 뽑아 각 자리의 2.5·97.5 백분위점을 구하면, "정규라면 이
    정도까지는 흔들린다"는 범위를 그릴 수 있다.
    """
    x = np.asarray(x, dtype=float)
    n = x.size
    mu, sd = x.mean(), x.std(ddof=1)

    # 이론 분위수. 0.5 를 빼는 것은 i/n 이 마지막 점에서 1 이 되어
    # ppf 가 무한이 되는 것을 피하기 위한 흔한 보정이다.
    p = (np.arange(1, n + 1) - 0.5) / n
    q_theor = stats.norm.ppf(p)

    x_sorted = np.sort(x)

    # 적합된 정규분포에서 B 번 표본을 뽑아 각 순서통계량의 분포를 얻는다.
    rng = np.random.default_rng(seed)
    sims = np.sort(rng.normal(mu, sd, size=(B, n)), axis=1)
    lo = np.percentile(sims, 2.5, axis=0)
    hi = np.percentile(sims, 97.5, axis=0)

    fig, ax = plt.subplots(figsize=(7, 4))
    ax.scatter(q_theor, x_sorted, s=15)
    ax.plot(q_theor, mu + sd * q_theor, linestyle="--")
    ax.fill_between(q_theor, lo, hi, alpha=0.15,
                    label="95% pointwise band")
    ax.set_title("Q-Q Plot with Simulated 95% Band")
    ax.set_xlabel("Theoretical quantiles (Normal)")
    ax.set_ylabel("Ordered data")
    ax.legend()
    plt.tight_layout()
    plt.show()

rng = np.random.default_rng(123)
x = rng.lognormal(mean=0.0, sigma=0.6, size=300)
qq_with_band(x, B=600, seed=7)
그림에서 읽을 수치를 따로 찍어 둔다.
def runs(mask):
    """True 인 자리를 연속 구간으로 묶는다 (1 부터 센 순위로)."""
    idx = np.where(mask)[0]
    if idx.size == 0:
        return []
    out, start, prev = [], idx[0], idx[0]
    for j in idx[1:]:
        if j == prev + 1:
            prev = j
        else:
            out.append((start + 1, prev + 1))
            start = prev = j
    out.append((start + 1, prev + 1))
    return out

rng = np.random.default_rng(123)
x = rng.lognormal(mean=0.0, sigma=0.6, size=300)

n = x.size
mu, sd = x.mean(), x.std(ddof=1)
p = (np.arange(1, n + 1) - 0.5) / n
q = stats.norm.ppf(p)
x_sorted = np.sort(x)

sims = np.sort(np.random.default_rng(7).normal(mu, sd, size=(600, n)), axis=1)
lo = np.percentile(sims, 2.5, axis=0)
hi = np.percentile(sims, 97.5, axis=0)

above, below = x_sorted > hi, x_sorted < lo
print(f"적합된 정규: mu-hat {mu:.4f}, sd-hat {sd:.4f}")
print(f"띠 밖의 점 {above.sum() + below.sum()}/{n} "
      f"({100 * (above.sum() + below.sum()) / n:.1f}%)")
print(f"  위로 벗어난 구간(순위): {runs(above)}")
print(f"  아래로 벗어난 순위 범위: {np.where(below)[0].min() + 1}"
      f" ~ {np.where(below)[0].max() + 1}  ({below.sum()}점)")

width = hi - lo
print(f"띠 폭: 가운데 최솟값 {width.min():.4f}, 양 끝 {width[0]:.4f} / "
      f"{width[-1]:.4f}, 최대/최소 = {width.max() / width.min():.2f}")
print(f"띠 하한의 최솟값 {lo.min():.4f}   자료 최솟값 {x_sorted[0]:.4f}")
print(f"P(적합된 정규 < 0) = {stats.norm.cdf(0, mu, sd):.4f}")
print(f"최댓값 {x_sorted[-1]:.4f}  띠 상한 {hi[-1]:.4f}  "
      f"({x_sorted[-1] / hi[-1]:.2f}배)")

s2 = 0.6 ** 2
print(f"\n이론: 평균 {np.exp(s2 / 2):.4f}  sd "
      f"{np.sqrt((np.exp(s2) - 1) * np.exp(s2)):.4f}  왜도 "
      f"{(np.exp(s2) + 2) * np.sqrt(np.exp(s2) - 1):.4f}")
print(f"표본: 평균 {mu:.4f}  sd {sd:.4f}  g1 {stats.skew(x):.4f}"
      f"  G1 {stats.skew(x, bias=False):.4f}")
print(f"샤피로-윌크 p = {stats.shapiro(x)[1]:.4g}")
출력:
적합된 정규: mu-hat 1.2044, sd-hat 0.7138
띠 밖의 점 204/300 (68.0%)
  위로 벗어난 구간(순위): [(1, 48), (278, 293), (295, 300)]
  아래로 벗어난 순위 범위: 103 ~ 241  (134점)
띠 폭: 가운데 최솟값 0.1994, 양 끝 1.0862 / 1.0342, 최대/최소 = 5.45
띠 하한의 최솟값 -1.4917   자료 최솟값 0.1807
P(적합된 정규 < 0) = 0.0458
최댓값 4.8422  띠 상한 3.8469  (1.26배)

이론: 평균 1.1972  sd 0.7881  왜도 2.2601
표본: 평균 1.2044  sd 0.7138  g1 1.5056  G1 1.5132
샤피로-윌크 p = 3.877e-14
(1) 300점 가운데 204점(68%)이 띠 밖이고, 흩어져 있지 않고 세 덩어리로 몰려 있다.
| 순위 구간 | 점 개수 | 방향 |
|---|---|---|
| \(1 \sim 48\) | 48 | 띠 위 |
| \(103 \sim 241\) | 134 | 띠 아래 |
| \(278 \sim 300\) | 22 | 띠 위 |
이 세 덩어리가 "위–아래–위" 순서로 늘어선 것이 오른쪽 치우침의 서명이다. 왼쪽 끝이 띠 위에 있는 것은 자료의 왼쪽 꼬리가 적합된 정규분포보다 짧기 때문이고(대수정규는 0 에서 잘린다), 오른쪽 끝이 띠 위에 있는 것은 오른쪽 꼬리가 길기 때문이다. 가운데가 띠 아래로 내려앉는 것은 자료의 중앙값(\(\approx 1.0\))이 평균 \(1.2044\)보다 작기 때문이다. 아래로 볼록이 아니라 위로 휘는 곡선 전체가 이렇게 나타난다.
몰려 있다는 사실 자체가 중요하다. 순서통계량은 강하게 양의 상관을 가지므로 \(x_{(i)}\)가 띠를 벗어나면 \(x_{(i+1)}\)도 벗어나기 쉽다. 그래서 벗어난 점의 개수를 "\(0.05 \times 300 = 15\)개"와 견주는 것은 뜻이 없다. 연습문제 1 에서 보듯 참으로 정규인 표본에서는 평균 \(0.7\)개만 벗어나고 \(78\%\)의 표본에서는 하나도 벗어나지 않는다. 204 개는 그 기준에서 압도적인 신호다. 샤피로–윌크의 \(p = 3.9\times10^{-14}\)가 같은 말을 한 수로 요약한다.
(2) 띠 폭이 5.45배 차이 난다. 가운데에서 가장 좁은 곳이 \(0.1994\)인데 양 끝은 \(1.0862\)와 \(1.0342\)다. 띠가 나팔처럼 벌어지는 까닭은 순서통계량의 분산이 꼬리에서 크기 때문이다 — 연습문제 3 에서 유도한다.
이것이 띠를 그리는 이유다. 띠가 없다면 양 끝 점이 적합선에서 \(1.0\) 벗어난 것과 가운데 점이 \(0.2\) 벗어난 것 가운데 어느 쪽이 더 심각한지 눈으로 판단할 수 없다. 띠가 그 환산율을 그림 위에 직접 그려 준다.
(3) 적합된 정규분포가 음수를 허용하기 때문이다. \(\hat\mu = 1.2044\), \(\hat\sigma = 0.7138\)인 정규분포는
로 전체 질량의 \(4.6\%\)를 음수에 둔다. \(n = 300\)이면 음수가 평균 14개쯤 나오는 셈이고, 그래서 가장 작은 순서통계량의 모의분포가 음수 영역에 걸쳐 띠 하한이 \(-1.4917\)까지 내려간다. 반면 자료의 최솟값은 \(0.1807\)이다.
이것만으로도 정규 모형은 기각된다. 띠를 그리거나 검정을 돌릴 필요도 없이, "길이·가격·소득처럼 양수일 수밖에 없는 양에 정규분포를 적합하면 모형이 불가능한 영역에 질량을 준다"는 사실이 드러난 것이다. 변동계수 \(\hat\sigma/\hat\mu = 0.59\)처럼 산포가 큰 양수 자료에서는 늘 이 문제가 생기며, 로그 변환이 표준 처방인 까닭이기도 하다.
(4) 표본왜도가 이론값보다 한참 작다. \(g_1 = 1.5056\)(보정판 \(G_1 = 1.5132\))인데 이론값은 \(2.2601\)이다. \(33\%\) 작다. 표준편차도 \(0.7138\) 대 이론 \(0.7881\)로 \(9\%\) 작다.
우연이 아니라 오른쪽 꼬리가 긴 분포에서 늘 일어나는 일이다. 왜도는 세제곱 적률이라 그 추정의 변동이 6차 적률에 지배되는데, 대수정규의 고차 적률은 \(e^{k^2\sigma^2/2}\)로 폭발적으로 커진다(\(\sigma = 0.6\)에서 6차 적률은 \(e^{6.48} = 652\)다). 그런 분포에서 \(g_1\)의 표본분포는 오른쪽으로 길게 늘어지고 중앙값이 참값 아래에 놓인다. 평균을 떠받치는 것은 극단적으로 큰 관측값이 섞인 드문 표본이고, 대다수 표본은 참값을 밑돈다.
요점은 두 가지다. 첫째, 보고된 왜도 하나를 소수점까지 믿지 말라. 둘째, 그런데도 방향은 맞는다 — \(1.5\)든 \(2.3\)이든 "오른쪽으로 치우쳤다"는 결론은 같다. 크기를 쓰려면 붓스트랩 구간을 함께 보고해야 한다.
scipy.stats.skew의 기본값은 bias=True이므로 위 출력의 \(1.5056\)은 보정하지 않은 \(g_1\)이다. \(n = 300\)에서 두 판본의 차이는 \(0.5\%\)로 결론에 영향이 없다.
점별 띠와 동시 띠
위에서 설명한 띠는 점별(pointwise)이다. 각 개별 순위 \(i\)에 대해 정규 순서통계량이 \([L_i, U_i]\) 안에 들어갈 확률이 95%라는 뜻이다. 그러나 \(n\)개 점이 모두 동시에 각자의 구간 안에 들어갈 확률은 95%보다 작다. 동시(simultaneous) 띠(Bonferroni 보정에 해당)는 더 넓을 것이다. 그럼에도 점별 띠가 표준 관행인 이유는 지나치게 보수적이지 않으면서 유용한 시각적 안내를 주기 때문이다.
해석
위 대수정규 예에서는 위쪽 꼬리의 점들이 신뢰띠를 벗어나 음영 영역 위로 휘어 올라간다. 형식적 검정도 탐지했을 오른쪽 치우침을 시각적으로 확인해 준다. 진짜 정규분포에서 뽑은 자료라면 대부분의 점이 띠 안에 놓이고 가끔 우연히 벗어나는 정도이다.
\"5%씩 벗어난다\"는 계산은 성립하지 않는다
각 순위가 개별적으로 5% 확률로 띠를 벗어나므로 \(n = 200\)이면 약 10개가 밖에 있을 것이라고 생각하기 쉽다. 틀렸다. 실제로는 평균 약 0.7개이고, 정규표본의 약 78%에서는 벗어나는 점이 하나도 없다. 이유는 연습문제 1에서 다룬다.
연습문제
연습문제 1. 표준정규 관측값 \(n = 200\)개를 생성하라. \(B = 1000\)번의 모의실험으로 95% 점별 띠를 갖는 Q-Q 그림을 만들어라. 거의 모든 점이 띠 안에 들어가는지 확인하라.
풀이
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt

rng = np.random.default_rng(0)
x = rng.normal(0, 1, size=200)

n = x.size
mu, sd = x.mean(), x.std(ddof=1)
p = (np.arange(1, n + 1) - 0.5) / n
q = stats.norm.ppf(p)
x_sorted = np.sort(x)

sims = np.sort(rng.normal(mu, sd, size=(1000, n)), axis=1)
lo = np.percentile(sims, 2.5, axis=0)
hi = np.percentile(sims, 97.5, axis=0)

outside = np.sum((x_sorted < lo) | (x_sorted > hi))
print(f"Points outside band: {outside} / {n}")

fig, ax = plt.subplots(figsize=(7, 4))
ax.scatter(q, x_sorted, s=15)
ax.plot(q, mu + sd * q, linestyle="--")
ax.fill_between(q, lo, hi, alpha=0.15, label="95% band")
ax.legend()
ax.set_title("Q-Q Plot with 95% Band (Normal Data)")
plt.tight_layout()
plt.show()
출력:
Points outside band: 1 / 200
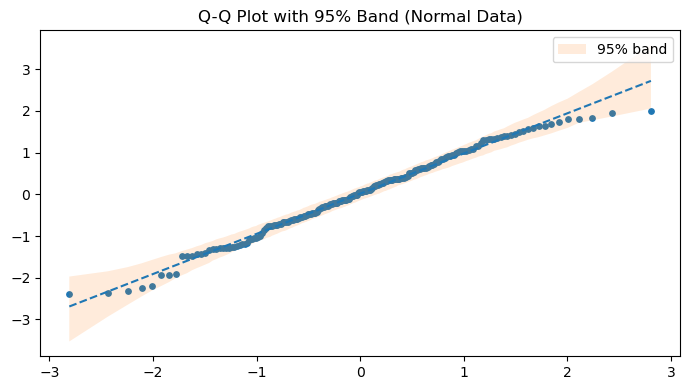
왜 10개가 아니라 1개인가? 순진한 계산 \(0.05 \times 200 = 10\)은 200개 순위의 벗어남이 서로 독립이라고 가정한다. 두 가지 이유로 성립하지 않는다.
-
순서통계량은 강하게 양의 상관을 갖는다. \(x_{(i)}\)가 크면 \(x_{(i+1)}\)도 클 수밖에 없다. 그래서 벗어남이 흩어지지 않고 연속된 구간(run)으로 몰려서 일어난다.
-
더 중요하게, 띠가 표본 자신의 \(\hat{\mu}, \hat{\sigma}\)를 중심으로 만들어진다. 모수적 붓스트랩이 적합된 모수에 조건부로 작동하므로, 변동의 가장 큰 두 성분인 위치와 척도가 이미 제거되어 있다. 관측 순서통계량이 구성상 띠의 중심에 고정되는 것이다.
실제로 정규표본 400개에 대해 반복하면 벗어나는 점의 개수는 평균 \(0.67\), 중앙값 0이고 표본의 \(77.5\%\)에서 하나도 벗어나지 않는다. 다만 분포의 꼬리가 두꺼워서 드물게 20개 이상이 한꺼번에 벗어나기도 한다. 상관된 벗어남이 몰려서 나타나기 때문이다.
실무적 함의: 이 띠는 명목 95%보다 훨씬 보수적이다. 한 점이라도 벗어나면 주목할 만한 신호로 보아야 한다. \(\square\)
연습문제 2. 연습문제 1을 \(t_4\) 분포에서 뽑은 관측값 \(n = 200\)개로 반복하라. Q-Q 그림의 어느 부분이 띠를 벗어나는지 찾고 그 이유를 설명하라.
풀이
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt

rng = np.random.default_rng(1)
x = rng.standard_t(df=4, size=200)

n = x.size
mu, sd = x.mean(), x.std(ddof=1)
p = (np.arange(1, n + 1) - 0.5) / n
q = stats.norm.ppf(p)
x_sorted = np.sort(x)

sims = np.sort(rng.normal(mu, sd, size=(1000, n)), axis=1)
lo = np.percentile(sims, 2.5, axis=0)
hi = np.percentile(sims, 97.5, axis=0)

fig, ax = plt.subplots(figsize=(7, 4))
ax.scatter(q, x_sorted, s=15)
ax.plot(q, mu + sd * q, linestyle="--")
ax.fill_between(q, lo, hi, alpha=0.15, label="95% band")
ax.legend()
ax.set_title("Q-Q Plot with 95% Band (t4 Data)")
plt.tight_layout()
plt.show()
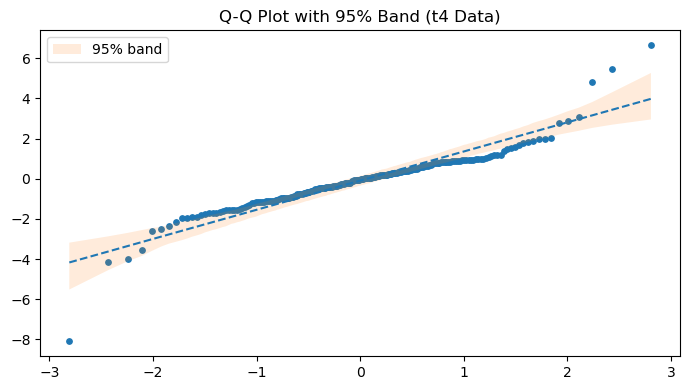
\(t_4\) 분포는 정규분포보다 꼬리가 훨씬 두껍다. \(t_\nu\)의 초과첨도는 \(\nu > 4\)일 때 \(6/(\nu - 4)\)인데, \(\nu = 4\)에서는 이 값이 발산한다(네 번째 적률이 존재하지 않는다). 따라서 표본첨도가 표본마다 크게 요동하며 매우 큰 값이 자주 나온다.
Q-Q 그림에서 가장 작은 순서통계량들은 띠의 아래 경계 밑으로 떨어지고(기대보다 더 음수) 가장 큰 순서통계량들은 위 경계 위로 올라간다(기대보다 더 양수). 포락선 밖으로 튀어나가는 특징적인 S자 모양이 나타난다.
연습문제 1에서 본 대로 이 띠는 매우 보수적이므로, 양 끝에서 띠를 벗어난다는 것은 꼬리 이탈이 상당히 크다는 강한 증거이다. \(\square\)
연습문제 3. 신뢰띠가 중앙 근처보다 꼬리(극단 분위수)에서 더 넓은 이유를 수학적으로 설명하라.
풀이
\(\mathcal{N}(\mu, \sigma^2)\)에서 나온 \(i\)번째 순서통계량의 분산은 근사적으로
여기서 \(p_i = i/(n+1)\)이고 \(\phi\)는 표준정규 밀도이다.
중앙 근처(\(p_i \approx 0.5\))에서는 \(\phi(\Phi^{-1}(0.5)) = \phi(0) = 1/\sqrt{2\pi} \approx 0.399\)로 최대이므로 분모가 커서 분산이 작다. 꼬리(\(p_i\)가 0이나 1에 가까울 때)에서는 \(\phi(\Phi^{-1}(p_i))\)가 매우 작아진다(정규 밀도가 빠르게 감쇠한다). 예컨대 \(p_i = 0.01\)이면 \(\phi(-2.326) = 0.0267\)로 중앙의 \(1/15\)에 불과하고, 제곱되어 분모에 들어가므로 분산이 크게 늘어난다.
분자 \(p_i(1-p_i)\)는 꼬리에서 오히려 작아지지만(\(0.01 \times 0.99 = 0.0099\) 대 \(0.25\)), 분모의 감소가 훨씬 빠르다. \(p_i = 0.01\)에서 비율은 \(\frac{0.0099}{0.0267^2} = 13.9\)이고 \(p_i = 0.5\)에서는 \(\frac{0.25}{0.399^2} = 1.57\)이므로 분산이 약 9배 크다.
결과적으로 모의 순서통계량의 산포가 꼬리에서 훨씬 커지고 신뢰띠가 나팔 모양으로 벌어진다. \(\square\)
연습문제 4. 99% 점별 띠를 만들도록 모의실험을 수정하라. 폭이 95% 띠와 비교해 어떠한가?
풀이
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt

rng = np.random.default_rng(0)
x = rng.normal(0, 1, size=200)

n = x.size
mu, sd = x.mean(), x.std(ddof=1)
p = (np.arange(1, n + 1) - 0.5) / n
q = stats.norm.ppf(p)
x_sorted = np.sort(x)

sims = np.sort(rng.normal(mu, sd, size=(1000, n)), axis=1)
lo95 = np.percentile(sims, 2.5, axis=0)
hi95 = np.percentile(sims, 97.5, axis=0)
lo99 = np.percentile(sims, 0.5, axis=0)
hi99 = np.percentile(sims, 99.5, axis=0)

print(f"Median width ratio: {np.median((hi99 - lo99) / (hi95 - lo95)):.3f}")

fig, ax = plt.subplots(figsize=(7, 4))
ax.fill_between(q, lo99, hi99, alpha=0.10, label="99% band")
ax.fill_between(q, lo95, hi95, alpha=0.15, label="95% band")
ax.scatter(q, x_sorted, s=15, zorder=3)
ax.plot(q, mu + sd * q, linestyle="--")
ax.legend()
ax.set_title("95% vs 99% Pointwise Bands")
plt.tight_layout()
plt.show()
출력:
Median width ratio: 1.305
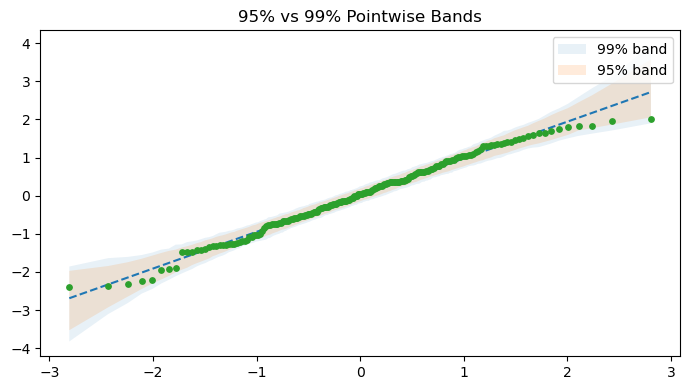
99% 띠는 모의 순서통계량의 0.5백분위수와 99.5백분위수를 쓰므로 모든 순위에서 95% 띠보다 넓다. 순서통계량의 분포가 근사적으로 정규이므로 폭의 비율은 대략
이다. 모의실험에서 얻은 중앙값 \(1.305\)가 이 예측과 잘 맞는다. 곧 99% 띠는 약 31% 더 넓다. \(\square\)
연습문제 5. Bonferroni 보정을 써서 점별 띠를 근사적 동시 띠로 바꾸는 방법을 기술하라. 명목 전체 수준이 95%이고 \(n = 100\)이면 각 개별 구간은 어떤 신뢰수준을 써야 하는가?
풀이
전체 수준 \(1 - \alpha\)의 동시 띠를 얻으려면 Bonferroni 보정에 따라 \(n\)개 점별 구간 각각이 수준 \(1 - \alpha/n\)을 가져야 한다. \(\alpha = 0.05\), \(n = 100\)이면 각 구간이 확률 \(1 - 0.05/100 = 0.9995\)를 덮어야 한다.
모의실험에서는 \(2.5\%\)와 \(97.5\%\) 대신 모의 순서통계량의 \(0.025\%\)와 \(99.975\%\) 백분위수를 쓴다. 훨씬 넓은 띠가 만들어진다. 정규분위수가 \(z_{0.975} = 1.96\)에서 \(z_{0.99975} \approx 3.48\)로 바뀌므로 폭이 약 1.8배가 된다.
보수적이기는 하지만 귀무가설 아래에서 \(n\)개 점이 모두 동시에 띠 안에 있을 확률이 최소 95%임을 보장한다.
다만 실무에서 Bonferroni 띠는 큰 \(n\)에 대해 지나치게 보수적이다. 순서통계량이 강하게 상관되어 있어 Bonferroni가 가정하는 최악의 경우(독립)와 거리가 멀기 때문이다. 더 정교한 동시 띠(예: Kolmogorov-Smirnov 분포에 기반한 것)가 선호된다. 또한 연습문제 1에서 보았듯 모수적 붓스트랩 점별 띠 자체가 이미 상당히 보수적이므로, 실용적으로는 Bonferroni 보정 없이 쓰는 편이 낫다. \(\square\)
정리하며
신뢰띠가 Q-Q 그림 읽기의 기준선을 준다.
- 문제는 맨 Q-Q 그림의 해석이 어렵다는 것이다. 완전한 정규 자료에서도 점들이 흔들리며, 얼마나 벗어나야 "진짜"인지 눈으로는 알 수 없다.
- 모수적 부트스트랩으로 만든다. 적합된 정규분포에서 같은 크기의 표본을 반복해 뽑고, 각 순서통계량의 분포에서 분위수를 취한다.
- 띠가 꼬리에서 넓다. 극단 순서통계량의 변동이 크기 때문이며, 꼬리에서 조금 벗어난 것은 정상임을 그림이 직접 알려 준다.
- 점별 띠와 동시 띠가 다르다. 점별 띠는 각 점에 대해 \(95\%\) 이므로, 여러 점 중 일부가 밖으로 나가는 것은 우연히도 흔하다. 9장의 다중검정 문제가 여기서도 나타난다.
- 치우친 자료에서 효과가 분명하다. 점들이 띠를 체계적으로 벗어나는 모양이 보인다.
다음 절 상자그림의 모양으로 넘어간다.