독립성 검정¶
개요¶
들어가는 이야기 — 행과 열의 합만 있으면 끝까지 계산된다
두 범주형 변수가 「무관하다」는 말을 수 하나로 바꾸는 일이 이 쪽의 주제다. 바꾸는 열쇠는 기대도수이고, 행과 열의 합만 있으면 그것이 끝까지 계산된다.
성인 \(2237\) 명에게서 성별과 주로 쓰는 손을 기록했다. 열 합이 남성 \(1067\), 여성 \(1170\) 이니 비율은 \(0.477\) 대 \(0.523\) 이다. 무관하다면 어느 행이든 그 비율로 쪼개져야 한다. 행 합은 오른손 \(2004\), 왼손 \(205\), 양손 \(28\) 이다. 오른손잡이 \(2004\) 명은 남성 \(934\) 대 여성 \(1070\) 으로 그 비율에 거의 맞는다. 그런데 양손잡이 \(28\) 명은 기대가 \(13.4\) 대 \(14.6\) 인데 실제가 \(20\) 대 \(8\) 이다.
그 한 행이 통계량의 절반 넘게 낸다 — \((20-13.4)^2/13.4 + (8-14.6)^2/14.6 = 6.2\) 이고 표 전체가 \(X^2 = 11.81\) 이다. 세 줄 가운데 둘은 멀쩡해 보이고 한 줄은 두 배 반이니, 눈으로는 이것이 우연인지 아닌지 가려지지 않는다.
그 수를 어떻게 만들고, 얼마나 커야 「우연이 아니다」라고 할 것인가. 이 쪽이 기대도수를 세워 통계량과 자유도를 얻고, 양손잡이처럼 드문 범주에서 근사가 흔들릴 때 주변합을 고정한 채 표를 다시 뽑아 확인하는 길까지 간다. 아래 상자가 이 검정이 행을 섞어도 값이 같다는 성질을 따라간다.
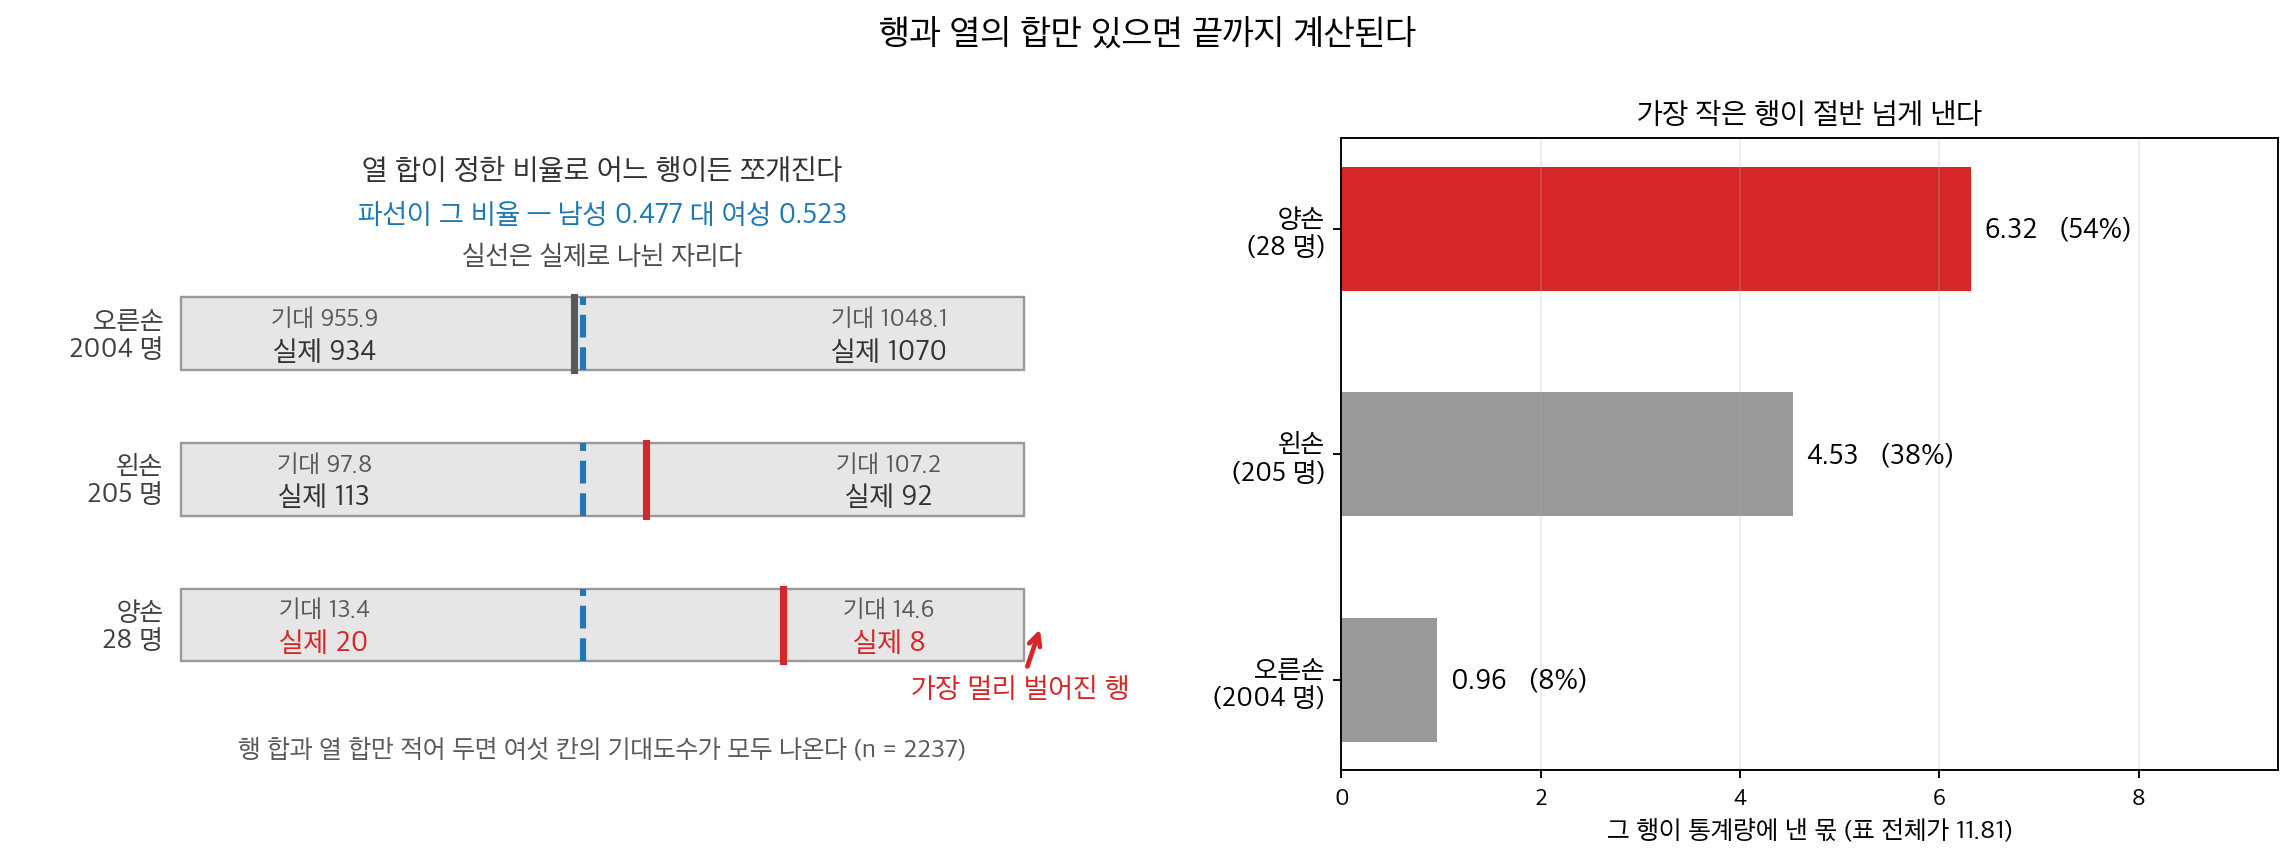
왼쪽. 행 합과 열 합만 적어 두면 여섯 칸의 기대도수가 모두 나온다 — 열 합이 정한 \(0.477\) 대 \(0.523\) 으로 어느 행이든 쪼개지는 것이고, 그 자리가 파선이다. 실선은 실제로 나뉜 자리다. 오른손 행은 두 선이 거의 겹치는데 양손 \(28\) 명은 기대가 \(13.4\) 대 \(14.6\) 인 자리에서 실제가 \(20\) 대 \(8\) 이라 실선이 멀리 가 있다. 오른쪽. 그 가장 작은 행이 통계량 \(11.81\) 의 \(54\%\) 를 낸다. (본문이 적는 \(6.2\) 는 기대도수를 \(13.4 \cdot 14.6\) 으로 반올림한 뒤 계산한 값이고, 반올림하지 않으면 \(6.32\) 다.)
독립성 검정(test of independence)은 두 범주형 변수 사이에 유의한 관계가 있는지 판정하는 통계 기법이다. 본질적으로 "한 변수의 발생이 다른 변수의 발생에 영향을 주는가?"라는 질문에 답하도록 돕는다. 두 변수가 독립이면 한 변수의 변화가 다른 변수의 분포에 아무런 영향을 주지 않아야 한다.
이 절은 방법과 그것이 변하는 자리들을 다룬다 — \(3\times2\)·\(3\times3\)·\(3\times5\) 표, 예이츠 보정이 켜지고 꺼지는 자리, 재표본의 두 설계. 실자료 \(2\times2\) 하나를 표집 설계를 가리는 일부터 효과크기(effect size)와 신뢰구간까지 끝까지 끌고 가는 것은 다음 절 타이타닉 생존과 성별: 설계 판별부터 완전한 보고까지이다.
1. 물음 — 두 변수가 서로 얽혀 있는가¶
한 변수가 아니라 두 변수를 동시에 보는 경우를 생각하자. \(100\) 명을 무작위로 뽑아 성별과 어떤 제품에 대한 선호를 함께 적었다고 하자. 물음은 「남성이 더 좋아하는가」가 아니라 「성별을 알면 선호에 대해 아는 것이 생기는가」이다.
생기지 않는다면 두 변수는 독립이다. 독립은 칸의 확률이 주변확률의 곱으로 쪼개진다는 말이고, 그것이 귀무가설(null hypothesis)이다.
적합도 검정(goodness-of-fit test)과 다른 점이 하나 있다. 거기서는 견줄 비율 \(p_i^0\) 가 바깥에서 왔다. 여기서는 바깥의 기준이 없다 — 주변확률 \(p_{i\cdot}\) 와 \(p_{\cdot j}\) 를 자료에서 얻어 써야 한다. 그 때문에 자유도가 달라지고, §\(3\) 이 그 자리를 짚는다.
2. 통계량 — 독립이라면 각 칸에 몇이 놓여야 하는가¶
두 변수를 가로와 세로로 놓고 센 표를 분할표라 한다.
| 좋아함 | 싫어함 | 합계 | |
|---|---|---|---|
| 남성 | \(30\) | \(20\) | \(50\) |
| 여성 | \(25\) | \(25\) | \(50\) |
| 합계 | \(55\) | \(45\) | \(100\) |
독립이 참이라면 각 칸의 확률이 주변확률의 곱이므로, 기대도수는 행 합과 열 합을 곱해 총합으로 나눈 값이다.
위 표에서 남성이면서 좋아함인 칸은 \(E_{11} = 50 \times 55 / 100 = 27.5\) 이고, 네 칸이 차례로 \(27.5\), \(22.5\), \(27.5\), \(22.5\) 가 된다. 도수가 정수인데 기대도수는 정수가 아니어도 된다 — 기대도수는 세어 본 수가 아니라 \(H_0\) 가 가리키는 자리이기 때문이다.
이제 칸마다의 불일치를 적합도 검정과 똑같이 모은다. 칸이 두 첨자를 갖는 것만 다르다.
위 표는 네 칸 모두 불일치가 \(\pm 2.5\) 라 \(X^2 = 1.0101\) 이 된다.
3. 표집분포 — 자유로운 칸은 (r−1)(c−1) 개다¶
\(H_0\) 가 참이면 이 통계량도 카이제곱분포(chi-squared distribution)로 수렴한다. 달라지는 것은 자유도뿐이다.
왜 \((r-1)(c-1)\) 인지는 칸을 세어 보면 보인다. 표에 칸이 \(rc\) 개 있지만 행 합과 열 합이 모두 자료로 고정되어 있으므로, 왼쪽 위 \((r-1) \times (c-1)\) 개를 채우고 나면 나머지는 합을 맞추느라 저절로 정해진다. 위의 \(2 \times 2\) 표라면 한 칸만 자유롭고 \(\mathrm{df} = 1\) 이다. 같은 수를 세는 다른 두 가지 길은 11.1절 자유도를 얻는 세 가지 길에 있다.
큰 쪽만 증거가 된다. 어느 칸이 넘치든 모자라든 제곱해서 더하므로 통계량은 커지기만 하고, 기각역(rejection region)은 오른쪽 꼬리 하나다. 다만 이 수렴에는 조건이 있다 — 칸의 기대도수가 너무 작으면 근사가 무너진다. 그 자리는 표를 한 번 끝까지 풀어 본 뒤 §\(6\) 에서 따진다.
4. 검정 — 꼬리를 읽고 판정한다¶
임계값 \(\chi^2_{\mathrm{df},\,1-\alpha}\) 와 견주든 \(p\) 값 \(P(\chi^2_{\mathrm{df}} \ge X^2_{\text{관측}})\) 을 \(\alpha\) 와 견주든 결론은 같다. 위 표라면 \(\mathrm{df} = 1\) 에서 \(p = 0.3149\) 이므로 기각하지 못한다.
기각했다면 두 변수가 독립이 아니며 서로 연관이 있다는 뜻이다. 기각하지 못했다면 「독립이다」가 아니라 「연관이 있다는 증거가 부족하다」는 뜻이다. \(100\) 명으로는 꽤 큰 연관도 놓친다 — 두 가설은 대칭이 아니다(9.1절 두 가설은 대칭이 아니다).
\(2 \times 2\) 표를 코드에 넘기면 수가 달라진다
scipy.stats.chi2_contingency 는 \(2 \times 2\) 일 때 예이츠 연속성 보정을 기본으로
켠다. 위 표를 그대로 넘기면 \(X^2 = 1.0101\) 이 아니라 \(0.6465\) 가 나오고 \(p\) 도
\(0.3149\) 가 아니라 \(0.4214\) 다. 그 보정이 무엇을 사고 무엇을 내주는지는 아래
§\(5\) 가 재어 둔다.
5. 문제 A: 성별과 주로 쓰는 손¶
문제 1.
여러 사람을 무작위로 뽑아 성별과 주로 쓰는 손을 함께 기록했다.
성별과 주로 쓰는 손 사이에 관계가 있는가, 아니면 두 변수는 독립인가?
풀이
귀무가설은 성별과 주로 쓰는 손이 독립이라는 것이다. 아래에서 기대도수를 세우고 \(X^2 = 11.8061\) 을 얻는다. 자유도는 \((3-1)(2-1) = 2\) 이고 임계값이 \(5.9915\) 이므로 기각역에 들어간다 — \(p = 0.0027\) 이다. 독립이라고 보기 어렵다.
셈을 끝까지 따라가는 것은 아래 보기 1 이다.
주변합은 그대로 두고 안쪽만 다시 나눈다¶
두 변수가 독립이라면 칸의 확률이 주변확률의 곱이다. 남성이면서 오른손잡이인 칸이라면
이므로 둘을 곱하고 다시 \(n = 2237\) 을 곱해
을 얻는다. \(n\) 이 한 번 약분되어 행 합 곱하기 열 합 나누기 총합만 남는 것이 \(\S 2\) 의 그 식이다. 여섯 칸을 모두 채우면 이렇게 된다.
행 합과 열 합이 관측표와 글자 그대로 같다. 기대도수는 주변합을 그대로 두고 안쪽만 독립이 시키는 대로 다시 나눈 표이고, 그래서 자유로운 칸이 둘뿐이다.
어디가 어긋났고, 그것이 큰가¶
눈으로 보면 오른손 행은 관측과 기대가 거의 같고(\(934\) 대 \(956\)), 양손 행이 멀다 (\(20\) 대 \(13\)). 가장 작은 행이 가장 크게 어긋난 것인데, 분모가 작으면 같은 차이도 크게 세어지므로 그 한 행이 통계량의 절반을 넘게 낸다.
\(p = 0.0027\) 이니 기각한다. 그런데 기각은 「연관이 있다」까지만 말한다. 이 표의 Cramér의 \(V\) 는 \(0.0726\) 으로 흔히 쓰는 기준에서 「무시할 만함」에 들어간다. \(2{,}237\) 명이라는 큰 표본이 작은 연관을 유의하게 만든 것이고, 둘은 다른 이야기다 — 크기를 재는 일은 11.3절 효과크기와 Cramér의 V가 맡는다.
식을 그대로 코드로 옮기면¶
보기 1. 정의대로 계산한 독립성 검정. 위의 성별 × 주로 쓰는 손 표를 쓴다. 행 합은 \(R_1 = 2{,}004\), \(R_2 = 205\), \(R_3 = 28\), 열 합은 \(C_1 = 1{,}067\), \(C_2 = 1{,}170\), 총합은 \(n = 2{,}237\) 이다.
(1) 독립 아래의 기대도수가 \(E_{ij} = R_i C_j / n\) 임을 보이고, 이 기대표가 관측표의 행 합과 열 합을 그대로 보존함을 확인하시오. 자유도가 \((r-1)(c-1)\) 인 까닭이 여기에 있다.
(2) 열이 둘뿐인 \(r \times 2\) 표에서는 검정통계량(test statistic)이
으로 줄어듦을 보이고 이 표의 \(X^2\) 을 구하시오.
(3) scipy.stats.chi2_contingency 를 쓰지 않고 정의대로 계산하는 코드를 돌려 (2)의 답과 맞는지 확인하고 p 값을 구하시오.
풀이
(1) 기대도수와 자유도. 두 변수가 독립이면 결합확률이 주변확률의 곱이다. 주변확률을 표본에서 읽으면 \(\hat P(i\text{행}) = R_i/n\), \(\hat P(j\text{열}) = C_j/n\) 이므로
이다. 이 기대표는 주변합을 보존한다.
보존이 곧 자유도의 정체다. 칸별 불일치 \(O_{ij} - E_{ij}\) 는 \(rc\) 개이지만 자유롭게 움직이지 못한다. 행마다 합이 \(0\) 이라는 제약이 \(r\) 개, 열마다 합이 \(0\) 이라는 제약이 \(c\) 개 붙고, 그중 하나는 나머지로부터 따라 나오므로(전체 합이 \(0\)) 겹친다. 독립인 제약이 \(r + c - 1\) 개이니 남는 자유도는
이다. 여기서는 \((3-1)(2-1) = 2\) 다.
(2) \(r \times 2\) 의 닫힌 꼴. 열이 둘뿐이면 "행 합이 보존된다"는 제약이 한 행의 두 칸을 한 수로 묶어 준다. \(i\) 행에서
이므로 \(i\) 행의 기여는 \(d_i\) 하나로 적힌다.
마지막 등식은 \(C_1 + C_2 = n\) 을 썼다. 행에 대해 더하면 주장한 식이다.
수를 넣는다.
열 합도 보존되므로 \(d_1 + d_2 + d_3 = 0\) 이어야 하고 실제로 그렇다. 그러면
세 항의 크기를 보라. 오른손잡이 행은 불일치가 가장 큰데도(\(d_1 = -21.9\)) 기여가 가장 작다. \(R_i\) 로 나누기 때문이다. 불일치는 그 행이 얼마나 큰지에 비추어 재야 한다. 양손잡이 28 명에서 6.6 명이 어긋난 것이 오른손잡이 2,004 명에서 21.9 명이 어긋난 것보다 훨씬 심각하다.
(3) 수치적으로.
import matplotlib.pyplot as plt
import numpy as np
from scipy import stats

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

def compute_expected(observed_counts):
    """관측도수로부터 독립 아래의 기대도수를 계산한다.

    독립의 정의 P(A and B) = P(A)P(B)를 그대로 옮긴 것이다.
    주변 확률의 곱으로 결합 확률을 만들고 전체 개수를 곱한다.
    """
    row_totals = observed_counts.sum(axis=1)
    col_totals = observed_counts.sum(axis=0)

    # reshape로 (r,1)과 (1,c)를 만들면 브로드캐스팅으로 (r,c) 곱이 나온다.
    row_pmf = row_totals.reshape((-1, 1)) / row_totals.sum()
    col_pmf = col_totals.reshape((1, -1)) / col_totals.sum()

    joint_pmf = row_pmf * col_pmf
    expected_counts = joint_pmf * row_totals.sum()

    return expected_counts

# 분할표 형태의 관측도수
observed_counts = np.array([[934, 1070], [113, 92], [20, 8]])
expected_counts = compute_expected(observed_counts)

# 자유도 = (행-1)(열-1)
degrees_of_freedom = (observed_counts.shape[0] - 1) * (observed_counts.shape[1] - 1)

# 검정통계량 계산
chi_squared_statistic = np.sum((observed_counts - expected_counts) ** 2 / expected_counts)
p_value = stats.chi2(degrees_of_freedom).sf(chi_squared_statistic)

# 통계량과 p 값 출력
print(f"chi_squared_statistic = {chi_squared_statistic:.02f}")
print(f"p_value = {p_value:.02%}")

# 카이제곱분포를 그리고 관측된 통계량 자리를 표시한다
fig, ax = plt.subplots(figsize=(12, 4))

x_values = np.linspace(0, chi_squared_statistic, 100)
y_values = stats.chi2(degrees_of_freedom).pdf(x_values)
ax.plot(x_values, y_values, color='b', linewidth=3)

x_fill_left = np.concatenate([[0], x_values, [chi_squared_statistic], [0]])
y_fill_left = np.concatenate([[0], y_values, [0], [0]])
ax.fill(x_fill_left, y_fill_left, color='b', alpha=0.1)

x_values_right = np.linspace(chi_squared_statistic, 20, 100)
y_values_right = stats.chi2(degrees_of_freedom).pdf(x_values_right)
ax.plot(x_values_right, y_values_right, color='r', linewidth=3)

x_fill_right = np.concatenate([[chi_squared_statistic], x_values_right, [20], [chi_squared_statistic]])
y_fill_right = np.concatenate([[0], y_values_right, [0], [0]])
ax.fill(x_fill_right, y_fill_right, color='r', alpha=0.1)

ax.annotate(f'p_value = {p_value:.02%}', xy=(12.5, 0.01), xytext=(16.5, 0.10),
            fontsize=15, arrowprops=dict(color='k', width=0.2, headwidth=8))

ax.spines['right'].set_visible(False)
ax.spines['top'].set_visible(False)
ax.spines['bottom'].set_position("zero")
ax.spines['left'].set_position("zero")

plt.show()
출력:
chi_squared_statistic = 11.81
p_value = 0.27%
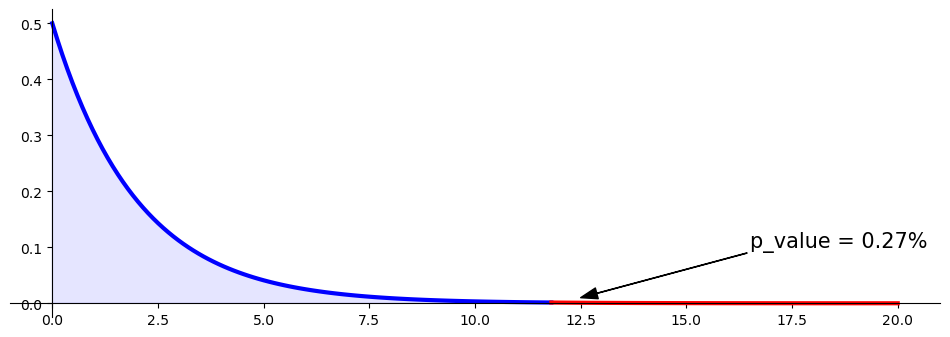
손으로 얻은 \(X^2 = 11.8061\) 과 코드의 \(11.81\) 이 맞는다. 자유도 2 에서 p 값이 \(0.27\%\) 이므로 \(\alpha = 0.05\) 에서 귀무가설을 기각한다. 성별과 주로 쓰는 손은 독립이 아니다.
(2)의 닫힌 꼴이 정말 정의와 같은 식인지 유리수로 확인해 둔다. 기대도수가 유리수이므로 \(X^2\) 도 유리수이고, 두 경로가 같은 유리수를 주어야 한다.
from fractions import Fraction as F

O = [[934, 1070], [113, 92], [20, 8]]
R = [sum(row) for row in O]
C = [sum(O[i][j] for i in range(3)) for j in range(2)]
n = sum(R)

# 정의대로 — 기대도수를 유리수로 두면 chi^2 도 유리수가 된다.
chi2_def = sum((O[i][j] - F(R[i] * C[j], n)) ** 2 / F(R[i] * C[j], n)
               for i in range(3) for j in range(2))

# (2) 에서 유도한 r x 2 닫힌 꼴
d = [O[i][0] - F(R[i] * C[0], n) for i in range(3)]
chi2_closed = F(n * n, C[0] * C[1]) * sum(di ** 2 / R[i] for i, di in enumerate(d))

print(f"정의대로 = {float(chi2_def):.10f}")
print(f"닫힌 꼴  = {float(chi2_closed):.10f}")
print(f"유리수로 똑같은가: {chi2_def == chi2_closed}")
print(f"d 의 합 = {sum(d)}  (열 합 보존)")
출력:
정의대로 = 11.8061346670
닫힌 꼴  = 11.8061346670
유리수로 똑같은가: True
d 의 합 = 0  (열 합 보존)
부동소수점이 아니라 유리수로 정확히 같다. 유도가 한 글자라도 틀렸다면 여기서 드러난다.
chi2_contingency 가 같은 값을 주는지¶
보기 2. scipy로 계산한 독립성 검정. 같은 표를 scipy.stats.chi2_contingency 에 넘긴다.
(1) 이 함수가 돌려주는 기대도수표는 어떤 꼴의 행렬인가. 그 행 합과 열 합을 관측표와 맞춰 보시오.
(2) chi2_contingency 의 인자 correction 은 기본값이 True 이고 예이츠 연속성 보정을 켠다. 그런데도 이 표에서는 보기 1 의 손계산과 소수점 아래 끝까지 같은 값이 나온다. 왜 그런가.
(3) 이 표에 카이제곱 근사를 써도 되는가. 기대도수를 보고 판정하시오.
풀이
(1) 기대표는 랭크 1 이다. \(E_{ij} = R_i C_j / n\) 에서 \(i\) 가 들어가는 자리는 \(R_i\) 뿐이고 \(j\) 가 들어가는 자리는 \(C_j\) 뿐이다. 곧 기대표는 두 주변합 벡터의 외적을 \(n\) 으로 나눈 것이다.
랭크가 1 인 행렬이므로 기대표를 정하는 자유로운 수는 주변합뿐이다. 주변합이 가진 정보는 \(r + c - 1 = 4\) 개이고 칸은 \(6\) 개이니 남는 \(2\) 가 자유도다. 보기 1 (1)의 셈과 같은 이야기를 행렬의 말로 적은 것이다.
행 합을 맞춰 본다. 첫 행은 \(955.86410 + 1048.13590 = 2004\), 셋째 행은 \(13.35539 + 14.64461 = 28\) 이다. 열 합도 \(955.86410 + 97.78051 + 13.35539 = 1067\) 이다. 기대표가 관측표와 주변합을 공유한다.
(2) 예이츠 보정은 자유도 1 에서만 켜진다. scipy 의 조건은 "correction=True 이고 자유도가 1 일 때"다. 보정은 \(\lvert O_{ij} - E_{ij} \rvert\) 에서 \(0.5\) 를 깎는 것인데, 불일치가 네 칸에서 한 수로 묶이는 \(2 \times 2\) 표에만 뜻이 있도록 만들어졌다. 이 표는 \(3 \times 2\) 라 자유도가 \(2\) 이므로 correction 을 켜 두어도 아무 일이 일어나지 않고, 정의대로의 값이 그대로 나온다.
(3) 쓸 수 있다, 다만 마지막 행이 얇다. 기대도수는 \(955.9,\ 1048.1,\ 97.8,\ 107.2,\ 13.4,\ 14.6\) 으로 여섯 칸 모두 \(5\) 를 넘는다. 경험칙(기대도수 \(5\) 미만 칸이 \(20\%\) 를 넘지 않을 것)을 충족하므로 근사를 써도 된다. 다만 양손잡이 행의 기대도수가 \(13\)–\(15\) 로 다른 행보다 두 자릿수 작고, 보기 1 에서 본 대로 카이제곱 기여가 가장 큰 행이 바로 그 가장 얇은 행이다. 결론이 이 한 행에 많이 기대고 있다는 뜻이다.
수치적으로.
import matplotlib.pyplot as plt
import numpy as np
from scipy import stats

# 분할표 형태의 관측도수
observed_counts = np.array([[934, 1070], [113, 92], [20, 8]])

# chi2_contingency는 2x2 표에 한해 Yates 연속성 보정을 **기본으로 적용한다**.
# 여기는 3x2라 보정이 없으므로 위의 수동 계산과 정확히 같은 값이 나온다.
chi_squared_statistic, p_value, degrees_of_freedom, expected_counts = stats.chi2_contingency(observed_counts)

# 통계량과 p 값 출력
print(f"chi_squared_statistic = {chi_squared_statistic:.02f}")
print(f"p_value = {p_value:.02%}", end="\n\n")

print("expected_counts")
print(expected_counts, end="\n\n")

# 그림으로 확인한다
fig, ax = plt.subplots(figsize=(12, 4))

x_values = np.linspace(0, chi_squared_statistic, 100)
y_values = stats.chi2(degrees_of_freedom).pdf(x_values)
ax.plot(x_values, y_values, color='b', linewidth=3)

x_fill_left = np.concatenate([[0], x_values, [chi_squared_statistic], [0]])
y_fill_left = np.concatenate([[0], y_values, [0], [0]])
ax.fill(x_fill_left, y_fill_left, color='b', alpha=0.1)

x_values_right = np.linspace(chi_squared_statistic, 20, 100)
y_values_right = stats.chi2(degrees_of_freedom).pdf(x_values_right)
ax.plot(x_values_right, y_values_right, color='r', linewidth=3)

x_fill_right = np.concatenate([[chi_squared_statistic], x_values_right, [20], [chi_squared_statistic]])
y_fill_right = np.concatenate([[0], y_values_right, [0], [0]])
ax.fill(x_fill_right, y_fill_right, color='r', alpha=0.1)

ax.annotate(f'p_value = {p_value:.02%}', xy=(12.5, 0.01), xytext=(16.5, 0.10),
            fontsize=15, arrowprops=dict(color='k', width=0.2, headwidth=8))

ax.spines['right'].set_visible(False)
ax.spines['top'].set_visible(False)
ax.spines['bottom'].set_position("zero")
ax.spines['left'].set_position("zero")

plt.show()
출력:
chi_squared_statistic = 11.81
p_value = 0.27%

expected_counts
[[ 955.86410371 1048.13589629]
 [  97.78050961  107.21949039]
 [  13.35538668   14.64461332]]
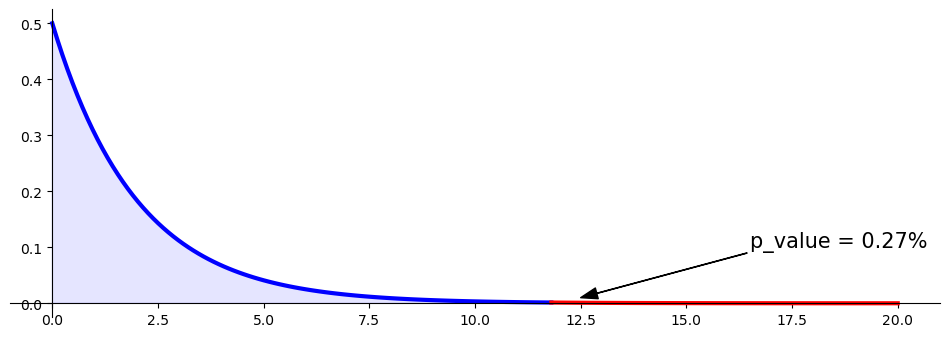
수동 계산과 통계량이 소수점 둘째 자리까지 같다. chi2_contingency 는 같은 식을 감싼 것이며 덤으로 기대도수까지 돌려준다.
인쇄된 기대도수표가 (1)의 외적을 그대로 보여 준다. 두 열의 비가 어느 행에서나 \(955.864 : 1048.136 = 97.781 : 107.219 = 1067 : 1170\) 이고, 세 행의 비가 어느 열에서나 \(2004 : 205 : 28\) 이다. 행 비와 열 비가 칸과 무관하게 일정하다는 것이 바로 독립의 꼴이다.
기대도수의 마지막 행이 13.4 와 14.6 으로 5 는 넘지만 넉넉하지는 않다. 카이제곱 근사가 아슬아슬하게 통하는 경계다.
예이츠 보정이 깎아 가는 양¶
보기 \(2\) 의 (2)가 보정이 자유도 \(1\) 에서만 켜진다는 것을 보였다. 그러면 켜졌을 때 얼마나 깎는가. \(2 \times 2\) 표에서 보정은 각 항의 이탈에서 \(0.5\) 를 깎는다.
표 \(\begin{pmatrix} 10 & 5 \\ 3 & 12 \end{pmatrix}\) 로 재어 보면 보정 없이 \(X^2 = 1470/221 = 6.651584\) 이고 보정하면 \(1080/221 = 4.886878\) 이다. 차가 \(1.764706\) 이다.
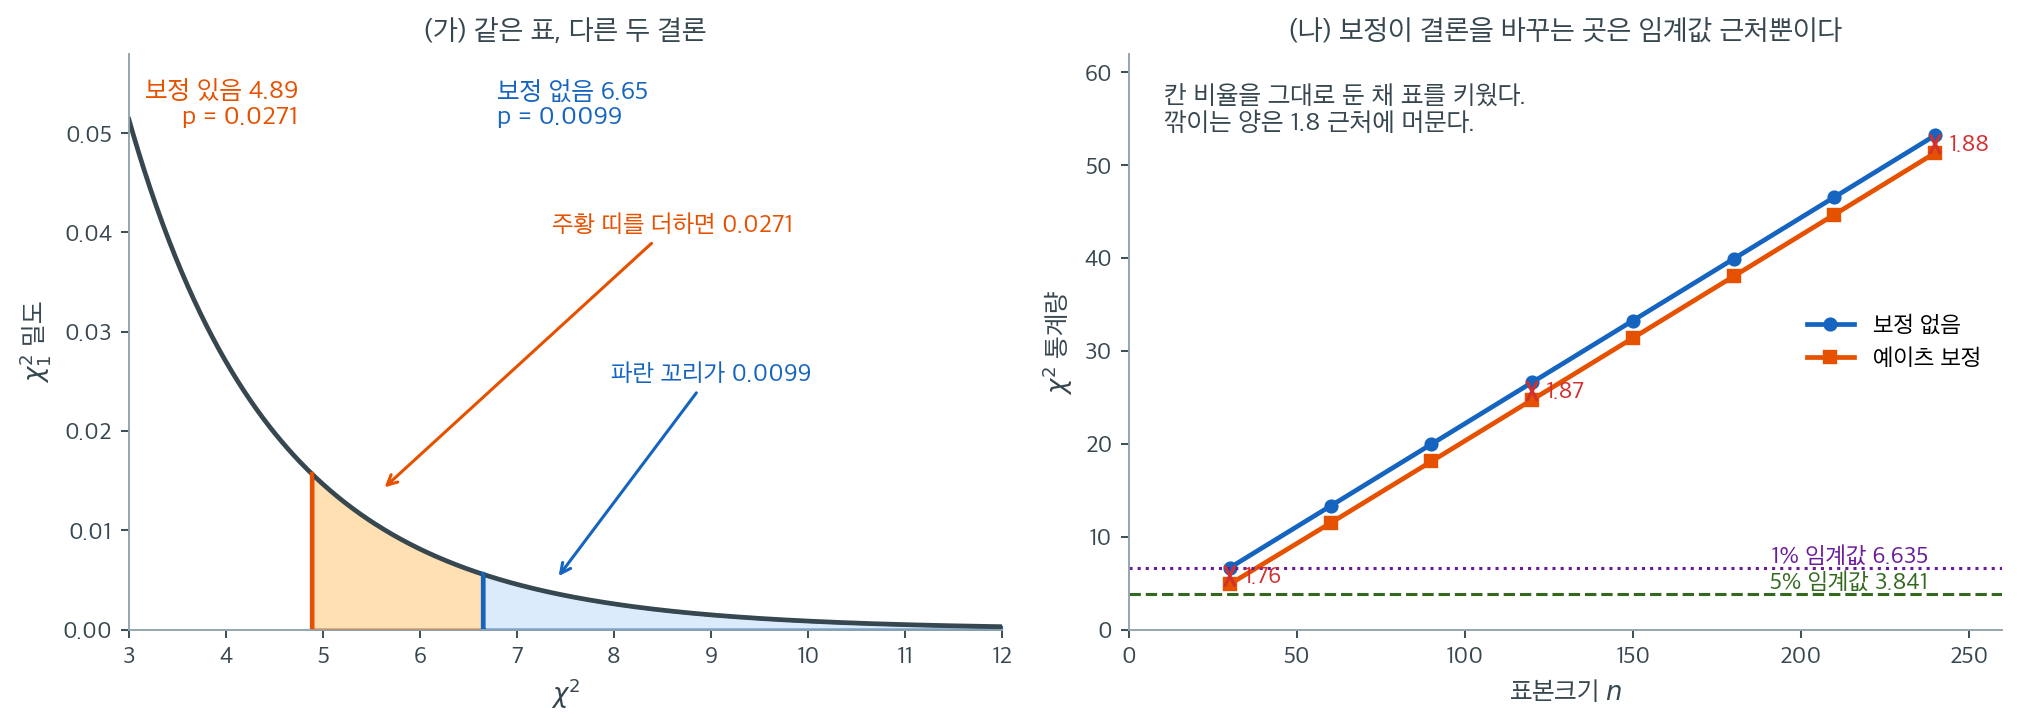
왼쪽 (가)는 \(\chi^2_1\) 밀도의 오른쪽 꼬리를 확대한 것이다. 보정을 걸지 않은 6.65에서 오른쪽으로 뻗은 파란 꼬리의 넓이가 0.0099이고, 보정을 건 4.89까지 왼쪽으로 넓힌 주황 띠를 더하면 0.0271이 된다. 통계량이 1.76 줄었을 뿐인데 p 값은 2.7배가 되었다. 꼬리가 가파르게 얇아지는 구간이라 통계량의 작은 이동이 p 값에서는 크게 증폭되는 것이다.
이 구간에는 1% 임계값 6.635가 들어 있다. 보정 없이는 6.65로 간신히 그 선을 넘고, 보정하면 4.89로 한참 미치지 못한다. correction 인자를 어떻게 두었는지 모른 채 "\(\alpha = 0.01\)에서 기각"이라고 적으면 그 문장의 진위가 기본값 하나에 달리게 된다. 이 쪽의 코드가 손계산과 견줄 때마다 correction=False 를 명시적으로 적어 두는 이유가 여기에 있다.
오른쪽 (나)는 이 걱정이 언제 필요한지를 알려 준다. 칸 비율을 그대로 둔 채 표를 \(n = 30\)에서 240까지 키우면 두 통계량 모두 \(n\)에 비례해 커지지만 둘의 간격은 1.76에서 1.88로 거의 변하지 않는다. 보정이 각 칸의 이탈에서 0.5씩만 덜어 내기 때문이다. 깎이는 양이 상수에 가깝다는 것은 곧, 통계량이 50이나 되는 큰 표에서는 1.88이 아무것도 아니고 통계량이 5 근처인 작은 표에서는 결정적이라는 뜻이다.
반대쪽 끝은 11.2절 타이타닉 생존과 성별 보기 3 이 본다. 거기서는 네 칸의 이탈이 모두 같아 보정에도 닫힌 꼴이 있고, \(X^2\) 이 \(260\) 을 넘는 표에서는 \(0.5\) 를 깎아도 결론이 꿈쩍하지 않는다.
정리하면 예이츠 보정은 "작은 표에서만 중요한" 것이 아니라 "통계량이 임계값 근처일 때만 중요한" 것이다. 두 조건은 보통 같이 오지만 항상 그렇지는 않다. 그리고 그 근처에 있다면, 애초에 결론을 한 번의 카이제곱 검정에 걸지 말고 피셔의 정확검정까지 함께 보는 편이 낫다.
보기 3. 더 긴 손과 더 긴 발. 100명을 무작위로 뽑아 각 사람에 대해 오른손이 더 긴지·왼손이 더 긴지·양손이 같은지를 판정하고, 발 길이에 대해서도 같은 과정을 반복했다.
| 오른발이 더 김 | 왼발이 더 김 | 양발이 같음 | |
|---|---|---|---|
| 오른손이 더 김 | 11 | 3 | 8 |
| 왼손이 더 김 | 2 | 9 | 14 |
| 양손이 같음 | 12 | 13 | 28 |
(1) 이 표에서는 기대도수가 모두 딱 떨어지는 유한소수로 나온다. 왜 그런지 설명하고 기대표를 구하시오.
(2) \(X^2\) 을 칸별 기여의 유리수 합으로 정확히 구하시오. 어느 칸 하나가 통계량의 절반 가까이를 만드는가.
(3) 자유도와 p 값을 구해 \(\alpha = 0.05\) 에서 판정하고, 이 표에 카이제곱 근사를 써도 되는지 따지시오.
풀이
가설. \(H_0\) 은 발 길이와 손 길이가 독립이라는 것, \(H_a\) 는 독립이 아니라는 것이다.
(1) 열 합이 총합을 나누어떨어뜨린다. 합계를 붙인 표는 이렇다.
\(E_{ij} = R_i C_j / n\) 에서 \(C_j / n\) 이 각각 \(25/100 = \tfrac14\), \(\tfrac14\), \(50/100 = \tfrac12\) 다. 곧
이므로 기대도수는 행 합을 넷으로 또는 둘로 나눈 값일 뿐이다. 분모가 \(4\) 와 \(2\) 밖에 없으니 소수점이 깔끔하게 끝난다.
(2) 칸별 기여를 유리수로 더한다. \((O_{ij} - E_{ij})^2 / E_{ij}\) 를 약분하면
이고 모두 더하면
이다. 소수로는 \(5.5 + 1.1364 + 0.8182 + 2.89 + 1.21 + 0.18 + 0.1179 + 0.0047 + 0.0849\) 다. 첫 칸 하나가 \(5.5\), 곧 전체의 \(46\%\) 를 만든다. 오른손이 더 긴 22 명 가운데 오른발도 더 긴 사람이 기대값 \(5.5\) 명의 두 배인 11 명이었다는 것, 그것이 이 검정이 잡아낸 전부다.
(3) 자유도와 p 값. 행과 열이 각각 3 이므로
이다. \(p < 0.05\) 이므로 귀무가설을 기각한다. 발 길이와 손 길이는 독립이 아니다.
타당성은 통과하지만 간신히다. 기대도수의 최소가 \(5.5\) 로 경험칙 \(E \ge 5\) 를 겨우 넘는다. 관측값이 100 개뿐이고 칸이 9 개라 칸당 평균 11 개에 불과하다.
수치적으로.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

def main():
    observed = np.array([[11, 3, 8], [2, 9, 14], [12, 13, 28]])

    statistic, p_value, df, expected = stats.chi2_contingency(observed)
    print(f"{statistic = :.02f}")
    print(f"{p_value   = :.02%}")

    _, ax = plt.subplots(figsize=(12, 4))

    x = np.linspace(0, statistic)
    y = stats.chi2(df).pdf(x)
    ax.plot(x, y, color='b', linewidth=3)

    x = np.concatenate([[0], x, [statistic], [0]])
    y = np.concatenate([[0], y, [0], [0]])
    ax.fill(x, y, color='b', alpha=0.1)

    x = np.linspace(statistic, 20, 100)
    y = stats.chi2(df).pdf(x)
    ax.plot(x, y, color='r', linewidth=3)

    x = np.concatenate([[statistic], x, [20], [statistic]])
    y = np.concatenate([[0], y, [0], [0]])
    ax.fill(x, y, color='r', alpha=0.1)

    xy = (15.0, 0.01)
    xytext = (16.5, 0.10)
    arrowprops = dict(color='k', width=0.2, headwidth=8)
    ax.annotate(f'{p_value = :.02%}', xy, xytext=xytext, fontsize=15, arrowprops=arrowprops)

    ax.spines['right'].set_visible(False)
    ax.spines['top'].set_visible(False)
    ax.spines['bottom'].set_position("zero")
    ax.spines['left'].set_position("zero")

    plt.show()

if __name__ == "__main__":
    main()
출력:
statistic = 11.94
p_value   = 1.78%
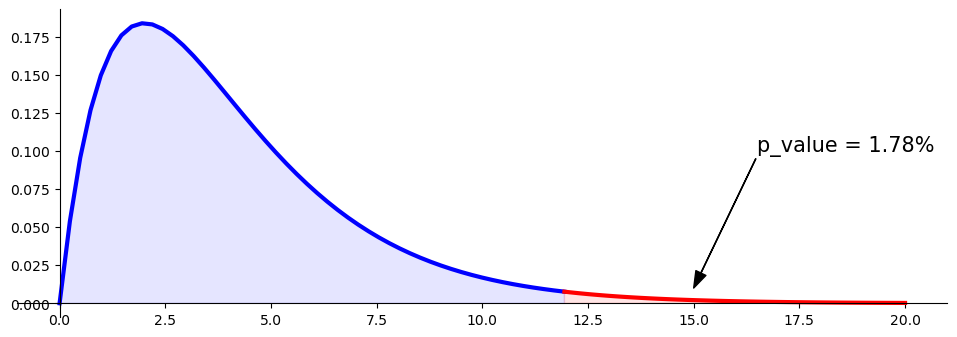
손으로 계산한 \(X^2 = 11.942093\) 과 코드의 \(11.94\) 가 맞고, p 값도 \(1.78\%\) 로 (3)의 \(0.01779\) 와 맞는다.
이보다 표가 크거나 자료가 적으면 카이제곱 근사 대신 피셔의 정확검정이나 몬테카를로(Monte Carlo) 방법을 고려해야 한다. 이 장의 마지막 절이 그 이야기다.
보기 4. 기대도수 계산의 상세. \(3 \times 5\) 분할표
를 본다. 행 합은 \(120,\ 120,\ 89\), 열 합은 \(25,\ 45,\ 90,\ 120,\ 49\), 총합은 \(n = 329\) 다.
(1) 1 행과 2 행의 관측도수는 전혀 다른데 기대도수는 글자 하나까지 같다. 왜 그런가. 또 \(E_{35}\) 를 약분한 유리수로 구하시오.
(2) 칸별 기여를 모두 인쇄해 \(X^2\) 과 자유도, p 값을 구하시오. 어느 칸들이 통계량을 끌고 가는가.
(3) 같은 통계량 값에 자유도가 2 였다면 p 값이 얼마였겠는가. 자유도 2 에서는 닫힌 꼴이 있다. 이 비교가 칸이 많은 표에 대해 무엇을 말해 주는가.
풀이
(1) 기대표는 주변합만 본다. \(E_{ij} = R_i C_j / n\) 에서 \(i\) 가 들어가는 자리는 \(R_i\) 뿐이다. 그러므로 행 합이 같은 두 행은 기대도수가 완전히 같다. 여기서는 \(R_1 = R_2 = 120\) 이므로 1 행과 2 행의 기대도수가 \(9.1185,\ 16.4134,\ 32.8267,\ 43.7690,\ 17.8723\) 으로 똑같이 나온다. 관측도수가 \((10, 20, 30, 40, 20)\) 과 \((5, 15, 40, 50, 10)\) 으로 다르다는 것을 기대표는 알지 못한다. 기대표는 주변합만 보고 만들어지며 표 안쪽이 어떻게 생겼는지는 보지 않는다. 그것이 이 검정의 기준선이고, 관측표가 그 기준선에서 얼마나 벗어났는지가 통계량이다.
\(E_{35}\) 를 약분한다. \(n = 329 = 7 \times 47\) 이고 \(C_5 = 49 = 7^2\) 이므로 \(7\) 이 하나 약분된다.
(2) 칸별 기여. 코드가 \((O-E)^2 / E\) 를 칸마다 인쇄한다. 열다섯 칸을 모두 더하면
이고 \(p = P(\chi^2_8 \ge 14.984027) = 0.059457\) 이다. \(\alpha = 0.05\) 를 아슬아슬하게 넘어 기각하지 못한다.
(3) 자유도 2 라면. \(\chi^2_d\) 의 밀도는 \(f_d(x) = x^{d/2-1}e^{-x/2} \big/ \left(2^{d/2}\Gamma(d/2)\right)\) 다. \(d = 2\) 를 넣으면 \(\Gamma(1) = 1\) 이고 \(x^0 = 1\) 이므로
곧 평균 2 인 지수분포다. 그래서 꼬리확률이 바로 적분된다.
\(t = 14.984027\) 을 넣으면
로 \(0.059457\) 의 100 분의 1 이다. 같은 통계량인데 자유도가 8 이냐 2 냐에 따라 "기각 못 함" 과 "강하게 기각" 이 갈린다. \(\chi^2_d\) 의 평균이 \(d\) 이기 때문이다. 자유도 8 인 분포에서 \(14.98\) 은 평균의 두 배에 못 미치는 흔한 값이지만, 자유도 2 인 분포에서는 평균의 일곱 배가 넘는 극단값이다. 칸이 많은 표는 우연히 어긋날 자리도 많으므로 같은 불일치 총량을 덜 놀랍게 취급한다.
수치적으로.
"""
Expected Frequency Calculator for Contingency Table
Computes expected frequencies under independence assumption
"""

import numpy as np
import pandas as pd
from scipy import stats

# 관측도수
observed = np.array([
    [10, 20, 30, 40, 20],
    [5, 15, 40, 50, 10],
    [10, 10, 20, 30, 19]
])

alpha = 0.05

# 행합과 열합, 곧 주변도수
row_totals = observed.sum(axis=1)
col_totals = observed.sum(axis=0)
grand_total = observed.sum()

print("=" * 70)
print("OBSERVED FREQUENCIES")
print("=" * 70)
obs_df = pd.DataFrame(observed,
                      index=['Row 1 (20)', 'Row 2 (30)', 'Row 3 (40)'],
                      columns=['Col 1', 'Col 2', 'Col 3', 'Col 4', 'Col 5'])
obs_df['Row Total'] = row_totals
print(obs_df)
print(f"\nColumn Totals: {col_totals}")
print(f"Grand Total: {grand_total}")

print("\n" + "=" * 70)
print("EXPECTED FREQUENCIES")
print("=" * 70)
print("Formula: E_ij = (Row_i_total × Column_j_total) / Grand_total\n")

# 주변도수의 곱으로 기대도수를 만든다
expected = np.zeros_like(observed, dtype=float)
for i in range(observed.shape[0]):
    for j in range(observed.shape[1]):
        expected[i, j] = (row_totals[i] * col_totals[j]) / grand_total

# 기대도수 출력
exp_df = pd.DataFrame(expected,
                      index=['Row 1 (20)', 'Row 2 (30)', 'Row 3 (40)'],
                      columns=['Col 1', 'Col 2', 'Col 3', 'Col 4', 'Col 5'])
exp_df['Row Total'] = exp_df.sum(axis=1)
print(exp_df)
print(f"\nColumn Totals: {expected.sum(axis=0)}")
print(f"Grand Total: {expected.sum()}")

print("\n" + "=" * 70)
print("DETAILED EXPECTED FREQUENCY CALCULATIONS")
print("=" * 70)
for i in range(observed.shape[0]):
    print(f"\nRow {i+1} (Row Total = {row_totals[i]}):")
    for j in range(observed.shape[1]):
        calculation = f"E[{i+1},{j+1}] = ({row_totals[i]} × {col_totals[j]}) / {grand_total}"
        result = f"= {row_totals[i] * col_totals[j]} / {grand_total} = {expected[i,j]:.4f}"
        print(f"  {calculation} {result}")

print("\n" + "=" * 70)
print("CHI-SQUARE CONTRIBUTIONS")
print("=" * 70)
print("Formula: (Observed - Expected)² / Expected\n")

chi_sq_contrib = (observed - expected)**2 / expected
chi_sq_df = pd.DataFrame(chi_sq_contrib,
                         index=['Row 1 (20)', 'Row 2 (30)', 'Row 3 (40)'],
                         columns=['Col 1', 'Col 2', 'Col 3', 'Col 4', 'Col 5'])
print(chi_sq_df)
print(f"\nChi-square statistic: {chi_sq_contrib.sum():.4f}")
print(f"Degrees of freedom: {(observed.shape[0]-1) * (observed.shape[1]-1)}")

p_value = stats.chi2(df=(observed.shape[0]-1) * (observed.shape[1]-1)).sf(chi_sq_contrib.sum())
print(f"{p_value = :.4f}")
if p_value < alpha:
    print("We have enough evidence to reject the null hypothesis that X and Y are independent.")
else:
    print("We do not have enough evidence to reject the null hypothesis that X and Y are independent.")
출력:
======================================================================
OBSERVED FREQUENCIES
======================================================================
            Col 1  Col 2  Col 3  Col 4  Col 5  Row Total
Row 1 (20)     10     20     30     40     20        120
Row 2 (30)      5     15     40     50     10        120
Row 3 (40)     10     10     20     30     19         89

Column Totals: [ 25  45  90 120  49]
Grand Total: 329

======================================================================
EXPECTED FREQUENCIES
======================================================================
Formula: E_ij = (Row_i_total × Column_j_total) / Grand_total

               Col 1      Col 2      Col 3      Col 4      Col 5  Row Total
Row 1 (20)  9.118541  16.413374  32.826748  43.768997  17.872340      120.0
Row 2 (30)  9.118541  16.413374  32.826748  43.768997  17.872340      120.0
Row 3 (40)  6.762918  12.173252  24.346505  32.462006  13.255319       89.0

Column Totals: [ 25.  45.  90. 120.  49.]
Grand Total: 328.99999999999994

======================================================================
DETAILED EXPECTED FREQUENCY CALCULATIONS
======================================================================

Row 1 (Row Total = 120):
  E[1,1] = (120 × 25) / 329 = 3000 / 329 = 9.1185
  E[1,2] = (120 × 45) / 329 = 5400 / 329 = 16.4134
  E[1,3] = (120 × 90) / 329 = 10800 / 329 = 32.8267
  E[1,4] = (120 × 120) / 329 = 14400 / 329 = 43.7690
  E[1,5] = (120 × 49) / 329 = 5880 / 329 = 17.8723

Row 2 (Row Total = 120):
  E[2,1] = (120 × 25) / 329 = 3000 / 329 = 9.1185
  E[2,2] = (120 × 45) / 329 = 5400 / 329 = 16.4134
  E[2,3] = (120 × 90) / 329 = 10800 / 329 = 32.8267
  E[2,4] = (120 × 120) / 329 = 14400 / 329 = 43.7690
  E[2,5] = (120 × 49) / 329 = 5880 / 329 = 17.8723

Row 3 (Row Total = 89):
  E[3,1] = (89 × 25) / 329 = 2225 / 329 = 6.7629
  E[3,2] = (89 × 45) / 329 = 4005 / 329 = 12.1733
  E[3,3] = (89 × 90) / 329 = 8010 / 329 = 24.3465
  E[3,4] = (89 × 120) / 329 = 10680 / 329 = 32.4620
  E[3,5] = (89 × 49) / 329 = 4361 / 329 = 13.2553

======================================================================
CHI-SQUARE CONTRIBUTIONS
======================================================================
Formula: (Observed - Expected)² / Expected

               Col 1     Col 2     Col 3     Col 4     Col 5
Row 1 (20)  0.085208  0.783744  0.243414  0.324553  0.253293
Row 2 (30)  1.860208  0.121707  1.567488  0.887053  3.467579
Row 3 (40)  1.549435  0.387984  0.775968  0.186725  2.489669

Chi-square statistic: 14.9840
Degrees of freedom: 8
p_value = 0.0595
We do not have enough evidence to reject the null hypothesis that X and Y are independent.
칸별 기여를 인쇄하면 통계량이 어디서 나왔는지 보인다. 가장 큰 넷은 \((2,5)\) 의 \(3.4676\), \((3,5)\) 의 \(2.4897\), \((2,1)\) 의 \(1.8602\), \((3,1)\) 의 \(1.5494\) 이고, 넷을 합치면 \(9.367\) 이라 전체 \(14.984\) 의 \(63\%\) 다. 넷 모두 첫째 열과 마지막 열, 곧 도수가 작은 양쪽 끝의 열이다.
\(E_{35}\) 가 코드의 = 4361 / 329 = 13.2553 으로 나와 (1)에서 약분한 \(623/47\) 과 맞는다. \(X^2 = 14.9840\), \(\text{df} = 8\), \(p = 0.0595\) 도 모두 (2)의 값과 같다.
기대도수의 최소는 \(E_{31} = 6.7629\) 로 \(5\) 를 넘으므로 근사는 쓸 수 있다. 그래도 \(p = 0.0595\) 처럼 경계에 걸린 결과는 근사의 오차 범위 안에 있다고 보아야 한다. 기각이냐 아니냐를 이 한 번의 계산으로 단정하지 말고 효과크기와 칸별 잔차를 함께 보는 것이 옳다.
6. 가정과 한계¶
카이제곱 독립성 검정은 관측값이 무작위로 추출되었고, 각 칸의 기대도수가 적어도 5 이상이며, 범주가 서로 배타적이라고 가정한다. 이 가정들이 어긋나면 결과가 오도할 수 있다.
표본이 작으면 피셔의 정확검정 같은 다른 독립성 검정이 나을 수 있다. 카이제곱 검정이 쓰는 대표본 근사에 의존하지 않기 때문이다.
AI로 보는 통계학 1. 이 검정은 행을 섞어도 값이 같다
위 절이 가정과 한계를 적었다. 거기 들어가야 할 한계가 하나 더 있는데, 식만 보아서는 눈에 띄지 않는다. 피어슨 카이제곱은 행과 열의 순서를 전혀 보지 않는다. 칸을 어떻게 재배열해도 \(\sum (O-E)^2/E\) 가 그대로이기 때문이다.
범주에 순서가 없으면 그것은 미덕이다. 혈액형이나 지역에는 순서가 없으니 순서를 안 보는 것이 맞다. 그런데 실제로 다루는 표에는 순서가 있는 것이 많다 — 교육 수준, 소득 구간, 만족도, 연령대. 그런 표에서 순서를 버리면 쓸 수 있는 정보를 버리는 것이고, 그 대가가 검정력이다.
import numpy as np, itertools
from scipy import stats

# 교육 수준 네 단계 × 찬반. 단계가 오를수록 찬성 비율이 꾸준히 는다.
EDU = np.array([[40, 20],
                [35, 25],
                [30, 30],
                [25, 35]])
LAB_ = ("중졸 이하", "고졸", "대졸", "대학원")

def pear_(TB):
    return stats.chi2_contingency(TB, correction=False)[:2]

def linlin_(TB):
    """행 점수 1..R, 열 점수 0/1 의 선형 대 선형 연관. M² = (n-1)r², 자유도 1."""
    rsc, csc = np.arange(1, TB.shape[0] + 1), np.arange(TB.shape[1])
    xv = np.repeat(rsc, TB.sum(1))
    yv = np.concatenate([np.repeat(csc, TB[ix]) for ix in range(TB.shape[0])])
    corr_ = float(np.corrcoef(xv, yv)[0, 1])
    msq = (len(xv) - 1) * corr_ ** 2
    return msq, float(stats.chi2.sf(msq, 1)), corr_

print("  찬성 비율 — " + "  ".join(f"{lb} {row[1]/row.sum():.2f}" for lb, row in zip(LAB_, EDU)))
chi_, pv_ = pear_(EDU)
msq, pm_, corr_ = linlin_(EDU)
print(f"\n  피어슨 카이제곱 (자유도 3)   X² = {chi_:7.4f}   p = {pv_:.4f}")
print(f"  선형 대 선형   (자유도 1)   M² = {msq:7.4f}   p = {pm_:.4f}   (r = {corr_:+.4f})")
print(f"\n  M² 가 X² 의 {msq/chi_:.1%} 를 차지한다 — 거의 전부가 '추세' 성분이다")

seen_ = {round(pear_(EDU[list(pm)])[0], 10) for pm in itertools.permutations(range(4))}
print(f"\n  행 순서를 바꾼 24 가지에서 나온 서로 다른 X² : {len(seen_)} 개 ({seen_.pop():.4f})")
출력:
  찬성 비율 — 중졸 이하 0.33  고졸 0.42  대졸 0.50  대학원 0.58

  피어슨 카이제곱 (자유도 3)   X² =  8.3916   p = 0.0386
  선형 대 선형   (자유도 1)   M² =  8.3566   p = 0.0038   (r = +0.1870)

  M² 가 X² 의 99.6% 를 차지한다 — 거의 전부가 '추세' 성분이다

  행 순서를 바꾼 24 가지에서 나온 서로 다른 X² : 1 개 (8.3916)
마지막 줄이 이 상자의 전부다. 네 단계를 뒤섞는 \(24\) 가지 순서가 모두 같은 \(8.3916\) 을 준다. 「대학원–중졸–대졸–고졸」로 늘어놓아도 검정은 알아채지 못한다. 순서를 안 보는 자이니 당연한데, 자료에 순서가 있었다면 그만큼을 그냥 버린 것이다.
버린 대가가 가운데 두 줄에 있다. 통계량의 크기는 \(8.39\) 와 \(8.36\) 으로 거의 같은데 \(p\) 값이 \(0.0386\) 과 \(0.0038\) 로 열 배 벌어진다. 자유도 때문이다 — 피어슨은 그 크기를 자유도 \(3\) 에 흩어 놓고, 추세 검정은 자유도 \(1\) 에 모은다. 실제로 \(X^2\) 의 \(99.6\%\) 가 「단계가 오를수록 찬성이 는다」는 한 방향에 들어 있는데, 피어슨은 그것을 모르고 세 방향으로 나눠 센다.
그러니 표를 받으면 먼저 물을 것이 하나 있다. 이 범주에 순서가 있는가. 있으면 순서를 쓰는 검정(선형 대 선형 연관, 이항 열에서는 코크런–아미티지 추세 검정)으로 가는 편이 거의 언제나 낫다. 반대로 순서가 없는데 순서를 가정하면 그것은 없는 정보를 지어내는 것이므로, 이 물음은 자료를 모을 때 정해져 있어야 한다. 검정을 고르는 일이 아니라 변수의 성질을 적어 두는 일이다.
7. 재표본추출 기반 카이제곱 검정¶
표본이 작거나 기대 칸 도수가 낮은 상황, 또는 분포에 의존하지 않는 접근을 원할 때, 순열/재표본추출 기반 카이제곱 검정은 점근적 카이제곱분포의 대안이 된다.
여기서 재표본은 카이제곱 통계량을 그대로 두고 그 귀무분포만 바꾸어 얻는다. 아래 보기 5 가 쓰는 헤드라인 표는 17.4절 A/B 검정 순열검정 \(\S 3\) 에도 나오는데, 거기서는 다른 통계량(집단 클릭률의 분산)으로 순열검정(permutation test)을 한다. 같은 표에 검정통계량 둘이 붙는 셈이다. 재표본 자체를 하나의 틀로 세우는 일은 17.4절 순열검정의 기초의 몫이다.
독립 아래의 칸 확률로 표를 지어 본다¶
재표본추출 접근은 다음과 같이 독립성을 검정한다.
- 실제 분할표로부터 관측된 카이제곱 통계량을 계산한다.
- 독립 아래의 기대 칸 확률을 구한다.
- 독립 가정에 따라 관측값을 무작위로 배정하여 분할표 B개를 모의생성한다.
- 모의생성된 각 표에 대해 카이제곱을 계산한다.
- p 값을 계산한다: 모의 카이제곱 중 관측값만큼 또는 그보다 극단적인 것의 비율.
보기 5. 헤드라인 클릭률 (A/B 검정). 헤드라인 세 개를 각각 \(1{,}000\) 명에게 보여 주고 클릭 여부를 세었다. 디지털 마케팅의 A/B 검정에서 흔한 상황이다.
| 헤드라인 | 클릭 | 비클릭 | 노출 | 클릭률 |
|---|---|---|---|---|
| A | \(14\) | \(986\) | \(1{,}000\) | \(1.4\%\) |
| B | \(8\) | \(992\) | \(1{,}000\) | \(0.8\%\) |
| C | \(12\) | \(988\) | \(1{,}000\) | \(1.2\%\) |
(1) 기대도수를 구하고 \(X^2\)·자유도·\(p\) 값을 적으시오. 세 행의 기대도수가 모두 같은 까닭도 말하시오.
(2) 기대도수 최솟값이 \(11.33\) 으로 「\(5\) 이상」을 넘지만, 한 행 안에서 두 칸의 비가 \(87:1\) 이다. 11.1절 자유도를 얻는 세 가지 길 \(\S 2\) 의 기준으로 이 근사를 의심해야 하는가. 모의실험으로 실제 수준을 재어 판정하시오.
(3) (2)의 답이 「의심하지 않아도 된다」라면, 보기 6·7 의 재표본은 무엇을 더 해 주는가.
풀이
import numpy as np
import pandas as pd
import random
from scipy import stats

# 제목 세 가지의 클릭 수
headlines = pd.DataFrame({
    'Click': [14, 8, 12],
    'No-click': [986, 992, 988],
    'Headline': ['Headline A', 'Headline B', 'Headline C']
})

# 결과를 행, 헤드라인을 열로 놓은 분할표를 만든다.
click_rate = headlines.copy()
clicks = click_rate.set_index('Headline')[['Click', 'No-click']].T

print("Observed Contingency Table:")
print(clicks)
print(f"\nTotal: {clicks.values.sum()}")
출력:
Observed Contingency Table:
Headline  Headline A  Headline B  Headline C
Click             14           8          12
No-click         986         992         988

Total: 3000
(1) 기대도수가 행마다 같다. \(E_{ij} = R_iC_j/N\) 이고 행 합이 셋 다 \(R_i = 1{,}000\) 이므로 — 헤드라인마다 정확히 같은 수를 보여 주었으므로 — 기대도수는 열에만 달렸다. 열 합이 \(C_1 = 34\), \(C_2 = 2{,}966\), 총합이 \(N = 3{,}000\) 이니
이다. 자유도는 \((3-1)(2-1) = 2\) 다.
import numpy as np
from scipy import stats

obs = np.array([[14, 986], [8, 992], [12, 988]], dtype=float)   # 행이 헤드라인
R, C, N = obs.sum(1), obs.sum(0), obs.sum()
E = np.outer(R, C) / N
chi2 = ((obs - E) ** 2 / E).sum()
df = (obs.shape[0] - 1) * (obs.shape[1] - 1)

# 한글은 고정폭에서 두 칸을 차지하므로 f-string 자리맞춤이 보이는 열과 어긋난다
print("  헤드라인   클릭 O    클릭 E   비클릭 O     비클릭 E")
for nm, o, e in zip("ABC", obs, E):
    print(f"       {nm}   {o[0]:6.0f} {e[0]:9.3f}     {o[1]:6.0f} {e[1]:12.3f}")
print(f"\nchi2 = {chi2:.4f}, df = {df}, p = {stats.chi2.sf(chi2, df):.4f}")
print(f"기대도수 최솟값 {E.min():.2f},  한 행 안 두 칸의 비 {E.max()/E.min():.1f} : 1")
출력:
  헤드라인   클릭 O    클릭 E   비클릭 O     비클릭 E
       A       14    11.333        986      988.667
       B        8    11.333        992      988.667
       C       12    11.333        988      988.667

chi2 = 1.6659, df = 2, p = 0.4348
기대도수 최솟값 11.33,  한 행 안 두 칸의 비 87.2 : 1
\(X^2 = 1.6659\), \(p = 0.4348\) 이다. 세 헤드라인의 클릭률 차이는 우연으로 설명된다. 같은 표를 17.4절 A/B 검정 순열검정 \(\S 3\) 이 쓰는데 거기서도 같은 수가 나온다.
(2) 의심하는 것이 맞고, 재어 보면 멀쩡하다. 클릭 수가 \(8\)·\(12\)·\(14\) 라 작고 한 행 안의 불균형이 \(87:1\) 이니 의심은 당연하다. 재어 본다.
# H0 아래 실제 수준 — 노출 1,000 회 고정, 참 클릭률은 전체 비율
rng = np.random.default_rng(0)
B, pbar, m = 200_000, C[0] / N, 1000
cl = rng.binomial(m, pbar, size=(B, 3)).astype(float)
tab = np.stack([cl, m - cl], axis=2)
Rb, Cb = tab.sum(2), tab.sum(1)
Eb = Rb[:, :, None] * Cb[:, None, :] / tab.sum((1, 2))[:, None, None]
X2 = np.where(Eb > 0, (tab - Eb) ** 2 / Eb, 0).sum((1, 2))

print(f"H0 아래 (참 클릭률 {pbar:.5f}, 노출 {m:,} 회씩, {B:,} 번)")
print(f"  명목 0.05 -> 실제 {(X2 > stats.chi2.ppf(0.95, df)).mean():.4f}")
print(f"  X² 평균 {X2.mean():.4f} (df = {df}), 분산 {X2.var():.4f} (2df = {2*df})")
print(f"  KS vs chi2({df}) = {stats.kstest(X2, 'chi2', args=(df,)).statistic:.4f}")
print("   분위     모의    chi2(2)")
for q in (0.90, 0.95, 0.99):
    print(f"   {q:.2f}  {np.quantile(X2, q):7.4f}  {stats.chi2.ppf(q, df):9.4f}")
출력:
H0 아래 (참 클릭률 0.01133, 노출 1,000 회씩, 200,000 번)
  명목 0.05 -> 실제 0.0479
  X² 평균 2.0017 (df = 2), 분산 3.8765 (2df = 4)
  KS vs chi2(2) = 0.0149
   분위     모의    chi2(2)
   0.90   4.6037     4.6052
   0.95   5.9323     5.9915
   0.99   9.0082     9.2103
명목 \(0.05\) 가 실제로 \(0.0479\) 다. 평균이 \(2.0017\), 분산이 \(3.8765\) 로 \(\chi^2_2\) 의 \(2\) 와 \(4\) 에 맞고, \(0.95\) 분위가 \(5.9323\) 대 \(5.9915\) 로 거의 포개진다. 근사가 멀쩡하다.
까닭이 11.1절 자유도를 얻는 세 가지 길의 기준에 있다. 거기서 근사를 깨뜨리는 것은 기대도수의 최솟값이 아니라 작은 항 하나가 평균될 상대를 못 찾는 것이었다. 그 쪽의 나쁜 보기는 큰 칸 넷 사이에 혼자 끼인 작은 칸이었다. 여기는 다르다 — 작은 칸이 셋이고 세 행의 기대도수가 완전히 같으므로, 그 셋이 서로의 상대가 된다. \(87:1\) 이라는 불균형은 열 사이의 것이고, 카이제곱의 각 항은 같은 행 안에서 짝을 이루어 들어간다. 불균형이 어디에 있는지를 보아야 하고, 최솟값만 보아서는 양쪽으로 다 틀린다.
(3) 재표본은 그 「멀쩡하다」를 가정이 아니라 결과로 만든다. (2)에서 근사가 통한다는 것을 알아내려고 우리는 모의실험을 돌려야 했다. 표마다 그럴 수는 없다. 재표본은 같은 일을 그 표의 설계에서 직접 해 준다 — 실제로 쓴 주변합을 고정한 채 귀무분포를 만들므로, 근사가 통하는지를 미리 묻지 않아도 된다. 그리고 「어떻게 고정하는가」가 설계마다 다르다는 것이 보기 6(비복원)과 보기 7(복원)의 주제다. 17.4절 A/B 검정 순열검정 \(\S 3\) 은 같은 표에서 다른 통계량(집단 클릭률의 분산)으로 순열검정을 하는데, 귀무분포를 자료의 무작위화(randomization)에서 끌어온다는 생각은 같다.
재표본추출 접근 (비복원)¶
보기 6. 재표본추출로 하는 검정 — 비복원. 보기 5 의 헤드라인 표를 이어 쓴다. 헤드라인마다 정확히 \(m = 1{,}000\) 명이 보았고 클릭은 \(14 + 8 + 12 = 34\) 회, 전체는 \(n = 3{,}000\) 이다.
(1) 세 집단의 크기가 모두 같을 때 기대도수가 그 행의 평균과 같아짐을 보이고, 그 덕분에 통계량이
로 줄어듦을 보이시오. 여기서 \(c = 3\) 은 집단 수, \(k = 34\) 는 전체 클릭 수, \(a_j\) 는 집단 \(j\) 의 클릭 수다. 이 표의 \(X^2\) 을 유리수로 구하시오.
(2) 클릭 34 개와 비클릭 2,966 개를 상자에 넣고 뒤섞어 1,000 명씩 세 그룹으로 나누는 순열검정을 2,000 번 돌려 p 값을 구하시오.
(3) 이 순열 귀무분포의 평균을 이론적으로 구하고 모의값과 맞춰 보시오. 그 값이 자유도와 어떤 관계인가.
풀이
(1) 기대도수가 행 평균이 된다. 열 합이 모두 같아 \(C_j = m = n/c\) 이므로
이고, 이것은 \(i\) 행 \(c\) 개 칸의 평균이다. 코드가 기대도수 대신 row_average 를 넘기는 것이 바로 이 때문이다. 클릭 행은 \(34/3 = 11.3333\), 비클릭 행은 \(2966/3 = 988.6667\) 이다.
이제 행이 둘뿐이므로 보기 1 의 논법을 행과 열을 바꿔 쓴다. 집단 \(j\) 에서 \(d_j = a_j - k/c\) 라 하면 열 합이 \(m\) 으로 묶여 있어 비클릭 칸의 불일치는 \(-d_j\) 이고, 그 집단의 기여는
이다. 집단에 대해 더하면 주장한 식이다. 수를 넣는다.
(3) 순열 귀무분포의 평균. 상자를 뒤섞어 1,000 명씩 가르면 집단 \(j\) 의 클릭 수 \(K_j\) 는 초기하분포를 따른다. \(\text{HG}(m, n, k)\) 의 꼴로 적으면 전체 \(n = 3{,}000\) 개 중 표시된 것이 \(k = 34\) 개인 상자에서 \(m = 1{,}000\) 개를 비복원으로 뽑는 것이므로
이다. 평균이 정확히 \(k/c\) 이므로 \(E[d_j^2] = \operatorname{Var}(K_j)\) 이고, \(cm = n\) 을 쓰면
이다. (1)의 상수를 곱하면 \(k\) 와 \(n\) 이 모두 약분되어
만 남는다. 마지막 등식은 \(m = n/c\) 를 넣은 것이다. 수로는
다. 자유도 \(c - 1 = 2\) 와 거의 같다. \(\chi^2_2\) 의 평균이 2 이므로 순열분포는 적어도 평균에서 카이제곱 근사와 맞아떨어진다. \(2.0006669\) 와 \(2\) 의 차이는 유한모집단 수정 \((n-m)/(n-1)\) 이 남긴 자취이고 \(n\) 이 커지면 사라진다.
(2) 수치적으로.
def chi2_stat(observed, expected):
    """카이제곱 통계량을 구한다. 칸마다 (관측-기대)^2/기대 를 더한 값이다."""
    pearson_residuals = []
    for row, expect in zip(observed, expected):
        pearson_residuals.append([(observe - expect) ** 2 / expect
                                  for observe in row])
    return np.sum(pearson_residuals)

# 관측된 카이제곱 통계량
row_average = clicks.mean(axis=1)
expected = np.array([[row_average['Click'], row_average['Click'], row_average['Click']],
                     [row_average['No-click'], row_average['No-click'], row_average['No-click']]])

chi2_obs = chi2_stat(clicks.values, row_average.values)
print(f"Observed chi-square: {chi2_obs:.4f}")

# 재표본추출 방법 — 분포를 가정하지 않는다
def perm_fun_chisq(box):
    """
    Generate permuted contingency table by random allocation.

    Parameters:
    -----------
    box : list
        Binary response (1 = click, 0 = no-click) for all users

    Returns:
    --------
    float : Chi-square statistic for permuted table
    """
    random.shuffle(box)
    # 앞 1000개를 A, 다음 1000개를 B, 마지막 1000개를 C에 배정한다
    sample_clicks = [sum(box[0:1000]),
                     sum(box[1000:2000]),
                     sum(box[2000:3000])]
    sample_noclicks = [1000 - n for n in sample_clicks]
    return chi2_stat([sample_clicks, sample_noclicks], row_average.values)

# 상자를 만든다. 클릭은 1, 비클릭은 0 이다.
box = [1] * 34 + [0] * 2966

# 순열검정 실행
random.seed(42)
perm_chi2 = [perm_fun_chisq(box) for _ in range(2000)]

p_value_resamp = sum(np.array(perm_chi2) >= chi2_obs) / len(perm_chi2)
print(f"Resampling p-value: {p_value_resamp:.4f}")
출력:
Observed chi-square: 1.6659
Resampling p-value: 0.4750
p 값이 \(0.4750\) 이다. 상자에 클릭 34 개와 비클릭 2,966 개를 넣고 뒤섞어 1,000 명씩 세 그룹으로 나눈 것이 "헤드라인이 아무 영향도 주지 않는" 세상이며, 그 세상에서 카이제곱이 관측값 이상으로 나오는 비율이 곧 p 값이다.
관측 통계량 1.6659 가 (1)에서 손으로 얻은 \(42000/25211 = 1.6659395\) 와 맞는다. 이제 (3)의 이론 평균을 확인한다.
import numpy as np

n, c, m = 3000, 3, 1000
print(f"순열 귀무분포  평균 = {np.mean(perm_chi2):.4f},  표준편차 = {np.std(perm_chi2):.4f}")
print(f"이론  n(c-1)/(n-1) = {n * (c - 1) / (n - 1):.4f},  chi2_2 의 평균 = 2")
print(f"몬테카를로 오차 = {np.std(perm_chi2) / np.sqrt(len(perm_chi2)):.4f}")
출력:
순열 귀무분포  평균 = 1.9789,  표준편차 = 1.9640
이론  n(c-1)/(n-1) = 2.0007,  chi2_2 의 평균 = 2
몬테카를로 오차 = 0.0439
모의 평균 \(1.9789\) 와 이론 \(2.0007\) 의 차이는 \(0.0218\) 이고 몬테카를로 오차 한 단위가 \(0.0439\) 다. 차이가 오차의 절반 크기이므로 어긋난 것이 아니다. 순열 2,000 번으로는 평균조차 소수 둘째 자리까지 맞추기 어렵다는 것을 보여 줄 뿐이다.
재표본추출 접근 (복원)¶
대신 상자에서 복원추출할 수도 있다.
보기 7. 재표본추출로 하는 검정 — 복원. 이번에는 같은 상자에서 1,000 개씩 복원추출해 세 집단을 만든다.
(1) 이 귀무분포의 평균을 이론적으로 구하시오. 보기 6 의 \(n(c-1)/(n-1)\) 과 견주면 무엇이 달라지는가.
(2) 2,000 번 돌려 p 값과 분포의 평균을 구하고 (1)과 맞춰 보시오. p 값이 비복원보다 커지는 까닭을 말하시오.
풀이
(1) 복원이면 평균이 \(c\) 다. 복원추출에서는 집단 \(j\) 의 클릭 수가 서로 독립인 이항분포(binomial distribution)
를 따른다. 평균은 비복원과 똑같은 \(mk/n = k/c\) 이지만 분산에서 유한모집단 수정 \((n-m)/(n-1)\) 이 빠진다.
보기 6 (1)의 상수를 곱하면 모든 것이 약분되어
이다. 복원은 평균 \(c\), 비복원은 평균 \(n(c-1)/(n-1) \approx c - 1\). 정확히 자유도 하나만큼 차이가 나는데, 그 하나가 바로 "전체 클릭 수를 34 로 고정한다"는 제약이다. 제약이 풀리면 귀무분포가 그만큼 퍼지고, 같은 관측값이 덜 극단적으로 보인다.
(2) 수치적으로.
def sample_with_replacement(box):
    """
    Generate contingency table by sampling with replacement.
    """
    sample_clicks = [sum(random.choices(box, k=1000)),
                     sum(random.choices(box, k=1000)),
                     sum(random.choices(box, k=1000))]
    sample_noclicks = [1000 - n for n in sample_clicks]
    return chi2_stat([sample_clicks, sample_noclicks], row_average.values)

# 복원추출 방식으로 실행
random.seed(42)
perm_chi2_wr = [sample_with_replacement(box) for _ in range(2000)]

p_value_wr = sum(np.array(perm_chi2_wr) >= chi2_obs) / len(perm_chi2_wr)
print(f"Resampling (with replacement) p-value: {p_value_wr:.4f}")
출력:
Resampling (with replacement) p-value: 0.6745
비복원의 \(0.4750\) 보다 눈에 띄게 크다. (1)이 예측한 평균을 확인한다.
print(f"복원 귀무분포  평균 = {np.mean(perm_chi2_wr):.4f},  표준편차 = {np.std(perm_chi2_wr):.4f}")
print("이론  E[chi2] = c = 3")
print(f"몬테카를로 오차 = {np.std(perm_chi2_wr) / np.sqrt(len(perm_chi2_wr)):.4f}")
출력:
복원 귀무분포  평균 = 3.0976,  표준편차 = 2.4859
이론  E[chi2] = c = 3
몬테카를로 오차 = 0.0556
모의 평균 \(3.0976\) 이 이론 \(3\) 에서 몬테카를로 오차 \(0.0556\) 의 \(1.8\) 배 떨어져 있다. 2,000 번치고는 큰 편이지만 오른쪽 꼬리가 두꺼운 분포의 표본평균(sample mean)은 수렴이 느리므로 어긋났다고 볼 정도는 아니다. 중요한 것은 평균이 2 가 아니라 3 근처라는 사실이고, 그것이 (1)의 예측과 맞는다.
어느 쪽이 맞는가는 무엇을 고정된 것으로 볼지에 달려 있다. 전체 클릭 수 34 를 주어진 것으로 본다면 비복원이 맞고, 그것이 피셔의 정확검정과 같은 조건부 관점이다.
비교: 재표본추출 대 모수적 방법¶
보기 8. 재표본추출과 모수적 방법의 비교.
(1) 자유도 2 인 카이제곱의 꼬리확률에는 닫힌 꼴 \(P(\chi^2_2 \ge t) = e^{-t/2}\) 가 있다. 이를 보이고 모수적 p 값을 손으로 구하시오.
(2) 순열분포는 유한하므로 p 값을 전수 열거로 정확히 구할 수 있다. 클릭 34 개를 세 집단에 나누는 모든 방법에 다변량 초기하확률을 매겨 정확한 p 값을 구하고, 모의값 \(0.4750\) 이 그것과 맞는지 몬테카를로 오차로 판정하시오.
(3) 세 p 값을 작은 것부터 늘어놓고 그 순서가 왜 그렇게 나오는지 말하시오.
풀이
(1) 자유도 2 의 닫힌 꼴. 보기 4 (3)에서 본 대로 \(\chi^2_2\) 의 밀도는 \(f_2(x) = \tfrac12 e^{-x/2}\), 곧 평균 2 인 지수분포다. 꼬리확률이 바로 적분된다.
보기 6 의 \(t = 42000/25211 = 1.6659395\) 를 넣으면
이다. 모수적 카이제곱 검정의 p 값에는 표도 함수도 필요 없다.
수치적으로.
# 모수적 카이제곱 검정
chi2_param, p_param, df, expected_param = stats.chi2_contingency(clicks.values)

print(f"\nComparison:")
print(f"Parametric chi-square: {chi2_param:.4f}, p-value: {p_param:.4f}")
print(f"Resampling (without repl): p-value: {p_value_resamp:.4f}")
print(f"Resampling (with repl): p-value: {p_value_wr:.4f}")
출력:
Comparison:
Parametric chi-square: 1.6659, p-value: 0.4348
Resampling (without repl): p-value: 0.4750
Resampling (with repl): p-value: 0.6745
모수적 p 값 0.4348 이 (1)에서 손으로 얻은 \(0.4347563\) 과 맞고, 통계량 1.6659 도 보기 6 의 유리수 \(42000/25211\) 과 같다.
(2) 순열 p 값을 정확히. 클릭 34 개를 세 집단에 \((k_1, k_2, k_3)\) 으로 나누는 방법은 \(\binom{36}{2} = 630\) 가지뿐이고, 각각의 확률은 다변량 초기하분포
로 정해진다. 630 가지를 모두 세면 순열 p 값을 모의 없이 정확히 얻는다.
from fractions import Fraction as F
from math import comb

n, m, c, k = 3000, 1000, 3, 34
const = F(c * n, k * (n - k))      # 보기 6 (1) 의 상수 2250/25211
obs = F(42000, 25211)              # 관측 통계량, 유리수로
denom = comb(n, k)

total = F(0)   # 확률의 총합 — 1 이어야 한다
tail = F(0)    # p 값
mean = F(0)    # 분포의 평균
for k1 in range(k + 1):
    for k2 in range(k + 1 - k1):
        k3 = k - k1 - k2
        prob = F(comb(m, k1) * comb(m, k2) * comb(m, k3), denom)
        stat = const * sum((F(a) - F(k, c)) ** 2 for a in (k1, k2, k3))
        total += prob
        mean += prob * stat
        if stat >= obs:
            tail += prob

se = (p_value_resamp * (1 - p_value_resamp) / 2000) ** 0.5
print(f"확률의 총합      = {total}   (유리수로 정확히)")
print(f"정확한 순열 p 값 = {float(tail):.7f}")
print(f"모의 순열 p 값   = {p_value_resamp:.7f}   (2,000 회)")
print(f"몬테카를로 오차  = {se:.4f}")
print(f"차이 / 오차      = {abs(float(tail) - p_value_resamp) / se:.2f}")
print(f"정확한 순열 평균 = {float(mean):.7f}   이론 n(c-1)/(n-1) = {n * (c - 1) / (n - 1):.7f}")
출력:
확률의 총합      = 1   (유리수로 정확히)
정확한 순열 p 값 = 0.4824141
모의 순열 p 값   = 0.4750000   (2,000 회)
몬테카를로 오차  = 0.0112
차이 / 오차      = 0.66
정확한 순열 평균 = 2.0006669   이론 n(c-1)/(n-1) = 2.0006669
확률의 합이 유리수로 정확히 1 이므로 630 가지에서 빠뜨린 것이 없다. 정확한 p 값은 \(0.4824141\) 이고 모의값 \(0.4750\) 은 오차 \(0.0112\) 의 \(0.66\) 배 떨어져 있으니 맞는다. 보기 6 (3)에서 유도한 평균 \(n(c-1)/(n-1)\) 도 전수 열거가 소수 일곱째 자리까지 되살린다.
(3) 순서와 그 까닭.
| 방법 | p 값 | 귀무분포 |
|---|---|---|
| 모수적 \(\chi^2_2\) | \(0.4348\) | 연속, 평균 \(2\) |
| 순열(비복원, 전수 열거) | \(0.4824\) | 이산 630 점, 평균 \(2.0007\) |
| 순열(비복원, 모의 2,000 회) | \(0.4750\) | 위의 몬테카를로 추정 |
| 재표본(복원, 모의 2,000 회) | \(0.6745\) | 이산, 평균 \(3\) |
모수적 값이 가장 작고 복원 재표본이 가장 크다. 까닭이 두 가지 겹쳐 있다.
첫째, 이산성. 관측 통계량 \(1.6659\) 는 순열분포가 실제로 취하는 630 개 값 중 하나이고 그 한 점만으로 확률 \(0.0632\) 를 가진다. 꼬리를 "관측값 이상" 으로 잡으면 이 덩어리가 통째로 들어가므로 매끄러운 연속분포로 근사할 때보다 p 값이 커진다. 칸 도수가 한 자릿수일 때 이 덩어리는 무시할 수 없다.
둘째, 고정의 정도. 복원 재표본은 전체 클릭 수를 고정하지 않아 보기 7 에서 본 대로 귀무분포의 평균이 \(2\) 가 아니라 \(3\) 이다. 더 퍼진 분포에서 같은 관측값을 재면 당연히 덜 극단적으로 보인다.
세 방법 모두 기각하지 못한다는 결론은 같다. 세 헤드라인의 클릭률 차이(\(1.4\%\) 대 \(0.8\%\))를 이 표본으로는 가려낼 수 없다는 것이 결론이며, 이런 크기의 차이를 잡으려면 9.5절 검정력 분석의 계산이 말해 주듯 집단당 수천 명이 필요하다.
두 귀무분포를 나란히 그린다¶
보기 9. 두 재표본 분포 그리기. 보기 6·7 이 만든 두 귀무분포를 나란히 그린다.
(1) 두 히스토그램을 그리고 관측값 \(1.6659\) 의 자리를 표시하시오.
(2) 그림에서 읽히는 것을 수치와 함께 적으시오. 두 분포의 중심과 산포는 어떻게 다르며 그것이 p 값 차이와 어떻게 이어지는가.
(3) 이 그림이 가리는 것은 무엇인가.
풀이
유도할 답은 없다. 중심과 산포의 이론값은 보기 6·7 에서 이미 얻었다(비복원 평균 \(n(c-1)/(n-1) = 2.0007\), 복원 평균 \(c = 3\)). 그림의 몫은 그 두 수가 분포의 모양으로 어떻게 나타나는지를 보여 주는 것이다.
(1) 그린다.
import matplotlib.pyplot as plt

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# 비복원 재표본 분포 — 순열검정에 해당한다
ax1.hist(perm_chi2, bins=40, alpha=0.7, color='steelblue', edgecolor='black')
ax1.axvline(chi2_obs, color='red', linewidth=2, label=f'Observed = {chi2_obs:.2f}')
ax1.set_xlabel('Chi-square Statistic')
ax1.set_ylabel('Frequency')
ax1.set_title(f'Resampling Distribution (without replacement)\np-value = {p_value_resamp:.4f}')
ax1.legend()
ax1.spines['top'].set_visible(False)
ax1.spines['right'].set_visible(False)

# 복원 재표본 분포 — 부트스트랩에 해당한다
ax2.hist(perm_chi2_wr, bins=40, alpha=0.7, color='forestgreen', edgecolor='black')
ax2.axvline(chi2_obs, color='red', linewidth=2, label=f'Observed = {chi2_obs:.2f}')
ax2.set_xlabel('Chi-square Statistic')
ax2.set_ylabel('Frequency')
ax2.set_title(f'Resampling Distribution (with replacement)\np-value = {p_value_wr:.4f}')
ax2.legend()
ax2.spines['top'].set_visible(False)
ax2.spines['right'].set_visible(False)

plt.tight_layout()
plt.show()
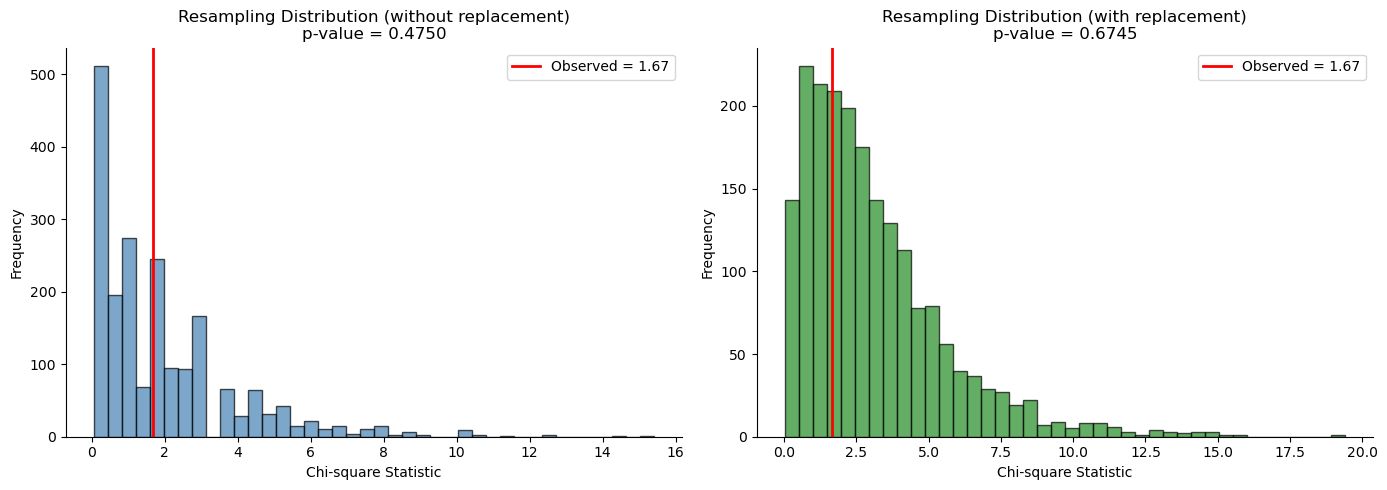
(2) 읽히는 것. 눈으로 읽은 것을 수로 적어 둔다.
import numpy as np

for name, d, theory in [("비복원", perm_chi2, 3000 * 2 / 2999),
                        ("복원", perm_chi2_wr, 3.0)]:
    a = np.array(d)
    print(f"{name:>4}  평균 {a.mean():.4f} (이론 {theory:.4f})  "
          f"표준편차 {a.std():.4f}  중앙값 {np.median(a):.4f}  "
          f"p 값 {(a >= chi2_obs).mean():.4f}")
출력:
 비복원  평균 1.9789 (이론 2.0007)  표준편차 1.9640  중앙값 1.4874  p 값 0.4750
  복원  평균 3.0976 (이론 3.0000)  표준편차 2.4859  중앙값 2.4692  p 값 0.6745
| 비복원(왼쪽) | 복원(오른쪽) | |
|---|---|---|
| 모의 평균 | \(1.9789\) | \(3.0976\) |
| 이론 평균 | \(2.0007\) | \(3\) |
| 모의 표준편차 | \(1.9640\) | \(2.4859\) |
| 모의 중앙값 | \(1.4874\) | \(2.4692\) |
| p 값 | \(0.4750\) | \(0.6745\) |
- 둘 다 오른쪽으로 길게 늘어졌다. 평균이 중앙값보다 크다(\(1.98\) 대 \(1.49\), \(3.10\) 대 \(2.47\)). 카이제곱류 통계량은 음수가 될 수 없고 위로는 열려 있으니 당연한 모양이다.
- 빨간 선(관측값 \(1.6659\))이 두 분포의 중심 근처에 있다. 왼쪽에서는 중앙값 \(1.4874\) 보다 약간 오른쪽, 오른쪽에서는 중앙값 \(2.4692\) 보다 왼쪽이다. 관측된 표가 "우연히 나올 법한" 범위 안에 있다는 뜻이고, 그래서 두 p 값이 모두 \(0.5\) 근처다.
- 왼쪽이 오른쪽보다 좁고 왼쪽으로 쏠려 있다. 표준편차가 \(1.96\) 대 \(2.49\) 다. 전체 클릭 수를 34 로 고정하면 그만큼 변동이 줄기 때문이며, 이것이 두 p 값 차이의 이유다.
(3) 가리는 것.
- 통계량은 실은 이산이다. 보기 8 에서 본 대로 순열분포는 630 개의 점에만 확률을 둔다. 관측값 \(1.6659\) 한 점만 해도 확률 \(0.0632\) 를 가진다.
bins=40으로 묶으면 그 계단이 뭉개져 연속분포처럼 보인다. 막대 높이가 들쭉날쭉한 것이 계단이 남긴 흔적이다. - 꼬리의 면적은 눈으로 읽히지 않는다. p 값을 결정하는 것은 \(1.67\) 오른쪽의 면적인데, 히스토그램을 보고 그 면적이 \(0.475\) 라고 읽어 낼 수는 없다. 그림은 "중심 근처다" 까지만 말해 주고 p 값은 세어야 나온다.
- 두 축의 범위가 서로 다르다. 두 분포를 겹쳐 그리지 않고 따로 자동 축척했으므로 산포의 차이가 눈에 그대로 들어오지 않는다. 표준편차 \(1.96\) 과 \(2.49\) 는 수로 적어야 보인다.
재표본추출 카이제곱의 장점¶
- 분포 가정이 없다: 카이제곱 근사에 의존하지 않는다.
- 작은 칸 도수: 기대 칸 도수가 5 미만이어도 작동한다.
- 정확하다: p 값이 (근사가 아니라) 정확하다.
- 유연하다: 어떤 크기의 분할표에도 적용할 수 있다.
재표본추출을 쓸 때¶
- 작은 기대도수: 기대 칸 도수가 하나라도 5 미만일 때.
- 작은 표본: \(n < 20\)–30일 때.
- 로버스트성 확인: 모수적 카이제곱과 비교할 때.
- 교육적 가치: 무작위화를 통해 귀무가설을 직접 검정한다.
계산상의 고려사항¶
- 대부분의 응용에서 순열 2,000–5,000회를 쓴다.
- 복원 방식이 비복원 방식보다 보수적이다 — 전체 클릭 수를 고정하지 않아 귀무분포가 더 퍼지고 \(p\) 값이 커진다(보기 7 의 \(0.6745\) 대 보기 6 의 \(0.4750\)).
- 표본크기가 어느 정도 되면 두 접근이 대체로 비슷한 p 값을 준다.
연습문제¶
연습문제 1. 결제수단(현금/카드/모바일) × 요일(주말/평일)을 검정하라. 자료: 주말 (30, 50, 20), 평일 (40, 60, 30). \(\alpha = 0.01\)에서 검정하라.
풀이
\(H_0\): 독립이다. 행 합계: 100, 130. 열 합계: 70, 110, 50. 총합: 230.
기대도수: $E_{ij} = $ 행합 \(\times\) 열합 / 230. 예를 들어 \(E_{11} = 100 \cdot 70/230 \approx 30.43\).
\(X^2 = \sum (O - E)^2/E \approx 0.43\). df \(= (2-1)(3-1) = 2\).
임계값 \(\chi^2_{0.99,\,2} = 9.21\). \(0.43 < 9.21\)이므로 기각하지 못한다. 연관의 증거가 없다.
연습문제 2. Cramér의 V 효과크기: \(V = \sqrt{X^2/(N \cdot \min(r-1, c-1))}\). 연습문제 1에 대해 계산하라.
풀이
\(V = \sqrt{0.43/(230 \cdot 1)} \approx \sqrt{0.00187} \approx 0.04\).
흔히 쓰는 기준은 셋으로 가른다.
- \(V \le 0.1\): 약함.
- \(V \approx 0.3\): 중간.
- \(V \ge 0.5\): 강함.
\(V = 0.04\)이므로 연관이 약하다(사실상 없다). 기각하지 못한 결과와 합쳐서 결제수단과 요일이 사실상 독립이라고 결론짓는다.
맥락상 유용한 점: \(N\)이 크면 \(V\)가 아주 작아도(효과가 사소해도) 카이제곱이 "유의"해질 수 있다.
연습문제 3. \(2 \times 2\) 표에 대한 오즈비. 흡연 × 암 = (50, 30) 대 (10, 100)에 대해 정의하고 계산하라.
풀이
표(흡연 여부 × 암 여부): \((50, 30) / (10, 100)\).
OR \(= (50 \cdot 100)/(30 \cdot 10) = 5000/300 \approx 16.7\).
해석: 암에 걸릴 오즈가 비흡연자에 비해 흡연자에서 16.7배 높다.
\(\ln(\mathrm{OR}) = 2.81\). \(\ln(\mathrm{OR})\)의 표준오차는 \(\sqrt{1/50 + 1/30 + 1/10 + 1/100} \approx \sqrt{0.1633} \approx 0.404\).
\(\ln(\mathrm{OR})\)의 95% 신뢰구간: \(2.81 \pm 1.96 \cdot 0.404 = (2.02, 3.61)\). 지수를 취하면 OR의 신뢰구간 \(= (7.55, 36.8)\).
강한 연관이다. 1을 포함하지 않으므로 유의하다.
연습문제 4. 독립성 검정의 전체 분석 지도를 정리하라.
풀이
선택 흐름.
두 범주형 변수의 연관을 본다
    │
    ├─ 관측이 독립인가 (군집·반복측정 아님)
    │      └─ 아니오 → McNemar / 코크런 Q / 혼합모형
    │
    ├─ 변수의 척도는
    │      ├─ 둘 다 명목형 ──────→ 일반 X² 독립성 검정
    │      ├─ 한쪽만 순서형 ─────→ 코크런·아미티지 추세검정
    │      └─ 둘 다 순서형 ──────→ 선형-선형 연관 검정 (연습문제 10)
    │
    ├─ 기대도수를 확인
    │      └─ 작으면 → 피셔 / 바너드 / 몬테카를로
    │
    ├─ 셋째 변수가 있는가
    │      ├─ 교란변수 → 층화 (맨텔·헨첼) / 로그선형모형
    │      └─ 충돌자  → 층화하면 안 됨 (연습문제 9)
    │
    └─ 언제나: 효과크기 + 잔차 + 원 도수표
한 자료에 대해 보고할 것.
| 항목 | 예 |
|---|---|
| 원 도수표 | 필수 |
| 행·열 백분율 | 해석의 편의 |
| \(X^2\), df, \(p\) | 관행 |
| 효과크기 | 크라메르 \(V\), 오즈비, 상호정보량 |
| 효과크기의 신뢰구간 | 정밀도 |
| 조정 표준화 잔차 | 어디가 다른가 |
| 기대도수 최솟값 | 근사의 타당성 |
연관의 강도를 재는 세 가지 척도.
| 척도 | 범위 | 성격 |
|---|---|---|
| 크라메르 \(V\) | \([0,1]\) | \(X^2\) 기반, 가장 흔함 |
| 오즈비 | \((0,\infty)\) | \(2\times2\), 회귀와 연결 |
| 상호정보량 | \([0,\min(H_X,H_Y)]\) | 정보이론, 예측 관점 |
셋이 답하는 질문이 미묘하게 다르다. \(V\)는 "독립에서 얼마나 멀리 있는가", 오즈비는 "한 수준에서 다른 수준으로 갈 때 오즈가 몇 배인가", 상호정보량은 "한 변수를 알면 다른 변수의 불확실성이 얼마나 줄어드는가"다.
가장 흔한 오해 다섯.
| 오해 | 사실 |
|---|---|
| "연관이 있으니 인과다" | 교란·역인과·선택편향이 모두 가능 |
| "\(p\)가 작으니 효과가 크다" | \(X^2=nw^2\) — \(n\)이 크면 작은 효과도 유의 |
| "\(p>0.05\)이니 독립이다" | 검정력이 낮아서일 수 있다 |
| "층화하면 언제나 낫다" | 충돌자를 층화하면 가짜 연관이 생긴다 |
| "순서형도 일반 검정으로 충분" | 검정력을 크게 잃는다 |
네 번째가 통계학에서 비교적 최근에 정리된 문제다. 교란을 제거하려고 무턱대고 변수를 넣으면, 그 변수가 충돌자일 때 없던 연관을 만들어 낸다. 어느 변수를 보정할지는 통계가 아니라 인과 도식이 정한다.
마지막으로 — 분할표 하나에서 얻을 수 있는 것과 없는 것.
| 얻을 수 있는 것 | 얻을 수 없는 것 |
|---|---|
| 두 변수의 연관 여부와 강도 | 인과의 방향 |
| 어느 칸이 이탈했는가 | 교란되지 않았다는 보장 |
| 그 이탈의 통계적 유의성 | 실질적 중요성(분야가 판단) |
한 문장. 독립성 검정은 "우연으로 보기 어려운가"에만 답한다. 그다음의 모든 질문 — 왜, 얼마나, 무엇을 해야 하는가 — 은 자료 바깥의 지식을 요구한다.
연습문제 5. 고차원에서의 독립성. 카이제곱이 \(r \times c \times s\) 분할표를 다룰 수 있는가?
풀이
그렇다. 다원표(변수 3개 이상)를 다룰 수 있다. df \(= (r-1)(c-1)(s-1) \cdots\)이다.
가설이 더 복잡해지고 세 갈래가 된다.
- 완전 독립: 모든 변수가 서로 독립.
- 결합 독립: 한 변수가 나머지의 결합분포(joint distribution)와 독립.
- 조건부 독립: 세 번째 변수를 주었을 때 두 변수가 독립.
표준 카이제곱은 결합 독립을 검정한다. 로그선형 모형은 이 모든 패턴으로 일반화하며 통일된 틀을 제공한다. 범주형 변수가 많은 사회과학 연구에서 쓰인다.
연습문제 6. 분할표에서의 심슨의 역설.
풀이
이진 처치–결과 사이의 연관이 세 번째 변수로 조건화하면 뒤집히는 현상이다.
버클리 입학 예: 전체로 보면 여성의 합격률이 남성보다 낮았다. 그러나 학과로 조건화하면 각 학과 안에서는 여성의 합격률이 같거나 더 높았다. 학과를 고려하면 집계 수준에서 보이던 차별이 사라진다.
이유: 여성이 경쟁이 심한(합격률이 낮은) 학과에 불균형하게 많이 지원했다. 주변 수준의 연관은 학과 선택과 학과별 합격률을 반영한 것이지 학과 내 차별을 반영한 것이 아니다.
교훈: 주변 분할표는 오도할 수 있다. 관련 공변량을 통제해야 하는지 항상 고려하라. 집계된 자료는 집단 내부의 패턴을 감춘다.
연습문제 7. 피셔의 정확검정 대 카이제곱. 피셔를 언제 쓰는가?
풀이
피셔의 정확검정은 \(2 \times 2\) 분할표에 대해 (점근 근사 없이) 정확한 p 값을 계산한다.
카이제곱의 근사 분포와 대비된다.
피셔를 쓸 때는 이렇다.
- 표본이 작을 때(기대도수 < 5).
- 표가 희소할 때.
- 정확한 p 값이 필요할 때.
카이제곱을 쓸 때는 이렇다.
- \(n\)이 클 때(Cochran의 규칙을 만족할 때).
- 다원표일 때.
- 계산이 간단하기를 원할 때.
scipy에서는 scipy.stats.fisher_exact, R에서는 fisher.test로 쓸 수 있다. 둘 다 기본이 양측검정(two-sided test)이다.
연습문제 8. 우도비 통계량 \(G^2\)이 상호정보량과 정확히 어떤 관계인지 확인하라.
풀이
상호정보량. 두 변수의 결합분포와 주변분포의 곱 사이의 쿨백–라이블러 발산(Kullback–Leibler divergence)이다. 두 분포가 얼마나 다른지를 재는 양으로, 두 분포가 같을 때만 \(0\) 이다.
\(G^2\)을 \(\hat p\)로 다시 쓰면 관계가 드러난다.
import numpy as np
from scipy import stats

def g2_and_mi(T):
    T = np.asarray(T, float)
    n = T.sum()
    P = T / n
    exp = np.outer(T.sum(1), T.sum(0)) / n
    mask = T > 0
    g2 = 2 * np.sum(T[mask] * np.log(T[mask] / exp[mask]))
    indep = np.outer(P.sum(1), P.sum(0))
    mi = np.sum(P[mask] * np.log(P[mask] / indep[mask]))
    return g2, mi

tables = {
    "결제수단 × 요일": np.array([[30, 50, 20], [40, 60, 30]], float),
    "강한 연관 2×2": np.array([[40, 10], [10, 40]], float),
    "성별 × 손잡이": np.array([[934, 1070], [113, 92], [20, 8]], float),
}
for name, T in tables.items():
    g2, mi = g2_and_mi(T)
    chi2, p, df, _ = stats.chi2_contingency(T, correction=False)
    n = T.sum()
    print(f"[{name}]  n = {n:.0f},  df = {df}")
    print(f"  X² = {chi2:8.4f}   G² = {g2:8.4f}   2n·MI = {2 * n * mi:8.4f}")
    print(f"  MI = {mi:.6f} nat = {mi / np.log(2):.6f} bit"
          f"    G² 의 p = {stats.chi2.sf(g2, df):.4f}")
[결제수단 × 요일]  n = 230,  df = 2
  X² =   0.4320   G² =   0.4332   2n·MI =   0.4332
  MI = 0.000942 nat = 0.001358 bit    G² 의 p = 0.8053
[강한 연관 2×2]  n = 100,  df = 1
  X² =  36.0000   G² =  38.5490   2n·MI =  38.5490
  MI = 0.192745 nat = 0.278072 bit    G² 의 p = 0.0000
[성별 × 손잡이]  n = 2237,  df = 2
  X² =  11.8061   G² =  11.9606   2n·MI =  11.9606
  MI = 0.002673 nat = 0.003857 bit    G² 의 p = 0.0025
\(G^2=2n\hat I\)가 세 경우 모두에서 정확히 성립한다. 소수점 넷째 자리까지 일치한다.
이 관계가 주는 세 가지 통찰.
1 — 독립성 검정은 정보량의 검정이다. "\(X\)를 알면 \(Y\)에 대한 불확실성이 얼마나 줄어드는가"를 재는 것이다. 독립이면 \(I=0\)이고, \(G^2\)도 0이다.
2 — 효과크기가 자연스럽게 나온다. \(\hat I=G^2/(2n)\)이므로 표본크기로 정규화된 양이다. 크라메르 \(V\)와 같은 역할이다.
| 자료 | \(G^2\) | \(\hat I\) (bit) |
|---|---|---|
| 강한 2×2 | 38.55 | 0.278 |
| 성별×손잡이 | 11.96 | 0.0039 |
\(G^2\)은 12과 39로 3배 차이지만, 상호정보량은 71배 차이다. \(n\)이 100과 2237로 다르기 때문이다. 정보량 쪽이 연관의 강도를 훨씬 정직하게 보여 준다.
3 — 해석이 구체적이다. 0.278 bit는 "\(X\)를 알면 \(Y\)의 엔트로피가 0.278비트 줄어든다"는 뜻이다. \(2\times2\)에서 \(Y\)의 최대 엔트로피가 1비트이므로 약 28%의 불확실성이 설명된다.
정규화된 상호정보량.
가 11.3절 효과크기와 크라메르의 V의 불확실성 계수다. 엔트로피로 나누어 \([0,1]\)로 만든 것이다.
\(X^2\)과 \(G^2\)의 관계. 둘 다 같은 극한분포를 갖고, \(O_{ij}\approx E_{ij}\)일 때
이다. 위 표에서 연관이 약하면 거의 같고(0.432 대 0.432), 강하면 벌어진다(36.0 대 38.5).
어느 것을 쓸까. 앞 절에서 본 대로 유한표본 성질은 \(X^2\)이 낫다. 다만 \(G^2\)은 로그선형모형에서 분해 가능하고 정보이론과 연결된다는 장점이 있다. 둘이 왜 다른 수인지는 11.1절 자유도를 얻는 세 가지 길 \(\S 3\) 에 있다 — \(X^2\) 은 점수통계량이고 \(G^2\) 은 가능도비통계량이라 삼위일체의 서로 다른 모서리다. 분해되는 것은 이탈도이므로 가능도비(likelihood ratio) 쪽이다.
연습문제 9. 연습문제 5·6이 다룬 3원 분할표와 심슨의 역설을 구체적인 수치로 보여라. 주변 독립과 조건부 독립이 서로 함의하지 않음을 확인하라.
풀이
import numpy as np
from scipy import stats

def report(T, title):
    print(f"[{title}]")
    marginal = T.sum(2)                      # Z 를 무시한 X×Y 표
    c, p, df, _ = stats.chi2_contingency(marginal, correction=False)
    print(f"  주변표 (Z 무시)\n{marginal.astype(int)}")
    print(f"    X² = {c:.4f},  df = {df},  p = {p:.4g}")
    for z in range(T.shape[2]):
        sub = T[:, :, z]
        if sub.sum(0).min() > 0 and sub.sum(1).min() > 0:
            c2, p2, _, _ = stats.chi2_contingency(sub, correction=False)
            print(f"  Z={z} 층\n{sub.astype(int)}    "
                  f"X² = {c2:.4f},  p = {p2:.4g}")
        else:
            print(f"  Z={z} 층\n{sub.astype(int)}    (한 칸이 0: 완전 종속)")
    print()

n = 800

# ① X 와 Y 는 주변적으로 독립이지만 Z 를 고정하면 완전히 종속
P1 = np.zeros((2, 2, 2))
P1[0, 0, 0] = P1[0, 1, 1] = P1[1, 0, 1] = P1[1, 1, 0] = 0.25
report(np.round(P1 * n), "① 주변 독립, 조건부 종속")

# ② Z 가 X 와 Y 의 공통 원인 — 주변적으로 종속, 조건부로 독립
P2 = np.zeros((2, 2, 2))
for z, (px, py) in enumerate([(0.2, 0.2), (0.8, 0.8)]):
    for x in range(2):
        for y in range(2):
            P2[x, y, z] = 0.5 * (px if x else 1 - px) * (py if y else 1 - py)
report(np.round(P2 * n), "② 주변 종속, 조건부 독립")
[① 주변 독립, 조건부 종속]
  주변표 (Z 무시)
[[200 200]
 [200 200]]
    X² = 0.0000,  df = 1,  p = 1
  Z=0 층
[[200   0]
 [  0 200]]    X² = 400.0000,  p = 5.507e-89
  Z=1 층
[[  0 200]
 [200   0]]    X² = 400.0000,  p = 5.507e-89

[② 주변 종속, 조건부 독립]
  주변표 (Z 무시)
[[272 128]
 [128 272]]
    X² = 103.6800,  df = 1,  p = 2.378e-24
  Z=0 층
[[256  64]
 [ 64  16]]    X² = 0.0000,  p = 1
  Z=1 층
[[ 16  64]
 [ 64 256]]    X² = 0.0000,  p = 1
두 개념이 어느 방향으로도 함의하지 않는다.
| 주변 독립 | 조건부 독립 | |
|---|---|---|
| ① | 예(\(X^2=0\)) | 아니오(완전 종속) |
| ② | 아니오(\(X^2=103.7\)) | 예(\(X^2=0\)) |
①의 구조. \(Z=0\)이면 \(X=Y\), \(Z=1\)이면 \(X\ne Y\)다. 즉 \(Z\)가 "\(X\)와 \(Y\)가 같은가"를 결정한다. \(Z\)를 무시하면 두 경우가 상쇄되어 완벽한 독립처럼 보인다.
②의 구조. \(Z\)가 \(X\)와 \(Y\) 각각에 영향을 주는 공통 원인이다. \(Z\)를 고정하면 \(X\)와 \(Y\)가 독립인데, \(Z\)를 무시하면 \(Z\)를 통한 가짜 연관이 나타난다.
인과 구조가 결정한다.
① 충돌자 구조             ② 공통 원인 구조
   X → Z ← Y                  X ← Z → Y

Z 를 무시: X ⊥ Y            Z 를 무시: X 와 Y 가 연관
Z 로 층화: X 와 Y 가 연관    Z 로 층화: X ⊥ Y
            (선택 편향!)                (교란 제거)
"층화하는 것이 언제나 옳다"는 규칙은 없다.
| \(Z\)의 역할 | 층화해야 하는가 |
|---|---|
| 교란변수(공통 원인) | 예 — 층화가 교란을 제거 |
| 충돌자(공통 결과) | 아니오 — 층화가 가짜 연관을 만듦 |
| 매개변수(중간 단계) | 질문에 따라 다름 |
통계만으로는 구분할 수 없다. 위 두 표는 자료만 보고는 어느 쪽인지 알 수 없다. \(Z\)가 \(X\)·\(Y\)보다 먼저 일어났는가, 나중에 일어났는가라는 분야 지식이 필요하다.
심슨의 역설은 ②의 극단적 형태다. 층화(stratification) 전후로 연관의 부호가 뒤집히는 경우다. 12장에서 인과추론의 틀로 다시 다룬다.
연습문제 10. 두 변수가 모두 순서형일 때 일반적인 독립성 검정 대신 쓸 수 있는 선형–선형 연관 검정을 구현하고 비교하라.
풀이
아이디어. 행과 열에 점수 \(u_i\), \(v_j\)를 주고 피어슨 상관을 계산한 뒤
로 검정한다. 자유도가 \((r-1)(c-1)\)에서 1로 줄어 훨씬 강력해진다.
import numpy as np
from scipy import stats

def linear_by_linear(T, u=None, v=None):
    """순서형 × 순서형 표의 선형-선형 연관 검정."""
    T = np.asarray(T, float)
    r, c = T.shape
    n = T.sum()
    u = np.arange(r, dtype=float) if u is None else np.asarray(u, float)
    v = np.arange(c, dtype=float) if v is None else np.asarray(v, float)
    ru, rv, w = np.repeat(u, c), np.tile(v, r), T.ravel()
    mu, mv = (w * ru).sum() / n, (w * rv).sum() / n
    su = np.sqrt((w * (ru - mu)**2).sum() / n)
    sv = np.sqrt((w * (rv - mv)**2).sum() / n)
    rho = (w * (ru - mu) * (rv - mv)).sum() / n / (su * sv)
    m2 = (n - 1) * rho**2
    return rho, m2, stats.chi2.sf(m2, 1)

tables = {
    "단조 연관": np.array([[30, 20, 10,  5],
                          [20, 30, 20, 10],
                          [10, 20, 30, 20],
                          [ 5, 10, 20, 30]], float),
    "대칭 U자": np.array([[40, 10, 10, 40],
                         [10, 40, 40, 10],
                         [10, 40, 40, 10],
                         [40, 10, 10, 40]], float),
}
for name, T in tables.items():
    c, p, df, _ = stats.chi2_contingency(T, correction=False)
    rho, m2, pm = linear_by_linear(T)
    print(f"[{name}]  n = {T.sum():.0f}")
    print(f"  일반 독립성   X² = {c:8.4f},  df = {df},  p = {p:.4g}")
    print(f"  선형-선형     r = {rho:+.6f},  M² = {m2:8.4f},  df = 1,  "
          f"p = {pm:.4g}")
[단조 연관]  n = 290
  일반 독립성   X² =  66.3332,  df = 9,  p = 7.935e-11
  선형-선형     r = +0.443609,  M² =  56.8720,  df = 1,  p = 4.651e-14
[대칭 U자]  n = 400
  일반 독립성   X² = 144.0000,  df = 9,  p = 1.539e-26
  선형-선형     r = +0.000000,  M² =   0.0000,  df = 1,  p = 1
단조 자료에서는 선형–선형 검정이 훨씬 강력하다. \(p\)가 \(8\times10^{-11}\)에서 \(5\times10^{-14}\)로 세 자릿수 작아진다. 자유도를 9에서 1로 줄이면서 신호는 그대로 담았기 때문이다.
대칭 U자 자료에서는 완전히 실패한다. 일반 검정은 \(X^2=144\)로 압도적인데 선형–선형 검정은 \(r\)이 정확히 0이라 \(p=1\)이다.
U자 표를 보면 이유가 분명하다.
[[40 10 10 40]
 [10 40 40 10]
 [10 40 40 10]
 [40 10 10 40]]
강한 구조가 있지만 선형이 아니다. 바깥 행은 바깥 열에, 가운데 행은 가운데 열에 몰린다. 상관계수는 이런 대칭 패턴을 전혀 포착하지 못한다.
점수를 어떻게 줄 것인가.
| 방법 | 설명 |
|---|---|
| 정수 점수 \(0,1,2,\dots\) | 기본. 등간격을 가정 |
| 중앙값 점수 | 구간형 변수(소득구간 등)에서 각 구간의 중앙값 |
| 순위 점수 | 주변분포를 반영. 만–휘트니와 연결 |
| 자료 기반 점수 | 금지 — 수준이 무너진다 |
점수 선택이 결과를 바꾼다. 소득구간이 "100만 미만 / 100~200 / 200~500 / 500 이상"이면 정수 \(0,1,2,3\)보다 중앙값이나 로그 점수가 나을 수 있다. 반드시 사전에 정한다.
실무 지침 넷.
- 양쪽 모두 순서형이고 단조 관계를 예상하면 선형–선형 검정.
- 한쪽만 순서형이면 코크런·아미티지 추세검정(11.2절 동질성 검정).
- 모양을 모르면 둘 다 계산하되, 어느 것을 주 결과로 삼을지 사전에 정한다.
- 일반 검정이 유의한데 선형–선형이 아니면 비단조 구조를 의심하고 잔차를 본다.
연습문제 11. 예이츠 보정 통계량이 언제나 보정하지 않은 통계량보다 작거나 같음을 증명하라.
풀이
임의의 칸 \((i,j)\)에 대해 \(d_{ij} = |O_{ij} - E_{ij}|\)라 하자. 보정하지 않은 기여는 \(d_{ij}^2 / E_{ij}\)이고, 예이츠 보정 기여는 \((\max(d_{ij} - 0.5, 0))^2 / E_{ij}\)이다.
모든 \(d_{ij} \ge 0\)에 대해 \(\max(d_{ij} - 0.5, 0) \le d_{ij}\)이므로
이다. 모든 칸에 대해 합하면
이 되어, 보정 통계량은 언제나 보정하지 않은 것보다 작거나 같고 따라서 검정이 더 보수적이 된다(p 값이 커진다). \(\square\)
연습문제 12. 통계량 하나는 어느 칸이 그것을 만들었는지 말해 주지 않는다. 위 절의 표 \(\begin{pmatrix} 10 & 5 \\ 3 & 12 \end{pmatrix}\) 에 대해 표준화 잔차 \((O_{ij} - E_{ij})/\sqrt{E_{ij}}\) 와 조정 잔차를 칸마다 구하고, 어느 칸이 통계량에 가장 많이 기여하는지 밝혀라. \(\sum_{i,j} R_{ij}^2 = X^2\) 으로 검산하시오.
풀이
import numpy as np
from scipy import stats

tab = np.array([[10, 5], [3, 12]], float)
chi2, p, df, exp = stats.chi2_contingency(tab, correction=False)
n = tab.sum()
rp, cp = tab.sum(1) / n, tab.sum(0) / n

resid = (tab - exp) / np.sqrt(exp)
adj = (tab - exp) / np.sqrt(exp * np.outer(1 - rp, 1 - cp))
contrib = (tab - exp)**2 / exp

print(f"X² = {chi2:.4f},  df = {df},  p = {p:.4f}")
print(f"기대도수\n{np.round(exp, 4)}")
print(f"\n표준화 잔차\n{np.round(resid, 4)}")
print(f"조정 잔차\n{np.round(adj, 4)}")
print(f"X² 기여율(%)\n{np.round(contrib / chi2 * 100, 2)}")
print(f"\n검산  ΣR² = {np.sum(resid**2):.4f}   (= X²)")
X² = 6.6516,  df = 1,  p = 0.0099
기대도수
[[6.5 8.5]
 [6.5 8.5]]

표준화 잔차
[[ 1.3728 -1.2005]
 [-1.3728  1.2005]]
조정 잔차
[[ 2.5791 -2.5791]
 [-2.5791  2.5791]]
X² 기여율(%)
[[28.33 21.67]
 [28.33 21.67]]

검산  ΣR² = 6.6516   (= X²)
\(2\times2\) 표의 특징 셋이 한눈에 보인다.
1 — 조정 잔차가 네 칸 모두 크기가 같다(\(|2.5791|\)). 자유도가 1이므로 독립적인 정보가 하나뿐이다. \(X^2=2.5791^2=6.6516\)으로, 조정 잔차 하나가 통계량 전체를 결정한다.
2 — 기여율은 균등하지 않다(28.3% 대 21.7%). 기대도수가 6.5와 8.5로 다르기 때문이다. \((O-E)\)는 네 칸 모두 \(\pm3.5\)로 같은데 \(E\)가 다르다.
3 — 따라서 \(2\times2\)에서 "어느 칸이 문제인가"는 의미 없는 질문이다. 한 칸이 크면 대각선 방향의 칸도 크고 나머지 둘은 작다. 표 전체가 하나의 이야기다.
\(2\times2\)에서는 무엇을 보고할까.
a, b, c, d = tab.ravel()
p1, p2 = a / (a + b), c / (c + d)
print(f"행별 비율: {p1:.4f} 대 {p2:.4f}   차이 {p1 - p2:+.4f}")
print(f"오즈비 {(a * d) / (b * c):.4f}")
odds, p_f = stats.fisher_exact(tab)
print(f"피셔 정확검정 p = {p_f:.4f}   (카이제곱 p = {p:.4f})")
행별 비율: 0.6667 대 0.2000   차이 +0.4667
오즈비 8.0000
피셔 정확검정 p = 0.0253   (카이제곱 p = 0.0099)
오즈비 8.0과 비율 차이 0.467이 잔차보다 훨씬 유익하다.
피셔 정확검정의 \(p\)가 2.6배 크다(0.0253 대 0.0099). \(n=30\)으로 작고 기대도수가 6.5까지 내려가므로, 정확검정 쪽을 믿는 것이 안전하다.
결론. 잔차 분석은 \(3\times3\) 이상에서 쓰는 도구다. \(2\times2\)에서는 오즈비와 비율 차이, 그리고 정확검정이 답이다.
연습문제 13. 손으로 짠 계산 코드가 수치적으로 안전한지 점검하라. 큰 수, 0인 칸, 대수적으로 같은 두 표현의 차이를 확인한다.
풀이
import numpy as np
from scipy import stats

print("① 도수의 규모가 커지면")
base = np.array([[934., 1070.], [113., 92.], [20., 8.]])
for scale in [1, 1e3, 1e6]:
    c, p, df, _ = stats.chi2_contingency(base * scale, correction=False)
    print(f"  ×{scale:>8.0e}:  X² = {c:14.4f},  p = {p:.6g}")

print("\n② 0 인 칸이 있으면")
cases = [np.array([[10., 0.], [5., 15.]]),
         np.array([[10., 0.], [0., 15.]]),
         np.array([[10., 5., 0.], [5., 10., 0.]])]
for T in cases:
    try:
        c, p, df, _ = stats.chi2_contingency(T, correction=False)
        print(f"  {T.astype(int).tolist()}:  X² = {c:.4f}, df = {df}, "
              f"p = {p:.4f}")
    except Exception as e:
        print(f"  {T.astype(int).tolist()}:  {type(e).__name__}")
        print(f"    {e}")

print("\n③ 대수적으로 같은 두 표현")
T = np.array([[1e6 + 3, 1e6], [1e6, 1e6]])
exp = np.outer(T.sum(1), T.sum(0)) / T.sum()
form_a = np.sum((T - exp)**2 / exp)
form_b = np.sum(T**2 / exp) - T.sum()
print(f"  (O−E)²/E 의 합  = {form_a:.12f}")
print(f"  O²/E − n        = {form_b:.12f}")
print(f"  차이 = {abs(form_a - form_b):.3e}")
① 도수의 규모가 커지면
  ×   1e+00:  X² =        11.8061,  p = 0.00273105
  ×   1e+03:  X² =     11806.1347,  p = 0
  ×   1e+06:  X² =  11806134.6670,  p = 0

② 0 인 칸이 있으면
  [[10, 0], [5, 15]]:  X² = 15.0000, df = 1, p = 0.0001
  [[10, 0], [0, 15]]:  X² = 25.0000, df = 1, p = 0.0000
  [[10, 5, 0], [5, 10, 0]]:  ValueError
    The internally computed table of expected frequencies has a zero element at (0, 2).

③ 대수적으로 같은 두 표현
  (O−E)²/E 의 합  = 0.000002249995
  O²/E − n        = 0.000002250075
  차이 = 8.040e-11
① 통계량이 \(n\)에 정비례한다. 도수를 1000배 하면 \(X^2\)도 정확히 1000배다. \(p\) 값이 0으로 언더플로하므로, 큰 자료에서는 \(p\) 대신 \(X^2\)과 효과크기를 보고해야 한다.
② 칸 도수 0은 괜찮지만 주변합 0은 안 된다.
| 상황 | 결과 |
|---|---|
| 칸 하나가 0 | 계산 가능 |
| 대각선만 채워짐 | 계산 가능 |
| 한 열 전체가 0 | 오류 — 그 열을 빼야 한다 |
한 열이 통째로 비면 그 범주는 존재하지 않는 것이므로, 표에서 제거하고 자유도를 다시 계산해야 한다. scipy가 오류를 내 주는 것이 다행이다.
③ 두 표현의 차이가 유효숫자를 잃게 한다. 참값이 \(2.25\times10^{-6}\)인데 \(O^2/E-n\) 형태는 여덟째 자리부터 틀린다.
왜. \(\sum O^2/E\approx4\times10^6\)에서 \(n=4\times10^6\)을 빼면 큰 수끼리의 뺄셈이 일어나 자리수가 소거된다. 반면 \((O-E)^2/E\)는 처음부터 작은 수를 다룬다.
일반 원칙. 손으로 짤 때는 차이를 먼저 계산한다. 교과서 공식이 "계산이 편한 형태"로 변형되어 있는 경우가 많은데, 그 형태가 수치적으로는 나쁠 수 있다.
| 나쁨 | 좋음 |
|---|---|
| \(\sum O^2/E-n\) | \(\sum(O-E)^2/E\) |
| \(\sum x^2/n-\bar x^2\) | \(\sum(x-\bar x)^2/n\) |
| \(\log(1+x)\)를 직접 | np.log1p(x) |
점검 방법. 같은 양을 두 가지 방법으로 계산해 비교해 본다. 차이가 크면 어느 쪽이 안정적인지 따져 본다.
연습문제 14.
기대표를 obs.sum(axis=1) @ obs.sum(axis=0) / n 으로 짜면 오류가 나지 않고 엉뚱한 수가 나오는 경우가 있다. keepdims=True 를 빼면 정확히 어떤 일이 생기는지 실행해 확인하고, 안전한 대안을 제시하라.
풀이
import numpy as np

obs = np.array([[934., 1070.], [113., 92.], [20., 8.]])
n = obs.sum()

row_keep = obs.sum(axis=1, keepdims=True)
col_keep = obs.sum(axis=0, keepdims=True)
row_flat = obs.sum(axis=1)
col_flat = obs.sum(axis=0)
print(f"keepdims=True 일 때  행합 모양 {row_keep.shape}, "
      f"열합 모양 {col_keep.shape}")
print(f"keepdims 없이       행합 모양 {row_flat.shape}, "
      f"열합 모양 {col_flat.shape}\n")

good = (row_keep @ col_keep) / n
print(f"올바른 기대도수 (모양 {good.shape})\n{np.round(good, 2)}")

try:
    bad = (row_flat @ col_flat) / n
    print(f"\nkeepdims 없이: {bad}   ← 스칼라!  모양 {np.shape(bad)}")
except Exception as e:
    print(f"\nkeepdims 없이: {type(e).__name__}: {e}")
keepdims=True 일 때  행합 모양 (3, 1), 열합 모양 (1, 2)
keepdims 없이       행합 모양 (3,), 열합 모양 (2,)

올바른 기대도수 (모양 (3, 2))
[[ 955.86 1048.14]
 [  97.78  107.22]
 [  13.36   14.64]]

keepdims 없이: ValueError: matmul: Input operand 1 has a mismatch in its core dimension 0, with gufunc signature (n?,k),(k,m?)->(n?,m?) (size 2 is different from 3)
이 표에서는 운 좋게 오류가 난다. 행이 3개, 열이 2개로 길이가 달라 행렬곱이 성립하지 않기 때문이다.
정방 표에서는 조용히 틀린 값이 나온다.
square = np.array([[30., 20.], [10., 40.]])
m = square.sum()
r_flat, c_flat = square.sum(axis=1), square.sum(axis=0)
r_keep = square.sum(axis=1, keepdims=True)
c_keep = square.sum(axis=0, keepdims=True)

print(f"올바른 기대도수\n{np.round((r_keep @ c_keep) / m, 4)}")
print(f"\nkeepdims 없이 @ 를 쓰면: {(r_flat @ c_flat) / m:.4f}  ← 내적(스칼라)")
print(f"안전한 대안 np.outer:\n{np.round(np.outer(r_flat, c_flat) / m, 4)}")
올바른 기대도수
[[20. 30.]
 [20. 30.]]

keepdims 없이 @ 를 쓰면: 50.0000  ← 내적(스칼라)
안전한 대안 np.outer:
[[20. 30.]
 [20. 30.]]
\(2\times2\) 표에서는 오류 없이 50.0이라는 스칼라가 나온다. 그 뒤의 계산이 브로드캐스팅으로 진행되어 완전히 틀린 결과가 조용히 산출된다.
왜 이런 차이가. 1차원 배열 두 개에 @를 쓰면 numpy는 내적으로 해석한다. \((3,)\)과 \((2,)\)는 길이가 달라 오류가 나지만, \((2,)\)와 \((2,)\)는 내적이 성립한다.
더 안전한 세 가지 대안.
r, c = square.sum(axis=1), square.sum(axis=0)
print("① np.outer        :", np.allclose(np.outer(r, c) / m,
                                         (r_keep @ c_keep) / m))
print("② 명시적 reshape  :", np.allclose(r.reshape(-1, 1) * c.reshape(1, -1) / m,
                                         (r_keep @ c_keep) / m))
print("③ np.einsum       :", np.allclose(np.einsum('i,j->ij', r, c) / m,
                                         (r_keep @ c_keep) / m))
① np.outer        : True
② 명시적 reshape  : True
③ np.einsum       : True
np.outer를 권한다. 이름이 의도를 그대로 드러내고(\(\mathbf r\otimes\mathbf c\)), 1차원 입력을 받는 것이 자연스러우며, 모양 실수가 일어날 여지가 없다.
일반 교훈 셋.
- 모양(shape)을 출력해 보는 습관을 들인다. 배열 연산 버그의 대부분이 모양 문제다.
- 정방 행렬로만 시험하지 않는다. \(3\times2\)처럼 비정방 자료로 시험해야 모양 버그가 드러난다.
- 검산을 넣는다. 기대도수의 행 합·열 합을 확인하면(보기 \(1\) 의 (1)) 이런 실수가 즉시 잡힌다.
정리하며¶
독립성 검정은 한 표본에서 두 변수를 함께 측정해 연관을 본다.
- 기대도수가 주변합에서 나온다. 독립이면 \(P(A\cap B)=P(A)P(B)\) 이므로, 행 비율과 열 비율을 곱해 \(n\) 을 곱한 것이 기대도수다. 3장의 독립 정의를 도수로 옮긴 것뿐이다.
- 적합도와 다른 점은 기대도수의 출처다. 적합도에서는 가설이 확률을 직접 주지만, 여기서는 자료의 주변합에서 추정한다. 그래서 자유도가 더 줄어든다.
- 기각은 "연관이 있다"까지다. 인과도, 방향도, 강도도 말하지 않는다. 1장의 교란 논의가 그대로 적용된다.
- 표가 크면 어느 칸이 원인인지 보이지 않는다. 표준화 잔차를 보아야 하며, 이 장 뒤에서 열지도로 다룬다.
- \(2\times2\) 에서 기대도수가 작으면 피셔의 정확검정으로 간다.
다음 절 동질성 검정으로 넘어간다. 계산은 이 절과 똑같은데 설계와 해석이 다르다 — 표본이 하나인가 여럿인가, 그리고 주변합 가운데 무엇이 설계로 고정되었는가에서 갈린다. 두 검정을 다 세우고 잔차까지 본 뒤에, 11.2절 타이타닉 생존과 성별이 승객 \(891\) 명의 자료에 그 전부를 끝까지 걸어 본다.