본페로니와 셰페 방법¶
개요¶
들어가는 이야기 — 언제 정했는지가 임계값을 바꾼다
무엇을 비교할지 언제 정했는지가 임계값을 바꾼다. 자료를 보기 전에 정해 둔 비교와 보고 나서 고른 비교는 지켜야 할 가족의 크기가 다르기 때문이다.
집단이 넷, 집단당 여덟, \(\text{MS}_W = 6.0\) 인 한 자료를 두 번 분석해 보자. 자료를 모으기 전에 정해 둔 비교 셋만 보면, 본페로니는 \(0.05\) 를 비교 수 셋으로 나누어 \(0.0167\) 을 양쪽 꼬리에 쓰므로 임계값이 \(t_{28}(1-0.05/6) = 2.55\) 이고 어떤 쌍의 차이를 표준오차로 나눈 \(t = 2.61\) 이 그것을 넘어 유의하다.
같은 자료를 본 뒤 집단 하나를 나머지 셋과 묶어 견주기로 하면 사정이 달라진다. 자료를 보고 고른다는 것은 눈으로 가능한 모든 대비를 뒤진 것과 같으므로, 셰페는 그 무한히 많은 가족을 한꺼번에 지키도록 임계값을 \((k-1)F_{3,28}(0.95) = 3 \times 2.95 = 8.85\) 로 올린다. 그 대비의 \(F_L = 7.29\) 는 \(8.85\) 에 못 미쳐 아무것도 기각하지 못한다.
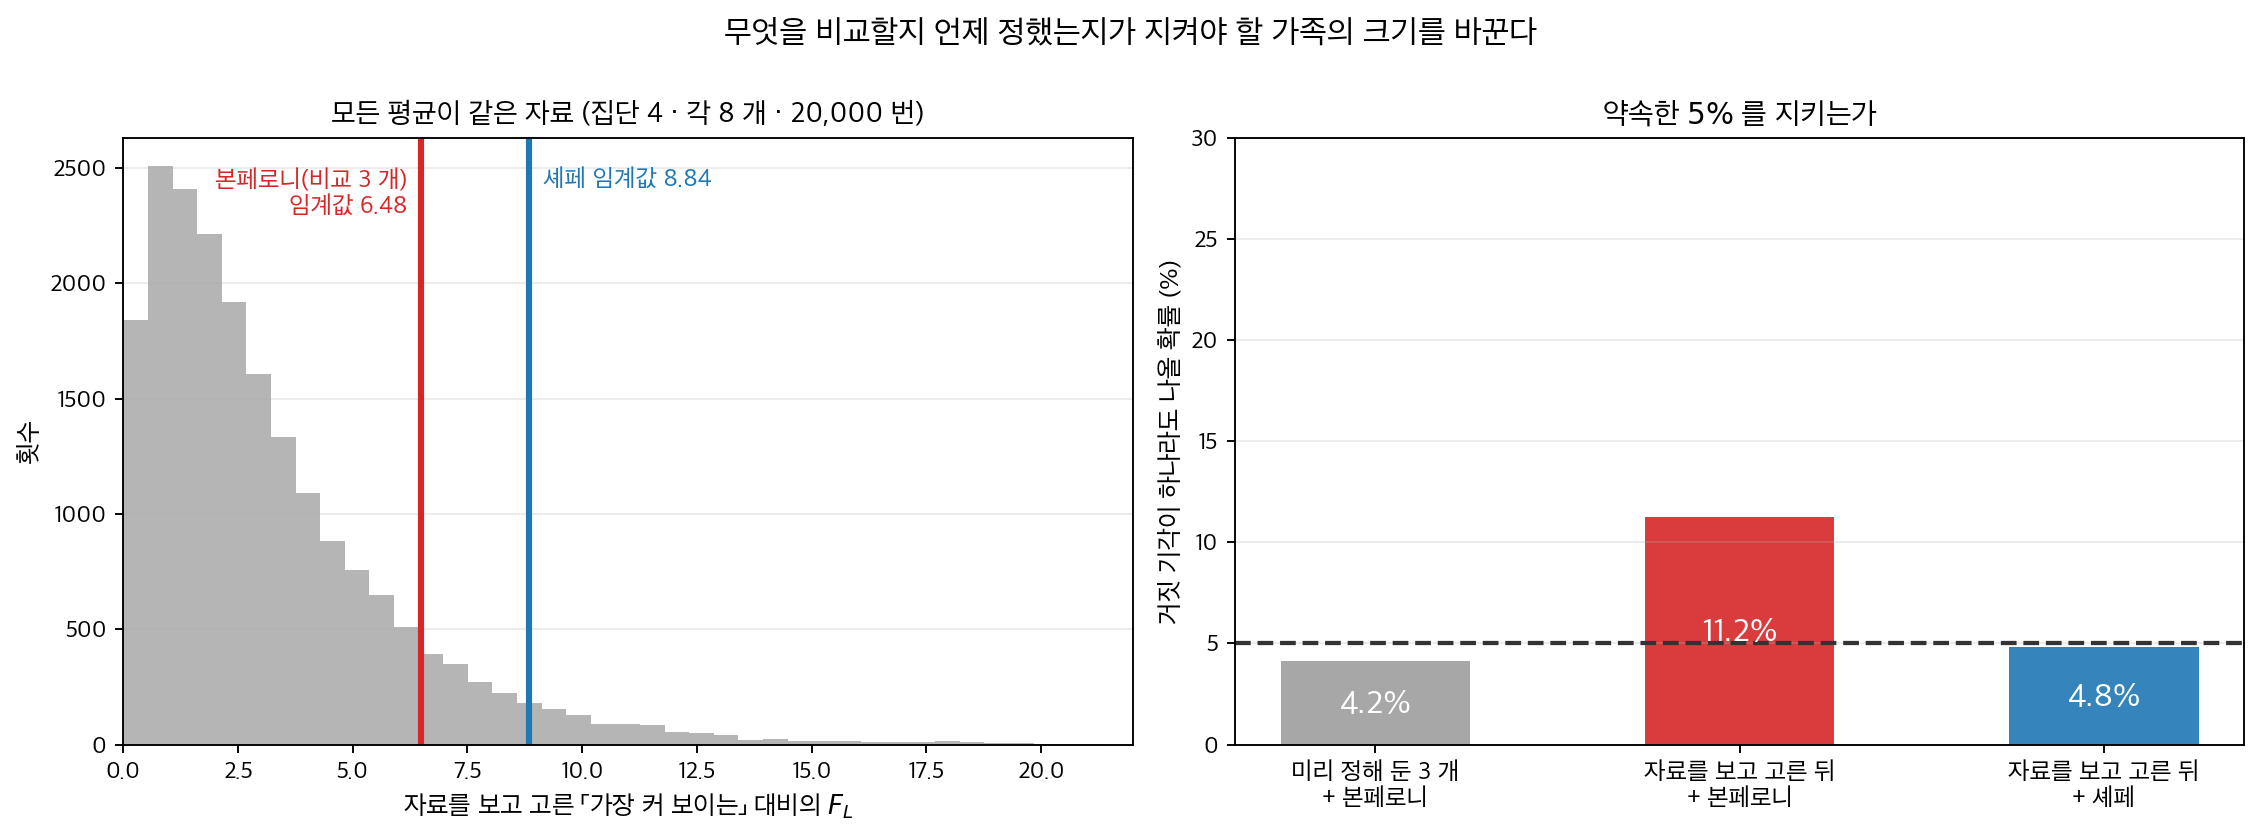
모든 평균이 같은 자료에서 세 가지 절차를 \(20{,}000\) 번 돌렸다. 왼쪽. 자료를 보고 「가장 커 보이는」 대비를 고르면 그 통계량의 분포가 오른쪽으로 길게 끌린다. 본페로니가 비교 셋을 가정해 세운 임계값 \(6.48\) 은 그 꼬리를 막지 못하고, 셰페의 \(8.84\) 는 막는다. 오른쪽. 그래서 미리 정해 둔 셋에 본페로니를 쓰면 \(4.2\%\) 로 약속을 지키는데, 자료를 보고 고른 뒤 같은 본페로니를 쓰면 \(11.2\%\) 로 두 배가 넘는다. 셰페는 \(4.8\%\) 로 지킨다. 가족의 크기는 적어 낸 비교의 수가 아니라 실제로 뒤진 범위다.
가족이 커지면 임계값이 올라가는 것이 두 방법의 공통 원리다. 다만 어느 쪽이 늘 보수적이라는 규칙은 없다. 비교 수가 적으면 본페로니가 느슨하고, 비교 수가 많아지면 \(0.05/m\) 이 빠르게 작아져 본페로니가 셰페보다 엄격해진다. \(\S 1\) 이 그 둘을 구조 없는 다중성과 구조 있는 다중성으로 가른다. 무엇을 비교할지 언제 정했는지가 임계값을 바꾼다면, 가족은 무엇으로 세어야 하는가. 아래 상자가 자료를 먼저 보고 나서 골라도 되는 방법이 어떻게 가능한지 따라간다.
일원배치 분산분석(one-way analysis of variance)이 귀무가설(null hypothesis)을 기각하면 적어도 한 집단의 평균이 나머지와 다르다는 사실은 알 수 있지만, 어느 집단 때문인지는 알 수 없다. 자연스러운 다음 단계는 개별 비교를 검정하는 것이다. \(\mu_i - \mu_j\) 같은 쌍별 차이나, 집단 평균의 더 복잡한 선형결합을 검정한다. 문제는 여러 검정을 동시에 하면 거짓 양성이 적어도 하나 나올 확률이 부풀려진다는 점이다.
여기까지는 9.6절과 같은 이야기다. 가족단위 오류율(FWER)의 정의는 9.6절 정의 1에 있고, 합집합 한계로 그것을 통제하는 논리와 본페로니·홀름 절차는 본페로니와 홀름 보정에서 이미 보았다. 이 절에서 다시 유도하지 않는다.
달라지는 것은 가족의 정체다.
1. 구조 없는 다중성과 구조 있는 다중성¶
9.6절의 가족은 서로 무관한 가설들의 모음이었다. 유전 변이 50만 개, 임상시험의 평가변수 셋, 하위집단 다섯. 이들 사이의 종속 구조에 대해서는 아무것도 모른다. 그래서 어떤 종속에서도 성립하는 합집합 한계를 쓰고, 그것이 느슨하다는 대가를 치른다.
분산분석 뒤의 가족은 다르다. 집단 \(k\)개의 평균을 견주는 비교들은 다음을 공유한다.
- 하나의 합동 분산추정값 \(\text{MS}_W\). 쌍마다 그 두 집단의 분산을 따로 쓰지 않고, \(k\)개 집단 전체에서 얻은 같은 값을 모든 비교의 분모에 넣는다.
- 하나의 오차 자유도 \(N - k\). 쌍마다 자유도가 달라지지 않는다.
- 같은 집단 평균들. \(\bar{Y}_{1\cdot} - \bar{Y}_{2\cdot}\)와 \(\bar{Y}_{1\cdot} - \bar{Y}_{3\cdot}\)은 \(\bar{Y}_{1\cdot}\)을 함께 쓴다. 균형 설계에서 이 두 검정통계량(test statistic)의 상관은 정확히 \(1/2\)이다.
종속 구조를 모르는 것이 아니라 정확히 아는 것이 사후비교(post hoc comparison)의 형편이다. 그리고 아는 만큼 정확한 방법을 쓸 수 있다.
| 가족 | 정확한 방법 | 무엇이 정확한가 |
|---|---|---|
| 쌍별 비교 \(\binom{k}{2}\)개(균형·등분산) | 투키 HSD | 스튜던트화 범위분포가 "\(k\)개 평균의 최대 차이"의 참 귀무분포다 |
| 대조군과의 \(k-1\)개 비교 | 더닛 검정 | 상관 \(\rho = n/(n + n_0)\)의 다변량 \(t\)-분포를 그대로 쓴다 |
| 가능한 모든 선형 대비(무한개) | 셰페 | 자료가 알려 주는 최적 대비의 \(t^2\)이 정확히 \((k-1)F\)다 |
| 사전에 정한 \(m\)개 | 본페로니(및 홀름) | 정확하지 않다. 상관을 버리고 합집합 한계만 쓴다 |
마지막 줄이 이 절의 긴장이다. 본페로니는 분산분석이 공짜로 주는 구조를 쓰지 않는다. 대신 대비가 무엇이든 몇 개든 \(m\)만 알면 적용된다. 투키는 "쌍별 전부"라는 고정된 가족에만, 더닛은 "대조군 대 나머지"에만 쓸 수 있는 반면, 본페로니는 연구자가 고른 임의의 \(m\)개에 쓸 수 있다. 일반성과 검정력을 맞바꾼 것이다. 그래서 \(m\)이 작으면 그 손실이 작고, \(m\)이 \(\binom{k}{2}\)에 가까워지면 투키에 밀린다.
셰페는 세 번째 길이다. 가족을 좁히는 대신 끝까지 넓혀 — 가능한 모든 선형 대비로 — 그 위에서 정확한 임계값을 구한다. 그래서 대비를 자료를 보고 골라도 보장이 유지된다.
2. 본페로니 방법¶
분산분석에 옮겨 놓기¶
유의수준 예산 \(\alpha\)를 \(m\)개 비교에 똑같이 나눈다는 발상과 그 정당화(합집합 한계)는 9.6절에 있다. 본페로니는 p 값이 어디서 왔는지 묻지 않는 절차이므로, 쌍별 비교의 p 값을 넣으면 그대로 작동한다.
다만 어떤 검정의 p 값인지가 중요하다. 쌍 \((i, j)\)를 볼 때 그 두 집단의 자료만으로 이표본 \(t\)-검정을 하는 것이 아니라, \(k\)개 집단 전체에서 얻은 합동 \(\text{MS}_W\)와 자유도 \(N - k\)를 쓴다. 자유도가 \(n_i + n_j - 2\)가 아니라 \(N - k\)이므로 집단이 작을 때 차이가 크다. 분산분석의 구조에서 본페로니가 챙기는 것은 여기까지다. 상관 구조는 여전히 버린다.
그 정당화를 이 쪽의 말로 적어 두면 이렇다.
정리 1. 본페로니 보정의 가족단위 오류율¶
비교 \(m\) 개를 미리 정하고 각각을 유의수준 \(\alpha/m\) 에서 검정하자. 그러면 비교들이 서로 어떻게 얽혀 있든
이고, 등호는 잘못 기각하는 사건들이 서로 겹치지 않을 때만 성립한다.
증명
\(A_j\) 를 「\(j\) 번째 비교를 잘못 기각한다」는 사건이라 하면 \(\Pr(A_j) = \alpha/m\) 이다. 합집합 한계로
다. \(\square\)
등호가 성립하려면 \(A_j\) 들이 서로 배반이어야 하는데, 쌍별 비교는 같은 집단평균을 나눠 쓰므로 한 평균이 크게 튀면 그 평균이 낀 비교들이 함께 잘못되기 쉽다. 곧 겹침이 있고 부등식이 엄격하다.
이 부등식 하나가 보수성의 전부다. 어떤 종속 구조에서도 쓸 수 있다는 것이 장점이자 대가다 — 구조를 묻지 않으므로 구조를 쓸 수도 없다. 10.3절 투키 정직유의차 정리 1 은 같은 합집합을 최댓값으로 바꾸어 등식을 얻고, 그래서 더 낮은 임계값으로 같은 \(\alpha\) 를 지킨다. \(4\) 절이 그 차이를 수로 잰다.
형식적 절차¶
집단이 \(k\)개, 전체 관측이 \(N\)개이고 자유도 \(N - k\)의 집단 내 평균제곱이 \(\text{MS}_W\)인 일원배치 분산분석 뒤에 비교 \(m\)개를 계획했다고 하자. 각 비교의 절차는 다음과 같다.
1단계. 비교를 정의한다. 쌍별 비교 \(\mu_i - \mu_j\)이거나, 더 일반적으로 \(\sum c_i = 0\)인 임의의 대비 \(L = \sum_{i=1}^{k} c_i \mu_i\)이다.
2단계. 검정통계량을 계산한다. 쌍별 비교에서는
이고, 일반적인 대비 \(L = \sum c_i \mu_i\)에서는
이다.
3단계. \(|t|\)를 임계값 \(t_{\alpha/(2m),\, N-k}\)와 비교한다. \(|t| > t_{\alpha/(2m),\, N-k}\)이면 \(H_0: L = 0\)을 기각한다.
동등하게, 각 검정의 p 값을 계산하여 \(p < \alpha/m\)이면 기각한다.
본페로니를 언제 쓰는가
본페로니는 계획된 비교의 수 \(m\)이 작을 때 가장 강력하다. \(k\)개 집단의 모든 쌍별 비교라면 \(m = \binom{k}{2}\)이고, 이 경우에는 대개 투키의 HSD가 더 강력하다. 가족이 "쌍별 전부"로 고정되면 투키가 그 가족의 정확한 귀무분포를 쓸 수 있는데, 본페로니는 버리는 상관 정보가 바로 그것이다. 본페로니 보정은 미리 지정한 가설이 소수일 때 빛을 발한다. 예를 들어 5개 집단에서 10개의 쌍별 비교를 모두 하는 대신 특정한 대비 3개만 검정할 때가 그렇다. 대조군과의 비교만 필요하다면 더닛 검정이 같은 이유로 더 강력하다.
보기 1. 본페로니 보정 계산. 집단이 \(k = 4\)개(각각 \(n = 8\)개 관측, 따라서 \(N = 32\))인 일원배치 분산분석에서 자유도 \(N - k = 28\)의 \(\text{MS}_W = 6.0\)을 얻었다. 집단 평균은 \(\bar{Y}_1 = 14.0\), \(\bar{Y}_2 = 11.5\), \(\bar{Y}_3 = 15.2\), \(\bar{Y}_4 = 12.0\)이다. 연구자는 자료를 모으기 전에 \(m = 3\)개의 비교를 계획했다.
- \(\mu_1 - \mu_2\)
- \(\mu_3 - \mu_4\)
- \(\mu_1 - \mu_4\)
풀이
본페로니 조정 유의수준은 \(\alpha^* = 0.05 / 3 = 0.0167\)이며, 양측 임계값은 \(t_{0.9917,28} \approx 2.55\)이다.
비교 1.
\(|2.04| < 2.55\)이므로 본페로니 보정 후 이 비교는 유의하지 않다.
비교 2.
\(|2.61| > 2.55\)이므로 이 비교는 유의하다. 집단 3과 4는 본페로니 보정 수준에서 다르다.
비교 3.
\(|1.63| < 2.55\)이므로 이 비교는 유의하지 않다.
3. 셰페 방법¶
셰페는 모든 대비를 한꺼번에 보장한다¶
본페로니가 미리 지정된 고정 비교 집합에 대해 FWER을 통제하는 반면, 셰페 방법은 더 강한 보장을 준다. 집단 평균의 가능한 모든 선형 대비에 대해 FWER을 동시에 통제한다. 그래서 비교를 미리 계획하지 않고 자료를 보고 착안한 경우에 알맞다. 대가는 셰페의 임계값이 더 커서(더 보수적이어서) 개별 비교의 검정력은 낮다는 점이다.
셰페가 본페로니와 갈리는 지점도 결국 구조다. 본페로니는 가족의 크기 \(m\)만 세고 그 안의 상관은 묻지 않는다. 셰페는 대비 공간 전체의 기하를 쓴다. 집단 평균 벡터에서 \(\sum c_i = 0\)인 방향들이 만드는 \(k-1\)차원 부분공간이 그 기하이며, 임계값의 \((k-1)\)이 바로 그 차원이다. 무한히 많은 대비를 동시에 보호하면서도 임계값이 유한한 것은 그 무한이 \(k-1\)차원 안에 들어 있기 때문이다. 검정하는 대비의 개수와 무관하게 임계값이 일정한 이유도 같다.
선형 대비¶
선형 대비는 모평균들의 선형결합이다.
제약 \(\sum c_i = 0\)은 \(L\)이 수준이 아니라 차이를 재도록 보장한다. 쌍별 비교는 특수한 경우이다. \(\mu_i - \mu_j\)는 \(c_i = 1\), \(c_j = -1\)이고 나머지 계수가 0인 대비이다. 더 복잡한 대비도 가능하다. 예를 들어 한 집단을 다른 두 집단의 평균과 비교하는 \(\mu_1 - \frac{1}{2}(\mu_2 + \mu_3)\)은 계수 \(c_1 = 1\), \(c_2 = -1/2\), \(c_3 = -1/2\)을 쓴다.
「모든 대비를 한꺼번에」라는 보장이 정확히 무엇인지는 정리로 적어야 한다.
정리 2. 셰페의 동시신뢰대¶
일원배치에서 \(\varepsilon_{ij}\) 가 서로 독립으로 \(N(0,\ \sigma^2)\) 을 따른다고 하자. \(\sum_i c_i = 0\) 인 대비 \(L(c) = \sum_i c_i \mu_i\) 와 그 추정량 \(\hat L(c) = \sum_i c_i \bar Y_{i\cdot}\), 그리고 \(\mathrm{SE}(c) = \sqrt{\text{MS}_W\sum_i c_i^2/n_i}\) 에 대해 \(\nu = N-k\) 이면
이다. 등호이고, 「모든 대비」에는 자료를 보고 고른 대비까지 들어간다.
증명
\(d_i = \bar Y_{i\cdot} - \mu_i\) 라 두면 \(d_i\) 는 서로 독립이고 \(N(0,\ \sigma^2/n_i)\) 다. \(\text{MS}_W\) 는 \(c\) 에 걸리지 않으므로 빼고
만 구하면 된다. \(a_i = c_i/\sqrt{n_i}\) 로 바꾸면 분모가 \(\lVert a\rVert^2\), 분자가 \(\langle a,\ v\rangle^2\) 이고(\(v_i = \sqrt{n_i}\,d_i\)), 제약 \(\sum_i c_i = 0\) 은 \(\langle a,\ u\rangle = 0\) 이 된다(\(u_i = \sqrt{n_i}\)).
여기서 코시–슈바르츠가 답을 준다. \(u\) 에 직교하는 \(a\) 들 위에서 \(\langle a, v\rangle^2/\lVert a\rVert^2\) 의 최댓값은 \(v\) 를 \(u^{\perp}\) 로 사영한 길이제곱이고, 그 최댓값을 주는 \(a\) 가 바로 그 사영이다. 곧
다. 오른쪽은 중심을 옮긴 집단평균의 집단간제곱합이므로 10.1절 F 검정 정리 1 에 의해 \(M/\sigma^2 \sim \chi^2_{k-1}\) 이고, 같은 정리가 주는 독립성(independence)으로 \(\text{MS}_W\) 와 독립이다. 따라서
이고 이 값이 \(F_{\alpha,k-1,\nu}\) 이하일 확률이 \(1-\alpha\) 다. 그런데 \(M\) 이 최댓값이므로 「\(M/(k-1)\text{MS}_W \le F_\alpha\)」는 「모든 \(c\) 에 대해 \(\lvert\hat L(c)-L(c)\rvert \le \sqrt{(k-1)F_\alpha}\,\mathrm{SE}(c)\)」와 같은 사건이다. \(\square\)
최댓값으로 바꾸는 수법이 투키와 같다. 다른 것은 최댓값을 무엇 위에서 재느냐다 — 투키는 쌍 \(k(k-1)/2\) 개 위에서, 셰페는 대비 전체라는 무한집합 위에서 잰다. 그래서 셰페의 임계값이 더 높고, 그 대신 자료를 보고 고른 대비도 덮는다. 쌍별 비교만 할 것이라면 셰페는 치르지 않아도 될 값을 치르는 셈이고, \(4\) 절이 그 값을 수로 잰다.
형식적 절차¶
추정값이 \(\hat{L} = \sum c_i \bar{Y}_{i\cdot}\)인 대비 \(L = \sum c_i \mu_i\)에 대해 이렇게 된다.
1단계. 대비의 F-통계량을 계산한다.
2단계. \(F_L\)을 셰페 임계값과 비교한다.
3단계. \(F_L > F_{\text{crit}}^{S}\)이면 \(H_0: L = 0\)을 기각한다.
동등하게 \(t\) 형태로 쓸 수도 있다. \(t_L = \hat{L} / \text{SE}(\hat{L})\)일 때 \(|t_L| > \sqrt{(k-1) F_{\alpha, k-1, N-k}}\)이면 기각한다.
셰페가 F가 아니라 (k−1)F를 쓰는 이유
인자 \((k - 1)\)은 가능한 모든 대비에 대해 FWER을 동시에 통제한다는 사실을 반영한다. Roy의 합집합–교집합 원리에 따르면 모든 대비 \(L\)에 걸친 \(F_L\)의 최댓값은 전체 분산분석 F-통계량의 정확히 \((k-1)\)배이고(연습문제 9 가 확인한다), 전체 F-통계량의 임계값은 \(F_{\alpha, k-1, N-k}\)이다. 그러므로 임계값에도 \((k-1)\)을 곱해 두면 가장 큰 \(F_L\)조차 확률 \(\alpha\)로만 그것을 넘고, 가족단위 보장이 확보된다.
보기 2. 셰페 방법 계산. 본페로니 보기와 같은 자료(\(k = 4\), \(n = 8\), \(\text{MS}_W = 6.0\), \(N - k = 28\))에서, 연구자가 자료를 보고 대비 \(L = \mu_3 - \frac{1}{3}(\mu_1 + \mu_2 + \mu_4)\)을 검정하기로 했다고 하자. 집단 3을 나머지 세 집단의 평균과 비교하는 것이다. 대비 계수는 \(c_1 = -1/3\), \(c_2 = -1/3\), \(c_3 = 1\), \(c_4 = -1/3\)이다.
풀이
대비 추정값은
이다. 표준오차의 분모는
이고, 대비의 F-통계량은
이다. \(F_{0.05, 3, 28} \approx 2.95\)이므로 셰페 임계값은
이다. \(F_L = 7.29 < 8.85\)이므로 셰페 방법으로는 이 대비가 유의하지 않다. 셰페 접근의 보수성을 보여준다. 대비의 점추정값은 상당하지만, 가능한 모든 대비를 동시에 통제하기 위해 요구되는 임계값에는 이르지 못한다.
그림으로 보는 통계학 1. 먼저 보고 나서 골라도 되는 방법
§3 의 직관은 통계학의 금기 하나를 정면으로 깬다. 자료를 보고 나서 무엇을 비교할지 고르면, 그 고르는 행위 자체가 다중성이 되고 몇 번 골랐는지 셀 수조차 없다. 셰페의 방법은 그 셀 수 없음을 통째로 집어삼킨다.
만든 사람은 뉴욕에서 가난한 독일 이민자의 아들로 태어난 헨리 셰페(\(1907\)–\(1977\))다. 제빵공이던 아버지가 대공황에 일자리를 잃고 길모퉁이에서 사과를 팔아 식구를 먹였다. 위스콘신에서 받은 그의 박사학위 논문은 통계학이 아니라 미분방정식이었다 — 제목이 「계수가 영을 가질 수 있는 어떤 선형미분방정식의 점근해」다. 통계학으로 건너온 뒤 오리건주립·리드·프린스턴·시러큐스·UCLA·컬럼비아를 거쳐 \(1953\) 년 버클리에 자리를 잡았고, 이 책에 여러 번 나오는 레만–셰페 정리의 그 셰페다. 버클리에 온 해에 낸 글의 제목이 「분산분석의 모든 대비를 판정하는 방법」이었다.
그런데 이 「모든」에는 위에서 적지 않은 선물이 하나 더 들어 있다. 전역 \(F\) 가 기각하면 셰페로 유의한 대비가 반드시 존재하고, 그것이 무엇인지 식으로 적힌다. \(c_i \propto \bar y_{i\cdot} - \bar y_{\cdot\cdot}\) 로 두면 그 대비의 \(F_L\) 이 정확히 \((k-1)F\) 가 되어, 전역 \(F\) 가 \(F_\alpha\) 를 넘는 꼭 그만큼 셰페 임계값 \((k-1)F_\alpha\) 를 넘는다.
이것이 반가운 까닭은 이 장에 세 번 나오는 당혹 — 「전역 \(F\) 는 기각했는데 어느 쌍도 유의하지 않다」 — 에 대한 답이기 때문이다.
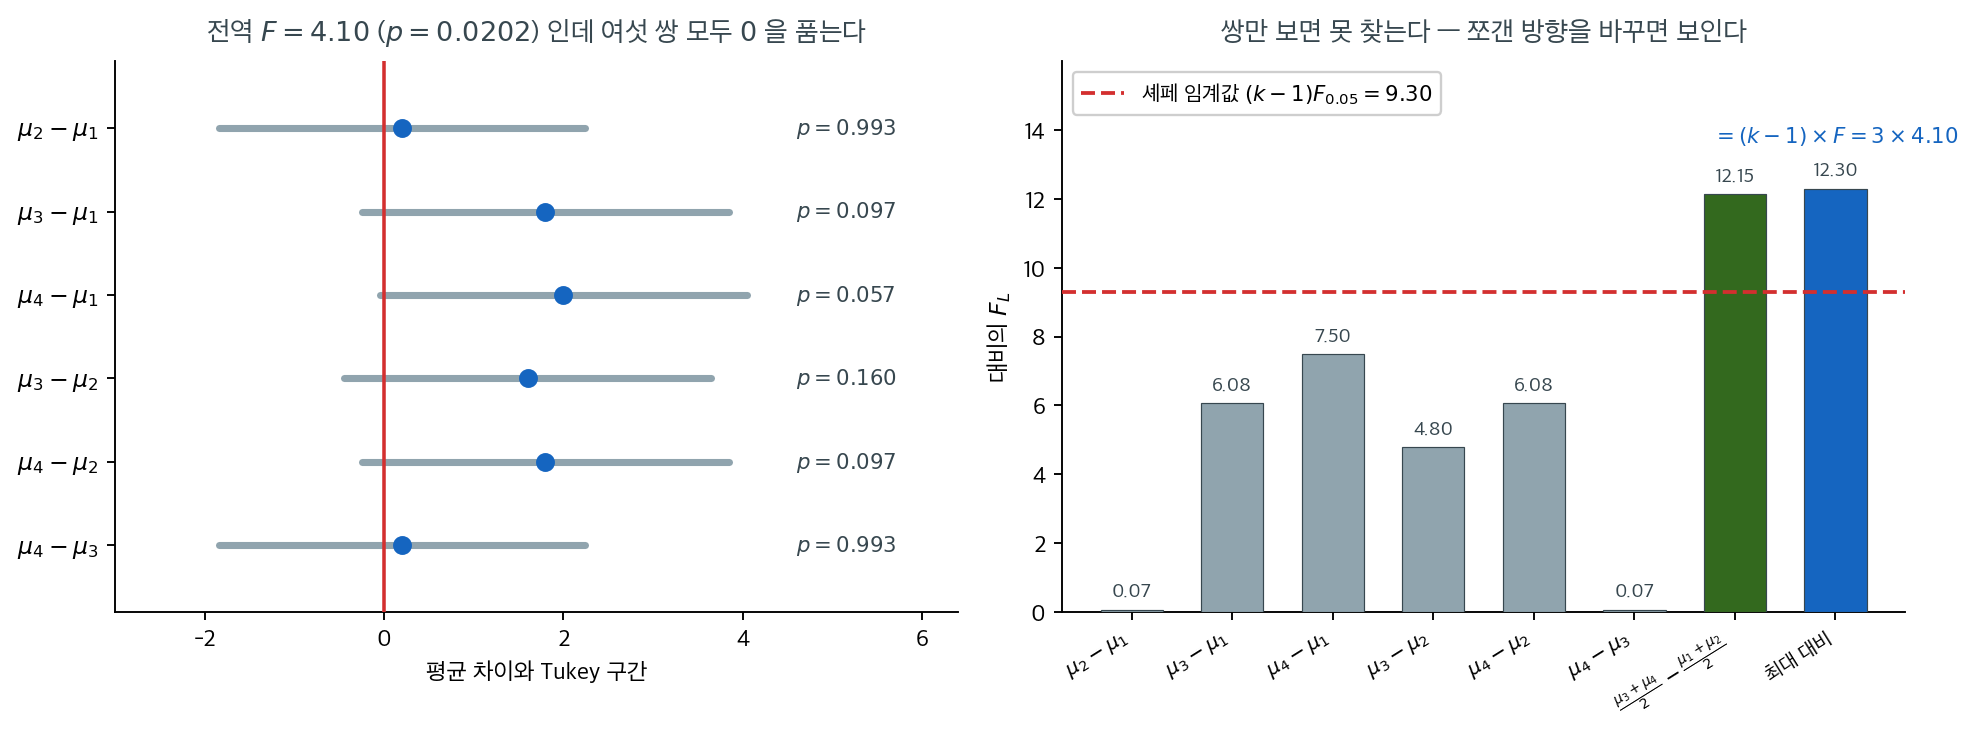
네 집단의 평균이 \(10.0\), \(10.2\), \(11.8\), \(12.0\) 이고 \(\text{MS}_W = 1.60\), 집단당 \(n = 6\) 이라 하자. 전역 \(F = 4.10\), \(p = 0.0202\) 로 기각이다. 그런데 왼쪽에서 여섯 쌍의 투키 구간이 모두 \(0\) 을 품는다. 가장 아까운 \(\mu_4 - \mu_1\) 조차 \(p = 0.057\) 이다.
오른쪽이 까닭이다. 신호가 쌍 방향에 있지 않다. 앞의 둘과 뒤의 둘로 가르는 대비 \(\frac{\mu_3+\mu_4}{2} - \frac{\mu_1+\mu_2}{2}\) 는 \(F_L = 12.15\) 로 셰페 임계값 \(9.30\) 을 넘는다. 셰페 공식이 짚어 주는 최대 대비 \(c = (-1,\ -0.8,\ 0.8,\ 1)\) 은 \(F_L = 12.30\) 이고, 이 값은 \(3 \times 4.10\) 과 소수점 아래 열넷째 자리까지 같다.
그러니 「\(F\) 는 기각했는데 쌍이 없다」는 모순이 아니라 쪼갠 방향이 틀렸다는 신호다. 쌍별 비교는 \(k-1\) 차원 대비공간에서 \(\binom{k}{2}\) 개의 방향만 들여다본다. \(F\) 는 그 공간 전체를 보고, 셰페는 \(F\) 가 본 그 방향을 되돌려 준다.
대가도 분명하다. 쌍별 비교만 할 생각이라면 셰페 임계값은 투키보다 늘 높다. 위 보기 2 에서 \(F_L = 7.29\) 가 \(8.85\) 에 못 미쳐 기각되지 못한 것이 그것이다. 무한히 많은 대비를 지키는 값은 몇 개만 쓸 때에도 치러야 한다. 비교를 미리 셀 수 있으면 본페로니가, 쌍별만 할 것이면 투키가 싸다. 셰페는 무엇을 비교할지 아직 모를 때 내는 보험료다.
확인한 곳 — 셰페(\(1907\) 년 \(4\) 월 \(11\) 일 뉴욕 출생, \(1977\) 년 \(7\) 월 \(5\) 일 버클리에서 자전거 사고로 사망)가 가난한 독일 이민자의 아들이고 제빵공이던 아버지가 대공황에 일자리를 잃어 길모퉁이에서 사과를 팔았다는 것, \(1935\) 년 위스콘신에서 「The Asymptotic Solutions of Certain Linear Differential Equations in which the Coefficient of the Parameter May Have a Zero」로 박사학위를 받았다는 것, 오리건주립·리드·프린스턴·시러큐스·UCLA·컬럼비아를 거쳐 \(1953\) 년부터 \(1974\) 년 은퇴까지 버클리에 있었다는 것, 「A method for judging all contrasts in the analysis of variance」(\(1953\))가 그의 가장 중요한 논문으로 꼽히고 『The Analysis of Variance』(\(1959\))가 표준 교재로 남아 있다는 것은 MacTutor 의 Henry Scheffé 항목. 그림의 네 평균과 \(\text{MS}_W\) 는 이 상자를 위해 고른 값이고, 전역 \(F\)·여섯 쌍의 Tukey \(p\) 값·대비들의 \(F_L\)·\(F_L^{\max} = (k-1)F\) 항등식 확인은 모두 직접 계산한 값이다
4. 본페로니와 셰페의 비교¶
두 방법은 FWER 통제라는 같은 문제를 다루지만 최적인 상황이 다르다.
| 항목 | 본페로니 | 셰페 |
|---|---|---|
| FWER을 통제하는 대상 | 미리 지정한 고정된 \(m\)개의 비교 | 가능한 모든 선형 대비를 동시에 |
| 임계값이 의존하는 것 | 비교의 수 \(m\) | 집단의 수 \(k\) (\(m\)이 아님) |
| 검정력 | \(m\)이 작을 때 더 높다 | 고정된 집합에 대해서는 낮지만 무한한 대비에 적용된다 |
| 적합한 경우 | 자료 수집 전에 비교를 계획했을 때 | 비교가 탐색적이거나 자료에서 착안했을 때 |
| 보수성 | \(m\)과 함께 커진다 | 검정하는 대비의 수와 무관하게 일정하다 |
흔한 함정
자료에서 착안한 비교에 본페로니를 쓰면 방법의 가정을 위반한다. 어느 비교를 검정할지가 자료의 영향을 받았다면 실제로 "암묵적인" 비교의 수가 \(m\)을 넘어서므로 FWER이 더 이상 \(\alpha\)로 통제되지 않는다. 이런 경우에는 대비를 어떻게 고르든 보장이 유지되는 셰페 방법이 옳은 선택이다.
경험 법칙: 미리 지정한 비교라면 거의 언제나 본페로니가 강력하다. 연습문제 3 이 교차점을 셈하는데 \(k = 3\) 에서 \(M \ge 4\), \(k = 4\) 에서 \(9\), \(k = 5\) 에서 \(21\), \(k = 10\) 에서 \(883\) 이다 — \(k \ge 4\) 에서는 쌍별 비교를 전부 해도 교차점에 한참 못 미친다(\(6\) 대 \(9\), \(10\) 대 \(21\), \(45\) 대 \(883\)). 셰페를 고를 까닭은 비교의 개수가 아니라 위 쪽지가 적은 비교를 자료에서 골랐다는 것이다.
두 방법의 성격 차이를 그림으로 확인해 두자. 왼쪽은 "가능한 모든 대비"가 실제로 무엇인지, 그리고 그 위에서 \((k-1)F\)가 왜 나오는지를 보여 준다. 앞 절의 PlantGrowth 자료(\(k = 3\), 각 \(n = 10\), \(\text{MS}_W = 0.3886\))를 쓴다.
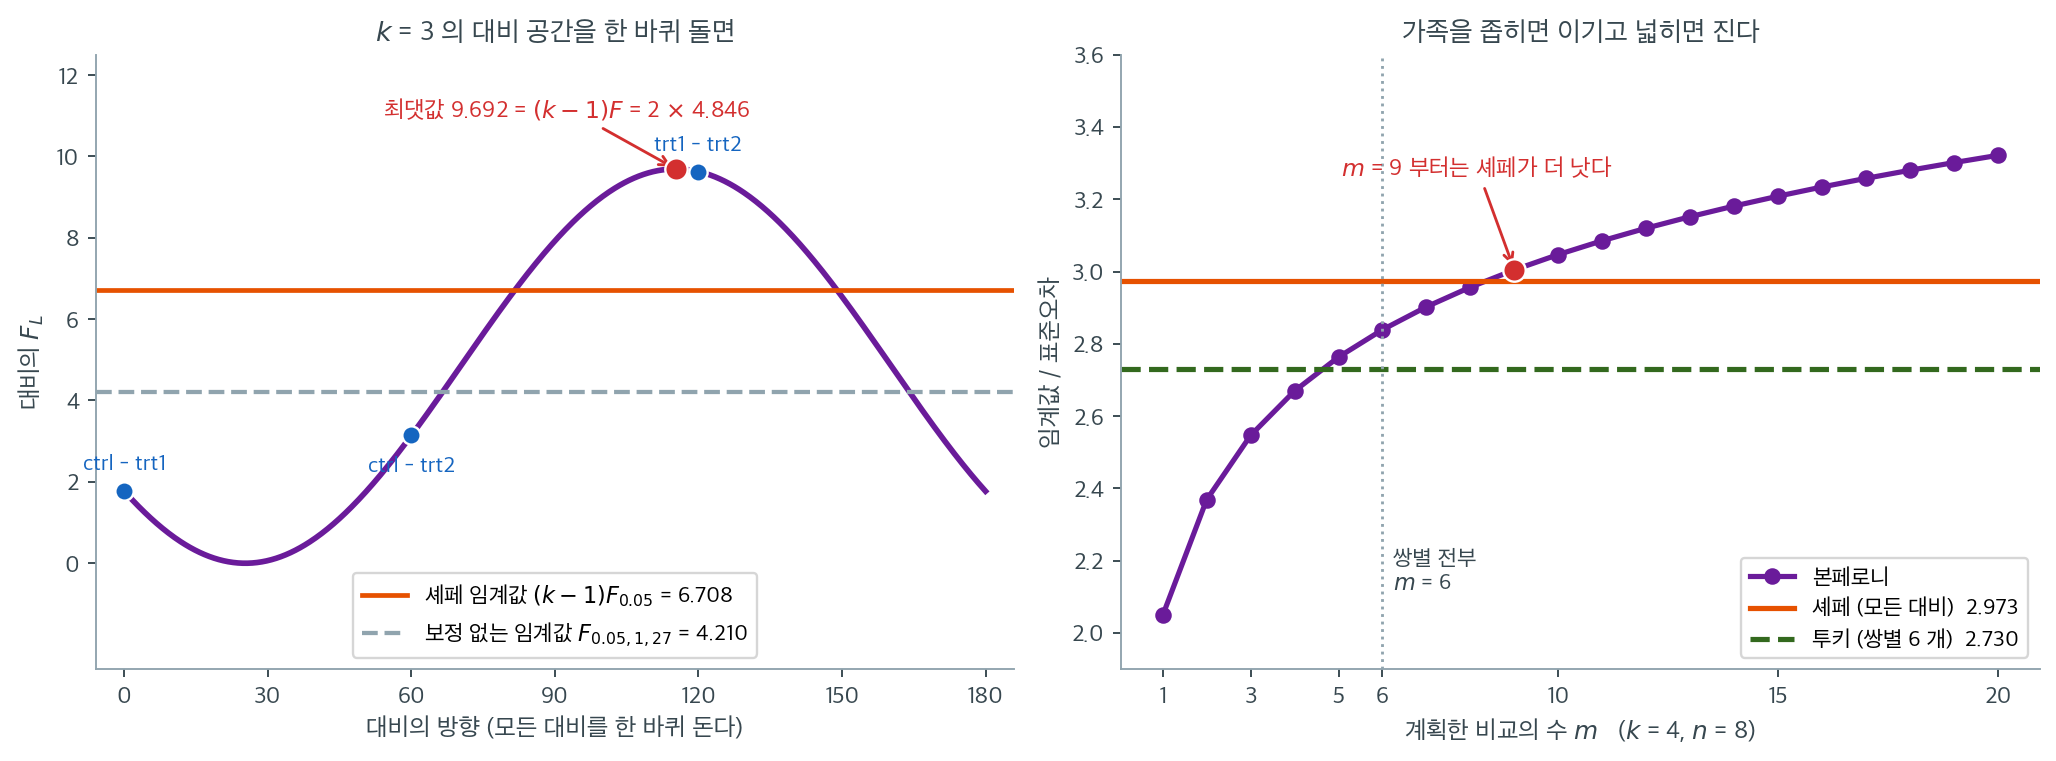
\(k = 3\)이면 \(\sum c_i = 0\)인 대비들은 2차원 평면을 이룬다. 길이를 \(\sum c_i^2 = 1\)로 고정하면 남는 자유도는 방향 하나뿐이므로, 대비 전체를 각도 한 바퀴로 훑을 수 있다. 가로축이 그 각도이고 세로축이 각 대비의 \(F_L\)이다. 세 쌍별 비교는 \(0^\circ,\ 60^\circ,\ 120^\circ\)에 놓이고 각각 \(F_L = 1.771,\ 3.140,\ 9.627\)이다.
곡선의 최댓값이 \(9.692\)인데, 이 값이 옴니버스 \(F = 4.846\)의 정확히 두 배, 곧 \((k-1)F\)다. 우연이 아니라 항등식이다. 자료가 허락하는 가장 유리한 대비를 골랐을 때의 \(F_L\)이 \((k-1)F\)를 넘을 수 없다는 것이 Roy의 합집합–교집합 원리이고, 그래서 임계값을 \((k-1)F_{\alpha}\)로 잡으면 어떤 대비를 어떻게 골라도 보장이 유지된다. 여기서는 \(2 \times 3.354 = 6.708\)이다. 무한히 많은 대비를 보호하는데도 임계값이 유한한 이유가 이 그림에 있다. 무한이 2차원 안에 들어 있기 때문이다.
이 자료의 최적 대비는 \(115.2^\circ\) 방향, 계수로 쓰면 \(c \propto (0.09,\ 0.91,\ -1)\)이다. 쌍별 비교 trt1–trt2(\(120^\circ\))와 거의 같은 방향이고, 그래서 \(F_L\)도 \(9.627\)로 최댓값에 바짝 붙어 있다. 자료를 보고 고른 최적 대비와 미리 정해 둔 쌍별 비교가 거의 일치했다는 뜻이며, 둘 다 셰페 임계값 \(6.708\)을 넘는다. 반대로 회색 점선 \(F_{0.05,1,27} = 4.210\)은 보정 없는 임계값인데, 곡선이 이 선 위로 올라가는 구간이 \(60^\circ\)대 중반부터 \(160^\circ\) 넘어까지 꽤 넓다. 대비를 자료에서 고르면서 이 임계값을 쓰면 안 되는 이유가 보인다.
오른쪽이 본페로니와의 교환 관계다. \(k = 4\), 각 \(n = 8\)(\(\nu = 28\))에서 셰페의 임계값은 \(m\)과 무관하게 \(2.973\)으로 고정이지만 본페로니는 \(m = 1\)의 \(2.048\)에서 출발해 계속 올라간다. 두 선이 만나는 곳이 \(m = 9\)다. 계획한 비교가 여덟 개 이하면 본페로니가 유리하고, 아홉 개를 넘으면 무한히 많은 대비를 보호하는 셰페가 오히려 싸진다. 쌍별 전부인 \(m = 6\)에서는 본페로니가 \(2.840\)으로 셰페보다는 낫지만, 그 가족에 특화된 투키의 \(2.730\)에는 여전히 진다. 가족을 좁게 잡고 그 구조를 쓰는 쪽이 언제나 이긴다는 이 절의 주제가 세 선의 높이로 정리된다.
그리고 검정만 보고할 것이라면 본페로니 자리에 홀름의 단계적 하강법을 넣는 것이 언제나 낫다. 9.6절에서 본 대로 홀름은 같은 FWER 보장에 검정력이 엄밀히 더 크거나 같다. 홀름 역시 상관 구조를 쓰지 않으므로 투키나 더닛만큼 정확해지지는 않지만, 가족이 "임의로 고른 \(m\)개"인 이상 그것이 구조를 묻지 않는 절차가 낼 수 있는 최선이다. 동시 신뢰구간이 필요하면 홀름으로는 만들기 어려우므로 본페로니로 남는다(연습문제 7).
연습문제¶
연습문제 1. 어떤 연구자가 집단 \(k = 5\)개, 집단당 \(n = 10\)개 관측으로 일원배치 분산분석을 수행하여 \(\text{MS}_W = 4.0\)을 얻었다. 연구자는 \(\alpha = 0.05\)에서 다음 세 개의 계획된 대비를 검정하려 한다.
- \(C_1\): \(\mu_1 - \mu_2 = 0\) (집단 1과 2의 비교)
- \(C_2\): \(\mu_3 - \frac{1}{2}(\mu_4 + \mu_5) = 0\) (집단 3과 집단 4·5 평균의 비교)
- \(C_3\): \(\mu_4 - \mu_5 = 0\) (집단 4와 5의 비교)
(a) 각 대비의 본페로니 조정 유의수준은 얼마인가?
(b) \(C_1\)에 대해 \(\bar{Y}_1 = 12.0\), \(\bar{Y}_2 = 9.5\)라고 하자. 검정통계량을 계산하고 본페로니 보정으로 이 대비가 유의한지 판정하라.
(c) 이 세 대비에 대해 셰페 방법은 본페로니보다 강력한가, 덜 강력한가? 설명하라.
풀이
(a) 계획된 대비가 \(m = 3\)개이고 \(\alpha = 0.05\)이므로 본페로니 조정 수준은 대비당 \(\alpha^* = 0.05 / 3 = 0.0167\)이다.
(b) 대비 \(C_1: \mu_1 - \mu_2\)의 검정통계량은
이다. \(\alpha^*/2 = 0.0083\)에서 \(t_{45}\)의 임계값은 약 \(t_{0.9917,45} \approx 2.49\)이다. \(2.80 > 2.49\)이므로 이 대비는 유의하다. 집단 1과 2는 본페로니 보정 수준에서 다르다.
(c) 이 세 대비에 대해서는 셰페 방법이 덜 강력하다. 셰페는 (검정하는 셋만이 아니라) 가능한 모든 대비에 대해 FWER을 통제하므로 임계값이 \(\sqrt{(k-1) F_{0.05, k-1, N-k}} = \sqrt{4 \times F_{0.05, 4, 45}} \approx \sqrt{4 \times 2.58} = 3.21\)로 결정된다. 이는 본페로니의 임계값 약 2.49보다 크다. 계획된 대비의 수가 가능한 전체 대비 수에 비해 적을 때에는 본페로니가 더 강력하다.
연습문제 2. 본페로니와 셰페의 선택 지침을 정리하라.
풀이
두 절차의 근본적 차이.
| 본페로니 | 셰페 | |
|---|---|---|
| 보호 대상 | 지정한 \(M\)개 | 모든 대비(무한) |
| 임계값 | \(t_{1-\alpha/(2M),\nu}\) | \(\sqrt{(k-1)F_\alpha}\) |
| \(M\) 의존 | 있음 | 없음 |
| \(k\) 의존 | 없음 | 있음 |
| 자료를 보고 고른 대비 | 무효 | 유효 |
핵심 수치 다섯.
| 사실 | 값 |
|---|---|
| \(k=5\)에서 셰페가 유리해지는 \(M\) | 21 |
| \(k=10\)에서는 | 883 |
| 시닥의 본페로니 대비 이득 | 최대 2.56% |
| 자료 기반 최적 대비의 셰페 오류율 | 0.054(\(=F\) 검정) |
| 개별 95% 구간 여섯 개의 동시 포함확률 | 0.807 |
선택 흐름.
대비를 언제 정했는가?
    │
    ├─ 자료 수집 전 (계획된 대비)
    │     ├─ 검정만 필요 ──→ 홀름 (본페로니를 지배)
    │     └─ 구간도 필요 ──→ 본페로니
    │
    ├─ 자료를 본 뒤 (사후 대비)
    │     └─→ 셰페 (다른 절차는 무효)
    │
    └─ 모든 쌍별 비교
          ├─ 등분산 ──→ 투키 (가장 정확)
          └─ 이분산 ──→ 게임스–하월
\(M\)이 몇 개일 때 무엇을 쓰나(\(k=5\), \(\nu=45\) 기준).
| \(M\) | 본페로니 \(t\) | 셰페 \(S\) | 권장 |
|---|---|---|---|
| 1 | 2.014 | 3.212 | 보정 불필요 |
| 3 | 2.487 | 3.212 | 본페로니/홀름 |
| 10 | 2.952 | 3.212 | 본페로니 |
| 21 | 3.215 | 3.212 | 교차점 |
| 50 | 3.520 | 3.212 | 셰페 |
쌍별 비교 10개는 본페로니 영역이다. 그러나 쌍별이면 투키가 둘 다보다 낫다(2.809).
흔한 실수 다섯.
| 실수 | 대가 |
|---|---|
| 계획했다며 보정 생략 | \(M=3\)에서 FWER 0.143 |
| 자료를 보고 고른 대비에 본페로니 | 통제 무효 |
| 쌍별인데 셰페 | \(k=10\)에서 FWER 0.002 |
| 시닥으로 바꿔 "검정력 향상" | 2.6% |
| 구간 없이 \(p\)만 보고 | 크기를 알 수 없음 |
보고 형식.
[확증적] 사전에 정한 대비 3개, 홀름 보정 (FWER = 0.05)
  C1  추정 +2.50  95% 본페로니 구간 [ 0.28,  4.72]  p_adj = 0.023
  C2  추정 +1.90  95% 본페로니 구간 [-0.03,  3.83]  p_adj = 0.036
  C3  추정 +1.40  95% 본페로니 구간 [-0.82,  3.62]  p_adj = 0.125

[탐색적] 자료를 보고 발견한 대비, 셰페 기준
  C4  추정 +2.23  95% 셰페 구간 [ 0.38,  4.09]
  → 가설 생성용이며 확증에는 새 자료가 필요하다.
확증과 탐색을 나누는 것이 가장 중요한 실천이다.
한 문장. 본페로니는 "몇 개를 볼지 미리 정한 사람"을 위한 절차이고, 셰페는 "자료가 이끄는 대로 보겠다는 사람"을 위한 절차다.
연습문제 3. 연습문제 1(c)가 말한 "비교가 적으면 본페로니가 유리하다"의 경계를 찾아라. 몇 개부터 셰페가 유리해지는가?
풀이
두 임계값.
셰페의 임계값은 \(M\)에 무관하다. 본페로니는 \(M\)과 함께 커진다. 어딘가에서 교차한다.
import numpy as np
from scipy import stats

print("본페로니 임계값과 셰페 임계값 (α=0.05)")
Ms = [3, 5, 10, 20, 50, 100]
print(f"{'k':>3s} {'ν':>5s} {'셰페 배수':>9s} "
      + " ".join(f"{'M=' + str(m):>8s}" for m in Ms))
for k, nu in [(3, 27), (4, 36), (5, 45), (6, 54), (10, 90)]:
    sc = np.sqrt((k - 1) * stats.f.ppf(0.95, k - 1, nu))
    row = [stats.t.ppf(1 - 0.05 / (2 * m), nu) for m in Ms]
    print(f"{k:3d} {nu:5d} {sc:9.4f} " + " ".join(f"{r:8.4f}" for r in row))

print("\n각 k 에서 본페로니가 셰페를 넘어서는 최소 M")
for k, nu in [(3, 27), (4, 36), (5, 45), (6, 54), (10, 90), (20, 190)]:
    sc = np.sqrt((k - 1) * stats.f.ppf(0.95, k - 1, nu))
    M = 1
    while stats.t.ppf(1 - 0.05 / (2 * M), nu) < sc:
        M += 1
    print(f"  k={k:3d}: 셰페 배수 {sc:.4f}  →  M ≥ {M} 이면 셰페가 유리 "
          f"(쌍별 비교 수는 {k * (k - 1) // 2})")
본페로니 임계값과 셰페 임계값 (α=0.05)
  k     ν     셰페 배수      M=3      M=5     M=10     M=20     M=50    M=100
  3    27    2.5900   2.5525   2.7707   3.0565   3.3334   3.6896   3.9538
  4    36    2.9324   2.5110   2.7195   2.9905   3.2507   3.5821   3.8255
  5    45    3.2117   2.4868   2.6896   2.9521   3.2028   3.5203   3.7519
  6    54    3.4540   2.4708   2.6700   2.9270   3.1716   3.4800   3.7042
 10    90    4.2273   2.4395   2.6316   2.8779   3.1108   3.4019   3.6118

각 k 에서 본페로니가 셰페를 넘어서는 최소 M
  k=  3: 셰페 배수 2.5900  →  M ≥ 4 이면 셰페가 유리 (쌍별 비교 수는 3)
  k=  4: 셰페 배수 2.9324  →  M ≥ 9 이면 셰페가 유리 (쌍별 비교 수는 6)
  k=  5: 셰페 배수 3.2117  →  M ≥ 21 이면 셰페가 유리 (쌍별 비교 수는 10)
  k=  6: 셰페 배수 3.4540  →  M ≥ 47 이면 셰페가 유리 (쌍별 비교 수는 15)
  k= 10: 셰페 배수 4.2273  →  M ≥ 883 이면 셰페가 유리 (쌍별 비교 수는 45)
  k= 20: 셰페 배수 5.5848  →  M ≥ 624455 이면 셰페가 유리 (쌍별 비교 수는 190)
교차점이 \(k\)에 따라 폭발적으로 커진다.
| \(k\) | 셰페가 유리해지는 \(M\) | 쌍별 비교 수 | 판정 |
|---|---|---|---|
| 3 | 4 | 3 | 비슷 |
| 4 | 9 | 6 | 본페로니 우세 |
| 5 | 21 | 10 | 본페로니 우세 |
| 6 | 47 | 15 | 본페로니 우세 |
| 10 | 883 | 45 | 본페로니 압승 |
| 20 | 624,455 | 190 | 본페로니 압승 |
\(k\)가 커질수록 셰페가 극단적으로 불리해진다. \(k=10\)에서 셰페를 이기려면 883개의 비교를 해야 하는데, 쌍별 비교는 45개뿐이다.
왜 그런가. 셰페의 임계값은
로 \(\sqrt k\)에 비례해 자란다. 본페로니는 \(\sqrt{2\ln M}\)으로 로그의 제곱근이다. \(k\)가 커질 때 셰페가 훨씬 빠르게 커진다.
\(k=3\)에서만 \(M=3\)과 \(M=4\) 사이에 교차가 있다. 연습문제 1의 상황(\(k=5\), \(M=3\))에서는 본페로니가 확실히 유리하다(2.49 대 3.21).
결론 — 셰페를 쓰는 이유는 검정력이 아니다.
| 이유 | 설명 |
|---|---|
| 검정력 | 거의 언제나 본페로니가 낫다 |
| 자료를 보고 대비를 고름 | 셰페만 유효(연습문제 9) |
| 대비의 개수를 사전에 못 정함 | 셰페 |
| 무한히 많은 대비 | 셰페 |
셰페의 가치는 "무제한의 탐색을 허용한다"는 데 있다. 검정력을 그 대가로 치른다.
연습문제 4. 본페로니보다 약간 나은 시닥 보정이 있다. 두 보정의 차이를 계산하고, 왜 실무에서 거의 쓰이지 않는지 설명하라.
풀이
시닥 보정. \(M\)개의 검정이 독립이면
본페로니는 \(\alpha/M\)이고, 언제나 \(\alpha/M<1-(1-\alpha)^{1/M}\)이다.
print("시닥 대 본페로니 (α = 0.05)")
print(f"{'M':>5s} {'본페로니 α/M':>12s} {'시닥 1-(1-α)^(1/M)':>18s} {'차이':>8s}")
for M in [2, 3, 5, 10, 20, 50, 100]:
    b = 0.05 / M
    s = 1 - (1 - 0.05)**(1 / M)
    print(f"{M:5d} {b:12.6f} {s:18.6f} {100 * (s - b) / b:7.2f}%")
시닥 대 본페로니 (α = 0.05)
    M     본페로니 α/M   시닥 1-(1-α)^(1/M)       차이
    2     0.025000           0.025321    1.28%
    3     0.016667           0.016952    1.71%
    5     0.010000           0.010206    2.06%
   10     0.005000           0.005116    2.32%
   20     0.002500           0.002561    2.46%
   50     0.001000           0.001025    2.53%
  100     0.000500           0.000513    2.56%
차이가 최대 2.56%다. \(M\)이 커져도 2.6%를 넘지 않는다.
| \(M\) | 시닥의 이득 |
|---|---|
| 2 | 1.28% |
| 10 | 2.32% |
| \(\infty\) | \(\to\) 2.56% |
극한값의 유도.
\(\alpha=0.05\)에서 \(-\ln0.95/0.05=1.0257\)로, 2.57%다. 표의 2.56%와 일치한다.
유의수준이 2.6% 느슨해지면 임계값은 얼마나 줄어드나. \(t\) 분포의 꼬리가 가파르므로 1% 미만이다. 검정력 이득은 거의 측정할 수 없는 수준이다.
실무에서 쓰이지 않는 이유 넷.
| 이유 | 설명 |
|---|---|
| 이득이 미미 | 2.6%는 반올림 오차 수준 |
| 독립 가정 | 쌍별 비교는 독립이 아니다 |
| 설명의 복잡함 | "\(\alpha\)를 \(M\)으로 나눴다"가 더 쉽다 |
| 더 나은 대안 | 홀름이 훨씬 큰 이득을 준다 |
두 번째가 이론적으로 중요하다. 시닥은 독립을 가정하는데, 쌍별 비교는 같은 평균을 공유해 양의 상관이 있다. 상관이 있으면 시닥도 보수적이다(다만 여전히 유효하다).
네 번째가 결정적이다. 홀름의 검정력 이득이 14~29%(10.3절 사후비교 방법의 비교와 검정력 연습문제 6)인데 시닥은 1% 미만이다. 같은 노력으로 홀름을 쓰는 것이 낫다.
시닥이 유용한 곳. 검정이 실제로 독립일 때다.
| 상황 | 독립인가 |
|---|---|
| 쌍별 비교 | 아니다(평균 공유) |
| 직교 대비 | 거의 그렇다 |
| 서로 다른 자료의 검정 | 그렇다 |
| 유전체 연구의 SNP 검정 | 대체로 그렇다 |
직교 대비에는 시닥이 정확하다. 연습문제 10에서 다룬다.
연습문제 5. 셰페 신뢰구간을 만들고 본페로니 구간과 폭을 비교하라.
풀이
구간의 형태. 대비 \(\psi=\sum c_i\mu_i\)에 대해
셰페 구간은 모든 대비에 대해 동시에 성립한다.
import numpy as np
from scipy import stats

k, n, MSW = 5, 10, 4.0
nu = k * (n - 1)
means = np.array([12.0, 9.5, 11.2, 10.0, 8.6])
contrasts = {
    "C1: μ1-μ2": np.array([1, -1, 0, 0, 0], float),
    "C2: μ3-(μ4+μ5)/2": np.array([0, 0, 1, -0.5, -0.5]),
    "C3: μ4-μ5": np.array([0, 0, 0, 1, -1], float),
    "C4: (μ1+μ3)/2-(μ2+μ4+μ5)/3":
        np.array([0.5, -1 / 3, 0.5, -1 / 3, -1 / 3]),
}
S = np.sqrt((k - 1) * stats.f.ppf(0.95, k - 1, nu))
tb = stats.t.ppf(1 - 0.05 / (2 * 3), nu)      # 사전에 정한 3개 기준

print(f"셰페 배수 S = {S:.4f},  본페로니(M=3) t = {tb:.4f}")
print(f"{'대비':>30s} {'추정값':>8s} {'SE':>7s} "
      f"{'셰페 구간':>22s} {'본페로니 구간':>22s}")
for lab, c in contrasts.items():
    est = c @ means
    se = np.sqrt(MSW * (c**2 / n).sum())
    print(f"{lab:>30s} {est:8.3f} {se:7.4f} "
          f"[{est - S * se:8.3f},{est + S * se:8.3f}] "
          f"[{est - tb * se:8.3f},{est + tb * se:8.3f}]")
print(f"\n구간 폭의 비 (셰페/본페로니) = {S / tb:.4f}")
셰페 배수 S = 3.2117,  본페로니(M=3) t = 2.4868
                            대비      추정값      SE                  셰페 구간                본페로니 구간
                     C1: μ1-μ2    2.500  0.8944 [  -0.373,   5.373] [   0.276,   4.724]
              C2: μ3-(μ4+μ5)/2    1.900  0.7746 [  -0.588,   4.388] [  -0.026,   3.826]
                     C3: μ4-μ5    1.400  0.8944 [  -1.473,   4.273] [  -0.824,   3.624]
    C4: (μ1+μ3)/2-(μ2+μ4+μ5)/3    2.233  0.5774 [   0.379,   4.088] [   0.798,   3.669]

구간 폭의 비 (셰페/본페로니) = 1.2915
셰페 구간이 29% 넓다(\(S/t_B=1.29\)).
| 대비 | 셰페 폭 | 본페로니 폭 |
|---|---|---|
| \(C_1\) | 5.75 | 4.45 |
| \(C_2\) | 4.98 | 3.85 |
| \(C_3\) | 5.75 | 4.45 |
| \(C_4\) | 3.71 | 2.87 |
\(C_1\)의 결론이 갈린다. 셰페 구간 \([-0.37,\,5.37]\)은 0을 포함하고, 본페로니 구간 \([0.28,\,4.72]\)은 포함하지 않는다. 연습문제 8의 검정 결과와 일치한다.
\(C_4\)는 표에 없던 대비다. 자료를 보고 "1·3이 높고 2·4·5가 낮다"고 판단해 만들었다고 하자.
| 상황 | 쓸 수 있는 구간 |
|---|---|
| \(C_4\)를 사전에 정함 | 본페로니(\(M=4\)로 다시 계산) |
| \(C_4\)를 자료를 보고 고름 | 셰페만 |
셰페 구간 \([0.379,\,4.088]\)이 0을 포함하지 않는다. 자료를 보고 고른 대비인데도 유효한 주장이 가능하다. 이것이 셰페의 값어치다.
\(C_4\)의 SE가 가장 작다(0.577). \(\sum c_i^2=0.5^2\times2+(1/3)^2\times3=0.833\)으로 가장 작기 때문이다. 여러 집단을 묶을수록 정밀해진다.
셰페 구간의 폭은 \(M\)에 무관하다. 대비를 100개 만들어도 폭이 같다. 본페로니는 \(M\)과 함께 넓어진다.
| \(M\) | 본페로니 \(t\) | 셰페 \(S\) | 승자 |
|---|---|---|---|
| 3 | 2.487 | 3.212 | 본페로니 |
| 10 | 2.952 | 3.212 | 본페로니 |
| 21 | 3.215 | 3.212 | 셰페 |
| 100 | 3.752 | 3.212 | 셰페 |
연습문제 3의 교차점 21과 일치한다.
연습문제 6. 계획된 대비와 사후 대비의 차이를 정의하고, 각각에 맞는 절차를 정리하라.
풀이
정의.
| 계획된(a priori) 대비 | 사후(post hoc) 대비 | |
|---|---|---|
| 언제 정하는가 | 자료 수집 전 | 자료를 본 뒤 |
| 개수 | 고정된 \(M\)개 | 셀 수 없음 |
| 절차 | 본페로니, 홀름, 시닥 | 셰페 |
| 검정력 | 높다 | 낮다 |
| 정당성 | 이론·선행연구 | 탐색 |
"자료를 본 뒤"의 범위가 넓다. 다음은 모두 사후다.
- 집단 평균을 보고 대비를 고름
- 상자그림(box plot)을 보고 "이 둘이 달라 보인다"
- 예비 분석 결과를 보고 방향을 정함
- 다른 사람이 본 자료를 넘겨받아 분석
세 번째가 특히 미묘하다. "같은 자료의 일부만 보았다"도 자료를 본 것이다.
왜 계획된 대비가 강력한가.
| 상황 | 임계값(\(k=5\), \(\nu=45\)) |
|---|---|
| 계획된 3개(본페로니) | 2.487 |
| 계획된 3개(홀름 1단계) | 2.487 |
| 쌍별 전부(투키) | 2.809 |
| 사후(셰페) | 3.212 |
계획하면 임계값이 22% 낮다. 표본 크기로 환산하면
계획하지 않으면 표본을 66% 더 써야 같은 검정력을 얻는다.
계획된 대비의 조건 넷.
- 자료 수집 전에 문서로 기록한다(사전 등록이 이상적).
- 개수를 미리 정한다. 나중에 추가하면 무효.
- 방향도 미리 정한다(단측 검정을 쓸 경우).
- 연구 질문에서 나와야 한다. "일단 몇 개 정해 두자"는 정당화가 아니다.
혼합 전략이 일반적이다.
보고서 구조

[확증적 분석]  사전에 정한 대비 3개, 홀름 보정
   C1: 처리 A 대 대조   p_adj = 0.008  ✓
   C2: 처리 B 대 대조   p_adj = 0.041  ✓
   C3: 처리 A 대 B      p_adj = 0.310

[탐색적 분석]  자료를 보고 발견한 패턴, 셰페 기준
   (A+B)/2 대 (C+D)/2   셰페 구간 [0.29, 4.21], 0 을 포함하지 않음
   → 가설 생성용. 확증에는 새 자료가 필요하다.
두 부분을 명확히 나누는 것이 정직한 보고다. 탐색적 결과를 확증적인 것처럼 쓰지 않는다.
흔한 오해. "계획된 대비는 보정이 필요 없다"는 말이 있는데, 틀렸다. 계획했더라도 \(M\)개를 검정하면 FWER이 커진다. 계획의 이점은 \(M\)이 작고 고정되어 있다는 것뿐이다.
| \(M\) | 무보정 FWER |
|---|---|
| 1 | 0.050 |
| 3 | 0.143 |
| 5 | 0.226 |
\(M=1\)일 때만 보정이 필요 없다.
연습문제 7. 본페로니 보정을 신뢰구간에 적용하는 방법과 주의점을 정리하라.
풀이
동시 신뢰구간. \(M\)개의 대비에 대해
라 하면, \(M\)개가 모두 참값을 덮을 확률이 \(\geq1-\alpha\)다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(15002)
B = 20_000
k, n, M = 4, 12, 6
nu = k * (n - 1)
tb = stats.t.ppf(1 - 0.05 / (2 * M), nu)
t1 = stats.t.ppf(0.975, nu)
pairs = [(i, j) for i in range(k) for j in range(i + 1, k)]

cov_all = cov_each = 0
for _ in range(B):
    gs = [rng.normal(0, 1, n) for _ in range(k)]
    m = np.array([g.mean() for g in gs])
    MSE = np.array([g.var(ddof=1) for g in gs]).mean()
    se = np.sqrt(2 * MSE / n)
    ok_all = ok_each = True
    for i, j in pairs:
        d = m[i] - m[j]
        if abs(d) > tb * se:
            ok_all = False
        if abs(d) > t1 * se:
            ok_each = False
    cov_all += ok_all
    cov_each += ok_each

print(f"k={k}, n={n}, M={M} 쌍, 참 차이는 모두 0")
print(f"  본페로니 t = {tb:.4f},  개별 t = {t1:.4f}")
print(f"  본페로니 동시구간이 여섯 개를 모두 덮을 확률 = {cov_all / B:.4f}")
print(f"  개별 95% 구간이 여섯 개를 모두 덮을 확률   = {cov_each / B:.4f}")
print(f"  (참고: 여섯 검정이 독립이면 0.95^6 = {0.95**6:.4f})")
k=4, n=12, M=6 쌍, 참 차이는 모두 0
  본페로니 t = 2.7628,  개별 t = 2.0154
  본페로니 동시구간이 여섯 개를 모두 덮을 확률 = 0.9592
  개별 95% 구간이 여섯 개를 모두 덮을 확률   = 0.8070
  (참고: 여섯 검정이 독립이면 0.95^6 = 0.7351)
개별 95% 구간을 여섯 개 만들면 동시 포함확률(simultaneous coverage probability)이 0.81이다. 다섯 번에 한 번은 적어도 하나가 빗나간다.
| 방식 | 임계값 | 동시 포함확률 |
|---|---|---|
| 개별 95% | 2.015 | 0.807 |
| 본페로니 | 2.763 | 0.959 |
본페로니가 0.959로 목표 0.95를 넘는다. 보수적이라는 뜻이다. 투키라면 0.95에 정확히 맞는다.
구간이 37% 넓어진다(2.763/2.015). 이것이 동시성의 대가다.
개별 구간의 0.807이 \(0.95^6=0.735\)보다 높다. 여섯 검정이 독립이 아니라 양의 상관을 갖기 때문이다. 독립이면 0.735였을 것이다.
주의점 넷.
| 주의 | 내용 |
|---|---|
| \(M\)을 명시 | 몇 개의 구간을 만들었는지 보고 |
| 홀름은 구간을 못 준다 | 검정만 가능 |
| 사후에 구간을 추가하면 무효 | \(M\)이 달라진다 |
| 쌍별이면 투키가 낫다 | 본페로니보다 좁다 |
두 번째가 실무의 제약이다. 홀름은 검정력이 좋지만 대응하는 신뢰구간을 만들기 어렵다. 구간이 필요하면
| 상황 | 선택 |
|---|---|
| 쌍별 비교 | 투키(가장 좁음) |
| 지정한 대비 | 본페로니 |
| 자료 기반 대비 | 셰페 |
| 대조군 비교 | 더닛 |
구간과 검정을 함께 보고하는 것이 원칙이다. \(p\)만으로는 "얼마나 다른가"를 알 수 없고, 구간만으로는 다중성 보정이 어떻게 되었는지 모른다.
한 가지 더 — 구간의 해석. 동시 구간 여섯 개를 보고
"여섯 구간이 모두 참값을 덮을 확률이 95%다"
가 옳고,
"각 구간이 참값을 덮을 확률이 95%다"
는 틀리다(그것보다 높다).
연습문제 8. 연습문제 1의 세 대비에 대해 본페로니·시닥·홀름·셰페를 모두 적용하고 결과를 비교하라.
풀이
import numpy as np
from scipy import stats

k, n, MSW = 5, 10, 4.0
nu = k * (n - 1)
means = np.array([12.0, 9.5, 11.2, 10.0, 8.6])
contrasts = {
    "C1: μ1-μ2": np.array([1, -1, 0, 0, 0], float),
    "C2: μ3-(μ4+μ5)/2": np.array([0, 0, 1, -0.5, -0.5]),
    "C3: μ4-μ5": np.array([0, 0, 0, 1, -1], float),
}

print(f"MSW = {MSW}, ν = {nu}, 집단당 n = {n}")
print(f"{'대비':>20s} {'추정값':>8s} {'SE':>7s} {'t':>7s} {'원 p':>8s}")
rows = []
for lab, c in contrasts.items():
    est = c @ means
    se = np.sqrt(MSW * (c**2 / n).sum())
    t = est / se
    p = 2 * stats.t.sf(abs(t), nu)
    rows.append((lab, est, se, t, p))
    print(f"{lab:>20s} {est:8.4f} {se:7.4f} {t:7.4f} {p:8.5f}")

M = len(rows)
ps = np.array([r[4] for r in rows])
a_bon = 0.05 / M
a_sid = 1 - 0.95**(1 / M)
sc = np.sqrt((k - 1) * stats.f.ppf(0.95, k - 1, nu))

print(f"\n임계값·수준")
print(f"  본페로니: α' = {a_bon:.5f}, 임계 t = {stats.t.ppf(1 - a_bon / 2, nu):.4f}")
print(f"  시닥    : α' = {a_sid:.5f}, 임계 t = {stats.t.ppf(1 - a_sid / 2, nu):.4f}")
print(f"  셰페    : 임계 배수 = {sc:.4f}")

order = np.argsort(ps)
holm = np.zeros(M, bool)
for r, idx in enumerate(order):
    if ps[idx] < 0.05 / (M - r):
        holm[idx] = True
    else:
        break

print(f"\n{'대비':>20s} {'본페로니':>9s} {'시닥':>7s} {'홀름':>7s} {'셰페':>7s}")
for i, (lab, est, se, t, p) in enumerate(rows):
    print(f"{lab:>20s} {'기각' if p < a_bon else '  -':>9s} "
          f"{'기각' if p < a_sid else '  -':>7s} "
          f"{'기각' if holm[i] else '  -':>7s} "
          f"{'기각' if abs(t) > sc else '  -':>7s}")
MSW = 4.0, ν = 45, 집단당 n = 10
                  대비      추정값      SE       t      원 p
           C1: μ1-μ2   2.5000  0.8944  2.7951  0.00760
    C2: μ3-(μ4+μ5)/2   1.9000  0.7746  2.4529  0.01811
           C3: μ4-μ5   1.4000  0.8944  1.5652  0.12453

임계값·수준
  본페로니: α' = 0.01667, 임계 t = 2.4868
  시닥    : α' = 0.01695, 임계 t = 2.4799
  셰페    : 임계 배수 = 3.2117

                  대비      본페로니      시닥      홀름      셰페
           C1: μ1-μ2        기각      기각      기각       -
    C2: μ3-(μ4+μ5)/2         -       -      기각       -
           C3: μ4-μ5         -       -       -       -
네 절차의 결론이 갈린다.
| 대비 | 원 \(p\) | 본페로니 | 시닥 | 홀름 | 셰페 |
|---|---|---|---|---|---|
| \(C_1\) | 0.0076 | 기각 | 기각 | 기각 | — |
| \(C_2\) | 0.0181 | — | — | 기각 | — |
| \(C_3\) | 0.1246 | — | — | — | — |
홀름만 \(C_2\)를 기각한다. 절차를 보면
정렬:  p(1)=0.0076,  p(2)=0.0181,  p(3)=0.1246

홀름 1단계: 0.0076 < 0.05/3 = 0.0167  ✓ 기각
홀름 2단계: 0.0181 < 0.05/2 = 0.0250  ✓ 기각
홀름 3단계: 0.1246 < 0.05/1 = 0.0500  ✗ 중단
\(C_1\)을 기각했으므로 남은 가설이 둘이고, 임계값이 \(\alpha/3\)에서 \(\alpha/2\)로 완화된다. \(0.0181<0.0250\)이므로 통과한다.
시닥과 본페로니의 임계값 차이가 0.007이다(2.4868 대 2.4799). 결론에 영향을 주지 않는다. 연습문제 4의 "2.6%는 무시할 만하다"가 확인된다.
셰페는 아무것도 기각하지 않는다. 임계 배수 3.212가 가장 큰 \(|t|=2.795\)보다 크다. 연습문제 1(c)의 답과 일치한다.
\(C_2\)의 SE가 가장 작은 것도 눈여겨볼 만하다.
\(\sum c_i^2=1.5\)로 \(C_1\)·\(C_3\)의 2보다 작다. 두 집단을 평균 내면 그만큼 정밀해진다.
권장 — 세 대비를 사전에 정했다면 홀름. 본페로니보다 언제나 낫고 계산도 쉽다.
연습문제 9. 셰페를 반드시 써야 하는 상황을 모의실험으로 보여라. 자료를 보고 대비를 고르면 무슨 일이 생기는가?
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats
from statsmodels.stats.libqsturng import qsturng

rng = np.random.default_rng(12005)
B = 4_000
k, n = 5, 12
dfe = k * (n - 1)
tc = qsturng(0.95, k, dfe) / np.sqrt(2)
sc = np.sqrt((k - 1) * stats.f.ppf(0.95, k - 1, dfe))
bc = stats.t.ppf(1 - 0.05 / (2 * 10), dfe)

a = b = c = d = 0
for _ in range(B):
    gs = [rng.normal(0, 1, n) for _ in range(k)]
    m = np.array([g.mean() for g in gs])
    MSE = np.array([g.var(ddof=1) for g in gs]).mean()
    tmax = max(abs(m[i] - m[j]) / np.sqrt(2 * MSE / n)
               for i in range(k) for j in range(i + 1, k))
    a += tmax > tc
    b += tmax > bc
    c += tmax > sc
    d += np.sqrt(n * ((m - m.mean())**2).sum() / MSE) > sc

print("k=5, n=12, 완전 귀무. '가장 큰 차이를 내는 것'을 자료에서 찾아 검정")
print(f"{'쌍별 최대 — 투키 기준':>28s} {a / B:8.4f}")
print(f"{'쌍별 최대 — 본페로니(10쌍)':>28s} {b / B:8.4f}")
print(f"{'쌍별 최대 — 셰페 기준':>28s} {c / B:8.4f}")
print(f"{'최적 대비 — 셰페 기준':>28s} {d / B:8.4f}")
print(f"\n임계값: 투키 {tc:.4f}, 본페로니 {bc:.4f}, 셰페 {sc:.4f}")

rng = np.random.default_rng(12005)
e = sum(stats.f_oneway(*[rng.normal(0, 1, n) for _ in range(k)]).pvalue < 0.05
        for _ in range(B))
print(f"F 검정의 기각률(참고): {e / B:.4f}")
k=5, n=12, 완전 귀무. '가장 큰 차이를 내는 것'을 자료에서 찾아 검정
               쌍별 최대 — 투키 기준   0.0590
           쌍별 최대 — 본페로니(10쌍)   0.0435
               쌍별 최대 — 셰페 기준   0.0195
               최적 대비 — 셰페 기준   0.0542

임계값: 투키 2.8204, 본페로니 2.9247, 셰페 3.1873
F 검정의 기각률(참고): 0.0542
마지막 두 줄이 셰페 정리다.
정확히 같다. 이것은 셰페 정리의 직접적 결과다.
\(F\) 검정이 유의하다 \(\iff\) 셰페 기준으로 유의한 대비가 적어도 하나 존재한다
"최적 대비"가 무엇인가. \(c_i\propto\bar y_i-\bar y_{\cdot\cdot}\)로 잡으면
자료가 알려 주는 가장 극단적인 대비이며, 그 \(t^2\)이 정확히 \((k-1)F\)다.
셰페 기준이 \(\sqrt{(k-1)F_\alpha}\)인 이유가 여기 있다. 최적 대비조차 딱 \(\alpha\)의 확률로 기각되도록 맞춘 것이다.
자료를 보고 고른 대비에 다른 절차를 쓰면.
| 절차 | 쌍별에 쓸 때 | 자료 기반 대비에 쓸 때 |
|---|---|---|
| 투키 | 0.059(정확) | 무효(대비가 쌍별이 아님) |
| 본페로니 | 0.044 | 무효(\(M\)을 모름) |
| 셰페 | 0.020(보수적) | 0.054(정확) |
본페로니가 "무효"인 이유가 중요하다. 자료를 본 뒤에는 몇 개의 대비를 "고려했는지" 셀 수 없다. 눈으로 훑은 모든 가능성이 암묵적 비교다.
실무에서 자주 일어나는 일.
1. 다섯 집단의 평균을 본다
2. "A, B 가 높고 C, D, E 가 낮아 보인다"
3. 대비 (A+B)/2 - (C+D+E)/3 를 검정한다
4. p = 0.02 → "유의하다"고 보고

→ 3단계의 대비를 2단계에서 자료를 보고 골랐다
→ 본페로니(M=1)나 t 검정은 무효
→ 셰페 기준으로 다시 검정해야 한다
이것이 셰페가 존재하는 이유다. 탐색적 분석을 정직하게 하려면 셰페가 필요하다.
대안 — 사전 등록. 대비를 자료 수집 전에 정하면 본페로니/홀름을 쓸 수 있고 검정력이 훨씬 높다. 탐색은 셰페로, 확증은 사전 등록으로.
연습문제 10. 직교 대비의 성질을 확인하라. 직교이면 보정이 달라지는가?
풀이
직교의 정의. 균형 설계에서 두 대비 \(\mathbf c\), \(\mathbf d\)가
이면 직교라 한다. 이때 \(\operatorname{Cov}(\hat\psi_c,\hat\psi_d)=0\)이다.
import numpy as np
from scipy import stats

k, n, MSW = 4, 10, 4.0
nu = k * (n - 1)
C = {
    "A: μ1-μ2": np.array([1, -1, 0, 0], float),
    "B: μ3-μ4": np.array([0, 0, 1, -1], float),
    "C: (μ1+μ2)-(μ3+μ4)": np.array([1, 1, -1, -1], float),
}
names = list(C)
print("대비 사이의 내적 (0 이면 직교)")
for i in range(3):
    for j in range(i + 1, 3):
        print(f"  {names[i]:>22s} · {names[j]:<22s} = "
              f"{C[names[i]] @ C[names[j]]:.1f}")

print("\n직교 대비의 제곱합이 SSB 를 분할하는가")
rng = np.random.default_rng(15001)
gs = [rng.normal(m, 2.0, n) for m in [10, 12, 9, 11]]
mm = np.array([g.mean() for g in gs])
SSB = n * ((mm - mm.mean())**2).sum()
tot = 0
for lab, c in C.items():
    ss = (c @ mm)**2 / ((c**2).sum() / n)
    tot += ss
    print(f"  {lab:>22s}: SS = {ss:9.4f}")
print(f"  {'합':>22s}: {tot:9.4f}   SSB = {SSB:9.4f}")

print("\n비직교 대비를 섞으면")
D = {"A: μ1-μ2": np.array([1, -1, 0, 0], float),
     "D: μ1-μ3": np.array([1, 0, -1, 0], float),
     "E: μ1-μ4": np.array([1, 0, 0, -1], float)}
tot = 0
for lab, c in D.items():
    ss = (c @ mm)**2 / ((c**2).sum() / n)
    tot += ss
    print(f"  {lab:>22s}: SS = {ss:9.4f}")
print(f"  {'합':>22s}: {tot:9.4f}   SSB = {SSB:9.4f}  (분할되지 않는다)")
대비 사이의 내적 (0 이면 직교)
                A: μ1-μ2 · B: μ3-μ4               = 0.0
                A: μ1-μ2 · C: (μ1+μ2)-(μ3+μ4)     = 0.0
                B: μ3-μ4 · C: (μ1+μ2)-(μ3+μ4)     = 0.0

직교 대비의 제곱합이 SSB 를 분할하는가
                A: μ1-μ2: SS =    6.9669
                B: μ3-μ4: SS =   29.6221
      C: (μ1+μ2)-(μ3+μ4): SS =    6.1408
                       합:   42.7299   SSB =   42.7299

비직교 대비를 섞으면
                A: μ1-μ2: SS =    6.9669
                D: μ1-μ3: SS =    9.9466
                E: μ1-μ4: SS =    5.2386
                       합:   22.1521   SSB =   42.7299  (분할되지 않는다)
직교 대비 셋의 제곱합(sum of squares)이 정확히 SSB와 같다(42.7299). 소수점 넷째 자리까지 일치한다.
\(k-1=3\)개의 직교 대비가 SSB를 완전히 분해한다. 이것이 직교 대비의 핵심 성질이다.
비직교 대비는 분해하지 않는다(22.15 ≠ 42.73). 정보가 중복되기 때문이다.
그럼 직교이면 보정이 달라지는가.
| 질문 | 답 |
|---|---|
| 보정이 필요 없는가 | 아니다. \(M\)개를 검정하면 여전히 FWER이 커진다 |
| 시닥이 정확한가 | 거의 그렇다. 통계량이 독립이므로 |
| 본페로니가 여전히 보수적인가 | 약간만(2.6% 이내) |
직교이면 \(\hat\psi\)들이 서로 독립이므로 시닥의 독립 가정이 만족된다. 그러나 이득이 2.6%뿐이므로(연습문제 4) 실무적 차이는 없다.
직교 대비의 진짜 가치는 해석이다.
| 장점 | 설명 |
|---|---|
| 정보가 중복되지 않음 | 각 대비가 독립적인 질문에 답한다 |
| SSB의 분해 | "전체 차이 중 이 대비가 \(X\%\)" |
| 독립 | 하나의 결과가 다른 것을 예측하지 않음 |
위 예에서 SSB 42.73 중
| 대비 | SS | 비율 |
|---|---|---|
| A: \(\mu_1-\mu_2\) | 6.97 | 16% |
| B: \(\mu_3-\mu_4\) | 29.62 | 69% |
| C: 앞 둘 대 뒤 둘 | 6.14 | 14% |
"집단 차이의 69%가 3·4 집단 사이의 차이"라는 깔끔한 분해가 가능하다. 비율이 곧 그 질문이 설명하는 몫이다.
직교 대비를 만드는 법. 요인 구조가 있으면 자연스럽다.
| 설계 | 직교 대비 |
|---|---|
| \(2\times2\) 요인 | 주효과 A, 주효과 B, 교호작용 |
| 용량 \(0,1,2,3\) | 선형, 이차, 삼차 추세 |
| 대조군 + 처리 3개 | 대조 대 처리 전체, 처리 안의 대비 둘 |
정리하며¶
본페로니와 셰페는 FWER 을 통제하되 겨냥하는 상황이 다르다.
| 무엇을 보호하는가 | 언제 유리한가 | |
|---|---|---|
| 본페로니 | 계획된 \(m\) 개 비교 | \(m\) 이 작을 때 |
| 셰페 | 가능한 모든 선형 대비 | 자료를 보고 착안한 비교 |
- 본페로니는 예산을 \(m\) 등분한다. 부울–본페로니 부등식이 근거라 검정통계량의 상관 구조와 무관하게 성립한다. 단순하고 언제나 타당하다. 이 논리 자체는 9.6절의 것이며, 여기서 새로 더한 것은 개별 검정이 합동 \(\text{MS}_W\) 와 자유도 \(N-k\) 를 쓴다는 점뿐이다.
- \(m\) 이 커지면 지나치게 보수적이 된다. 모든 쌍을 비교할 생각이라면 투키가 낫다.
- 9.6절과 10.3절의 차이는 가족의 구조다. 9.6절의 가족은 종속 구조가 알려지지 않은 무관한 가설들이라 합집합 한계 말고 쓸 것이 없다. 사후비교의 가족은 하나의 \(\text{MS}_W\) 와 하나의 오차 자유도를 공유하므로 상관이 알려져 있고, 그 정보를 쓰는 투키·더닛·셰페가 정확해진다. 본페로니는 그 정보를 버리는 대가로 어떤 대비 집합에나 쓸 수 있다.
- 셰페는 무한히 많은 대비를 동시에 보호한다. 그래서 가장 보수적이지만, 자료를 본 뒤 떠오른 비교를 검정할 수 있는 유일한 방법이다.
- 이 차이가 실무의 핵심이다. 비교를 사전에 정했는가가 방법을 정한다. 사후에 고른 비교를 본페로니로 처리하면 실제로는 \(m\) 을 과소계산한 셈이다.
- 셰페는 전체 \(F\) 와 정합적이다. \(F\) 가 유의하지 않으면 셰페로 유의해지는 대비가 존재하지 않는다.
다음 절 더닛 검정으로 넘어간다. 모든 쌍이 아니라 대조군과의 비교만 필요한 경우다.