최대가능도의 점근적 성질
개요
최대가능도추정량은 유한표본에서 치우쳐 있다. 그런데도 대표본에서 그것이 문제가 되지 않는 까닭이 있다 — 편향은 \(1/n\) 으로 사라지는데 표준오차는 \(1/\sqrt n\) 으로만 줄어서, 표본이 커질수록 편향이 표준오차 안에 묻힌다. 두 속도가 다르다는 사실 하나가 「대표본이면 MLE 를 쓰면 된다」는 실무의 관행을 떠받친다. 그 관행이 서는 조건은 무엇이고, 조건이 깨지면 무엇이 먼저 무너지는가.
유한표본에서 MLE의 거동은 구체적인 모형과 자료에 달려 있다. 그러나 일반적인 정칙 조건 아래에서 MLE는 표본크기 \(n\)이 커질 때 강력한 성질 셋을 갖는다. 참 모수값으로 수렴하고(일치성), 근사적으로 정규분포를 따르게 되며(점근정규성), 가능한 최선의 정밀도를 달성한다(점근 효율성). 이 성질들이 MLE를 기본 추정 전략으로 삼는 것을 정당화하고, 가능도에 기반한 신뢰구간, 가설검정, 모형 비교 도구의 이론적 근거가 된다.
이 쪽에서 \(\theta_0\)은 참 모수값, 즉 실제로 자료를 만들어 낸 값을 나타낸다. \(X_1, \ldots, X_n \overset{\text{iid}}{\sim} f(x; \theta_0)\)을 가정한다.
1. 정칙 조건
아래의 점근적 결과들은 일련의 정칙 조건에 의존한다. 이 조건들은 표준 이론이 적용될 만큼 가능도함수가 잘 행동하도록 보장한다.
-
식별 가능성. 서로 다른 모수값이 서로 다른 분포를 만든다. \(\theta_1 \neq \theta_2\)이면 적어도 하나의 \(x\)에서 \(f(x; \theta_1) \neq f(x; \theta_2)\)이다.
-
공통 지지집합. 집합 \(\{x : f(x; \theta) > 0\}\)이 \(\theta\)에 의존하지 않는다. 모수에 따라 지지집합이 바뀌는 \(\text{Uniform}(0, \theta)\) 같은 분포는 제외된다.
-
내부의 모수. 참값 \(\theta_0\)이 경계가 아니라 모수공간 \(\Theta\)의 내부에 있다.
-
매끄러움. 로그밀도 \(\log f(x; \theta)\)가 \(\theta\)에 대해 적어도 세 번 연속미분가능하고, 도함수를 적분(또는 합) 기호 안으로 넘길 수 있다.
-
양의 피셔 정보량. 피셔 정보량이 \(I(\theta_0) > 0\)이어서 자료가 실제로 \(\theta\)에 관한 정보를 담고 있다.
정칙 조건이 깨질 때
정칙 조건이 위배되면 표준 점근 결과가 완전히 무너질 수 있다. 예를 들어 \(\text{Uniform}(0, \theta)\)에서 \(\theta\)의 MLE는 \(X_{(n)}\)(표본 최댓값)인데, 통상적인 \(1/\sqrt{n}\)이 아니라 \(1/n\)의 속도로 수렴하고 극한분포가 정규가 아니라 지수분포(exponential distribution)이다.
2. 일치성
좋은 추정량이라면 자료를 더 모을수록 참값으로 수렴해야 한다. 일치성의 정의와 평균제곱오차(mean squared error)가 \(0\) 으로 가면 일치한다는 충분조건은 \(7.1\) 절 일치성과 점근정규성에 있다(정의 \(1\)·정리 \(1\)). 여기서 보일 것은 그 성질이 최대가능도추정량에서 성립한다는 것이다.
정리 1. 최대가능도추정량의 일치성
정칙 조건 아래에서
이다. 곧 임의의 \(\epsilon > 0\) 에 대해 \(P\bigl(|\hat\theta_{\text{MLE}} - \theta_0| > \epsilon\bigr) \to 0\) 이다.
증명 개요
왜 참값이 이기는가를 큰수의 법칙과 쿨백–라이블러 발산(Kullback–Leibler divergence) — 두 분포가 얼마나 다른지를 재는 양 \(\operatorname{KL}(f\,\|\,g) = E_f[\log(f(X)/g(X))]\) — 으로 볼 수 있다. 완전한 증명은 가능도의 균등수렴을 다루어야 하므로 여기서는 뼈대만 적는다.
표본당 로그가능도비를 본다.
오른쪽은 i.i.d. 항의 평균이므로 큰수의 법칙(3.5절 큰수의 법칙 정리 2)에 의해 그 기댓값으로 수렴한다. 그 기댓값은 \(\theta_0\) 아래에서 잰 것이므로
다. 쿨백–라이블러 발산은 음이 아니고, 0 이 되는 것은 두 분포가 같을 때뿐이다(옌센 부등식에서 나온다). 식별 가능성 조건이 "두 분포가 같으면 \(\theta = \theta_0\)"을 보장하므로, 극한 함수가 \(\theta = \theta_0\) 에서만 최댓값 0 을 갖고 다른 곳에서는 엄격히 음수다.
그러므로 큰 \(n\) 에서 \(\theta \ne \theta_0\) 이면 \(\ell(\theta) < \ell(\theta_0)\) 이고, \(\ell\) 을 최대화하는 점이 \(\theta_0\) 근방에 갇힌다. \(\square\)
참값이 평균적으로 가장 높은 가능도를 준다는 것이 일치성의 알맹이다. 자료는 \(\theta_0\) 에서 나왔으므로 \(\theta_0\) 의 밀도가 그 자료에 평균적으로 가장 잘 맞고, 표본이 커지면 그 평균적 우위가 변동을 압도한다.
식별 가능성이 없으면 무너진다. 두 모수값이 같은 분포를 주면 가능도가 둘을 구별하지 못하고 MLE 가 그 사이에서 오간다.
일치성은 필요하지만 충분하지는 않다
일치성만으로는 추정량이 얼마나 빨리 수렴하는지, 그 분포가 어떤 모양인지 알 수 없다. 일치하는 두 추정량이 유한표본에서 매우 다르게 거동할 수 있다. 다음의 두 성질이 속도와 분포 모양을 다룬다.
3. 점근정규성
MLE의 점근적 성질 중 실무적으로 가장 중요한 것은 \(n\)이 클 때 표집분포(sampling distribution)가 근사적으로 정규가 된다는 점이다.
정리 2. 최대가능도추정량의 점근정규성
정칙 조건 아래에서
이고, 동등하게 \(n\) 이 크면 \(\hat\theta_{\text{MLE}} \;\dot\sim\; N\bigl(\theta_0,\, 1/(nI(\theta_0))\bigr)\) 다. 점근분산이 피셔 정보량의 역수이므로 MLE 는 크라메르–라오 하한을 점근적으로 달성한다.
증명 개요
점수함수를 참값 둘레에서 테일러 전개하는 것이 길이다. MLE 는 점수의 합을 0 으로 만드는 점이므로
다(부록 A 테일러 정리). 나머지를 버리고 풀어 \(\sqrt n\) 을 곱하면
가 된다. 분자와 분모를 따로 본다.
분자. \(\ell'(\theta_0) = \sum_i s(X_i;\theta_0)\) 은 i.i.d. 점수의 합이다. 점수의 평균이 0 이고(피셔 정보량 정리 1) 분산이 \(I(\theta_0)\) 이므로(같은 쪽 정의 2), 중심극한정리(central limit theorem)에서
다. 점수의 평균이 0 이라는 정리가 여기서 쓰인다 — 그래서 따로 중심화할 것이 없다.
분모. \(-\frac1n\ell''(\theta_0)\) 은 i.i.d. 항의 평균이므로 큰수의 법칙에서 기댓값으로 수렴하고, 그 기댓값이 바로 \(I(\theta_0)\) 다(같은 쪽 정리 2).
분모가 상수로 굳고 분자가 정규로 가므로 슬러츠키 정리에 의해
다. \(\square\)
정보량이 두 번, 서로 다른 모습으로 들어온다. 분자에서는 점수의 분산으로, 분모에서는 로그가능도의 곡률로 들어오는데, 바틀렛 항등식(7.2절 피셔 정보량과 표준오차 정리 2)이 그 둘을 같다고 말해 주기 때문에 하나가 약분되고 \(1/I\) 가 남는다. 그 항등식이 없으면 이 깔끔한 결과가 나오지 않는다.
"점근적으로"라는 단서가 실제로 무엇을 뜻하는지는 유한한 \(n\)에서 확인해 보아야 안다.
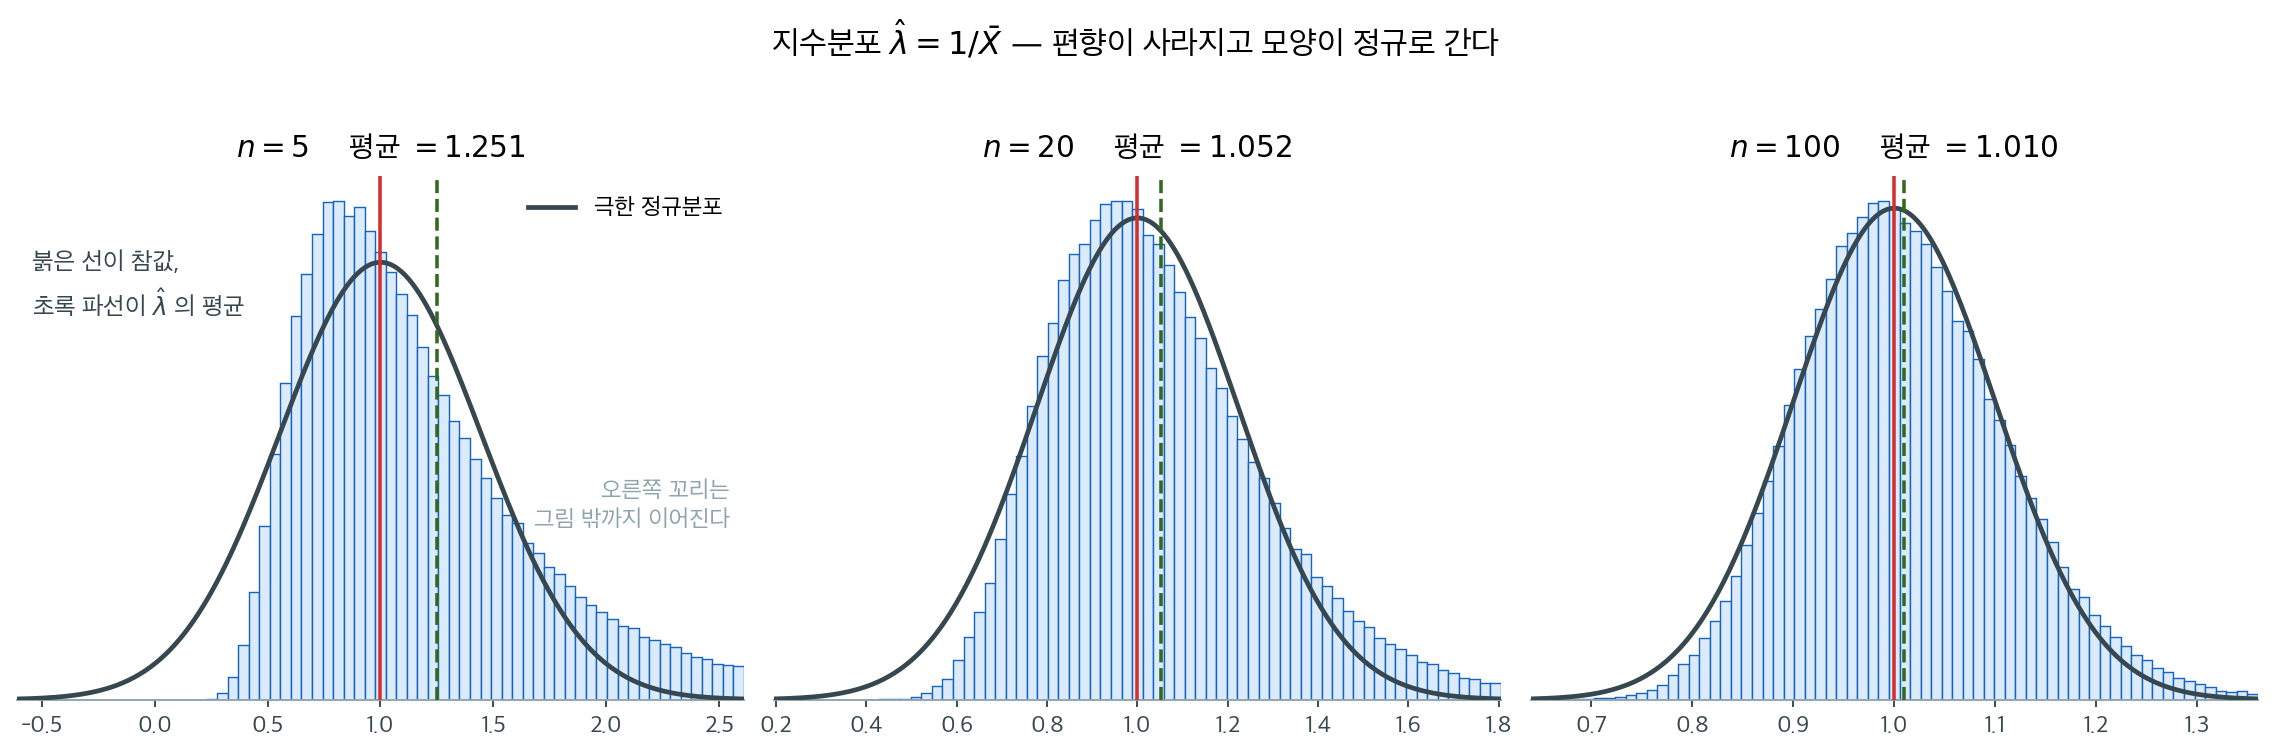
지수분포의 MLE \(\hat\lambda = 1/\bar X\)를 참값 \(\lambda = 1\)에서 20만 번 반복해 얻은 분포다. 세 칸을 왼쪽에서 오른쪽으로 읽으면 정리가 약속한 것이 하나씩 나타난다.
\(n = 5\)에서는 약속이 거의 지켜지지 않는다. 분포가 오른쪽으로 길게 늘어져 있고 평균이 \(1.25\)로 참값에서 25%나 위에 있다. \(1/\bar X\)가 \(\bar X\)의 볼록함수이므로 옌센 부등식이 위쪽 편향을 만든다(정확히 \(n/(n-1)\)배다). 검은 곡선이 극한의 정규분포인데, 실제 분포와 모양이 전혀 다르다.
\(n = 20\)에서 편향이 5%로 줄고 모양이 종에 가까워진다. \(n = 100\)에서는 편향이 1%이고 오른쪽 꼬리도 거의 사라져 두 곡선이 포개진다.
편향이 \(1/n\)의 속도로 사라지는 반면 표준오차는 \(1/\sqrt{n}\)의 속도로 줄어든다는 점이 핵심이다. 편향이 더 빨리 사라지므로 표본이 커질수록 편향은 표준오차에 묻혀 무시할 수 있게 된다. MLE가 유한표본에서 편향되어 있음에도 대표본에서 문제가 되지 않는 이유가 이것이다.
이 결과는 곧바로 실용적인 귀결을 낳는다. \(\theta_0\)에 대한 근사적인 \((1 - \alpha)\) 신뢰구간은
여기서 \(z_{1-\alpha/2}\)는 표준정규분포의 \((1 - \alpha/2)\) 분위수(quantile)이다. \(\theta_0\)을 모르므로 실무에서는 피셔 정보량을 \(\hat{\theta}_{\text{MLE}}\)에서 평가한다.
베르누이 모수의 점근 신뢰구간
\(X_1, \ldots, X_n \overset{\text{iid}}{\sim} \text{Bernoulli}(p)\)에서 MLE는 \(\hat{p} = \bar{X}\)이고 피셔 정보량은 \(I(p) = 1/(p(1-p))\)이다. 근사적인 95% 신뢰구간은
\(n = 100\)이고 \(\hat{p} = 0.3\)이면 \(0.3 \pm 1.96\sqrt{0.21/100} = 0.3 \pm 0.090\), 즉 근사적으로 \((0.210, 0.390)\)이다.
4. 점근 효율성
점근정규성은 MLE가 점근분산 \(1/(nI(\theta_0))\)으로 \(1/\sqrt{n}\)의 속도로 수렴한다고 알려 준다. 그런데 이 분산이 우리가 달성할 수 있는 최선인가? 답은 그렇다이다.
정칙추정량(regular estimator) 중에서 MLE는 점근적으로 크라메르–라오 하한을 달성한다. 정칙추정량이란 참값을 \(1/\sqrt n\) 크기만큼 살짝 옮겨도 극한분포가 달라지지 않는 추정량을 말한다 — 특정한 모수값 하나에서만 유난히 잘하도록 꾸민 추정량을 걸러 내는 조건이며, 아래 상자가 그 조건이 왜 필요한지 보인다.
이는 다른 어떤 정칙 일치추정량(consistent estimator)도 이보다 작은 점근분산을 가질 수 없음을 뜻한다. 일치하고 점근적으로 정규인 다른 추정량 \(\tilde{\theta}\)는 반드시 다음을 만족한다.
등호는 \(\tilde{\theta}\)가 MLE와 점근적으로 동등할 때에만 성립한다.
초효율성
모수공간의 고립된 점에서 MLE보다 분산이 작은 추정량을 구성할 수 있다(호지스 추정량이 고전적인 예이다). 이를 초효율성(superefficiency)이라 한다. 그러나 그런 추정량은 다른 점에서 반드시 분산이 더 커진다. MLE는 정칙추정량 부류 안에서 모수공간 전체에 걸쳐 일률적으로 효율적이다.
그림으로 보는 통계학 1. 발표하지 않은 반례 하나가 「정칙」이라는 낱말을 불러왔다
바로 위 쪽지에 「정칙추정량 부류 안에서」라는 단서가 붙어 있다. 그 단서는 처음부터 있던 것이 아니다. 누군가 그것 없이는 정리가 틀린다는 것을 보여 준 뒤에 붙었다.
피셔는 MLE 가 점근분산을 최소로 한다고 보았다. \(1951\) 년, 버클리의 조지프 호지스가 수업에서 반례 하나를 내놓는다. 쓰기는 터무니없이 쉽다. \(X_1, \ldots, X_n \sim \mathcal{N}(\theta, 1)\) 에서 \(a_n = n^{-1/4}\) 로 두고
곧 \(\bar X\) 가 \(0\) 에 가까우면 아예 \(0\) 이라고 말해 버리는 추정량이다. 참값이 \(\theta \neq 0\) 이면 \(\bar X\) 가 임계값을 넘을 확률이 \(1\) 로 가므로 \(\hat\theta_H\) 는 \(\bar X\) 와 똑같아진다. 그런데 \(\theta = 0\) 이면 임계값 안에 들어올 확률이 \(1\) 로 가므로 \(\hat\theta_H = 0\) 이 되고, 점근분산이 \(1/(nI)\) 가 아니라 \(0\) 이다. 한 점에서 이기고 나머지 모든 점에서 비긴다. 위 쪽지의 정리를 그대로 뒤집는다.
호지스는 이것을 논문으로 내지 않았다. 수업에서 말했을 뿐이고, 활자가 된 것은 \(1953\) 년 뤼시앵 르캄의 박사학위 논문에서 나온 글을 통해서다. 그리고 같은 글에서 르캄이 반례의 값을 매긴다 — 초효율이 일어날 수 있는 \(\theta\) 들은 르베그 측도가 \(0\) 인 집합에 갇힌다. 르베그 측도는 수직선 위에서 「길이」를 일반화한 것이니, 그런 \(\theta\) 를 다 모아도 길이가 \(0\) 이라는 뜻이다.
측도가 \(0\) 이라는 말이 추상적으로 들린다면, 위험함수를 그려 보면 된다.
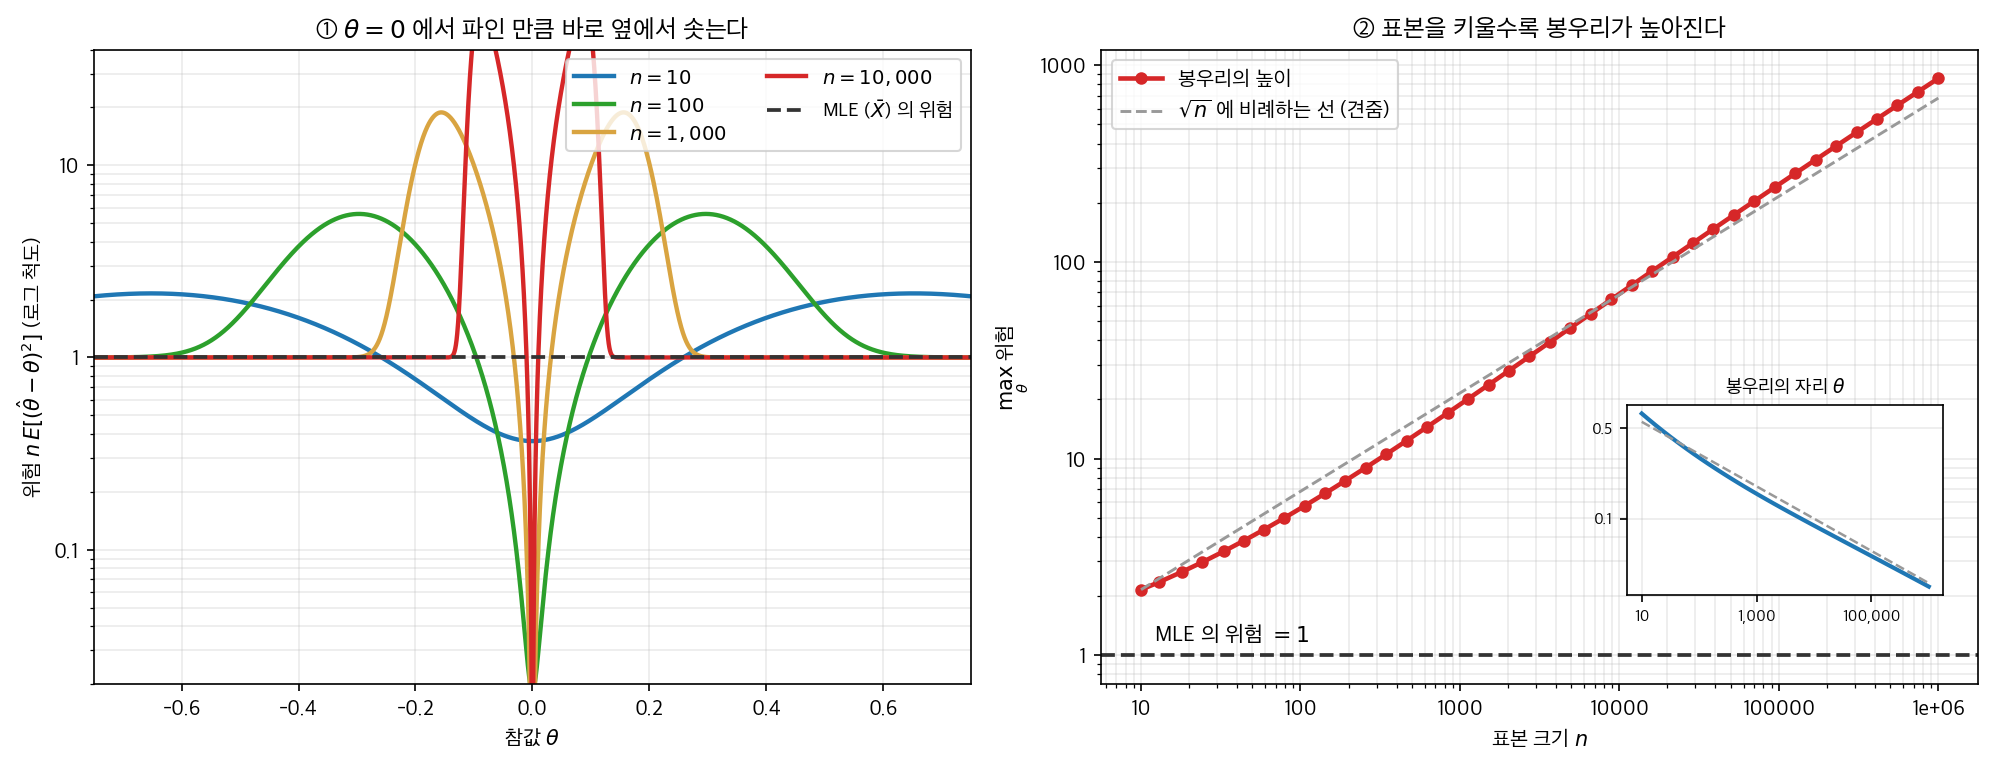
위험은 \(n\,E[(\hat\theta-\theta)^2]\) 이고, MLE 는 모든 \(\theta\) 에서 \(1\) 이다. 닫힌 꼴로 계산한 값이며 모의실험 \(40\) 만 회와 소수 넷째 자리까지 맞는다.
왼쪽 칸이 거래의 전모다. \(\theta = 0\) 에서 바닥까지 파이는 만큼, 바로 옆에서 솟는다. \(n\) 이 커지면 파인 골은 좁아지지만 봉우리는 좁아지면서 높아진다. \(n = 10\) 에서 최대 위험이 \(2.15\) 이던 것이 \(n = 10{,}000\) 에서 \(68.9\), \(n = 10^6\) 에서 \(858\) 이다. 오른쪽 칸이 그 속도로, 대략 \(\sqrt n\) 에 비례한다. 봉우리의 자리는 임계값 \(a_n = n^{-1/4}\) 를 따라 \(0\) 으로 다가간다.
그래서 한 점 \(\theta\) 를 못박고 \(n \to \infty\) 를 보는 눈에는 아무것도 보이지 않는다. \(\theta = 0.1\) 한 자리에서 \(n\) 을 키워 보자.
| \(n\) | \(10\) | \(100\) | \(1{,}000\) | \(10{,}000\) | \(100{,}000\) |
|---|---|---|---|---|---|
| 위험 | \(0.47\) | \(1.08\) | \(9.99\) | \(\mathbf{50.5}\) | \(1.00\) |
\(n = 10\) 에서는 \(0.47\) 로 MLE 보다 낫다 — 임계값 \(a_{10} = 0.562\) 가 \(\theta = 0.1\) 보다 훨씬 커서 거의 언제나 \(0\) 이라고 답하는데, 참값이 \(0\) 에 가까우니 그 답이 맞는 편이다. 그러다 임계값이 줄어들어 \(a_n\) 이 \(\theta\) 를 지나가는 \(n = 10{,}000\) (\(a_n = 0.1\)) 에서 \(50.5\) 까지 솟고, 더 키우면 임계값이 \(\theta\) 아래로 내려가 \(\hat\theta_H = \bar X\) 가 되어 \(1\) 로 돌아온다. 봉우리가 그 자리를 지나간 것이다. 「\(n\) 을 충분히 키우면 \(1\) 로 간다」는 말은 참이지만, 그 「충분히」가 얼마인지는 \(\theta\) 가 정한다. 어떤 \(n\) 에서든 아직 봉우리가 지나가지 않은 \(\theta\) 가 있다.
이것이 위 쪽지의 「정칙」이 하는 일이다. 추정량 쪽에 조건을 걸어 이런 것을 걸러 내지 않으면, 「MLE 가 점근적으로 최적」이라는 문장은 참이 아니다. 7.1절 효율성과 Cramér-Rao 하한의 상자가 모형 쪽 정칙조건을 두고 같은 말을 한다 — 조건을 어기면 결과가 조금 나빠지는 것이 아니라 결론이 통째로 뒤집힌다. 한쪽은 모형에, 한쪽은 추정량에 붙은 같은 잔글씨다.
확인한 곳 — 호지스가 \(1951\) 년에 이 추정량을 내놓았으나 스스로 발표하지 않았고 \(1953\) 년 르캄의 박사학위 논문에서 나온 글로 처음 활자가 된 것, 그것이 MLE 가 점근분산을 최소로 한다는 피셔의 추측에 대한 반례였다는 것, 르캄이 같은 글에서 초효율이 일어나는 모수의 집합이 르베그 측도 \(0\) 임을 보인 것. 그림과 표의 수는 모두 직접 계산한 값이다
5. 세 가지 성질 요약
| 성질 | 서술 | 실무적 함의 |
|---|---|---|
| 일치성 | \(\hat{\theta}_{\text{MLE}} \xrightarrow{P} \theta_0\) | 추정값이 참값으로 수렴한다 |
| 점근정규성 | \(\sqrt{n}(\hat{\theta}_{\text{MLE}} - \theta_0) \xrightarrow{d} N(0, 1/I(\theta_0))\) | 정규근사로 신뢰구간과 검정을 얻는다 |
| 점근 효율성 | \(\text{Var}_{\text{asy}} = 1/(nI(\theta_0))\) | 어떤 정칙추정량도 더 나을 수 없다 |
이 세 결과를 종합하면, 정칙 조건이 성립하고 점근근사가 믿을 만할 만큼 표본이 크다면 MLE가 모수적 추정의 기본 선택이 된다.
연습문제
연습문제 1. 정칙 조건 아래에서 MLE가 갖는 세 가지 주요 점근적 성질인 일치성, 점근정규성, 점근 효율성을 서술하라.
풀이
표준적인 정칙 조건 아래에서 이렇게 된다.
-
일치성: \(n \to \infty\)일 때 \(\hat{\theta}_{\text{MLE}} \xrightarrow{p} \theta_0\).
-
점근정규성: \(\sqrt{n}(\hat{\theta}_{\text{MLE}} - \theta_0) \xrightarrow{d} N(0, I(\theta_0)^{-1})\)이며, \(I(\theta_0)\)은 관측값 하나에 대한 피셔 정보량이다.
-
점근 효율성: MLE는 점근적으로 크라메르–라오 하한을 달성한다. 즉 어떤 정칙 일치추정량도 \(1/(nI(\theta_0))\)보다 작은 점근분산을 가질 수 없다.
이 성질들 덕분에 MLE는 대표본 모수적 추정의 기본 선택이 된다. 다만 소표본에서는 MLE가 편향되거나 다른 추정량보다 효율이 낮을 수 있다.
연습문제 2. 비율 모수가 \(\lambda\)인 지수분포에서 MLE는 \(\hat{\lambda} = 1/\bar{X}\)이다. 피셔 정보량 \(I(\lambda)\)를 계산하고 \(\hat{\lambda}\)의 점근분산이 \(\lambda^2/n\)임을 확인하라.
풀이
관측값 하나에 대한 로그가능도는 \(\ell(\lambda) = \log\lambda - \lambda x\)이다. 2계도함수는 이렇게 된다.
피셔 정보량은 이렇게 된다.
MLE의 점근분산은 이렇게 된다.
따라서 \(n\)이 크면 \(\hat{\lambda} \approx N(\lambda, \lambda^2/n)\)이고 표준오차는 \(\text{SE}(\hat{\lambda}) \approx \lambda/\sqrt{n}\)이다.
연습문제 3. 불변성은 \(\hat{\theta}\)가 \(\theta\)의 MLE이면 임의의 함수 \(g\)에 대해 \(g(\hat{\theta})\)가 \(g(\theta)\)의 MLE라는 성질이다. 이를 이용하여 지수분포의 평균 \(1/\lambda\)의 MLE를 구하라.
풀이
비율 모수의 MLE는 \(\hat{\lambda} = 1/\bar{X}\)이다. 불변성에 의해 (모평균인) \(g(\lambda) = 1/\lambda\)의 MLE는 이렇게 된다.
지수분포 평균의 MLE가 표본평균이라는 직관적인 결과가 확인된다. 불변성은 MLE를 처음부터 다시 유도하지 않고도 비선형 변환을 포함한 임의의 변환에 대해 작동하므로 강력하다.
연습문제 4. MLE가 점근적으로는 불편인데도 유한표본에서 편향될 수 있는 이유를 설명하라. 구체적인 예를 들라.
풀이
점근적 불편성은 \(n \to \infty\)일 때 \(E[\hat{\theta}_n] \to \theta_0\)임을 뜻하지만, 고정된 \(n\)에 대해서는 편향 \(E[\hat{\theta}_n] - \theta_0\)이 0이 아닐 수 있다.
예: 정규분포의 분산에서 MLE는 \(\hat{\sigma}^2_{\text{MLE}} = \frac{1}{n}\sum(X_i - \bar{X})^2\)이며 다음을 만족한다.
편향은 \(-\sigma^2/n\)으로 \(n \to \infty\)일 때 사라지지만 모든 유한한 \(n\)에서는 0이 아니다. 이 때문에 불편추정량(unbiased estimator) \(S^2 = \frac{1}{n-1}\sum(X_i - \bar{X})^2\)이 베셀 수정 \(n - 1\)을 사용한다.
일반적으로 \(\hat{\theta}\)가 \(\theta\)의 MLE이고 \(g\)가 비선형이면 불변성에 의해 \(g(\hat{\theta})\)가 \(g(\theta)\)의 MLE이지만, 옌센 부등식에 의해 유한표본에서 \(E[g(\hat{\theta})] \neq g(\theta)\)가 되어 편향이 생긴다.
연습문제 5. \(X_i \sim \text{Uniform}(0,\theta)\)에서 \(\hat\theta = \max_i X_i\)는 정칙 조건을 만족하지 않는다. 어느 조건이 깨지는지 밝히고, 그 결과 점근분포가 어떻게 달라지는지 보여라.
풀이
깨지는 조건. 정칙 조건의 핵심은 밀도의 지지집합이 모수에 의존하지 않는다는 것이다. 여기서는 지지집합이 \([0,\theta]\)로 \(\theta\)에 직접 의존한다.
그 결과 미분과 적분을 맞바꿀 수 없게 되고, 점수함수의 기댓값이 0이라는 기본 항등식 \(E[\ell'(\theta)] = 0\)이 무너진다. 실제로 로그가능도 \(\ell(\theta) = -n\ln\theta\)(\(\theta \ge x_{(n)}\))는 \(\theta\)에 대해 감소하며 도함수가 0이 되는 점이 없다. MLE는 미분이 아니라 제약의 경계 \(\theta = x_{(n)}\)에서 나온다.
점근분포. \(M = \max_i X_i\)의 CDF가 \((m/\theta)^n\)이므로, \(t > 0\)에 대해
이다. 따라서
정칙 경우와의 대비.
| 정칙 | 균등 | |
|---|---|---|
| 수렴 속도 | \(\sqrt n\) | \(n\) (더 빠름) |
| 극한분포 | 정규 | 지수 |
| 대칭성 | 대칭 | 비대칭(한쪽으로만 꼬리) |
| 크라메르–라오 | 점근적으로 달성 | 적용 불가 |
수렴이 \(\sqrt n\)보다 빠른 것을 초일치성이라 한다. 크라메르–라오 하한이 \(\hat\theta\)의 분산에 대해 아무것도 말해 주지 않는 이유가 여기 있다. 하한 자체가 정칙 조건 아래에서만 유도되기 때문이다.
실무적 함의. 이런 모형에서는 표준오차와 왈드 구간을 쓰면 안 된다. 정확한 분포를 직접 쓰거나, 부트스트랩(bootstrap)을 쓴다면 \(m\)-out-of-\(n\) 같은 변형이 필요하다. 경제학의 경계모형, 생존분석의 임계 모수, 극단값 모형에서 같은 문제가 나타난다.
연습문제 6. 델타 방법을 서술하고, MLE의 점근정규성과 결합해 \(g(\hat\theta)\)의 점근분포를 구하라. \(\hat\lambda\)의 점근분포에서 \(\hat\mu = 1/\hat\lambda\)의 점근분포를 유도해 확인하라.
풀이
델타 방법. \(\sqrt n(\hat\theta-\theta) \xrightarrow{d} N(0, \sigma^2)\)이고 \(g\)가 \(\theta\)에서 미분가능하며 \(g'(\theta) \ne 0\)이면
증명 개요. \(g\) 를 \(\theta\) 근처에서 테일러 전개하면
이고 \(\sqrt n\)을 곱하면 나머지항이 \(O_p(n^{-1/2}) \to 0\)이므로 슬러츠키 정리로 결론이 따라 나온다.
MLE와 결합. \(\sigma^2 = 1/I_1(\theta)\)이므로
이다. 이는 \(g(\theta)\) 모수화에서의 크라메르–라오 하한과 정확히 같다. MLE의 점근효율성은 변환에 대해 보존된다.
확인. 지수분포에서 \(\hat\lambda\)의 점근분산이 \(\lambda^2/n\)이고 \(g(\lambda) = 1/\lambda\)이므로 \(g'(\lambda) = -1/\lambda^2\)이다.
\(\hat\mu = \bar X\) 이고 지수분포의 분산이 \(\mu^2\) 이므로 직접 구한 \(\operatorname{Var}(\bar X) = \mu^2/n\)과 일치한다. ✓
주의할 점. \(g'(\theta) = 0\)이면 1차항이 사라져 이 결과가 성립하지 않는다. 그때는 2차항이 주도해 극한분포가 정규가 아니라 카이제곱류가 된다. 예컨대 \(\theta = 0\) 근처에서 \(g(\theta)=\theta^2\)의 분포가 그렇다.
연습문제 7. 모형이 틀렸을 때(\(\theta\) 값이 무엇이든 참 분포를 담지 못할 때) MLE는 무엇으로 수렴하는가? 표준오차는 어떻게 고쳐야 하는가?
풀이
수렴 대상. 참 분포를 \(g\), 모형족을 \(\{f(\cdot;\theta)\}\)라 하자. 로그가능도의 평균이
이고, 이를 최대로 하는 \(\theta\)는
이다. 즉 MLE는 참 분포에 쿨백–라이블러 발산 기준으로 가장 가까운 모형으로 수렴한다. 이를 유사참값(pseudo-true value)이라 하며, 추정량을 유사최대가능도추정량(quasi-maximum likelihood estimator, QMLE)이라 부른다.
표준오차. 모형이 맞으면 성립하던 정보량 등식
가 깨진다. 점근분포는
이고, 이 \(A^{-1}BA^{-1}\)을 샌드위치 분산 또는 화이트의 로버스트 분산이라 한다. 모형이 맞으면 \(A=B\)가 되어 \(A^{-1}\), 즉 보통의 \(I^{-1}\)로 돌아온다.
추정.
실무. 회귀에서 이분산이 있을 때 쓰는 로버스트 표준오차(HC0~HC3), 군집 표준오차, 일반화추정방정식의 표준오차가 모두 샌드위치 형태다. 계수 추정값은 그대로 두고 불확실성만 고쳐 주는 것이 특징이다.
주의. 샌드위치 분산은 표준오차만 고친다. 점추정(point estimation)이 겨냥하는 \(\theta^*\)가 애초에 관심 모수가 아닐 수 있고, 가능도비 검정도 더 이상 \(\chi^2\)를 따르지 않는다. "모형이 틀려도 로버스트 표준오차를 쓰면 된다"는 말은 지나친 단순화다.
연습문제 8. "점근적으로 정규"라는 말이 실무에서 얼마나 믿을 만한지 판단하려 한다. 어떤 요인들이 필요한 \(n\)을 좌우하는지 정리하고, 실제로 확인하는 방법을 적어라.
풀이
필요한 \(n\)을 좌우하는 요인.
- 모수공간의 경계까지의 거리. \(\hat p\)가 0이나 1에 가깝거나 분산성분이 0에 가까우면 아무리 \(n\)이 커도 정규근사가 나쁘다. 중요한 것은 \(n\) 자체가 아니라 \(\hat\theta\)가 경계에서 몇 표준오차 떨어져 있는가다.
- 유효 정보량. 이항에서는 \(n\)이 아니라 \(np(1-p)\)가, 생존분석에서는 관측 수가 아니라 사건 수가, 포아송에서는 총 계수가 기준이다.
- 모수화. 로그가능도가 이차식에 얼마나 가까운지가 핵심이며, 이는 모수화에 따라 크게 달라진다. \(\sigma\)보다 \(\ln\sigma\), \(p\)보다 로짓이 훨씬 빨리 정규에 다가간다.
- 모수의 개수. \(p\)가 \(n\)에 비해 크면 점근이론이 통하지 않는다. 대략 \(n/p \ge 10\)은 되어야 한다는 경험칙이 있다.
- 장애모수(nuisance parameter)의 수. 관측 단위마다 모수가 하나씩 생기는 구조(네이만–스콧 문제)에서는 \(n\to\infty\)여도 일치성조차 없다.
확인하는 방법.
- 로그가능도 곡선(또는 프로파일 곡선)을 그린다. 포물선에서 얼마나 벗어나는지 눈으로 본다. 가장 값싸고 정보가 많은 진단이다.
- 왈드 구간과 가능도비 구간을 둘 다 계산해 견준다. 둘이 크게 다르면 이차 근사가 나쁘다는 직접적인 증거다.
- 부트스트랩한다. \(\hat\theta\)의 부트스트랩 분포를 정규밀도와 겹쳐 그리거나 Q-Q 그림을 그린다.
- 모의실험한다. 추정값을 참값으로 놓고 자료를 생성해 신뢰구간의 실제 포함확률을 세어 본다. 가장 확실한 방법이며, 계산 비용이 감당되면 언제나 권할 만하다.
결론. "\(n\)이 충분히 크면 된다"는 말은 구체적인 상황에서 확인해야 하는 주장이지 자동으로 적용되는 보증이 아니다. 위 진단 중 하나만 해 보아도 대부분의 사고를 막을 수 있다.
연습문제 9. MLE의 점근분산이 크라메르–라오 하한과 같다는 사실을 근거로 "MLE는 언제나 최선"이라고 말할 수 있는가? 반례를 들어 논하라.
풀이
말할 수 없다. 네 가지 유보가 있다.
(1) 점근적일 뿐이다. 유한표본에서는 다른 추정량이 나을 수 있다. 정규분포의 \(\hat\sigma^2_{\text{MLE}} = \frac1n\sum(x_i-\bar x)^2\)은 편향되어 있고, 평균제곱오차 기준으로는 \(\frac{1}{n+1}\sum(x_i-\bar x)^2\)이 더 낫다. MLE도 불편추정량도 최적이 아니다.
(2) 불편추정량 안에서만의 최적이다. 크라메르–라오는 불편추정량의 분산에 대한 하한이다. 편향을 허용하면 평균제곱오차가 더 작은 추정량이 있을 수 있다.
가장 유명한 반례가 제임스–스타인 추정량이다. \(\mathbf{X}\sim N_d(\boldsymbol\mu, I)\)에서(여기의 \(I\) 는 정보량이 아니라 단위행렬이다) \(d \ge 3\)이면
가 MLE \(\mathbf{X}\)를 모든 \(\boldsymbol\mu\)에서 평균제곱오차로 이긴다. MLE가 허용 불가능(inadmissible)하다는 뜻이다. 서로 무관해 보이는 여러 평균을 원점 쪽으로 함께 축소하는 것이 이득이라는 결과라 발표 당시 충격을 주었고, 오늘날 축소 추정과 계층모형의 출발점이 되었다.
(3) 정칙 조건이 필요하다. 연습문제 5의 균등분포에서는 MLE의 수렴 속도가 \(n\)이라 크라메르–라오가 아예 적용되지 않고, 분산이 형식적으로 계산한 하한보다 훨씬 작아진다.
(4) 모형이 맞다는 전제가 있다. 모형이 틀리면 MLE는 유사참값으로 수렴하며, 그 값이 관심 모수가 아닐 수 있다. 이상치(outlier)가 있는 자료에서 정규 MLE(표본평균(sample mean))는 로버스트 추정량보다 훨씬 나쁘다.
정리. MLE가 널리 쓰이는 이유는 "최선"이어서가 아니라 일반적이고, 자동이며, 정칙 조건 아래 점근적으로 효율적이기 때문이다. 표본이 작거나, 모수가 많거나, 모형이 미덥지 않거나, 모수공간에 경계가 있으면 대안을 함께 살펴야 한다.
연습문제 10. MLE의 점근정규성을 점수함수의 테일러 전개로 유도하라. 어디서 큰수의 법칙이, 어디서 중심극한정리가 쓰이는가?
풀이
점수함수를 \(U_n(\theta) = \ell'(\theta)\)라 하자. \(\hat\theta\)가 내부 최댓값이면 \(U_n(\hat\theta) = 0\)이다. 참값 \(\theta_0\) 둘레에서 전개하면
이고(\(\tilde\theta\)는 \(\theta_0\)와 \(\hat\theta\) 사이의 어떤 값), 정리하면
분자 — 중심극한정리. \(U_n(\theta_0) = \sum_i s(X_i;\theta_0)\)는 독립인 점수의 합이다. 정칙 조건에서 \(E[s] = 0\)이고 \(\operatorname{Var}(s) = I_1(\theta_0)\)이므로
분모 — 큰수의 법칙. \(-n^{-1}U_n'(\theta_0) = -n^{-1}\sum_i s'(X_i;\theta_0)\) 역시 독립인 항의 평균이므로
이다. \(\hat\theta\)의 일치성(\(\hat\theta\xrightarrow{p}\theta_0\))에서 \(\tilde\theta \xrightarrow{p}\theta_0\)이고, 적당한 연속성 조건 아래 \(-n^{-1}U_n'(\tilde\theta)\)도 같은 극한을 갖는다.
결합 — 슬러츠키. 분포수렴하는 분자를 확률수렴하는 상수로 나누면
를 얻는다. \(\square\)
구조를 읽으면. 점근분산의 분자에 있는 \(I_1\)은 점수의 변동(중심극한정리)에서 오고, 분모의 \(I_1^2\)은 로그가능도의 곡률(큰수의 법칙)에서 온다. 둘이 같은 \(I_1\)인 것이 우연이 아니라 정보량 등식이며, 연습문제 7 에서 본 대로 모형이 틀리면 이 일치가 깨져 샌드위치 형태가 남는다.
증명에 필요한 조건. (1) \(\hat\theta\)가 내부에 있을 것(경계면 실패), (2) 세 번 미분 가능하고 3계 도함수가 유계일 것(테일러 전개의 나머지 통제), (3) 미분과 적분을 맞바꿀 수 있을 것(지지집합이 모수에 무관), (4) \(\hat\theta\)가 일치할 것, (5) \(I_1(\theta_0)\)이 유한하고 양수일 것.
정리하며
정칙 조건 아래에서 최대가능도추정량은 세 가지 성질을 갖는다.
- 일치성 · 점근정규성 · 점근 효율성. 참값으로 가고, 정규분포로 가며, 그 분산이 크라메르–라오 하한과 같다. 점근적으로는 더 나은 추정량이 없다.
- 이 셋이 최대가능도를 기본 전략으로 삼는 근거이며, 가능도비(likelihood ratio) 검정·왈드 검정·정보기준이 모두 여기서 나온다.
- 정칙 조건이 장식이 아니다. 식별 가능성, \(\theta\) 에 의존하지 않는 지지집합, 내부의 참값, 매끄러움, 양의 정보량. 이 중 하나만 깨져도 결론이 무너진다.
- 깨지는 실제 사례들. \(\text{Uniform}(0,\theta)\) 는 지지집합이 \(\theta\) 에 의존해 수렴 속도가 \(n^{-1}\) 로 더 빠르고 극한이 정규가 아니다. 분산 모수를 \(0\) 근처에서 추정하면 참값이 경계에 놓여 표준 이론이 적용되지 않는다. 정규혼합의 가능도는 위로 유계가 아니다(3.5절 큰수의 법칙 참조).
- "점근적으로"가 "당신의 \(n\) 에서"를 뜻하지는 않는다. 소표본에서는 편향이 \(O(1/n)\) 으로 남아 있으며, 정규분포의 \(\hat\sigma^2\) 이 그 예다.
다음 절 피셔 정보량과 표준오차는 위 공식의 \(I(\theta_0)\) 을 실제로 계산하고 표준오차로 바꾸는 법을 다룬다.