동질성 검정
1. 동질성 검정과 독립성 검정
들어가는 이야기 — 「셋이 같지 않다」에서 두 가지를 더
「셋이 같지 않다」는 결론은 어느 하나가 다른지도, 얼마나 다른지도 말해 주지 않는다. 이 쪽은 그 한 줄에서 두 가지를 더 꺼낸다 — 어느 칸이 얼마나 냈는지와 연관의 크기다.
행이 응답 다섯 범주이고 열이 나라 셋인 병원 만족도 표(\(n = 3706\))에서 \(X^2 = 212.94\) 가 나온다. 자유도는 \((5-1)(3-1) = 8\) 이고, 거기서 사실상 불가능한 값이니 「세 나라의 분포가 같다」는 기각된다. 그런데 칸별 기여를 펼쳐 보면 한 나라가 \(136.62\) — 전체의 \(64\%\) — 를 들고 있고 다른 나라는 \(1.87\), 곧 \(0.9\%\) 에 지나지 않는다. 멕시코를 빼고 남은 둘만 떼어 보면 통계량이 \(212.94\) 에서 \(11.73\) 으로 떨어진다.
크기는 또 다른 이야기다. \(0\) 에서 \(1\) 사이의 수인 크라메르 \(V\)(Cramér's V)가 같은 자료에서 \(0.1695\) 로 약한 연관이다. 표본이 \(3706\) 이어서 통계량이 커진 것이고, 비율의 차이 자체는 작다. 유의성과 크기가 서로 다른 방향을 가리키는 전형이다.
설계도 함께 적어 두어야 한다. 셈이 독립성 검정(test of independence)과 완전히 같다는 것이 뜻까지 같다는 말은 아니다. 나라마다 표본을 따로 뽑았다면 묻는 것이 「두 변수가 무관한가」가 아니라 「세 모집단의 분포가 같은가」다. 귀무가설(null hypothesis)은 세 나라의 선이 겹친다는 말이 된다. 쌍마다 다시 보려면 비교 횟수만큼 보정이 따라붙는다. 「셋이 같지 않다」는 결론에서 어느 나라가 얼마나 다른지는 어떻게 읽어 내는가. 아래 상자가 분포가 움직였는지를 묻는 자리를 따라간다.
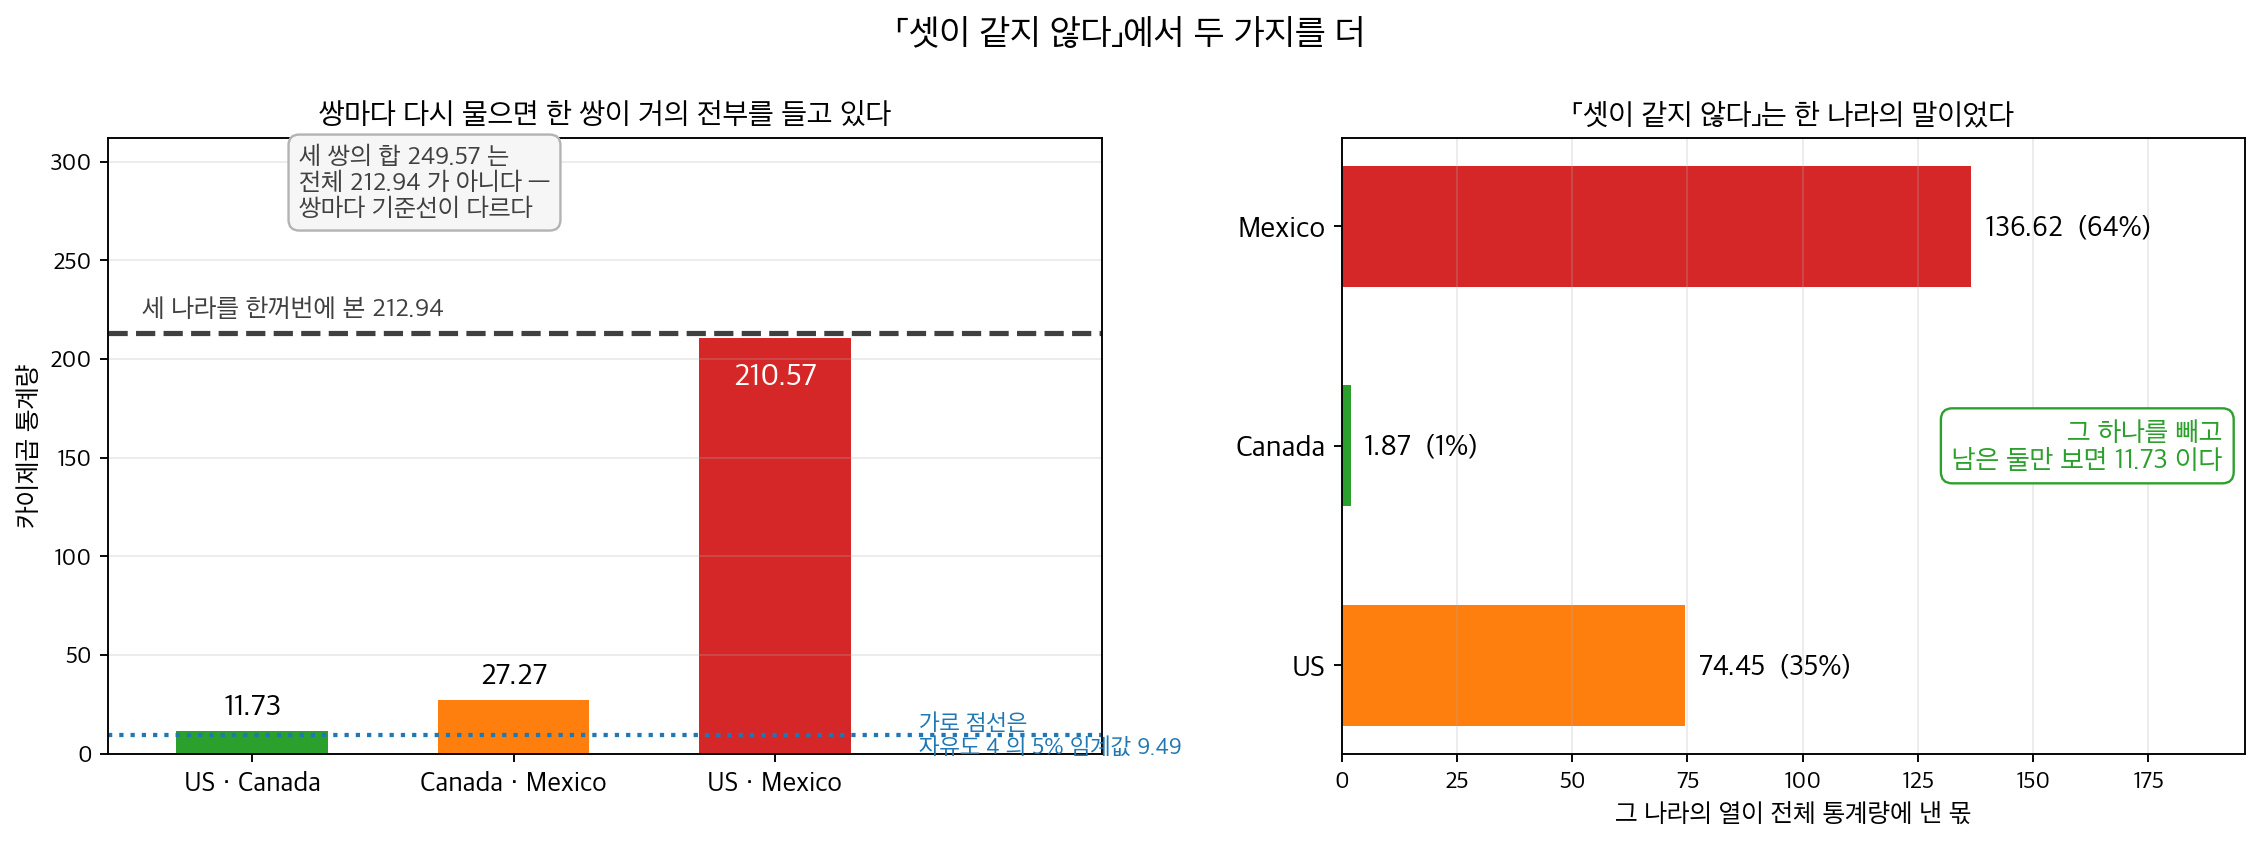
오른쪽. 「셋이 같지 않다」는 결론은 사실 한 나라의 말이었다 — Mexico 열이 \(136.62\), 곧 전체 \(212.94\) 의 \(64\%\) 를 들고 있고 Canada 는 \(1.87\) 로 \(1\%\) 에 지나지 않는다. 왼쪽. 그래서 쌍마다 다시 물으면 US–Mexico 가 \(210.57\) 로 거의 전부이고, Mexico 를 빼고 남은 둘만 보면 \(11.73\) 으로 떨어진다. 다만 세 쌍의 합 \(249.57\) 은 전체 \(212.94\) 가 아니다 — 쌍마다 총합과 합동 분포(pooled distribution)가 달라 기준선이 바뀌기 때문이고, 그래서 이것은 분해가 아니다. 수는 모두 아래 보기 1 과 보기 4 가 출력으로 적어 둔 것이다.
카이제곱 독립성 검정과 카이제곱 동질성 검정(test of homogeneity)은 계산 절차가 완전히 같다. 그러나 목적, 실험 설계, 해석이 다르다.
공통점의 핵심
두 검정 모두 같은 χ² 검정통계량(test statistic)
과 같은 표집분포(sampling distribution, 자유도 \((r-1)(c-1)\)인 χ²)를 쓴다.
기대도수도 같은 방식으로 계산한다.
따라서 계산만 보아서는 어느 검정을 하고 있는지 구분할 수 없다. 차이는 자료를 어떻게 수집했는가와 어떤 질문에 답하는가에 있다.
개념적 차이
| 항목 | 독립성 검정 | 동질성 검정 |
|---|---|---|
| 연구 질문 | 두 범주형 변수가 연관되어 있는가(통계적으로 종속인가)? | 둘 이상의 모집단이 어떤 범주형 변수의 분포에서 서로 비슷한가(동질적인가)? |
| 자료의 출처 | 하나의 무작위 표본을 두 변수로 분류한다. | 각 모집단에서 하나씩, 여러 개의 독립인 무작위 표본. |
| 예시 질문 | 어떤 모집단에서 흡연 여부가 성별과 관련이 있는가? | 남성, 여성, 청소년의 흡연 습관 분포가 같은가? |
| 표집 설계 | 표본 하나 → 두 변수로 교차 분류. | 각 집단(또는 처치)에서 별도의 표본. |
| 해석 | 두 변수 사이의 연관 또는 독립을 검정한다. | 모집단들에 걸친 분포의 유사성(동질성)을 검정한다. |
표만 보아서는 모른다 — 흡연과 폐암
표 하나가 주어졌다. 영국 남성 \(1298\) 명을 폐암 여부와 흡연 여부로 나눈 것이다.
| 흡연자 | 비흡연자 | 합 | |
|---|---|---|---|
| 폐암 | \(647\) | \(2\) | \(649\) |
| 폐암 아님 | \(622\) | \(27\) | \(649\) |
| 합 | \(1269\) | \(29\) | \(1298\) |
흡연자 \(1269\) 명 가운데 폐암이 \(647\) 명이니 \(51\%\) 다. 담배를 피우면 둘에 하나가 폐암에 걸린다고 적어도 되는가?
안 된다. 이 표는 리처드 돌(Richard Doll)과 오스틴 브래드퍼드 힐(Austin Bradford Hill)이 1950 년에 발표한 연구의 남성 자료이고, 그들은 사람을 무작위로 뽑지 않았다. 런던의 병원 스무 곳에서 폐암 환자 \(649\) 명을 먼저 모으고, 환자마다 같은 병원·같은 성별·같은 나이대의 다른 병 환자를 한 명씩 대조로 붙였다. 이런 설계를 환자–대조군 연구(case-control study)라 한다. 그러면 「폐암 행 \(649\), 대조 행 \(649\)」는 자료가 알려 준 것이 아니라 연구자가 정한 수다. 표의 절반이 폐암인 것도, 흡연자의 절반이 폐암인 것도 그 결정의 메아리다.
단서는 표 안에 있었다. 두 행 합이 \(649 = 649\) 로 똑같다. 사람을 무작위로 뽑았다면 행 합도 우연히 정해지는 수여서 이렇게 맞아떨어질 까닭이 없다. 너무 반듯한 주변합은 누군가 그 합을 고정했다는 표시다.
같은 수가 세 가지 이야기에서 나올 수 있다.
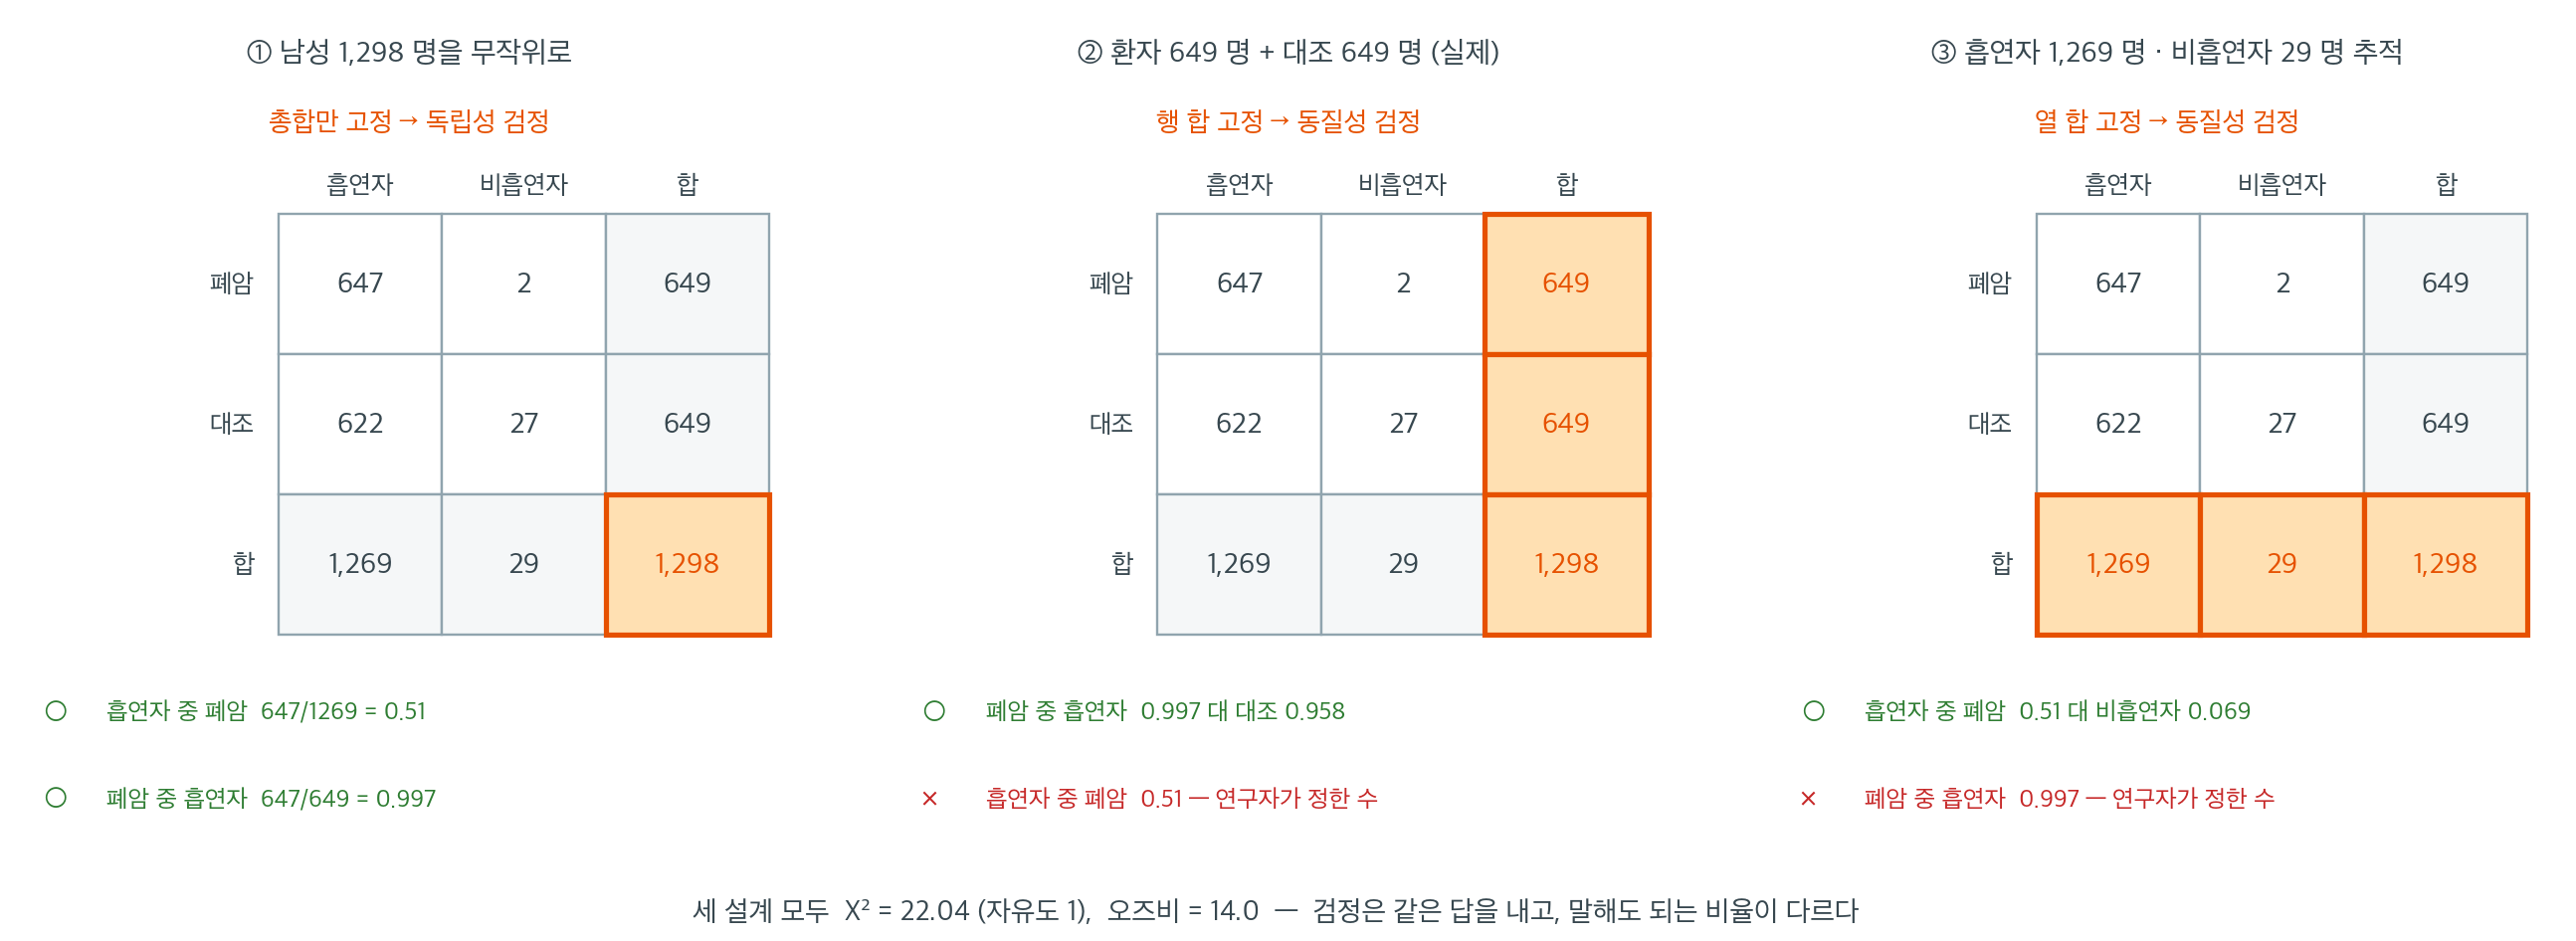
같은 표, 세 설계. 주황 칸이 연구자가 정한 합이다. ① 총합만 고정이면 두 변수가 모두 우연히 정해지므로 어느 방향의 비율도 읽을 수 있다 — 독립성 검정이다. ② 행 합 고정(실제 설계)이면 행 안의 비율, 곧 「폐암 환자와 대조 가운데 흡연자가 얼마인가」만 모집단을 말한다 — 두 집단의 흡연 분포를 견주는 동질성 검정이다. ③ 열 합 고정(흡연자와 비흡연자를 정해 놓고 추적하는 코호트 연구(cohort study))이면 거꾸로 열 안의 비율만 읽힌다. 셋 모두 \(X^2 = 22.04\) 이고 오즈비(odds ratio) \(14.0\) 도 같다.
검정은 세 경우에 같은 답을 낸다. 기대도수가 \(R_iC_j/n\) 하나뿐이고 통계량과 자유도도 같기 때문이다. 다른 것은 기각한 뒤에 무엇을 말해도 되는가다. ② 에서 「흡연자 중 폐암 \(51\%\)」를 읽을 수 없다는 것은 대조를 한 명이 아니라 두 명씩 붙였다면 어떻게 되었을지 생각해 보면 분명해진다.
import numpy as np
from scipy import stats

# 돌과 힐(1950) Table IV, 남성. 행 = 폐암 환자 / 대조, 열 = 흡연자 / 비흡연자
T = np.array([[647, 2],
              [622, 27]])

def report(T, label):
    chi2, p, df, _ = stats.chi2_contingency(T, correction=False)
    OR = T[0, 0] * T[1, 1] / (T[0, 1] * T[1, 0])
    print(f"[{label}]  X2 = {chi2:.2f}, df = {df}, p = {p:.1e}, 오즈비 = {OR:.2f}")
    print(f"  폐암 중 흡연자 {T[0,0]/T[0].sum():.3f}  대조 중 흡연자 {T[1,0]/T[1].sum():.3f}")
    print(f"  흡연자 중 폐암 {T[0,0]/T[:,0].sum():.3f}")

report(T, "대조 1 배")
# 같은 연구를 대조를 두 배로 모아 했다면 — 대조 행의 비율은 그대로, 도수만 두 배
report(np.array([T[0], 2 * T[1]]), "대조 2 배")
출력:
[대조 1 배]  X2 = 22.04, df = 1, p = 2.7e-06, 오즈비 = 14.04
  폐암 중 흡연자 0.997  대조 중 흡연자 0.958
  흡연자 중 폐암 0.510
[대조 2 배]  X2 = 22.98, df = 1, p = 1.6e-06, 오즈비 = 14.04
  폐암 중 흡연자 0.997  대조 중 흡연자 0.958
  흡연자 중 폐암 0.342
연구자가 대조를 몇 명 모을지 정하는 것만으로 「흡연자 중 폐암」이 \(0.510\) 에서 \(0.342\) 로 움직인다. 연구자의 손으로 바뀌는 수는 모집단에 대해 아무것도 말하지 않는다. 행 안의 비율 \(0.997\) 과 \(0.958\) 은 그대로이고, 오즈비 \(14.04\) 도 그대로다. 오즈비는 행으로 읽든 열로 읽든 같은 값이 나오는 양이라 세 설계에서 모두 살아남는다. 8.3절 두 비율 차이의 신뢰구간이 「환자–대조군 연구에서는 오즈비만 추정 가능하다」고 적어 둔 것이 이 출력이다. 폐암은 희귀한 병이어서 오즈비 \(14\) 는 흡연자의 폐암 위험이 대략 열네 배라는 말로 옮겨진다.
자료의 출처와 짝지은 대조
돌과 힐은 환자마다 대조를 하나씩 짝지어 골랐으므로, 엄밀하게는 짝을 살리는 분석(11.2절 맥니마 검정)도 가능하다. 원 논문의 Table IV 는 두 집단을 그냥 견주었고(정확검정 \(P = 0.00000064\)), 여기서도 그 비교를 따랐다. 짝이 있든 없든 행 합을 연구자가 정했다는 사실은 바뀌지 않는다.
확인한 곳 — R. Doll & A. B. Hill, "Smoking and Carcinoma of the Lung: Preliminary Report", BMJ 2(4682), 739–748 (1950) 의 Table IV(남성 폐암 환자 \(649\) 명 가운데 비흡연자 \(2\) 명, 대조 \(649\) 명 가운데 \(27\) 명, 정확검정 \(P = 0.00000064\))와 설계 서술(런던 병원 스무 곳, 같은 성별·다섯 살 나이대·같은 병원의 대조). 그림과 표의 나머지 수는 모두 직접 계산한 값이다
그러니 독립성인지 동질성인지 묻는 것은 결국 「어느 합을 누가 정했는가」를 묻는 것이다. 문제 문장이 표만 주고 설계를 말하지 않으면 답할 수 없고, 답할 수 없는 채로 비율을 읽으면 「흡연자 둘에 하나가 폐암」 같은 문장이 나온다.
미묘한 연결
수학적으로 두 검정 모두 관측도수의 분할표를 분석하고 \(H_0\) 아래의 기대도수와 비교하며 같은 χ² 통계량을 쓴다.
- 독립성 검정에서 "행"과 "열"은 하나의 모집단에서 나온 두 변수를 나타낸다.
- 동질성 검정에서 "행"은 서로 다른 모집단 또는 처치를, 열은 한 변수의 범주를 나타낸다.
귀무가설 아래에서는 이렇게 된다.
- 독립성 검정: 두 변수가 독립이다.
- 동질성 검정: 모든 모집단이 같은 분포를 공유한다.
확률적으로 표현하면 두 진술은 동치이다.
자료를 어떻게 모았는지가 둘을 가른다
| 측면 | 독립성 검정 | 동질성 검정 |
|---|---|---|
| 자료 수집 | 표본 하나 → 범주형 변수 둘 | 표본 둘 이상 → 범주형 변수 하나 |
| 귀무가설 | 두 변수가 독립이다 | 모든 모집단의 분포가 같다 |
| 대립가설 | 두 변수가 연관되어 있다 | 적어도 한 모집단이 다르다 |
| 검정통계량과 자유도 | 동일 | 동일 |
| 해석 | 하나의 모집단 안에서의 연관 | 모집단들 사이의 일관성 |
요컨대: 절차는 같지만 맥락이 다르다. 독립성 → 하나의 표본 안에서의 관계. 동질성 → 여러 표본 사이의 일관성.
2. 문제 A: 병원의 질
문제 1.
각 나라에서 사람들이 병원의 질을 별 다섯에서 별 하나까지 어떻게 평가하는지 물었다. 자료는 다음과 같다.
관측은 이렇다.
풀이
병원 만족도 분포가 나라들 사이에서 동질적인가, 아니면 다른 나라가 있는가?
식을 그대로 코드로 옮기면
보기 1. 정의대로 계산한 동질성 검정. 위의 병원 만족도 표를 쓴다. 행이 응답 범주(별 5개 … 별 1개), 열이 나라다. 행 합은 \(847,\ 782,\ 1196,\ 677,\ 204\), 열 합은 \(2165,\ 311,\ 1230\), 총합은 \(n = 3706\) 이다.
(1) 동질성의 귀무가설을 열별 조건부분포로 적고, 그로부터 기대도수가 \(E_{ij} = R_i C_j / n\) 이 됨을 보이시오. 이 식이 "각 나라에 합동 분포를 씌운 것" 이라는 뜻임을 설명하시오.
(2) 코드로 \(X^2\) 과 자유도, p 값을 구해 판정하시오.
(3) 칸별 기여를 모두 구해 어느 나라의 어느 범주가 통계량을 끌고 가는지 찾고, 크라메르 \(V\) 로 효과크기(effect size)를 재시오. \(X^2\) 이 212.94 라는 것과 \(V\) 가 말하는 것이 어떻게 다른가.
풀이
(1) 동질성의 \(H_0\) 는 열별 조건부분포가 같다는 것. 나라 \(j\) 에서 응답이 범주 \(i\) 일 조건부확률(conditional probability)을 \(\pi_{i\mid j}\) 라 하면
이다. 공통값 \(\pi_i\) 는 모르는 값이므로 자료에서 추정해야 하는데, 세 나라를 통틀어 범주 \(i\) 에 든 사람이 \(R_i\) 명이므로 가장 자연스러운 추정값은 세 나라를 합쳐서 구한 합동 비율
이다. 나라 \(j\) 의 응답자가 \(C_j\) 명이니 그 나라에서 범주 \(i\) 의 기대도수는
가 되고, 이것이 독립성 검정에서 쓰는 식과 글자 하나까지 같다. 다만 읽는 법이 다르다. 독립성에서는 "주변확률의 곱" 이었고, 동질성에서는 "각 나라에 합동 분포를 그대로 씌운 것" 이다.
합동 분포는
이고, 나라별 실제 분포는
다. 별 2개와 별 1개 줄을 보라. US 의 \(0.1303\) 과 \(0.0300\) 이 Mexico 에서는 \(0.2805\) 와 \(0.0976\) 으로 두 배에서 세 배가 된다. 통계량이 어디서 나올지가 이미 보인다.
자유도는 \((r-1)(c-1) = 4 \times 2 = 8\) 이다. 합동 분포를 추정하느라 \(r-1 = 4\) 개의 모수를 썼고, 나라마다 \(r-1=4\) 개의 자유로운 비율이 있어 모두 \(3 \times 4 = 12\) 개였으므로 \(12 - 4 = 8\) 이 남는다.
(2) 수치적으로.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

def compute_expected(observed):
    """행과 열이 무관하다는 가정 아래 기대도수를 구한다.

    무관하다면 결합확률이 주변확률의 곱이 된다. 그 곱에 전체 도수를 곱한
    것이 각 칸의 기대도수다.
    """
    row_sum = observed.sum(axis=1)
    row_pmf = row_sum.reshape((-1, 1)) / row_sum.sum()

    column_sum = observed.sum(axis=0)
    column_pmf = column_sum.reshape((1, -1)) / column_sum.sum()

    joint_pmf = row_pmf * column_pmf
    expected = joint_pmf * row_sum.sum()
    return expected

def main():
    """동질성 검정을 정의대로 계산하고 p 값을 그림으로 보인다."""
    # 행이 응답 범주, 열이 나라다. 나라마다 응답 분포가 같은지를 묻는다.
    observed = np.array([[541, 75, 231], [498, 71, 213],
                         [779, 96, 321], [282, 50, 345], [65, 19, 120]])
    expected = compute_expected(observed)

    # 자유도는 (행-1)(열-1). 행합과 열합이 묶여 있어 자유롭게 움직일 수 있는
    # 칸이 그만큼뿐이다.
    df = (observed.shape[0] - 1) * (observed.shape[1] - 1)

    statistic = np.sum((observed - expected)**2 / expected)
    p_value = stats.chi2(df).sf(statistic)
    print(f"{statistic = :.02f}")
    print(f"{p_value   = :.02%}")

    _, ax = plt.subplots(figsize=(12, 4))

    x = np.linspace(0, statistic, 1000)
    y = stats.chi2(df).pdf(x)
    ax.plot(x, y, color='b', linewidth=3)

    x = np.concatenate([[0], x, [statistic], [0]])
    y = np.concatenate([[0], y, [0], [0]])
    ax.fill(x, y, color='b', alpha=0.1)

    x = np.linspace(statistic, 300, 100)
    y = stats.chi2(df).pdf(x)
    ax.plot(x, y, color='r', linewidth=3)

    x = np.concatenate([[statistic], x, [20], [statistic]])
    y = np.concatenate([[0], y, [0], [0]])
    ax.fill(x, y, color='r', alpha=0.1)

    xy = (250, 0.01)
    xytext = (250, 0.08)
    arrowprops = dict(color='k', width=0.2, headwidth=8)
    ax.annotate(f'{p_value = :.02%}', xy, xytext=xytext, fontsize=15, arrowprops=arrowprops)

    ax.spines['right'].set_visible(False)
    ax.spines['top'].set_visible(False)
    ax.spines['bottom'].set_position("zero")
    ax.spines['left'].set_position("zero")

    plt.show()

if __name__ == "__main__":
    main()
출력:
statistic = 212.94
p_value   = 0.00%
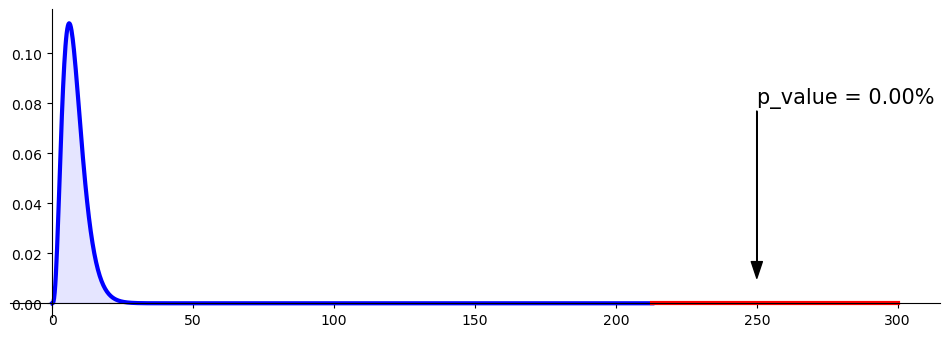
\(X^2 = 212.94\)는 자유도 8인 카이제곱분포(chi-squared distribution)에서 사실상 불가능한 값이다. 세 나라의 만족도 분포가 같지 않다는 결론을 강하게 지지한다.
(3) 어디서 나온 통계량인가. 칸별 기여를 모두 인쇄한다.
import numpy as np

O = np.array([[541, 75, 231], [498, 71, 213],
              [779, 96, 321], [282, 50, 345], [65, 19, 120]])
R, C, N = O.sum(1), O.sum(0), O.sum()
E = np.outer(R, C) / N
contrib = (O - E) ** 2 / E

print("칸별 기여  (O-E)^2/E")
print(f"{'':8s}{'US':>9s}{'Canada':>9s}{'Mexico':>9s}{'행 합':>9s}")
for lab, row in zip(["별 5개", "별 4개", "별 3개", "별 2개", "별 1개"], contrib):
    print(f"{lab:8s}" + "".join(f"{v:9.2f}" for v in row) + f"{row.sum():9.2f}")
print(f"{'열 합':8s}" + "".join(f"{v:9.2f}" for v in contrib.sum(0))
      + f"{contrib.sum():9.2f}")
print(f"\n최소 기대도수 {E.min():.2f}")
print(f"크래머 V = sqrt(chi2 / (n min(r-1,c-1))) "
      f"= sqrt({contrib.sum():.2f} / (3706 x 2)) = {np.sqrt(contrib.sum() / (N * 2)):.4f}")
출력:
칸별 기여  (O-E)^2/E
               US   Canada   Mexico      행 합
별 5개         4.31     0.22     8.93    13.46
별 4개         3.71     0.44     8.35    12.50
별 3개         9.23     0.19    14.53    23.95
별 2개        32.57     0.82    64.42    97.80
별 1개        24.63     0.21    40.39    65.22
열 합         74.45     1.87   136.62   212.94

최소 기대도수 17.12
크래머 V = sqrt(chi2 / (n min(r-1,c-1))) = sqrt(212.94 / (3706 x 2)) = 0.1695
두 줄이 전부다. 별 2개 줄이 \(97.80\), 별 1개 줄이 \(65.22\) 로 둘을 합치면 \(163.0\), 곧 전체 \(212.94\) 의 \(77\%\) 다. 나라로 보면 Mexico 가 \(136.62\) (\(64\%\)), US 가 \(74.45\) (\(35\%\)), Canada 는 \(1.87\) (\(0.9\%\)) 다. Canada 는 합동 분포에 거의 그대로 맞는다. 가장 큰 칸 하나는 Mexico 의 별 2개로 \(64.42\), 전체의 \(30\%\) 다.
최소 기대도수가 \(17.12\) 라 모든 칸이 5 를 넘고, 타당성 조건이 넉넉하게 충족된다.
\(X^2\) 과 \(V\) 가 서로 다른 말을 한다. \(X^2 = 212.94\) 는 "우연으로 보기 어렵다" 를 압도적으로 말하지만 크라메르 \(V = 0.1695\) 는 약한 연관이다(\(V \le 0.1\) 약함, \(0.3\) 중간, \(0.5\) 이상 강함이라는 흔한 기준에서 약함과 중간 사이다). 까닭은 \(X^2 = n V^2 \min(r-1,c-1)\) 이라서 \(n = 3706\) 이 통계량을 끌어올리기 때문이다. 관측값이 3,500 개가 넘어 검정력이 아주 높다는 점을 함께 보아야 한다. "분포가 같지 않다" 는 확실하지만 "많이 다르다" 는 아니다.
chi2_contingency 가 같은 값을 주는지
보기 2. scipy로 계산한 동질성 검정.
(1) scipy.stats.chi2_contingency 가 보기 1 의 손계산과 같은 값을 주는지 확인하시오. 이 함수는 독립성인지 동질성인지 알 수 있는가.
(2) 출력이 p_value = 0.00% 다. 실제 p 값은 얼마인가. 임계값 방식으로도 판정하시오.
풀이
(1) 같은 계산이다. 보기 1 (1)에서 본 대로 동질성의 기대도수와 독립성의 기대도수가 같은 식 \(R_iC_j/n\) 이므로 chi2_contingency 는 둘을 구분할 필요가 없다. 구분은 표집 설계에 있고 그것은 함수가 알 수 없다. 여기서 나라별 표본 크기 \(2165,\ 311,\ 1230\) 이 연구자가 정한 값인지 결과인지는 코드에 적혀 있지 않다. 설계를 아는 사람이 결론 문장을 "세 나라의 만족도 분포가 같지 않다" 로 쓰느냐 "나라와 만족도가 독립이 아니다" 로 쓰느냐만 달라진다.
chi2_contingency 는 \(2\times2\) 표에만 예이츠 보정을 걸고 여기는 \(5\times3\) 이라 보정이 없다. 그러므로 보기 1 과 같은 수가 나와야 한다.
(2) 수치적으로.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

def main():
    """같은 계산을 scipy 의 chi2_contingency 로 대신한다."""
    observed = np.array([[541, 75, 231], [498, 71, 213],
                         [779, 96, 321], [282, 50, 345], [65, 19, 120]])

    # 기대도수와 자유도까지 함께 돌려준다. 앞의 손계산과 값이 맞아야 한다.
    statistic, p_value, df, expected = stats.chi2_contingency(observed)
    print(f"{statistic = :.02f}")
    print(f"{p_value   = :.02%}")

    _, ax = plt.subplots(figsize=(12, 4))

    x = np.linspace(0, statistic, 1000)
    y = stats.chi2(df).pdf(x)
    ax.plot(x, y, color='b', linewidth=3)

    x = np.concatenate([[0], x, [statistic], [0]])
    y = np.concatenate([[0], y, [0], [0]])
    ax.fill(x, y, color='b', alpha=0.1)

    x = np.linspace(statistic, 300, 100)
    y = stats.chi2(df).pdf(x)
    ax.plot(x, y, color='r', linewidth=3)

    x = np.concatenate([[statistic], x, [20], [statistic]])
    y = np.concatenate([[0], y, [0], [0]])
    ax.fill(x, y, color='r', alpha=0.1)

    xy = (250, 0.01)
    xytext = (250, 0.08)
    arrowprops = dict(color='k', width=0.2, headwidth=8)
    ax.annotate(f'{p_value = :.02%}', xy, xytext=xytext, fontsize=15, arrowprops=arrowprops)

    ax.spines['right'].set_visible(False)
    ax.spines['top'].set_visible(False)
    ax.spines['bottom'].set_position("zero")
    ax.spines['left'].set_position("zero")

    plt.show()

if __name__ == "__main__":
    main()
출력:
statistic = 212.94
p_value   = 0.00%
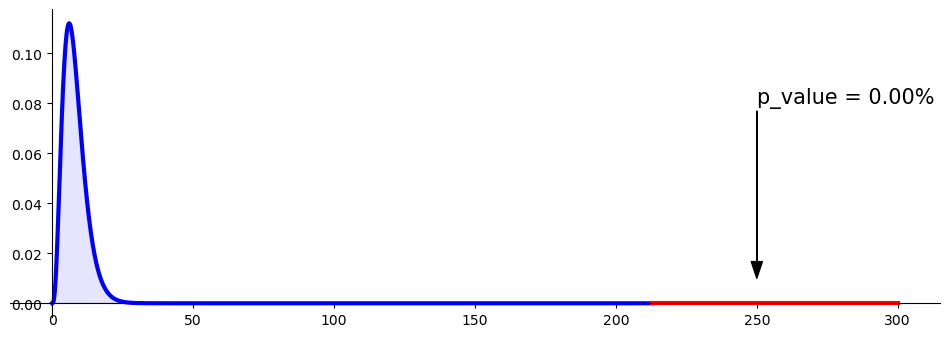
chi2_contingency가 수동 계산과 같은 값을 준다.
인쇄된 0.00% 는 소수 둘째 자리에서 끊은 것이다. 실제 값을 자리수까지 본다.
from scipy.stats import chi2

chi2_obs = 212.93563265
print(f"정확한 p 값          {chi2.sf(chi2_obs, 8):.4e}")
print(f"임계값 chi2_0.05(8)  {chi2.ppf(0.95, 8):.4f}")
print(f"관측값은 임계값의    {chi2_obs / chi2.ppf(0.95, 8):.1f} 배")
출력:
정확한 p 값          1.1951e-41
임계값 chi2_0.05(8)  15.5073
관측값은 임계값의    13.7 배
\(p = 1.2 \times 10^{-41}\) 이다. 임계값 \(15.5073\) 의 \(13.7\) 배이므로 어떤 통상적 유의수준에서도 기각한다. 다만 보기 1 (3)에서 본 대로 효과크기는 \(V = 0.17\) 로 크지 않다. p 값의 자릿수는 표본 크기의 이야기이고 효과의 크기가 아니다.
동질적인 경우와의 비교
동질적인 분포가 어떻게 보이는지 보이기 위해, 원자료를 나라들 사이에 분포가 비슷한 경우와 비교해 보자.
보기 3. 동질적인 자료와 견주기. 같은 절차를 나라별 분포가 거의 같은 자료에 적용한다.
(1) \(X^2\) 과 p 값을 구하시오.
(2) 적합도 검정에서는 귀무가설 아래 \(E[X^2] = \text{df}\) 가 근사 없이 성립한다. 분할표에서는 어떤가(풀이가 \(\approx\) 로 적는 까닭을 밝히시오). 그러면 이 자료의 \(1.10\) 은 자유도 8 인 카이제곱분포의 어디에 놓이는가. 아래쪽 꼬리의 백분위로 답하시오.
(3) (2)의 답이 뜻하는 것은 무엇인가. "적합이 너무 좋다" 가 왜 문제가 될 수 있는가.
풀이
(1) 수치적으로. 절차는 보기 1 과 똑같다. 도수만 바꾼다.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

def compute_expected(observed):
    row_sum = observed.sum(axis=1)
    row_pmf = row_sum.reshape((-1, 1)) / row_sum.sum()
    column_sum = observed.sum(axis=0)
    column_pmf = column_sum.reshape((1, -1)) / column_sum.sum()
    joint_pmf = row_pmf * column_pmf
    expected = joint_pmf * row_sum.sum()
    return expected

def main():
    # 이번에는 세 나라의 분포를 비슷하게 맞춘 자료다. 앞과 같은 절차인데
    # p 값이 크게 나온다. 검정이 무엇에 반응하는지가 이 대비에서 드러난다.
    observed = np.array([[541, 530, 550], [498, 490, 503],
                         [779, 750, 760], [282, 270, 265], [65, 60, 58]])
    expected = compute_expected(observed)
    df = (observed.shape[0] - 1) * (observed.shape[1] - 1)

    statistic = np.sum((observed - expected)**2 / expected)
    p_value = stats.chi2(df).sf(statistic)
    print(f"{statistic = :.02f}")
    print(f"{p_value   = :.02%}")

if __name__ == "__main__":
    main()
출력:
statistic = 1.10
p_value   = 99.75%
앞의 자료와 대비된다. 나라별 분포가 거의 같으면 통계량이 1.10까지 떨어지고 p 값은 99.75%가 된다.
(2) 기준선은 자유도다. 귀무가설 아래에서 각 칸의 불일치가 평균 0, 분산이 대략 \(E_{ij}\) 이므로 \((O-E)^2/E\) 의 기댓값이 칸마다 1 근처이고, 제약을 빼고 세면 정확히 자유도만큼 남는다. 적합도 검정(goodness-of-fit test)에서는 이것이
로 근사 없이 나온다(연습문제 10 에서 과대산포를 진단할 때 쓰는 바로 그 사실이다). 분할표에서도 \(E[X^2] \approx (r-1)(c-1) = 8\) 이다.
그러므로 \(X^2 = 1.10\) 은 기준선 8 의 7 분의 1 이다. 위쪽 꼬리 확률이 \(0.9975\) 라는 말은 아래쪽 꼬리 확률이 \(0.0025\) 라는 말이다.
곧 하위 \(0.25\%\) 다. 자유도 8 의 \(1\%\) 분위가 \(1.6465\) 인데 \(1.0988\) 은 그보다도 작다.
(3) 너무 잘 맞는 것도 신호다. 자료가 참으로 귀무가설에서 나왔다면 \(X^2\) 이 하위 \(0.25\%\) 에 떨어질 확률은 400 분의 1 이다. 그런 일이 눈앞에 있다면 둘 중 하나다.
- 우연히 아주 잘 맞았다. 400 번에 한 번은 일어난다.
- 자료가 "맞도록" 만들어졌다. 여기서는 후자다. 세 열을 손으로 비슷하게 적어 넣었으니 무작위 변동이 있어야 할 만큼 들어 있지 않다.
이 "너무 좋은 적합" 검사는 실제 자료 조작을 찾아내는 데 쓰인다. 멘델의 완두콩 자료가 그 유명한 예다. 적합도 검정은 보통 위쪽 꼬리만 보지만, 아래쪽 꼬리도 뜻이 있다.
두 나라 비교 (US 대 Canada)
보기 4. 두 나라만 비교하기. 전체 검정은 "세 나라가 모두 같은가" 에만 답한다. 어느 쌍이 다른지는 쌍마다 따로 보아야 한다.
(1) US 와 Canada 만 남기면 열이 둘인 \(5\times2\) 표가 된다. 독립성 검정 보기 1 에서 얻은 \(r\times2\) 닫힌 꼴
으로 통계량을 구하고 코드와 맞추시오.
(2) 세 쌍을 모두 계산하시오. 세 쌍의 \(X^2\) 을 더하면 전체 검정의 \(212.94\) 가 되는가. 왜 그런가.
(3) 세 쌍을 모두 검정했으므로 다중비교(multiple comparisons) 보정이 필요하다. 본페로니로 보정하면 US–Canada 의 결론이 어떻게 바뀌는가.
풀이
(1) 열이 둘이면 닫힌 꼴이 쓰인다. US 와 Canada 만 남긴 표의 주변합은 행 합 \(616,\ 569,\ 875,\ 332,\ 84\), 열 합 \(C_1 = 2165\)(US), \(C_2 = 311\)(Canada), 총합 \(n = 2476\) 이다. 각 행의 불일치는
하나로 묶이고(열이 둘이므로 둘째 칸은 \(-d_i\)), 그 값은 차례로
이다. \(\sum_i d_i = 0\) 이어야 하고 실제로 그렇다. 그러면
자유도는 \((5-1)(2-1) = 4\) 다. 다섯 항 가운데 마지막(별 1개)이 \(0.84985\) 로 전체의 \(66\%\) 다. Canada 의 별 1개가 기대 \(10.55\) 명에 대해 19 명이었던 것이 US–Canada 차이의 거의 전부다. 행 합 84 로 나누기 때문에 작은 행의 불일치가 크게 친다.
(2)·(3) 수치적으로.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

def main():
    """열을 둘로 줄여 두 나라만 견준다."""
    observed = np.array([[541, 75], [498, 71], [779, 96], [282, 50], [65, 19]])

    statistic, p_value, df, expected = stats.chi2_contingency(observed)
    print(f"{statistic = :.02f}")
    print(f"{p_value   = :.02%}")
    print("expected")
    print(expected)

if __name__ == "__main__":
    main()
출력:
statistic = 11.73
p_value   = 1.95%
expected
[[538.62681745  77.37318255]
 [497.53029079  71.46970921]
 [765.09491115 109.90508885]
 [290.29886914  41.70113086]
 [ 73.44911147  10.55088853]]
세 나라 중 둘만 놓고 비교하면 \(X^2\)이 212.94에서 11.73으로 뚝 떨어진다. (1)에서 손으로 얻은 \(11.7255\) 와 코드의 11.73 이 맞고, 기대도수의 최소 \(10.55\) 도 경험칙을 만족한다.
앞의 큰 통계량이 어디서 왔는지 세 쌍을 모두 보면 분명해진다.
import itertools
import numpy as np
from scipy import stats

O = np.array([[541, 75, 231], [498, 71, 213],
              [779, 96, 321], [282, 50, 345], [65, 19, 120]])
names = ["US", "Canada", "Mexico"]

print("쌍마다 열 둘만 남겨 다시 검정한다 (df = 4)")
total = 0.0
for i, j in itertools.combinations(range(3), 2):
    res = stats.chi2_contingency(O[:, [i, j]])
    total += res.statistic
    print(f"  {names[i]:>6s} - {names[j]:<6s}  chi2 = {res.statistic:8.4f}   "
          f"p = {res.pvalue:9.3g}   최소기대 {res.expected_freq.min():6.2f}")
print(f"\n세 쌍의 합 {total:.4f}   전체 검정 212.9356")
print(f"본페로니 임계 p = 0.05/3 = {0.05 / 3:.4f}")
출력:
쌍마다 열 둘만 남겨 다시 검정한다 (df = 4)
      US - Canada  chi2 =  11.7255   p =    0.0195   최소기대  10.55
      US - Mexico  chi2 = 210.5657   p =  2.01e-44   최소기대  67.03
  Canada - Mexico  chi2 =  27.2786   p =  1.75e-05   최소기대  28.05

세 쌍의 합 249.5698   전체 검정 212.9356
본페로니 임계 p = 0.05/3 = 0.0167
Mexico 가 범인이다. US–Mexico 만으로 \(210.57\) 이고, 전체 \(212.94\) 의 거의 전부다. 보기 1 (3)에서 Mexico 열의 기여가 \(136.62\) 로 가장 컸던 것과 같은 이야기다.
세 쌍의 합 \(249.57\) 은 전체 \(212.94\) 와 같지 않다. 같을 이유가 없다. 쌍마다 총합과 합동 분포가 달라진다. US–Canada 쌍에서는 \(n = 2476\), Mexico 가 들어간 쌍에서는 \(n\) 이 각각 \(3395\), \(1541\) 이다. 기준선이 쌍마다 다르므로 세 수는 서로 다른 표에 대한 통계량이고, 더해서 전체가 되는 분해가 아니다. 진짜 분해를 원하면 자유도를 쪼개는 직교 대비를 써야 하고, 그러면 세 쌍이 아니라 두 개의 독립 대비만 잡을 수 있다(\(\text{df} = 8 = 4 + 4\)).
(3) 본페로니. 세 쌍을 모두 검정했으므로 쌍별 유의수준을 \(0.05/3 = 0.0167\) 로 내린다. US–Mexico 와 Canada–Mexico 는 \(p\) 가 \(10^{-5}\) 보다 작아 그대로 유의하지만, US–Canada 는 \(p = 0.0195 > 0.0167\) 이 되어 유의성을 잃는다. 보정 전에는 "5% 수준에서 기각" 이던 것이 보정 후에는 기각되지 않는다. 사후비교(post hoc comparison)의 보정 방법과 그 함정은 연습문제 8 이 자세히 다룬다.
보기 5. 좋아하는 과목과 주로 쓰는 손. 오른손잡이 60명과 왼손잡이 40명을 각각 무작위로 뽑아 선호 과목을 물었다. 두 집단의 표본 크기를 미리 정했으므로 전형적인 동질성 설계다.
| 오른손 | 왼손 | 합계 | |
|---|---|---|---|
| STEM | 30 | 10 | 40 |
| 인문학 | 15 | 25 | 40 |
| 같음 | 15 | 5 | 20 |
| 합계 | 60 | 40 | 100 |
(1) 기대도수가 모두 정수로 딱 떨어진다. 왜 그런가.
(2) \(r\times2\) 닫힌 꼴로 \(X^2\) 을 유리수로 구하시오. 자유도 2 에서는 p 값에도 닫힌 꼴이 있다.
(3) 크라메르 \(V\) 로 효과크기를 재고, 보기 1 의 \(V = 0.17\) 과 견주시오. 관측값이 100 개뿐인데도 강하게 기각되는 까닭이 거기 있다.
풀이
가설. \(H_0\) 은 오른손잡이와 왼손잡이의 과목 선호 분포가 같다는 것, \(H_a\) 는 다르다는 것이다.
(1) 주변합이 100 을 깔끔하게 나눈다. \(E_{ij} = R_i C_j / n\) 에서 \(n = 100\) 이고 행 합이 \(40, 40, 20\), 열 합이 \(60, 40\) 이다. 분자 \(R_i C_j\) 가 언제나 \(100\) 의 배수이므로
가 정수 행렬이 된다. 1 행과 2 행의 행 합이 둘 다 40 이라 기대도수도 같은 것 역시 눈여겨볼 만하다. 기대표는 주변합만 보기 때문이다.
(2) 유리수로. 열이 둘이므로 행마다 불일치가 하나다.
\(d_1 + d_2 + d_3 = 0\) 으로 열 합이 보존된다. 닫힌 꼴에 넣는다.
정의대로 더해도 같다. \(1.5 + 2.25 + 3.375 + 5.0625 + 0.75 + 1.125 = 14.0625\) 다.
자유도는 \((3-1)(2-1) = 2\) 이고, 자유도 2 의 꼬리확률은 \(P(\chi^2_2 \ge t) = e^{-t/2}\) 이므로
이다. \(p < 0.001\) 이므로 강하게 기각한다.
(3) 효과크기. \(\min(r-1, c-1) = 1\) 이므로
정확히 \(0.375\) 다. 보기 1 의 병원 자료는 \(n = 3706\) 이나 되는데 \(V = 0.17\) 이었다. 여기는 \(n = 100\) 뿐인데 \(V = 0.375\) 로 두 배 넘게 강하다. \(X^2 = nV^2\min(r-1,c-1)\) 이므로 작은 표본으로도 강하게 기각되는 것은 효과가 그만큼 크기 때문이다.
수치적으로.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

def main():
    observed = np.array([[30, 10], [15, 25], [15, 5]])

    statistic, p_value, df, expected = stats.chi2_contingency(observed)
    print(f"{statistic = :.02f}")
    print(f"{p_value   = :.04f}")
    print(f"\nExpected frequencies:")
    print(expected)

    _, ax = plt.subplots(figsize=(12, 4))

    x = np.linspace(0, statistic)
    y = stats.chi2(df).pdf(x)
    ax.plot(x, y, color='b', linewidth=3)

    x = np.concatenate([[0], x, [statistic], [0]])
    y = np.concatenate([[0], y, [0], [0]])
    ax.fill(x, y, color='b', alpha=0.1)

    x = np.linspace(statistic, 20, 100)
    y = stats.chi2(df).pdf(x)
    ax.plot(x, y, color='r', linewidth=3)

    x = np.concatenate([[statistic], x, [20], [statistic]])
    y = np.concatenate([[0], y, [0], [0]])
    ax.fill(x, y, color='r', alpha=0.1)

    xy = (15.0, 0.01)
    xytext = (16.5, 0.10)
    arrowprops = dict(color='k', width=0.2, headwidth=8)
    ax.annotate(f'{p_value = :.04f}', xy, xytext=xytext, fontsize=15, arrowprops=arrowprops)

    ax.spines['right'].set_visible(False)
    ax.spines['top'].set_visible(False)
    ax.spines['bottom'].set_position("zero")
    ax.spines['left'].set_position("zero")

    plt.show()

if __name__ == "__main__":
    main()
출력:
statistic = 14.06
p_value   = 0.0009

Expected frequencies:
[[24. 16.]
 [24. 16.]
 [12.  8.]]
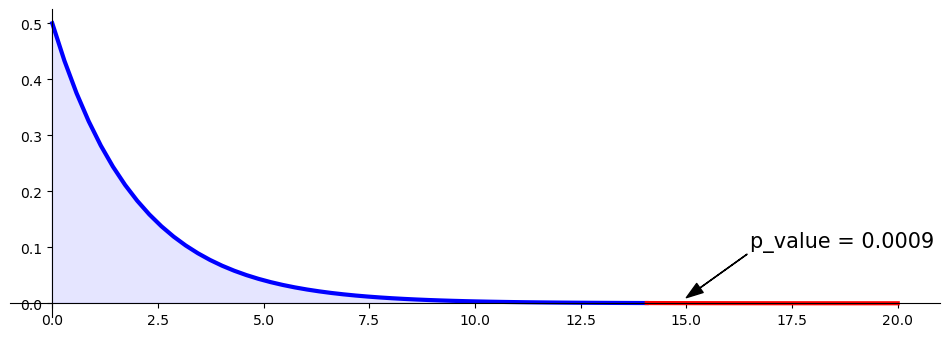
statistic = 14.06 과 p_value = 0.0009 가 (2)의 \(225/16 = 14.0625\) 와 \(e^{-7.03125} = 0.00088383\) 과 맞고, 기대도수 행렬도 (1)에서 손으로 적은 정수 행렬과 글자 하나까지 같다.
관측값이 100개뿐인데도 강하게 기각된다. STEM에서 오른손잡이가 기대 24에 대해 30, 인문학에서 왼손잡이가 기대 16에 대해 25로 불일치가 크기 때문이다. 칸별 기여를 보면 인문학·왼손 칸이 \(81/16 = 5.0625\) 로 가장 크고 전체 \(14.0625\) 의 \(36\%\) 다.
기대도수가 모두 정수로 딱 떨어진 것은 우연이 아니다. 행 합계가 40, 40, 20이고 열 합계가 60, 40이며 총합이 100이라 \(R_i C_j / n\)이 언제나 정수가 된다.
3. 귀무가설은 세 선이 겹친다는 말이다
동질성의 귀무가설을 식이 아니라 그림으로 읽어 두면 검정이 무엇을 재는지가 한눈에 들어온다. 모집단 셋, 범주 넷인 작은 표로 본다.
보기 6. 동질성 검정 — 기본 예. 모집단 세 곳에서 각각 100 명을 뽑아 네 범주 중 하나로 응답을 받았다.
(1) 세 행의 기대도수가 완전히 같다. 왜 그런지 설명하고 기대도수를 유리수로 구하시오.
(2) \(X^2\) 을 유리수로 구하고 자유도와 p 값을 구해 \(\alpha = 0.05\) 에서 판정하시오.
(3) 칸별 기여와 잔차로 어디가 어긋났는지 찾으시오. 크라메르 \(V\) 로 효과크기도 재시오.
풀이
(1) 행 합이 모두 같으면 기대행도 같다. 동질성의 기대도수는
곧 "모집단 \(i\) 의 표본 크기에 합동 비율을 곱한 것" 이다. 여기서는 \(R_1 = R_2 = R_3 = 100\) 이고 \(n = 300\) 이므로
가 되어 \(i\) 가 사라진다. 세 행이 글자 하나까지 같은 것이 그 때문이다.
합동 비율로 적으면 \((0.243333,\ 0.256667,\ 0.233333,\ 0.266667)\) 이다. 귀무가설은 "세 모집단의 응답 비율이 모두 이 네 수와 같다" 는 말이다.
(2) 통계량. 기대도수의 분모가 모두 3 이므로 유리수 계산이 끝까지 깔끔하다. 열두 칸을 모두 더하면
이고 자유도는 \((3-1)(4-1) = 6\) 이다. p 값은
이고 임계값은 \(\chi^2_{6,\,0.05} = 12.5916\) 이다. \(14.17 > 12.59\) 이고 \(p < 0.05\) 이므로 기각한다. 적어도 한 모집단의 응답 분포가 다르다.
수치적으로.
import numpy as np
from scipy import stats

# 모집단 3개(행), 범주 4개(열)
# 동질성 검정과 독립성 검정은 **계산이 완전히 같다**. 다른 것은 표집 설계뿐이다.
# 여기서는 모집단마다 표본을 따로 뽑았으므로 행 합계가 설계자에 의해 고정되어 있다.
observed = np.array([
    [25, 30, 20, 25],   # 모집단 1
    [18, 22, 35, 25],   # 모집단 2
    [30, 25, 15, 30],   # 모집단 3
], dtype=float)

chi2, p, df, expected = stats.chi2_contingency(observed, correction=False)

print("=== Chi-square Test of Homogeneity (scipy) ===")
print(f"chi2 = {chi2:.4f}, df = {df}, p = {p:.6f}")
print()
print("Expected counts under H0 (same proportions):")
print(expected)
출력:
=== Chi-square Test of Homogeneity (scipy) ===
chi2 = 14.1697, df = 6, p = 0.027796

Expected counts under H0 (same proportions):
[[24.33333333 25.66666667 23.33333333 26.66666667]
 [24.33333333 25.66666667 23.33333333 26.66666667]
 [24.33333333 25.66666667 23.33333333 26.66666667]]
세 행의 기대도수가 완전히 같다. 세 모집단의 표본크기가 모두 100으로 같고 \(H_0\)이 "분포가 같다"이므로 그럴 수밖에 없다. 출력의 24.33333333 등이 (1)의 \(73/3\) 과 맞고, chi2 = 14.1697, df = 6, p = 0.027796 이 (2)의 손계산과 맞는다.
(3) 어디가 어긋났는가. 전체 검정은 "적어도 한 모집단이 다르다" 까지만 말한다. 칸별로 쪼개 본다.
import numpy as np

O = np.array([[25, 30, 20, 25],
              [18, 22, 35, 25],
              [30, 25, 15, 30]], dtype=float)
R, C, n = O.sum(1), O.sum(0), O.sum()
E = np.outer(R, C) / n
contrib = (O - E) ** 2 / E
pearson = (O - E) / np.sqrt(E)
adj = (O - E) / np.sqrt(E * (1 - R[:, None] / n) * (1 - C[None, :] / n))

for name, M in [("칸별 기여  (O-E)^2/E", contrib),
                ("피어슨 잔차  (O-E)/sqrt(E)", pearson),
                ("조정 잔차", adj)]:
    print(name)
    for i, row in enumerate(M):
        print(f"  모집단 {i + 1}  " + " ".join(f"{v:+8.4f}" for v in row))
print("\n열별 기여 합  " + " ".join(f"{v:8.4f}" for v in contrib.sum(0)))
print(f"전체 chi2 = {contrib.sum():.4f}   가장 큰 칸의 몫 "
      f"{contrib.max() / contrib.sum():.3f}   범주 3 열의 몫 "
      f"{contrib.sum(0)[2] / contrib.sum():.3f}")
print(f"크래머 V = {np.sqrt(contrib.sum() / (n * 2)):.4f},   최소 기대도수 {E.min():.4f}")
출력:
칸별 기여  (O-E)^2/E
  모집단 1   +0.0183  +0.7316  +0.4762  +0.1042
  모집단 2   +1.6484  +0.5238  +5.8333  +0.1042
  모집단 3   +1.3196  +0.0173  +2.9762  +0.4167
피어슨 잔차  (O-E)/sqrt(E)
  모집단 1   +0.1351  +0.8553  -0.6901  -0.3227
  모집단 2   -1.2839  -0.7237  +2.4152  -0.3227
  모집단 3   +1.1488  -0.1316  -1.7252  +0.6455
조정 잔차
  모집단 1   +0.1903  +1.2150  -0.9652  -0.4616
  모집단 2   -1.8077  -1.0281  +3.3783  -0.4616
  모집단 3   +1.6174  -0.1869  -2.4131  +0.9232

열별 기여 합    2.9863   1.2727   9.2857   0.6250
전체 chi2 = 14.1697   가장 큰 칸의 몫 0.412   범주 3 열의 몫 0.655
크래머 V = 0.1537,   최소 기대도수 23.3333
범주 3 한 열이 전부다. 그 열의 기여 합이 \(9.2857\) 로 전체 \(14.1697\) 의 \(65.5\%\) 이고, 그중 모집단 2 의 칸 하나가 \(5.8333\) 으로 \(41.2\%\) 다. 기대 \(23.3\) 에 대해 35 가 관측되었다. 모집단 3 은 반대로 \(15\) 로 내려앉아 \(2.9762\) 를 보탠다. 범주 3 에서 모집단 2 와 3 이 서로 반대 방향으로 벌어진 것이 기각의 이유다.
잔차는 방향까지 알려 준다. 피어슨 잔차 \((O-E)/\sqrt E\) 가 모집단 2·범주 3 에서 \(+2.4152\), 모집단 3·범주 3 에서 \(-1.7252\) 다. 다만 피어슨 잔차는 분산을 과대평가한다. 주변합이 고정되어 있어 실제 분산이 \(E_{ij}\) 보다 \((1-R_i/n)(1-C_j/n)\) 배 작기 때문이다. 그 보정을 넣은 조정 잔차는 각각 \(+3.3783\) 과 \(-2.4131\) 이 된다. 다만 칸이 열둘이므로 \(\pm 1.96\) 을 그대로 대면 안 된다 — 본페로니 기준 \(2.8653\) 으로 보면 살아남는 것은 \(+3.3783\) 하나다(11.2절 기각한 뒤: 칸별 잔차 분석이 그 셈을 끝까지 따라간다). 피어슨 잔차만 보았다면 \(-1.7252\) 를 "유의하지 않다" 고 넘겼을 것이다.
\(p = 0.0278\)로 기각한다. 가장 크게 어긋난 곳은 모집단 2의 범주 3으로, 기대 23.3에 대해 35가 관측되었다.
다만 효과크기는 작다. 크라메르 \(V = 0.1537\) 이다(출력의 「크래머 V」가 이 값이다). \(X^2 = nV^2\min(r-1,c-1)\) 이므로 \(n = 300\) 이 통계량을 끌어올린 몫이 크다. 최소 기대도수가 \(23.33\) 으로 타당성 조건은 넉넉히 충족된다.
주요 출력은 이렇다.
chi2_contingency는 값 네 개를 돌려준다: 검정통계량, p 값, 자유도, 기대도수 행렬.correction=False로 두면 예이츠 보정이 적용되지 않는다(어차피 예이츠는 \(2 \times 2\) 표에만 의미가 있다).
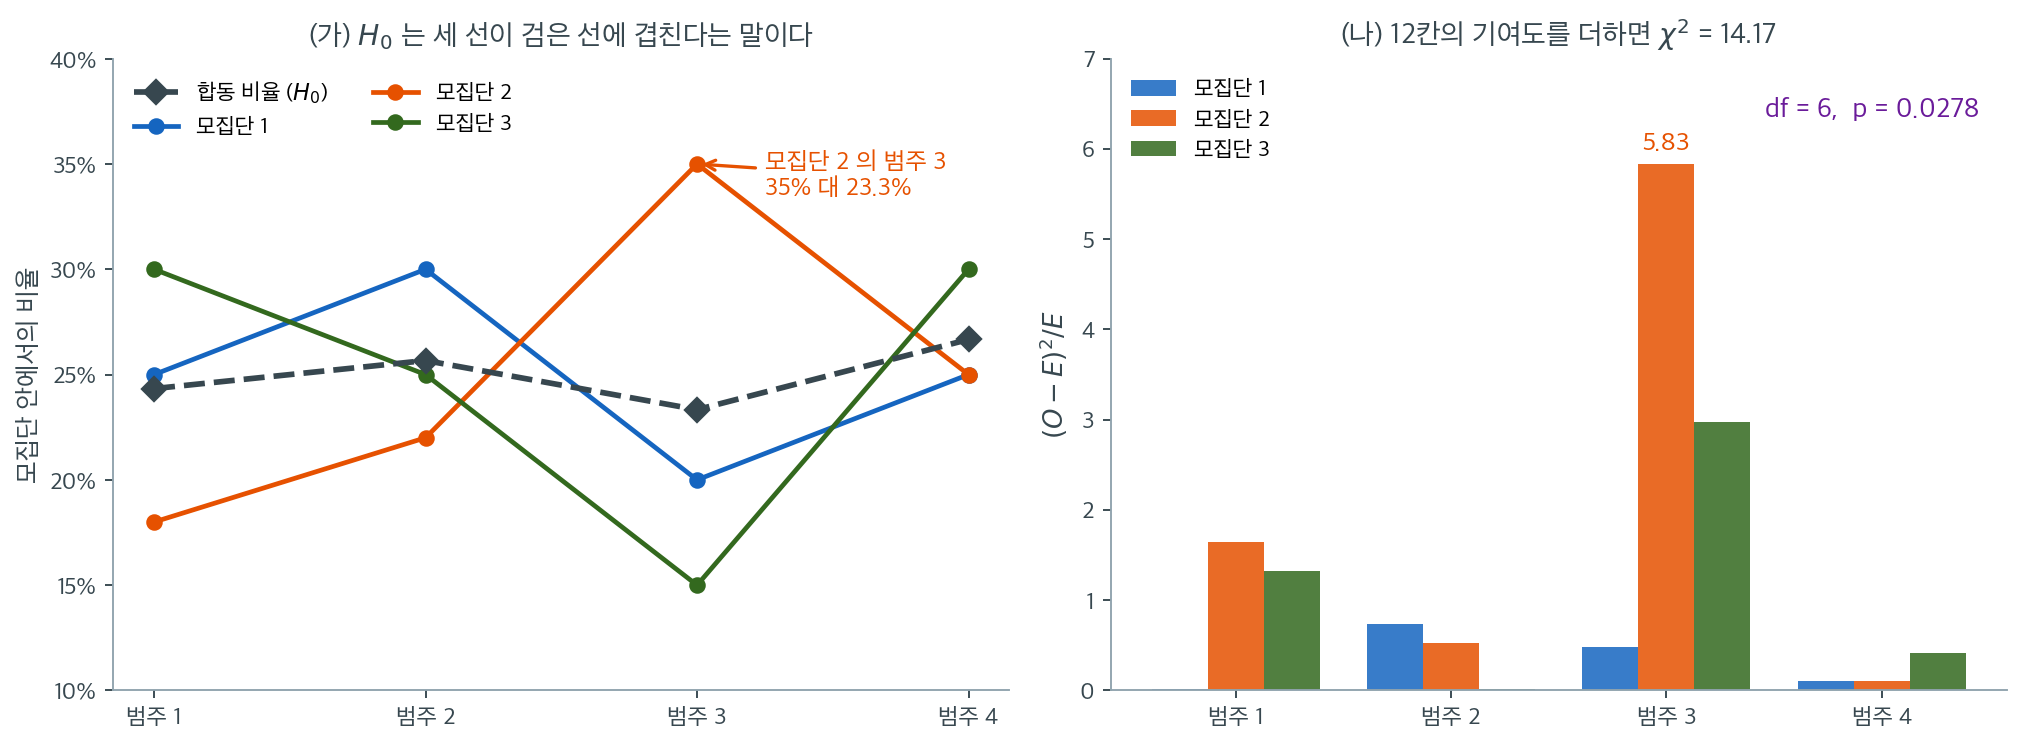
왼쪽 (가)는 세 모집단의 범주별 비율을 선으로 이은 것이다. 검은 파선이 합동 비율, 즉 24.3%, 25.7%, 23.3%, 26.7%이다. 동질성의 귀무가설은 "세 색깔 선이 모두 이 검은 선 위에 놓인다"는 말과 같다. 표를 숫자로 들여다볼 때보다 이렇게 그려 놓으면 \(H_0\)가 무엇을 주장하는지가 훨씬 분명해진다.
실제로는 세 선이 제법 벌어져 있다. 범주 3에서 모집단 2가 35%로 솟아 있고 모집단 3은 15%로 내려앉았다. 검은 선은 그 사이 23.3%에 있다. 범주 4에서는 세 선이 25%, 25%, 30%로 거의 붙어 있다. 불일치가 표 전체에 고르게 퍼져 있는 것이 아니라 특정 칸에 몰려 있다는 뜻이다.
오른쪽 (나)가 그 몰림을 정량화한다. 12칸의 \((O-E)^2/E\)를 모두 그렸고, 이들을 더한 것이 \(X^2 = 14.17\)이다. 가장 큰 막대는 모집단 2의 범주 3으로 5.83이며, 이 한 칸이 통계량의 41%를 차지한다. 그다음이 모집단 3의 범주 3으로 2.98이다. 즉 검정이 기각된 이유는 거의 전부 "범주 3에서 모집단 2와 3이 반대 방향으로 벌어진 것"이다.
자유도는 \((3-1)(4-1) = 6\)이고 \(p = 0.0278\)로 5% 수준에서 기각한다. 하지만 검정이 말해 주는 것은 여기까지다. "적어도 한 모집단이 다르다"를 넘어 "어디가 어떻게 다른가"를 말하려면 이 오른쪽 그림처럼 칸별로 분해해 보아야 하고, 방향까지 읽으려면 부호가 살아 있는 표준화 잔차 \((O-E)/\sqrt{E}\)를 본다. 모집단 2의 범주 3은 \(+2.42\), 모집단 3의 범주 3은 \(-1.73\)이다.
AI로 보는 통계학 1. 분포가 움직였는가
배포된 모형은 늘 같은 물음을 받는다 — 지금 들어오는 자료가 학습할 때와 같은 분포인가. 입력을 칸으로 나누어 기준 시점의 비율 \(q\) 와 지금의 비율 \(p\) 를 견주는 일이니, 이 쪽의 동질성 검정과 같은 물음이다.
그런데 업계는 \(X^2\) 나 \(G^2\) 를 쓰지 않는다. PSI(모집단 안정성 지수)라는 것을 쓴다.
두 쿨백–라이블러 발산을 양쪽으로 더한 것이다. 이 쪽의 가능도비(likelihood ratio) 통계량과 나란히 놓아 보자.
다른 것은 \(n\) 하나뿐이다. PSI 에는 표본 수가 들어 있지 않다.
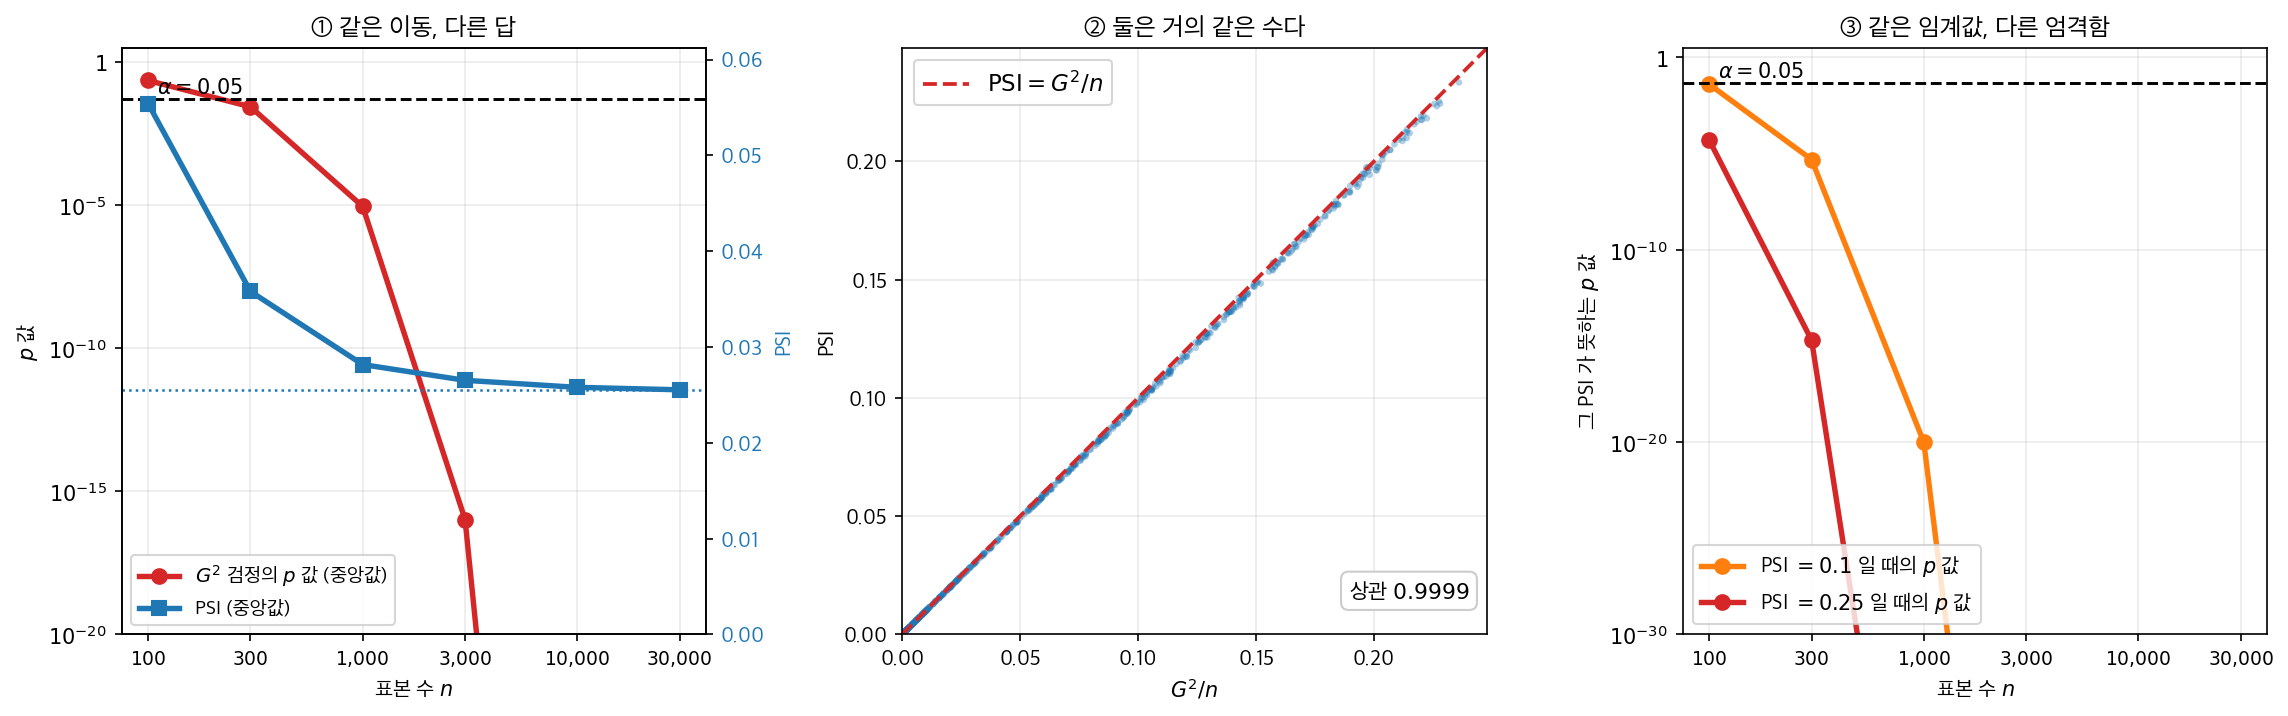
칸 다섯 개짜리 표집분포에서 가운데 질량 \(0.06\) 을 바깥으로 옮겨 참 PSI 가 \(0.0255\) 인 이동을 만들어 두고, 표본 수만 바꿔 가며 둘을 재었다.
- ① \(G^2\) 검정의 \(p\) 값이 \(n = 100\) 에서 \(0.23\) 이었다가 \(n = 30{,}000\) 에서 \(2 \times 10^{-167}\) 이 된다. 자료는 똑같이 움직였는데 검정의 답이 \(165\) 자릿수를 건넜다. 같은 자리에서 PSI 는 \(0.0255\) 에 그대로 앉아 있다.
- ② 둘은 사실 같은 수다. \(\mathrm{PSI}\) 와 \(G^2/n\) 의 상관이 \(0.9999\) 이고 기울기가 \(0.99\) 다 (\(D_{\mathrm{KL}}(p\|q) \approx D_{\mathrm{KL}}(q\|p)\) 인 작은 이동에서 \(\mathrm{PSI} \approx 2D_{\mathrm{KL}} = G^2/n\) 이기 때문이다). \(n\) 으로 나눈 것이 PSI 다.
- ③ 그러니 업계가 쓰는 임계값 — PSI \(< 0.1\) 이면 움직이지 않은 것, \(0.1\)–\(0.25\) 는 조금 움직인 것, \(0.25\) 를 넘으면 크게 움직인 것 — 은 \(n\) 마다 전혀 다른 엄격함이 된다. PSI \(= 0.1\) 이 \(n = 100\) 에서는 \(p = 0.04\) 인데 \(n = 10{,}000\) 에서는 \(p = 10^{-215}\) 다.
여기서 어느 쪽이 옳으냐고 물으면 안 된다. 둘은 다른 물음에 답한다. \(G^2\) 는 「이 이동이 우연일 수 있는가」를 묻고, PSI 는 「이 이동이 신경 쓸 만한 크기인가」를 묻는다. 요청이 하루 수천만 건씩 들어오는 자리에서는 앞의 물음이 늘 「아니다」로 끝나 쓸모가 없어진다. \(n\) 을 일부러 지운 것이 PSI 의 설계다.
이 쪽이 가르치는 것은 앞의 물음이고, 그것이 틀린 물음이어서가 아니라 \(n\) 이 작을 때 쓰라고 만든 것이기 때문이다. 병원 두 곳의 환자 \(200\) 명을 견줄 때는 \(G^2\) 가 맞고, 사용자 천만 명의 입력 분포를 날마다 지켜볼 때는 \(n\) 을 지운 척도가 맞다. 같은 식의 두 얼굴이다.
확인한 곳 — PSI 의 정의 \(\sum (p_i-q_i)\ln(p_i/q_i)\) 와 신용평가 쪽에서 널리 쓰는 임계값 (\(0.1\) 미만·\(0.1\)–\(0.25\)·\(0.25\) 초과)은 업계 표준 관행으로, 「A critical review of existing and new population stability testing procedures in credit risk scoring」(arXiv:\(2303.01227\)) 을 비롯한 여러 개관 문헌이 그렇게 정리하고 있다. 그 정의가 제프리스 발산 \(D_{\mathrm{KL}}(p\|q) + D_{\mathrm{KL}}(q\|p)\) 와 같다는 것과 \(G^2 = 2nD_{\mathrm{KL}}(p\|q)\) 는 식에서 바로 나오며, 그림의 수는 모두 직접 계산한 값이다
연습문제
연습문제 1. 여러 모집단의 동질성. 세 약을 비교한다: A (60/100), B (55/100), C (45/100). 세 약의 성공률이 모두 같은지 검정하라.
풀이
표: 성공 행 = (60, 55, 45), 실패 행 = (40, 45, 55). 총합 = 300, 성공 합계 = 160.
합동 \(\hat p_{\text{success}} = 160/300 \approx 0.533\).
집단별 기대도수: 성공 53.33, 실패 46.67.
\(X^2 = \sum (O - E)^2/E\):
- A: \((60-53.33)^2/53.33 + (40-46.67)^2/46.67 \approx 0.834 + 0.953 = 1.787\).
- B: \((55-53.33)^2/53.33 + (45-46.67)^2/46.67 \approx 0.052 + 0.060 = 0.112\).
- C: \((45-53.33)^2/53.33 + (55-46.67)^2/46.67 \approx 1.302 + 1.488 = 2.790\).
전체 \(X^2 \approx 4.69\). df \(= (3-1)(2-1) = 2\). 임계값 \(\chi^2_{0.95,\,2} = 5.99\). 5% 수준에서 기각하지 못한다.
약 C의 성공률이 눈에 띄게 낮지만(45% 대 60%) 검정은 유의성에 이르지 못한다.
연습문제 2. 동질성 검정의 전체 분석 흐름을 정리하라.
풀이
흐름.
여러 집단의 분포가 같은지 묻는다
    │
    ├─ ① 표집 설계 확인
    │     ├─ 집단별로 따로 표집 → 동질성 검정
    │     ├─ 한 표본을 두 변수로 분류 → 독립성 검정 (계산은 같다)
    │     └─ 같은 개체를 반복 측정 → McNemar / 코크런 Q
    │
    ├─ ② 독립성 확인
    │     └─ 군집 구조가 있으면 DEFF 보정 (연습문제 10)
    │
    ├─ ③ 집단에 순서가 있는가
    │     ├─ 예, 단조 관계 예상 → 추세검정 (연습문제 9)
    │     └─ 아니오 → 일반 동질성 검정
    │
    ├─ ④ 기대도수 확인 → 필요하면 병합·정확검정
    │
    ├─ ⑤ 옴니버스 검정
    │     └─ 기각 못 하면 여기서 멈춘다
    │
    ├─ ⑥ 사후분석 (연습문제 8)
    │     ├─ 쌍별 비교 + 다중비교 보정
    │     └─ 또는 조정 표준화 잔차
    │
    └─ ⑦ 효과크기 + 신뢰구간 + 원 도수표
동질성과 독립성의 차이 — 한 번 더.
| 동질성 | 독립성 | |
|---|---|---|
| 표집 | 집단마다 따로, 행 합이 고정 | 한 표본, 총합만 고정 |
| 귀무가설 | 집단별 조건부 분포가 같다 | 두 변수가 독립 |
| 계산 | 완전히 같다 | 완전히 같다 |
| 해석 | "집단이 결과에 영향을 주는가" | "두 특성이 연관되는가" |
계산이 같으므로 소프트웨어도 같은 함수를 쓴다. 다른 것은 연구 설계와 결론의 서술뿐이다.
보고 점검 목록.
- [ ] 표집 설계를 명시했는가(집단별 표집인지)
- [ ] 원 도수표를 실었는가
- [ ] 행 백분율을 함께 보였는가
- [ ] 기대도수의 최솟값을 보고했는가
- [ ] \(X^2\), df, \(p\)
- [ ] 효과크기(크라메르 \(V\))와 신뢰구간
- [ ] 사후분석을 했다면 보정 방법을 밝혔는가
- [ ] 군집 구조가 없음을 확인했는가
자주 하는 실수 다섯.
| 실수 | 대가 |
|---|---|
| 옴니버스 기각 전에 사후비교 | 일관성 없는 결론(연습문제 8) |
| 사후비교에 보정 없음 | FWER 팽창 |
| 순서형 집단에 일반 검정 | 검정력 손실(연습문제 9) |
| 군집 자료를 개인 단위로 | 수준이 0.35까지(연습문제 10) |
| \(p\)만 보고, 효과크기 누락 | \(n\)이 크면 언제나 유의 |
한 문장. 동질성 검정은 "어느 집단이 어떻게 다른가"로 가는 관문일 뿐이다. 옴니버스 \(p\) 값 하나로 끝내면 자료가 가진 정보의 대부분을 버리는 셈이다.
연습문제 3. 약 A: 100명 중 60명 성공. B: 100명 중 55명 성공. (a) 교란변수를 어떻게 통제하는가? (b) \(z\)-검정. (c) \(\chi^2\) 검정. 두 검정이 동치임을 보여라.
풀이
(a) 참가자를 A 또는 B에 무작위 배정한다. 무작위 배정은 교란변수(나이, 성별, 중증도)를 기댓값 수준에서 두 집단에 균형 있게 배분한다.
(b) 합동 \(\hat p = 115/200 = 0.575\). \(\mathrm{SE} = \sqrt{0.575 \cdot 0.425 \cdot (1/100 + 1/100)} \approx 0.0699\).
\(z = (0.60 - 0.55)/0.0699 \approx 0.715\). \(|z| < 1.96\)이므로 기각하지 못한다.
(c) 기대도수: 성공 칸은 모두 57.5, 실패 칸은 모두 42.5. \(X^2 = 2 \cdot (2.5)^2/57.5 + 2 \cdot (2.5)^2/42.5 \approx 0.512\). \(0.512 < 3.84\)이므로 기각하지 못한다.
동치성: \(z^2 = 0.715^2 = 0.511 \approx X^2\). \(2 \times 2\) 표에서 \(\chi^2\) 검정은 비율에 대한 양측 \(z\)-검정과 동치이다.
연습문제 4. 동질성 검정과 독립성 검정. 차이는 무엇인가?
풀이
둘 다 같은 통계량과 같은 자유도의 카이제곱을 쓴다. 차이는 표집 설계에 있다.
동질성: 한 변수의 주변합이 고정된다(예: \(n_A = n_B = 100\)을 미리 정한다). 다른 변수의 분포가 행들 사이에서 같은지 검정한다.
독립성: 전체 \(n\)만 고정되고 칸 도수는 무작위로 배분된다. 두 변수가 독립인지 검정한다.
수식은 같고 해석이 다르다. 표본크기를 미리 정한 약물시험은 동질성이고, 고객 선호에 대한 관찰연구는 독립성이다.
실무적으로 계산상 구분되지 않지만, 설계 가정 때문에 개념적으로는 구별된다.
연습문제 5. 동질성을 기각한 뒤의 사후분석. 무엇이 권장되는가?
풀이
전체 카이제곱이 \(H_0\)을 기각한 뒤에는 어느 집단이 다른지 찾는다.
선택지는 이렇다.
- 본페로니 보정을 적용한 쌍별 카이제곱: 집단이 3개면 쌍별 검정 3개를 \(\alpha/3\)에서 수행한다.
- 조정 잔차: \(r_{ij} = (O - E)/\sqrt{E \cdot (1 - p_i)(1 - p_j)}\). \(|r| > 2\)이면 그 칸이 유의하다.
- 관심 있는 특정 집단 사이의 두 비율 z-검정.
중요: 여러 비교를 할 때에는 가족단위 오류율(familywise error rate)이나 거짓발견율(false discovery rate)을 통제해야 한다.
앞의 두 가지는 다음 절 기각한 뒤: 칸별 잔차 분석이 끝까지 따라간다 — 표준화 잔차와 조정 잔차 가운데 어느 쪽이 정말 \(N(0,1)\) 인지, 칸마다 보정하면 유의한 칸이 남는지, 그리고 주변합이 치우쳤을 때 잔차가 어떻게 오도하는지다.
연습문제 6. 대응/짝지은 이진 자료에 대한 McNemar 검정. 정의하고 카이제곱과 대비하라.
풀이
상황: 같은 대상을 두 번 측정한다(전/후, 평가자 두 명). 결과는 이진이다.
짝지어 세면 네 칸이 된다.
| 이후 + | 이후 − | |
|---|---|---|
| 이전 + | \(a\) | \(b\) |
| 이전 − | \(c\) | \(d\) |
McNemar 통계량: \(X^2 = (b - c)^2/(b + c)\), df = 1.
주변 비율이 변했는지를 검정한다(예: "처치가 성공률을 옮겼는가?").
카이제곱과의 대비: 독립성 카이제곱은 관측값이 독립이라고 가정한다. McNemar는 짝지음을 반영하여 불일치 쌍(\(b\), \(c\))만 사용한다.
예: 설문에서 동의–비동의로 바뀐 쌍, 처치 전후의 개선.
연습문제 7. 카이제곱 동질성 검정의 검정력 분석.
풀이
효과크기: \(w = \sqrt{\sum (p_{ij} - p_{ij,0})^2/p_{ij,0}}\), 여기서 \(p_{ij,0}\)은 \(H_0\) 아래의 기대 확률이다.
Cohen의 관례: \(w = 0.1\)(작음), 0.3(중간), 0.5(큼).
검정력 80%, \(\alpha = 0.05\), df = 2에 필요한 \(n\): \(\lambda \approx 9.63\), \(n = \lambda/w^2\).
작은 효과: \(n \approx 963\). 중간: \(n \approx 107\). 큰 효과: \(n \approx 39\).
statsmodels.stats.power.GofChisquarePower를 쓰거나 직접 계산한다. 표본크기 계획은 필수적이다. 응용 연구에서 검정력이 부족한 카이제곱 검정이 흔하다.
연습문제 8. 연습문제 1의 세 약(A 60/100, B 55/100, C 45/100)에 대해 연습문제 5가 말한 사후 쌍별 비교를 실제로 수행하라.
풀이
import numpy as np
from scipy import stats
from itertools import combinations
from statsmodels.stats.multitest import multipletests

table = np.array([[60, 40], [55, 45], [45, 55]], float)
labels = ["A", "B", "C"]

chi2, p, df, exp = stats.chi2_contingency(table, correction=False)
print(f"전체 동질성:  X² = {chi2:.4f},  df = {df},  p = {p:.4f}\n")

print("쌍별 비교 (보정 전)")
pvals, pairs = [], []
for i, j in combinations(range(3), 2):
    c, pp, _, _ = stats.chi2_contingency(table[[i, j]], correction=False)
    pvals.append(pp)
    pairs.append(f"{labels[i]}-{labels[j]}")
    print(f"  {labels[i]}-{labels[j]}:  X² = {c:.4f},  p = {pp:.4f}")

pvals = np.array(pvals)
print()
for method, name in [("bonferroni", "본페로니"), ("holm", "홀름  "),
                     ("fdr_bh", "BH    ")]:
    rej, adj, _, _ = multipletests(pvals, alpha=0.05, method=method)
    detail = "  ".join(f"{pairs[k]} {adj[k]:.4f}{'*' if rej[k] else ' '}"
                       for k in range(3))
    print(f"  {name}: {detail}")
전체 동질성:  X² = 4.6875,  df = 2,  p = 0.0960

쌍별 비교 (보정 전)
  A-B:  X² = 0.5115,  p = 0.4745
  A-C:  X² = 4.5113,  p = 0.0337
  B-C:  X² = 2.0000,  p = 0.1573

  본페로니: A-B 1.0000   A-C 0.1010   B-C 0.4719
  홀름  : A-B 0.4745   A-C 0.1010   B-C 0.3146
  BH    : A-B 0.4745   A-C 0.1010   B-C 0.2359
전체 검정이 \(p=0.096\)으로 기각되지 않는다. 따라서 사후분석으로 넘어가면 안 된다.
그런데 보정 전 A-C가 \(p=0.0337\)로 유의해 보인다. 이것이 사후분석의 함정이다.
| 단계 | 결과 |
|---|---|
| 옴니버스 | \(p=0.096\) — 기각 못 함 |
| A-C 보정 전 | \(p=0.034\) — "유의" |
| A-C 보정 후 | \(p=0.101\) — 기각 못 함 |
보정이 일관성을 되돌려 준다. 세 보정 모두 A-C를 0.101로 보내 옴니버스와 같은 결론에 이른다.
보호된 절차(protected procedure). "옴니버스가 기각했을 때만 사후비교를 한다"는 규칙이다. 이유는
- 전체 FWER을 대략 \(\alpha\)로 유지한다.
- 논리적 일관성을 지킨다. 전체적으로 차이가 없다고 했는데 특정 쌍에서 차이가 있다고 말하면 모순처럼 들린다.
보정 방법의 차이가 여기서 드러난다.
- 본페로니: A-B의 조정 \(p\)가 1.0000으로 잘려 나간다. \(3\times0.4745=1.42>1\)이기 때문이다.
- 홀름·BH: A-B를 0.4745로 남긴다. 가장 큰 \(p\)는 보정하지 않는 것이 두 방법의 구조다.
- 가장 작은 \(p\)(A-C)는 세 방법이 모두 0.1010으로 같다. 최솟값에 대해서는 세 방법이 일치한다.
표본이 얼마나 더 필요했을까.
def n_per_group_for(p1, p2, power=0.80, alpha=0.05):
    za, zb = stats.norm.ppf(1 - alpha / 2), stats.norm.ppf(power)
    pbar = (p1 + p2) / 2
    num = (za * np.sqrt(2 * pbar * (1 - pbar))
           + zb * np.sqrt(p1 * (1 - p1) + p2 * (1 - p2)))**2
    return int(np.ceil(num / (p1 - p2)**2))

print(f"A 대 C (0.60 대 0.45) 를 80% 로 탐지: 군당 "
      f"{n_per_group_for(0.60, 0.45)}명")
print(f"A 대 B (0.60 대 0.55) 를 80% 로 탐지: 군당 "
      f"{n_per_group_for(0.60, 0.55)}명")
A 대 C (0.60 대 0.45) 를 80% 로 탐지: 군당 173명
A 대 B (0.60 대 0.55) 를 80% 로 탐지: 군당 1534명
군당 100명은 부족했다. A와 C의 15%p 차이를 안정적으로 잡으려면 173명이 필요하다. 다중비교까지 고려하면 더 필요하다.
연습문제 9. 집단에 순서가 있을 때(예: 용량 수준) 일반적인 동질성 검정 대신 쓸 수 있는 추세검정을 구현하고 비교하라.
풀이
코크런·아미티지 추세검정. 집단에 점수 \(x_i\)를 부여하고, 성공률이 그 점수에 따라 선형으로 변하는지를 자유도 1로 검정한다.
import numpy as np
from scipy import stats

def cochran_armitage(success, total, scores=None):
    """순서형 집단에 대한 선형 추세 검정. (z, 양측 p) 를 돌려준다."""
    success = np.asarray(success, float)
    total = np.asarray(total, float)
    x = (np.arange(len(success), dtype=float) if scores is None
         else np.asarray(scores, float))
    N, S = total.sum(), success.sum()
    p_bar = S / N
    t = (success * x).sum() - p_bar * (total * x).sum()
    var = p_bar * (1 - p_bar) * ((total * x**2).sum()
                                 - (total * x).sum()**2 / N)
    z = t / np.sqrt(var)
    return z, 2 * stats.norm.sf(abs(z))

tot = [50, 50, 50, 50]
for label, succ in [("단조 증가", [10, 14, 18, 24]),
                    ("비단조(뒤섞음)", [10, 24, 14, 18])]:
    table = np.array([[s, t - s] for s, t in zip(succ, tot)], float)
    c, p, df, _ = stats.chi2_contingency(table, correction=False)
    z, pz = cochran_armitage(succ, tot)
    print(f"{label}  성공 {succ} / 각 50")
    print(f"  일반 동질성   X² = {c:.4f}, df = {df}, p = {p:.4f}")
    print(f"  추세검정      z = {z:.4f}, df = 1, p = {pz:.4f}\n")
단조 증가  성공 [10, 14, 18, 24] / 각 50
  일반 동질성   X² = 9.6789, df = 3, p = 0.0215
  추세검정      z = 3.0936, df = 1, p = 0.0020

비단조(뒤섞음)  성공 [10, 24, 14, 18] / 각 50
  일반 동질성   X² = 9.6789, df = 3, p = 0.0215
  추세검정      z = 0.9415, df = 1, p = 0.3464
두 자료의 일반 동질성 \(X^2\)이 정확히 같다(9.6789). 도수만 순서를 바꿨으므로 당연하다. 일반 검정은 집단의 순서를 전혀 모른다.
추세검정은 둘을 완전히 구분한다. 단조 자료에서 \(p=0.002\), 뒤섞은 자료에서 \(p=0.346\)이다.
검정력 비교.
rng = np.random.default_rng(1357)
M = 5_000
for label, ps in [("단조 증가 (0.20→0.44)", [0.20, 0.28, 0.36, 0.44]),
                  ("V자 (0.35,0.20,0.20,0.35)", [0.35, 0.20, 0.20, 0.35])]:
    a = b = 0
    for _ in range(M):
        s = [rng.binomial(50, q) for q in ps]
        table = np.array([[x, 50 - x] for x in s], float)
        if table.sum(0).min() > 0:
            a += stats.chi2_contingency(table, correction=False)[1] < 0.05
        b += cochran_armitage(s, [50] * 4)[1] < 0.05
    print(f"{label:>26s}:  일반 X² {a / M:.4f}   추세검정 {b / M:.4f}")
         단조 증가 (0.20→0.44):  일반 X² 0.6220   추세검정 0.7768
  V자 (0.35,0.20,0.20,0.35):  일반 X² 0.4856   추세검정 0.0592
추세가 있으면 추세검정이 압도적이다(0.777 대 0.622).
추세가 없으면 완전히 실패한다. V자 패턴에서 추세검정의 검정력이 0.059로 유의수준과 다를 바 없다. 올라갔다 내려오는 효과가 서로 상쇄되어 \(T\)가 0에 가까워지기 때문이다.
선택 기준.
| 상황 | 검정 |
|---|---|
| 집단에 순서가 있고 단조 관계를 예상 | 추세검정 |
| 순서가 있지만 모양을 모름 | 둘 다 보고(사전 지정) |
| 순서가 없음(명목형) | 일반 동질성 |
| 비단조 관계 예상(U자 등) | 일반 동질성 또는 이차항 포함 모형 |
주의 셋.
- 점수를 사전에 정한다. 용량이 0, 10, 50, 200 mg이면 \(\log\) 점수가 나을 수 있는데, 자료를 보고 고르면 안 된다.
- 자료를 보고 추세검정으로 갈아타지 않는다. 그림에서 단조로워 보인다고 바꾸면 수준이 부풀어 오른다.
- 추세가 없다고 "차이가 없다"는 아니다. V자 자료가 그 예다. 옴니버스 검정을 함께 보고한다.
연습문제 10. 동질성 검정에서 과대산포가 있으면 어떻게 되는지 확인하고, 진단과 보정 방법을 제시하라.
풀이
과대산포. 각 집단의 관측이 서로 독립인 베르누이가 아니라 군집을 이루면, 도수의 분산이 이항분포(binomial distribution)가 예측하는 것보다 크다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(2468)
M, m, n_cluster = 5_000, 10, 10      # 군당 군집 10개 × 크기 10 = 100명

print(f"{'ICC':>5s} {'DEFF':>6s} {'보정 없음':>10s} {'DEFF 로 나눔':>13s} "
      f"{'X²/df 평균':>11s}")
for icc in [0.0, 0.05, 0.10, 0.20]:
    deff = 1 + (m - 1) * icc
    a = b = 0.5 * (1 / icc - 1) if icc > 0 else None
    raw = adj = 0
    phis = []
    for _ in range(M):
        table = np.zeros((3, 2))
        for g in range(3):
            for _ in range(n_cluster):
                p_c = rng.beta(a, b) if icc > 0 else 0.5
                k = rng.binomial(m, p_c)
                table[g, 0] += k
                table[g, 1] += m - k
        if table.sum(0).min() > 0:
            chi2, p, df, _ = stats.chi2_contingency(table, correction=False)
            raw += p < 0.05
            adj += stats.chi2.sf(chi2 / deff, df) < 0.05
            phis.append(chi2 / df)
    print(f"{icc:5.2f} {deff:6.2f} {raw / M:10.4f} {adj / M:13.4f} "
          f"{np.mean(phis):11.4f}")
  ICC   DEFF      보정 없음     DEFF 로 나눔    X²/df 평균
 0.00   1.00     0.0524        0.0524      1.0084
 0.05   1.45     0.1208        0.0466      1.4339
 0.10   1.90     0.2092        0.0516      1.9139
 0.20   2.80     0.3520        0.0510      2.8554
ICC가 0.2면 수준이 0.352다. 세 집단의 비율이 모두 같은데도 35%가 "차이가 있다"고 결론짓는다.
진단은 \(X^2/\text{df}\)로 한다. 마지막 열을 보면
| ICC | DEFF | \(X^2/\text{df}\) 평균 |
|---|---|---|
| 0.00 | 1.00 | 1.008 |
| 0.05 | 1.45 | 1.434 |
| 0.10 | 1.90 | 1.914 |
| 0.20 | 2.80 | 2.855 |
\(X^2/\text{df}\)의 평균이 DEFF와 거의 정확히 일치한다. \(H_0\) 아래에서 \(E[X^2]=\text{df}\)여야 하므로, 1보다 크면 과대산포의 신호다.
보정은 그 값으로 나누는 것이다.
위에서 DEFF로 나누면 수준이 0.047~0.052로 완벽히 회복된다.
그런데 진단이 실무에서 어려운 이유. 표 하나에서 \(X^2/\text{df}\)를 재면 자유도가 작아 추정이 아주 불안정하다. 여기서는 df=2이므로 \(\hat\phi\)의 상대표준오차가 \(\sqrt{2/2}=100\%\)다. 평균은 맞지만 개별 값은 믿을 수 없다.
그래서 실제로는 이렇게 한다.
| 방법 | 내용 |
|---|---|
| 군집을 분석단위로 | 각 군집의 비율을 관측 하나로 보고 ANOVA·\(t\) 검정 |
| ICC를 따로 추정 | 반복 자료나 문헌값에서 얻어 DEFF 계산 |
| 일반화추정방정식 | 군집 로버스트 표준오차 |
| 혼합효과 로지스틱 | 군집을 확률효과로 |
| 부트스트랩 | 군집 단위로 재추출 |
첫 방법이 가장 단순하고 확실하다. 정보를 조금 잃지만 가정이 거의 필요 없다.
어떻게 알아채는가. 과대산포는 자료만 보고는 잘 드러나지 않는다. 다음을 확인한다.
- 자료가 군집·다단계 표집으로 모였는가
- 같은 개체를 여러 번 세지 않았는가
- 시간·공간적으로 인접한 관측이 있는가
- 여러 표에서 \(X^2/\text{df}\)가 일관되게 1보다 큰가
마지막 항목이 실용적인 진단이다. 비슷한 표가 여럿 있으면 \(X^2/\text{df}\)를 모아 평균 내 본다.
연습문제 11. 관측도수가 합동 비율과 정확히 일치하는(즉 각 범주 \(j\)에 대해 \(O_{4j} = n_4 \cdot C_j / n\)인) 네 번째 모집단을 추가한다고 하자. 전체 검정통계량은 어떻게 되는가? 설명하라.
풀이
검정통계량은 정확히 그대로이다.
새 행이 합동 비율에 비례하므로 새 열 합계는 \(C_j' = C_j + n_4 C_j/n = C_j(n + n_4)/n\)이고 새 총합은 \(n' = n + n_4\)이다. 따라서 원래 행 \(i\)의 기대도수는
으로 변하지 않는다. 새 행의 기대도수는 \(n_4 C_j'/n' = n_4 C_j/n = O_{4j}\)이므로 기여가 0이다.
다만 자유도는 \((r-1)(c-1)\)에서 \(r(c-1)\)로 커지므로, 같은 통계량에 대해 p 값은 커진다. 완벽하게 "평균적인" 모집단을 하나 더 관측하는 것은 이질성의 증거를 전혀 더하지 않으면서 표집분포만 넓히는 셈이다. \(\square\)
연습문제 12. 모든 모집단의 표본크기가 똑같이 \(n_0\)이고 모든 범주에서 관측 비율도 같다면, 모집단이나 범주의 개수와 무관하게 \(X^2 = 0\)임을 증명하라.
풀이
크기가 각각 \(n_0\)인 모집단이 \(r\)개 있다고 하면 \(n = r \cdot n_0\)이다. 모든 모집단의 도수가 같으면 모든 \(i\)에 대해 \(O_{ij} = O_{1j}\)이고 열 합계는 \(C_j = r \cdot O_{1j}\)이다. 행 합계는 모든 \(i\)에서 \(R_i = n_0\)이다. 기대도수는
이다. 모든 행이 같으므로 모든 칸에서 \(O_{ij} = O_{1j} = E_{ij}\)이다. 따라서
이다. 직관적으로도 자연스럽다. 모든 모집단이 정확히 같은 분포를 보인다면 동질성에 반하는 증거가 전혀 없다. \(\square\)
연습문제 13. 연습문제 11·12가 다룬 "\(X^2=0\)이 되는 경우"를 일반화하라. \(X^2\)이 취할 수 있는 최댓값은 얼마인가?
풀이
최솟값은 0이다. 모든 행의 비율이 합동 비율과 정확히 같을 때다(연습문제 12).
최댓값은 \(n\cdot(q-1)\)이다. 여기서 \(q=\min(r,c)\)다.
import numpy as np
from scipy import stats

def max_table(r, c, n):
    """완전 연관인 표: 작은 쪽의 각 수준이 큰 쪽의 서로 다른 그룹에 대응."""
    obs = np.zeros((r, c))
    if r <= c:
        for i, g in enumerate(np.array_split(np.arange(c), r)):
            obs[i, g] = n / (r * len(g))
    else:
        for j, g in enumerate(np.array_split(np.arange(r), c)):
            obs[g, j] = n / (c * len(g))
    return obs

def max_check(r, c, n):
    q = min(r, c)
    chi2, _, _, _ = stats.chi2_contingency(max_table(r, c, n),
                                           correction=False)
    return chi2, n * (q - 1), np.sqrt(chi2 / (n * (q - 1)))

print(f"{'표':>7s} {'n':>5s} {'관측 X²':>10s} {'n(q-1)':>9s} {'V':>7s}")
for r, c, n in [(2, 2, 100), (3, 3, 300), (4, 4, 400),
                (2, 4, 200), (4, 2, 200), (3, 5, 300)]:
    got, bound, v = max_check(r, c, n)
    print(f"{f'{r}×{c}':>7s} {n:5d} {got:10.4f} {bound:9.0f} {v:7.4f}")
      표     n      관측 X²    n(q-1)       V
    2×2   100   100.0000       100  1.0000
    3×3   300   600.0000       600  1.0000
    4×4   400  1200.0000      1200  1.0000
    2×4   200   200.0000       200  1.0000
    4×2   200   200.0000       200  1.0000
    3×5   300   600.0000       600  1.0000
여섯 경우 모두 상한에 정확히 도달한다. 그리고 그때 \(V=1\)이다.
이것이 크라메르 \(V\)의 정의가 그런 모양인 이유다. \(X^2\)을 그 최댓값으로 나눠 \([0,1]\)로 정규화한 것이다.
\(q=\min(r,c)\)인 이유. "완전 연관"이란 한 변수를 알면 다른 변수가 결정된다는 뜻인데, \(3\times5\) 표에서는 행이 3개뿐이라 열을 3개 그룹까지만 구분할 수 있다. 그래서 작은 쪽이 한계를 정한다.
\(2\times4\)와 \(4\times2\)가 같은 값(\(q-1=1\))인 것도 같은 이유다.
세 가지 한계 상황 정리.
| 상황 | \(X^2\) | \(V\) |
|---|---|---|
| 모든 행의 비율이 같음 | 0 | 0 |
| 완전 연관 | \(n(q-1)\) | 1 |
| 독립이 참, 표본 유한 | 평균 \((r-1)(c-1)\) | 평균 \(\sqrt{\frac{(r-1)(c-1)}{n(q-1)}}\) |
셋째 줄이 실무에서 중요하다. 11.3절 효과크기와 크라메르의 V가 다루는 \(V\) 의 소표본 편향이 바로 이 값이다.
\(X^2\)을 눈으로 판단하는 감각.
- \(X^2\approx\text{df}\) → 예상대로
- \(X^2\approx 2\sim3\times\text{df}\) → 이탈의 신호
- \(X^2\approx n(q-1)\) → 거의 완전 연관(자료를 의심할 만하다)
마지막 경우가 실제로 나오면 대개 자료 오류다. 같은 정보를 두 번 코딩했거나, 한 변수가 다른 변수의 함수인 경우다.
연습문제 14. 동질성 검정과 독립성 검정은 계산이 같은데 표집 설계가 다르다. 그래도 두 상황에서 검정이 똑같이 작동하는지 모의실험으로 확인하라.
풀이
두 표집 설계.
| 동질성 | 독립성 | |
|---|---|---|
| 고정하는 것 | 행 합 \(R_i\) | 총합 \(n\)만 |
| 확률모형 | 행마다 독립인 다항분포 | 하나의 다항분포 |
import numpy as np
from scipy import stats

rng = np.random.default_rng(5791)
M, n = 20_000, 300
p_col = np.array([0.25, 0.26, 0.23, 0.26])
P = np.outer([1 / 3, 1 / 3, 1 / 3], p_col)     # 독립이 참

a = b = 0
for _ in range(M):
    # ① 독립성 표집: 전체 n 을 한 번에 다항으로
    t1 = rng.multinomial(n, P.ravel()).reshape(3, 4).astype(float)
    if (t1.sum(0) > 0).all() and (t1.sum(1) > 0).all():
        a += stats.chi2_contingency(t1, correction=False)[1] < 0.05

    # ② 동질성 표집: 행마다 100 씩 따로
    t2 = np.array([rng.multinomial(100, p_col) for _ in range(3)], float)
    if (t2.sum(0) > 0).all():
        b += stats.chi2_contingency(t2, correction=False)[1] < 0.05

print(f"독립성 표집(총 n 만 고정):  기각률 {a / M:.4f}")
print(f"동질성 표집(행 합 고정):    기각률 {b / M:.4f}")
독립성 표집(총 n 만 고정):  기각률 0.0521
동질성 표집(행 합 고정):    기각률 0.0508
두 설계에서 수준이 같다(0.052와 0.051). 같은 통계량, 같은 자유도, 같은 극한분포다.
왜 그런가. 다항분포를 행 합으로 조건화하면 행별 독립 다항분포가 된다. 즉 ②는 ①을 조건화한 것이고, 카이제곱 통계량의 극한분포는 그 조건화에 영향을 받지 않는다.
그래도 구분해야 하는 이유 셋.
1 — 귀무가설의 서술이 다르다.
| 설계 | \(H_0\) |
|---|---|
| 동질성 | \(P(\text{범주}=j\mid\text{집단}=i)\)가 모든 \(i\)에 대해 같다 |
| 독립성 | \(P(\text{행}=i,\ \text{열}=j)=P(\text{행}=i)P(\text{열}=j)\) |
2 — 추정할 수 있는 것이 다르다. 동질성 설계에서는 행 합을 연구자가 정했으므로 행의 주변분포를 추정할 수 없다. "전체 인구에서 집단 1의 비율"을 이 자료로 말할 수 없다.
print("동질성 설계에서 추정 가능한 것과 불가능한 것")
obs = np.array([[25, 30, 20, 25], [18, 22, 35, 25], [30, 25, 15, 30]], float)
print(f"  집단별 범주 비율(가능):\n{np.round(obs / obs.sum(1, keepdims=True), 4)}")
print(f"  전체 집단 비율(불가능): {np.round(obs.sum(1) / obs.sum(), 4).tolist()}")
print("    ← 이 값은 연구자가 1:1:1 로 정한 것이지 모집단의 성질이 아니다")
동질성 설계에서 추정 가능한 것과 불가능한 것
  집단별 범주 비율(가능):
[[0.25 0.3  0.2  0.25]
 [0.18 0.22 0.35 0.25]
 [0.3  0.25 0.15 0.3 ]]
  전체 집단 비율(불가능): [0.3333, 0.3333, 0.3333]
    ← 이 값은 연구자가 1:1:1 로 정한 것이지 모집단의 성질이 아니다
3 — 인과적 해석의 여지가 다르다. 동질성 설계에서 집단이 무작위 배정이면 인과를 말할 수 있다. 독립성 설계는 관측자료이므로 연관까지만 말한다.
결론. 계산은 같아도 결론의 서술은 설계를 따라야 한다. 소프트웨어가 구분해 주지 않으므로 사람이 기억해야 한다.
정리하며
동질성 검정과 독립성 검정은 계산이 완전히 같고 설계와 해석이 다르다.
| 독립성 | 동질성 | |
|---|---|---|
| 표본 | 하나의 표본에서 두 변수 측정 | 여러 모집단에서 각각 표집 |
| 고정된 것 | 총 \(n\) 만 | 각 집단의 크기를 연구자가 정함 |
| 묻는 것 | 두 변수가 연관되는가 | 집단들의 분포가 같은가 |
- 같은 \(X^2\) 통계량, 같은 자유도 \((r-1)(c-1)\) 을 쓴다. 계산만 보면 구별할 수 없다.
- 구별은 자료를 어떻게 모았는지에서 온다. 고객 300명을 뽑아 성별과 선호를 함께 기록했으면 독립성, 남성 150명과 여성 150명을 따로 뽑았으면 동질성이다.
- 결론의 문장이 다르다. 독립성은 "성별과 선호가 연관되어 있다", 동질성은 "남성과 여성의 선호 분포가 다르다"이다.
- 실무에서 혼동해도 수치는 같다. 다만 무엇을 일반화할 수 있는지가 달라지므로 보고할 때는 설계를 밝혀야 한다.
다음 절은 기각한 뒤의 이야기다. 전체 검정이 「적어도 한 집단이 다르다」까지만 말해 주므로, 어느 칸이 어긋났는지는 잔차로 따로 찾아야 한다.