오염을 늘리면 어느 평균이 먼저 무너지는가¶
자료 \(\{1, 3, 5, 7, 100\}\) 의 표본평균(sample mean)은 \(23.2\) 다. 다섯 값 가운데 넷이 \(1\) 과 \(7\) 사이인데 요약값만 그 바깥에 서 있고, 양쪽에서 하나씩 떼어 낸 \(20\%\) 절사평균은 \(5.0\) 을 준다. 그렇다고 평균을 버릴 일도 아니다 — 깨끗한 \(N(0,1)\) 자료 \(n = 25\) 에서 \(10\%\) 절사평균의 표준편차는 \(0.204\) 로 평균의 \(0.200\) 보다 \(2\%\) 넓을 뿐인데, 관측값의 \(5\%\) 가 \(N(0, 5^2)\) 에서 섞여 드는 순간 평균은 \(0.297\) 로 벌어지고 절사평균은 \(0.222\) 에 머문다. \(2\%\) 의 보험료로 어디까지 보장받는가.
표본평균은 정규성(normality) 아래에서 모평균의 가장 효율적인 추정량이지만, 극단 관측값 하나가 참 중심에서 얼마든지 멀리 밀어낼 수 있다. 로버스트 추정량은 이상적인 조건에서 약간의 효율을 희생하는 대신 자료가 가정한 모형에서 벗어날 때의 안정성을 얻는다. 이 절에서는 그런 추정량 둘 — 절사평균과 윈저화 평균 — 을 소개하고 그 트레이드오프(trade-off)을 비교한다. 이 쪽은 오염 모형을 쓴다 — 깨끗한 자료에 이상치를 손으로 섞어 넣고 몇 개까지 버티는지 센다. 같은 추정량들을 꼬리가 두꺼운 분포에서 — 오염 없이 \(t_5\) 같은 자료에서 — 견주는 것은 5.14절 꼬리가 두꺼운 분포 §6·§7 이다. 두 틀에서 순위가 같지 않다.
1. 절사평균¶
절사의 발상은 단순하다: 평균을 내기 전에 양쪽 끝의 가장 극단적인 관측값을 제거한다. 이상치이거나 두꺼운 꼬리의 산물일 가능성이 가장 높은 값을 버림으로써, 자료의 대부분을 여전히 사용하면서도 오염에 저항한다.
표본 \(X_1, \ldots, X_n\)이 주어졌을 때 \(X_{(1)} \leq X_{(2)} \leq \cdots \leq X_{(n)}\)을 순서통계량(작은 것부터 정렬한 관측값)이라 하자. \(\alpha\)-절사평균은 가장 작은 쪽과 가장 큰 쪽에서 각각 \(\lfloor n\alpha \rfloor\)개를 제거하고 나머지를 평균한다.
\(\alpha = 0\)이면 보통의 표본평균이 되고, \(\alpha = 0.5\)이면 중앙값이 된다.
20% 절사한 절사평균
\(n = 5\)인 표본 \(\{1, 3, 5, 7, 100\}\)에서 \(\alpha = 0.2\)를 생각하자. \(\lfloor 5 \times 0.2 \rfloor = 1\)이므로 절사평균은 가장 작은 값(\(1\))과 가장 큰 값(\(100\))을 제거하고 남은 셋을 평균한다: \(\bar{X}_{\text{trim}(0.2)} = (3 + 5 + 7)/3 = 5.0\). 보통의 표본평균은 \((1 + 3 + 5 + 7 + 100)/5 = 23.2\)로, 이상치(outlier) 하나가 절사하지 않은 추정값을 얼마나 부풀리는지 보여준다.
2. 윈저화 평균¶
윈저화 평균은 극단 관측값을 버리는 대신 가장 가까운 극단이 아닌 값으로 대체한다. 원래의 표본크기가 유지되므로 분산추정이 간단해질 수 있다.
절사비율 \(\alpha\)에 대해 \(k = \lfloor n\alpha \rfloor\)라 하자. \(\alpha\)-윈저화 평균은 가장 작은 \(k\)개를 \(X_{(k+1)}\)로, 가장 큰 \(k\)개를 \(X_{(n-k)}\)로 바꾼 뒤 \(n\)개 값을 모두 평균한다.
20% 윈저화한 윈저화 평균
같은 표본 \(\{1, 3, 5, 7, 100\}\)에서 \(\alpha = 0.2\)(\(k = 1\))를 쓰면 윈저화 평균은 \(1\)을 \(3\)으로, \(100\)을 \(7\)로 바꾼다: \(\bar{X}_{\text{win}(0.2)} = (3 + 3 + 5 + 7 + 7)/5 = 5.0\). 이 경우에는 결과가 절사평균과 같지만, 표본이 커지면 일반적으로 서로 다르다.
3. 붕괴점과 효율¶
추정량의 붕괴점(breakdown point)은 추정량이 무한히 커지기 전까지 임의의 값으로 바꿀 수 있는 관측값의 최대 비율이다. 붕괴점이 높을수록 로버스트하다.
| 추정량 | 붕괴점 | 표본평균 대비 ARE (정규) |
|---|---|---|
| 표본평균 | 0% | 100% |
| 10% 절사평균 (\(\alpha = 0.1\)) | 10% | ~94% |
| 20% 절사평균 (\(\alpha = 0.2\)) | 20% | ~87% |
| 중앙값 (50% 절사) | 50% | ~64% |
효율 열은 정규분포 아래에서 표본평균과 비교한 점근 상대효율이다. 10% 절사평균은 정규성 아래에서 효율을 약 6%만 잃으면서 이상치에 대한 상당한 보호를 얻는다.
절사비율을 한쪽으로 세는지 양쪽 합으로 세는지 확인할 것
위 표의 \(\alpha\)는 이 절의 정의대로 양쪽에서 각각 떼어 내는 비율이다. \(\alpha = 0.1\)이면 아래위로 \(10\%\)씩, 합쳐서 \(20\%\)를 버린다.
책과 소프트웨어마다 관례가 다르다. 절사량을 합계로 세는 곳에서는 같은 추정량을 "\(20\%\) 절사평균"이라 부르고, 그 관례로 적은 효율표에는 \(97\%\)와 \(94\%\)가 실린다. 한쪽 기준의 \(94\%\), \(87\%\)와 어긋나 보이지만 같은 값을 다르게 이름 붙인 것일 뿐이다. 표를 옮겨 쓸 때 가장 흔히 생기는 오류가 이 혼동이다. 중앙값은 최대 붕괴점 50%를 달성하지만 정규성 아래에서 약 36%의 효율 손실을 대가로 치른다.
표의 두 열 — 붕괴점과 효율 — 이 각각 무엇을 재는지는 다음 두 그림에서 직접 볼 수 있다.
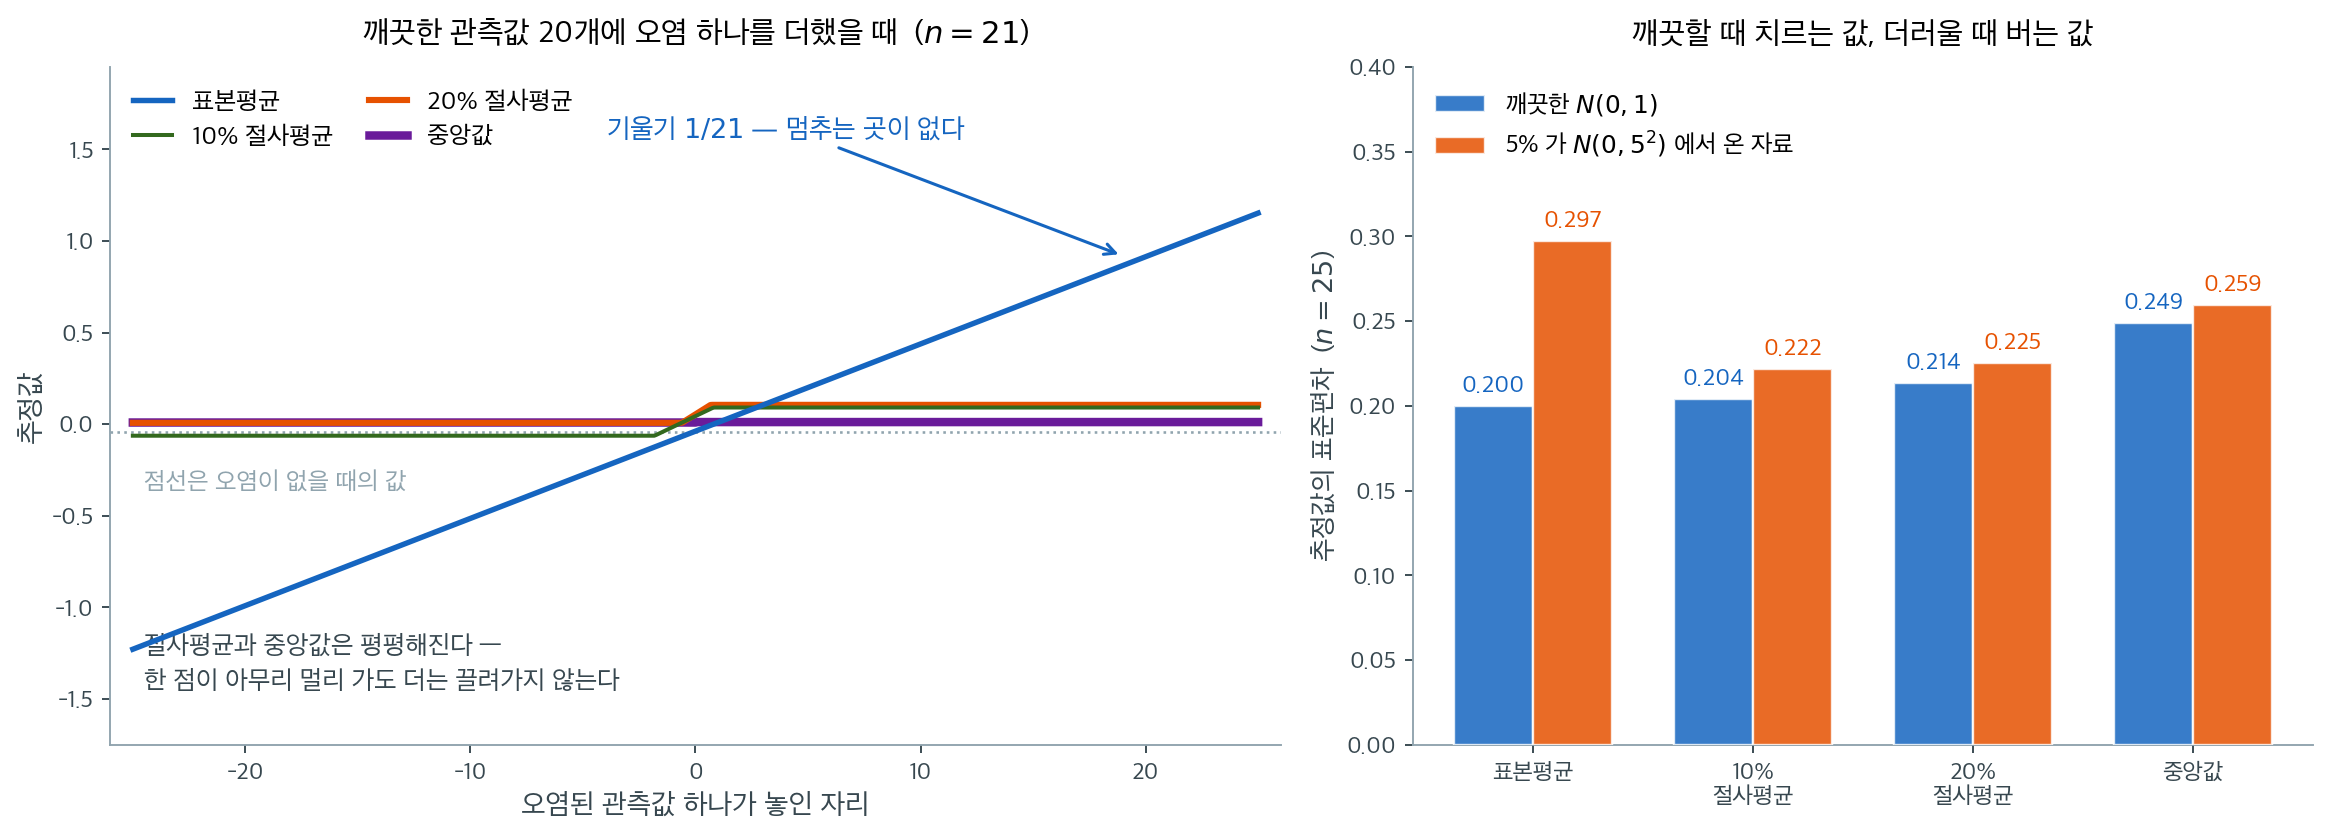
왼쪽은 민감도 곡선이다. \(N(0,1)\) 에서 뽑은 깨끗한 관측값 20개를 고정해 두고, 21번째 관측값 하나만 \(-25\) 에서 \(+25\) 까지 끌고 다니면서 네 추정량의 값을 따라 그렸다. 파란 선은 기울기 \(1/21\) 인 직선이다. 끝점에서 \(-1.228\) 과 \(+1.153\) 을 주고, 그 점을 더 멀리 보내면 값도 그만큼 더 간다. 멈추는 곳이 없다는 것, 이것이 표본평균의 붕괴점이 \(0\%\) 라는 말의 그림이다. 관측값 백만 개가 있어도 사정은 같다 — 기울기만 \(1/10^6\) 으로 작아질 뿐 직선은 여전히 직선이다.
나머지 셋은 곧 평평해진다. 오염이 절사되는 순간부터는 그 점이 \(10\) 에 있든 \(10^{9}\) 에 있든 추정값이 똑같다. 10% 절사평균은 양 끝에서 \(-0.063\) 과 \(+0.091\) 사이에 갇히고, 중앙값은 \(0.009\) 와 \(0.012\) 로 거의 꿈쩍도 하지 않는다. 절사가 하는 일은 영향을 줄이는 것이 아니라 영향에 천장을 씌우는 것이다. 붕괴점 \(\alpha\) 는 그 천장이 유지되는 오염 비율의 한계이다.
오른쪽은 그 보호에 붙는 가격표다. \(n = 25\) 에서 8만 번씩 반복해 추정값의 표준편차를 잰 것으로, 파란 막대가 깨끗한 \(N(0,1)\) 자료, 주황 막대는 관측값의 5%가 \(N(0, 5^2)\) 에서 오는 오염된 자료다. 깨끗할 때 10% 절사평균의 표준편차는 \(0.204\) 로 표본평균의 \(0.200\) 보다 2% 넓을 뿐이다. 그런데 5%만 오염되면 표본평균은 \(0.297\) 로 \(49\%\) 나 벌어지는 반면 10% 절사평균은 \(0.222\) 에 그친다. 보험료가 2%이고 사고가 났을 때의 보상이 이만큼이라면, 바로 아래 쪽지가 권하는 선택이 어디로 기우는지는 분명하다.
절사비율의 선택
실무에서는 \(\alpha = 0.1\)(10% 절사)이나 \(\alpha = 0.2\)(20% 절사)가 로버스트성과 효율 사이의 좋은 균형을 준다. 분포의 꼬리가 두꺼울 것으로 예상되면, 정규성 아래에서 표본평균 대비 잃는 효율보다 얻는 안정성이 훨씬 크다.
그림으로 보는 통계학 1. 논문 제목이 이 표의 두 열이다
위 표는 열이 둘이다 — 붕괴점과 정규에서의 효율. 둘을 나란히 놓고 재는 일을 처음 한 사람의 논문은 제목이 그 두 열 그대로다. \(1967\) 년 제\(5\) 회 버클리 심포지엄 논문집에 실린 조지프 호지스의 「위치추정량들의 정규표본에서의 효율과 극단값에 대한 내성」이다.
「내성」이라 옮긴 말이 붕괴점의 첫 꼴이다. 호지스가 물은 것은 간단하다 — 표본 가운데 몇 개까지 아무 값으로 바꿔 놓아도 추정값이 터무니없어지지 않는가. 그 수를 \(n\) 으로 나눈 것이 오늘의 유한표본 붕괴점이다. 몇 해 뒤 프랑크 함펠이 버클리 박사논문 (\(1968\))과 『Annals of Mathematical Statistics』의 글(\(1971\))에서 이것을 분포 수준의 점근 개념으로 일반화했고, 위 표의 \(0\%\)·\(10\%\)·\(20\%\)·\(50\%\) 가 그 점근값이다.
점근값이라는 것이 중요하다. 손에 든 표본이 유한하면 그 수가 그대로 나오지 않는다. 호지스가 원래 물었던 방식 그대로 — 몇 개까지 버티는지 직접 세어 — 재 보면 이렇다.
import numpy as np
from scipy import stats

def est(v, kind):
    if kind == "평균":   return float(v.mean())
    if kind == "중앙값": return float(np.median(v))
    return float(stats.trim_mean(v, float(kind)))     # 양쪽에서 각각 떼는 비율

def tolerate(nn, kind, big=1e12):
    """깨끗한 값 0 가운데 k 개를 무한대로 보내도 추정값이 안 끌려가는 최대 k."""
    for k in range(nn + 1):
        v = np.zeros(nn); v[:k] = big
        if abs(est(v, kind)) > 1.0:
            return k - 1
    return nn

KINDS = ("평균", "0.1", "0.2", "중앙값")
print("      버틸 수 있는 오염 개수와 그 비율 (= 유한표본 붕괴점)")
print("     n       평균        10% 절사      20% 절사       중앙값")
for nn in (10, 25, 101, 1001):
    cells = [f"{tolerate(nn,k):4d} ({tolerate(nn,k)/nn:5.1%})" for k in KINDS]
    print(f"  {nn:5d}   " + " ".join(cells))
print("\n     점근값      0.0%         10.0%         20.0%         50.0%")
출력:
      버틸 수 있는 오염 개수와 그 비율 (= 유한표본 붕괴점)
     n       평균        10% 절사      20% 절사       중앙값
     10      0 ( 0.0%)    1 (10.0%)    2 (20.0%)    4 (40.0%)
     25      0 ( 0.0%)    2 ( 8.0%)    5 (20.0%)   12 (48.0%)
    101      0 ( 0.0%)   10 ( 9.9%)   20 (19.8%)   50 (49.5%)
   1001      0 ( 0.0%)  100 (10.0%)  200 (20.0%)  500 (50.0%)

     점근값      0.0%         10.0%         20.0%         50.0%
중앙값의 \(50\%\) 는 어떤 유한한 \(n\) 에서도 나오지 않는다. \(n = 10\) 이면 넷까지만 버티므로 \(40\%\) 이고, \(n = 25\) 에서 \(48\%\), \(n = 101\) 에서 \(49.5\%\) 로 아래에서 다가갈 뿐이다. 까닭은 셈을 해 보면 당연하다 — 절반이 오염되면 어느 쪽이 깨끗한지 가릴 길이 없으므로, 버틸 수 있는 것은 언제나 절반에서 하나 모자란 수다.
\(n = 25\) 의 \(10\%\) 절사평균이 \(8.0\%\) 로 내려앉는 것도 같은 사정이다. 양쪽에서 \(\lfloor 0.1 \times 25 \rfloor = 2\) 개씩 떼므로 실제로 버티는 것은 둘, 곧 \(2/25\) 다. 이름표의 \(10\%\) 와 실제가 어긋나는 쪽은 언제나 덜 로버스트한 쪽이다. 표를 그대로 믿어도 되는 것은 \(n\) 이 넉넉할 때이고, 작은 표본에서는 한 단계 낮춰 읽는 편이 안전하다.
덧붙이면 이 호지스가 7.2절 최대가능도의 점근적 성질의 그 호지스다. 한 번은 점 하나에서만 유난히 좋은 추정량을 만들어 점근 이론의 빈틈을 보였고, 한 번은 오염을 얼마나 버티는가를 재는 자를 만들었다. 둘 다 「평균이 언제 좋은가」를 뒤집어 물은 것이다.
확인한 곳 — J. L. Hodges, Jr. 가 「Efficiency in normal samples and tolerance of extreme values for some estimators of location」을 『Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability』 제\(1\) 권(\(1967\)) \(163\)–\(186\)쪽에 실었고 거기서 위치추정량이 견디는 오염의 최대 비율을 물었다는 것, F. R. Hampel 이 버클리 박사논문 「Contributions to the theory of robust estimation」(\(1968\))과 「A general qualitative definition of robustness」(『Annals of Mathematical Statistics』 \(42\)권, \(1971\), \(1887\)–\(1896\)쪽)에서 이를 점근 개념으로 일반화했다는 것. 위의 수는 이 쪽이 직접 세어 본 값이다
AI로 보는 통계학 1. 공격자는 이상치처럼 굴지 않는다
\(\S 3\) 의 민감도 곡선은 오염을 점으로 본다. 점은 멀리 갈수록 해롭고, 절사는 그 영향에 천장을 씌운다 — 「영향을 줄이는 것이 아니라 영향에 천장을 씌우는 것」이라고 위에 적혀 있다.
연합학습에서 그 그림이 그대로 쓰인다. 서버는 일꾼 \(n\) 명이 보낸 기울기를 평균해서 모형을 한 걸음 옮기는데, 평균의 붕괴점이 \(0\) 이므로 일꾼 하나가 망가지면 모형이 어디로든 끌려간다. 그래서 평균 대신 좌표별 중앙값이나 절사평균을 쓴다. \(\S 3\) 의 표가 곧바로 설계 지침이 되는 셈이다.
그런데 여기서 오염은 점이 아니라 규칙을 아는 상대다. 그 하나가 달라지면 결론이 어디까지 따라오는지 재어 보았다. 일꾼 \(20\) 명 가운데 \(2\) 명이 공격자이고, 정직한 값은 \(N(0,1)\) 이다.
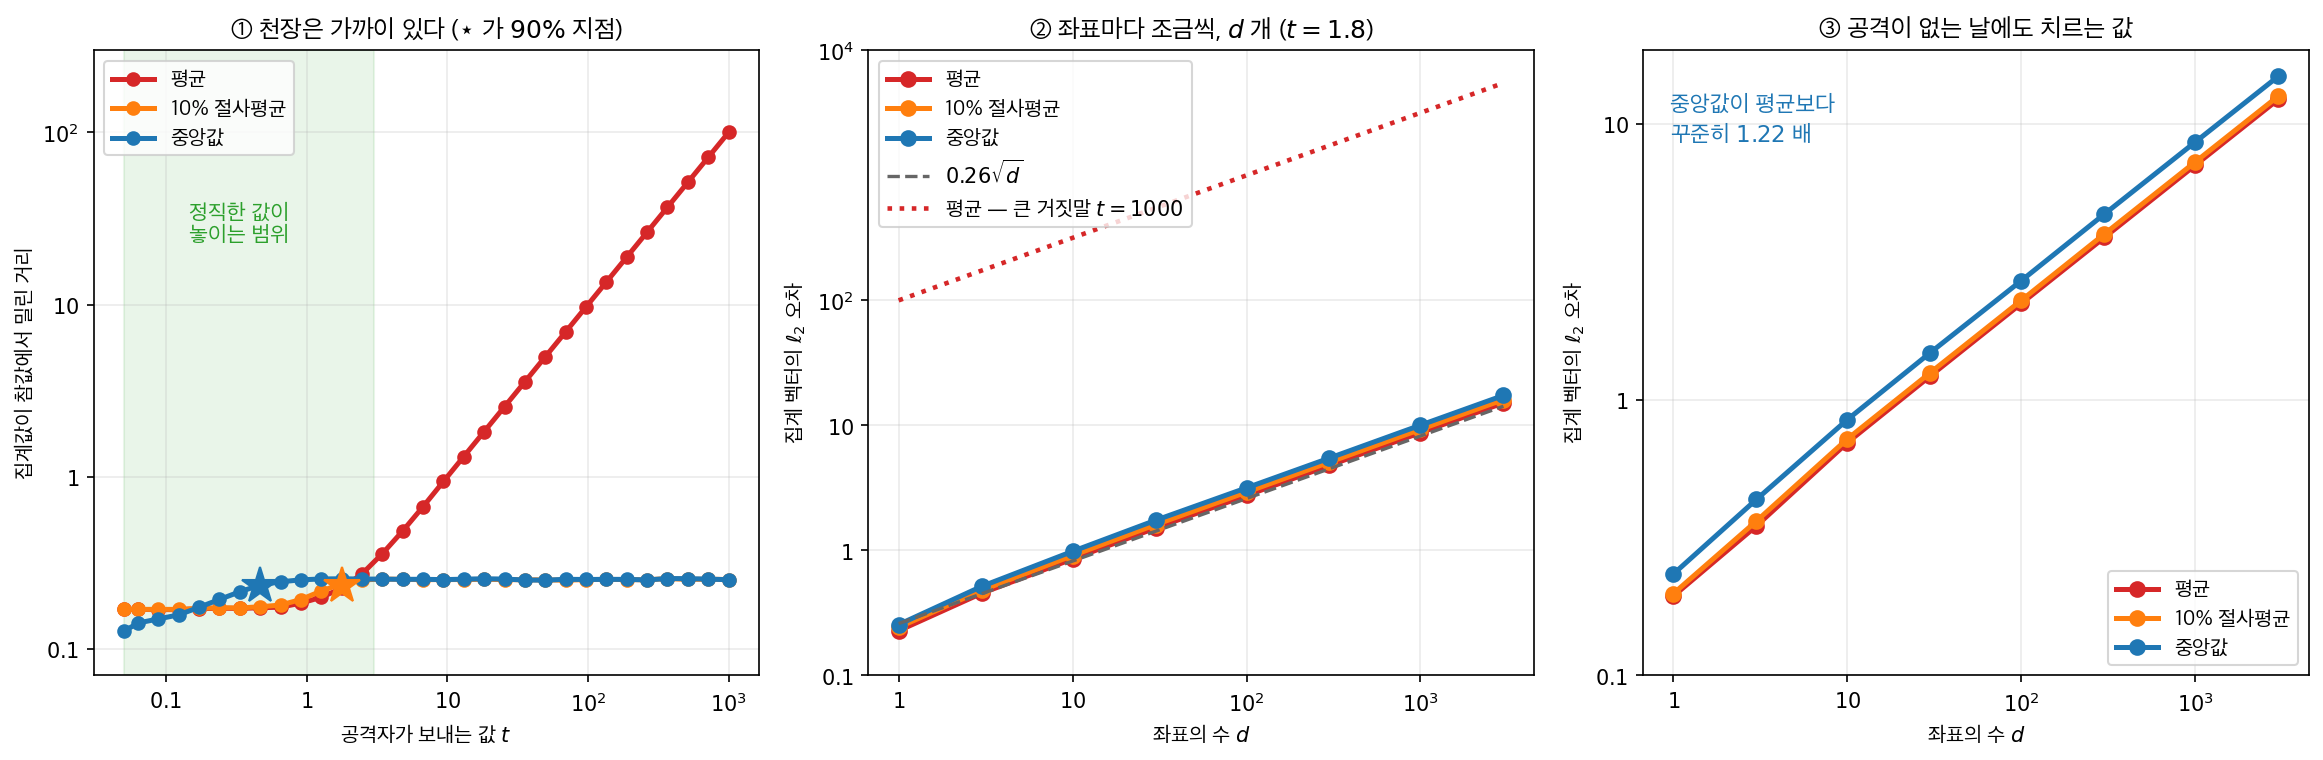
① 천장은 있는데, 가까이 있다. 공격자가 보내는 값 \(t\) 를 키우면 평균은 끝없이 밀린다(\(t = 1000\) 에서 \(100\) 만큼). 절사평균과 중앙값은 \(0.256\) 에서 천장을 친다 — 여기까지는 \(\S 3\) 그대로다. 눈여겨볼 것은 언제 천장을 치느냐다.
| 천장 | 그 \(90\%\) 에 닿는 가장 작은 \(t\) | |
|---|---|---|
| \(10\%\) 절사평균 | \(0.256\) | \(1.77\) |
| 중앙값 | \(0.256\) | \(0.47\) |
정직한 값의 표준편차가 \(1\) 이다. 공격자는 정상 범위 안에 머물면서 입힐 수 있는 피해를 거의 다 입힌다. 이상치 탐지로는 보이지도 않는다 — \(0.47\) 은 평범한 값이다. 멀리 가는 것은 이상치가 하는 일이지 공격자가 하는 일이 아니다.
② 좌표마다 조금씩, \(d\) 개. 기울기는 수 하나가 아니라 길이 \(d\) 의 벡터이고, 좌표별 집계는 좌표마다 따로 돈다. 같은 값싼 공격을 \(d\) 개 좌표에 모두 걸면
| 좌표 수 \(d\) | \(1\) | \(100\) | \(3{,}000\) |
|---|---|---|---|
| \(10\%\) 절사평균의 \(\ell_2\) 오차 | \(0.24\) | \(2.93\) | \(16.07\) |
| 중앙값의 \(\ell_2\) 오차 | \(0.26\) | \(3.17\) | \(17.37\) |
\(\sqrt d\) 로 큰다. 절사가 막는 것은 좌표 하나의 크기이지 벡터의 길이가 아니다. 좌표마다 \(0.26\) 씩 같은 방향으로 밀면 길이는 \(0.26\sqrt d\) 가 되고, \(d\) 가 백만이면 \(260\) 이다. 같은 그림에서 평균의 오차도 \(15.13\) 으로 거의 같다 — 이 값싼 공격에 한해서는 로버스트 규칙이 사 준 것이 없다. 사 준 것은 붉은 점선 쪽이다. 같은 자리에 \(t = 1000\) 짜리 큰 거짓말을 걸면 평균의 오차가 \(d = 3{,}000\) 에서 \(5{,}500\) 이 된다.
③ 그리고 보험료는 매일 낸다. 공격자가 하나도 없는 날의 오차를 재면
| 좌표 수 \(d\) | \(1\) | \(100\) | \(3{,}000\) |
|---|---|---|---|
| 평균 | \(0.18\) | \(2.23\) | \(12.24\) |
| 중앙값 | \(0.22\) | \(2.69\) | \(14.83\) |
중앙값이 꾸준히 \(1.22\) 배다. \(\S 3\) 의 ARE 표가 정규에서 중앙값의 효율을 \(64\%\) 로 적는데, 표준편차의 비 \(\sqrt{\pi/2} = 1.253\) 이 그 수의 다른 얼굴이고, 여기서는 \(1.22\) 로 나왔다.
셋을 합치면. 로버스트 집계는 큰 거짓말을 막아 주지만 — 그것이 ①의 붉은 선과 ②의 점선이 말하는 바다 — 작은 거짓말에는 거의 아무것도 해 주지 않고, 그 보험료는 공격이 없는 날에도 매번 나간다. \(\S 3\) 의 두 열(붕괴점과 효율)이 묻지 않는 질문이 하나 더 있는 셈이다 — 오염이 스스로 고르는가. 점은 아무 데나 떨어지지만 상대는 천장 바로 아래를 고른다.
확인한 곳 — 분산 학습에서 일부 계산 노드가 「비정상으로, 나아가 비잔틴 고장 — 제멋대로이며 적대적일 수도 있는 행동 — 을 보일 수 있다」는 것과, 그에 맞서 「중앙값과 절사평균에 바탕한 두 로버스트 분산 경사하강 알고리듬」을 분석한다는 것은 인 둥·첸 유둥·람찬드란·바틀렛의 「Byzantine-Robust Distributed Learning: Towards Optimal Statistical Rates」(arXiv:1803.01498, \(2018\); ICML \(2018\)) 초록에서 읽었다. 본문은 읽지 않았다 · ①②③의 수는 모두 직접 모의실험한 값이고, 공격 방식(공격자 전원이 같은 값 \(t\) 를 보내고 \(t\) 를 쓸어 본다)도 이 쪽에서 정한 것이다 — 더 영리한 공격이 있을 수 있다 · 중앙값의 \(64\%\) 는 위 \(\S 3\) 표의 값이다
4. 로버스트 추정량을 수로 견주기¶
절 \(1\)~\(3\) 은 절사평균·윈저화 평균과 그 붕괴점을 세웠다. 같은 틀을 척도 추정량(MAD 등)까지 넓히고, 오염을 점진적으로 늘려 가며 붕괴점이 수에서 어떻게 드러나는지 본다.
보기 1. 절사평균 구현하기. 자료는 \(\{1, 2, \dots, 9, 1000\}\)으로 \(n = 10\)이다.
(1) 평균, \(10\%\) 절사평균, \(20\%\) 절사평균, 중앙값을 손으로 구하시오. 뒤의 셋이 모두 같은 값이 나오는데, 우연인가.
(2) 코드로 확인하고, 이상치를 하나 더 넣어 \(10\%\) 절사평균이 실제로 무너지는지 보시오. 중앙값은 "\(100\%\) 절사평균"인가.
풀이
(1) 해석적으로. 평균부터. \(1 + 2 + \cdots + 9 = 45\)이므로
이고, 이는 자료의 아홉 값 전부보다 크다. 관측값 하나가 중심을 자료 바깥으로 밀어냈다.
절사평균은 \(k = \lfloor n\alpha \rfloor\)개씩 양 끝을 버리고 순서통계량 \(x_{(k+1)}, \dots, x_{(n-k)}\)를 평균한다. 여기서 정렬된 자료는 \(x_{(i)} = i\) \((i \le 9)\), \(x_{(10)} = 1000\)이다. \(k \ge 1\)이면 \(1000\)이 창 밖으로 나가므로 창 안에는 등차수열만 남고, 등차수열의 평균은 양 끝의 평균이다.
\(k\)가 지워진다. \(\alpha = 0.1\)이면 \(k = 1\), \(\alpha = 0.2\)이면 \(k = 2\)이지만 창의 한가운데 자리는 언제나 \((10+1)/2 = 5.5\)번째이므로 답이 바뀌지 않는다. 중앙값도 \(k = 4\)에 해당하는 창 \(\{5, 6\}\)의 평균이라 같은 \(5.5\)다. 우연이 아니라 아래쪽 아홉 값이 등차수열이기 때문이고, \(1 \le k \le 4\)인 모든 절사가 똑같이 \(5.5\)를 준다.
(2) 수치적으로.
import numpy as np

def trimmed_mean(data, proportion=0.1):
    """양쪽 꼬리에서 proportion 비율씩 잘라 내고 평균을 낸다."""
    x = np.sort(data)              # 잘라 내려면 먼저 정렬해야 한다
    n = len(x)
    k = int(np.floor(n * proportion))   # 각 꼬리에서 버릴 개수
    if k == 0:
        return x.mean()            # 표본이 작아 버릴 것이 없으면 그냥 평균
    return x[k:-k].mean()          # 앞뒤 k개를 빼고 평균


# 이상치 하나가 들어 있는 자료로 확인한다.
data = np.array([1, 2, 3, 4, 5, 6, 7, 8, 9, 1000.0])
print(f"평균         {data.mean():9.2f}   <- 이상치 하나에 끌려간다")
print(f"10% 절사평균 {trimmed_mean(data, 0.1):9.2f}")
print(f"20% 절사평균 {trimmed_mean(data, 0.2):9.2f}")
print(f"중앙값       {np.median(data):9.2f}   <- 100% 절사평균인 셈")
출력:
평균            104.50   <- 이상치 하나에 끌려간다
10% 절사평균      5.50
20% 절사평균      5.50
중앙값            5.50   <- 100% 절사평균인 셈
네 수가 (1)과 정확히 맞는다. 이어서 이상치를 하나 더 넣어 본다.
# 이상치를 둘로 늘린다. 자료 크기는 10 그대로 두어야 비교가 된다.
data2 = np.array([1, 2, 3, 4, 5, 6, 7, 8, 1000, 1000.0])
print(f"평균         {data2.mean():9.3f}")
print(f"10% 절사평균 {trimmed_mean(data2, 0.1):9.3f}   <- k=1 이라 1000 하나가 남는다")
print(f"20% 절사평균 {trimmed_mean(data2, 0.2):9.3f}   <- k=2 라 둘 다 빠진다")
print(f"중앙값       {np.median(data2):9.3f}")
출력:
평균           203.600
10% 절사평균   129.375   <- k=1 이라 1000 하나가 남는다
20% 절사평균     5.500   <- k=2 라 둘 다 빠진다
중앙값           5.500
\(10\%\) 절사평균이 무너졌다. \(k = \lfloor 10 \times 0.1 \rfloor = 1\)이라 위쪽에서 하나만 버리는데 이상치가 둘이므로 하나가 창에 남고, 그 하나가 \(\{2, \dots, 8, 1000\}\)의 평균을 \(1035/8 = 129.375\)로 끌어올린다. \(20\%\) 절사는 \(k = 2\)라 둘 다 버려 \(5.5\)를 지킨다. 표의 "붕괴점 \(\alpha\)"가 바로 이 뜻이다. \(\alpha\) 절사평균은 \(\alpha\) 비율까지의 오염을 견디고 그 너머에서는 평균과 똑같이 얼마든지 끌려간다.
"\(100\%\) 절사평균"은 말이 되지 않는다. 코드 주석에 그렇게 적혀 있으나 \(\alpha = 1\)이면 자료가 통째로 없어진다. 중앙값은 \(\alpha \to 1/2\)의 극한이며, \(n = 10\)에서는 \(k\)를 가능한 가장 큰 값인 \(4\)(\(\alpha = 0.4\))로 둔 것과 같다. 붕괴점 표에서 중앙값이 \(50\%\)인 것과 \(\alpha\) 절사평균이 \(\alpha\)인 것이 \(\alpha \to 1/2\)에서 이어지는 까닭이다.
보기 2. 가중평균과 가중중앙값. 자료 \((1, 2, 3, 4, 100)\)에 가중치 \((1, 1, 1, 1, w)\)를 준다. 이상치 \(100\)이 가중치까지 많이 가져간 상황이다.
(1) \(w = 3\)에서 가중평균과 가중중앙값을 손으로 구하시오.
(2) \(w\)를 키우면 가중중앙값은 어느 값에서 정확히 \(100\)으로 넘어가는가. 그 임계값을 유도하고 코드로 확인하시오.
풀이
(1) 해석적으로. 가중평균은 정의대로다. 가중치 합이 \(4 + w = 7\)이므로
이고, 자료의 네 값이 \(4\) 이하인데도 중심이 \(44\)를 넘었다. 가중평균은 가중치가 붙어도 여전히 평균이며 붕괴점이 \(0\)이다.
가중중앙값은 작은 값부터 가중치를 쌓아 누적 비율이 처음 \(1/2\)에 이르는 값이다. 누적 비율을 적으면
이고 \(0.5\)를 처음 넘는 것이 네 번째이므로 \(\tilde x_w = 4\)다. 이상치가 전체 가중치의 \(3/7 = 43\%\)를 쥐고 있는데도 버틴다.
(2) 임계값. 값 \(100\) 하나가 가중중앙값이 되려면 그 앞에 쌓인 가중치가 절반에 못 미쳐야 한다. 앞의 네 점이 쥔 비율이 \(4/(4+w)\)이므로 조건은
이다. 이상치의 가중치 몫이 \(1/2\)를 넘는 순간, 그리고 오직 그때에만 무너진다. 이것이 가중중앙값의 붕괴점이 "질량의 절반"이라는 말의 정확한 뜻이고, 가중치가 모두 같은 보통의 중앙값에서 \(50\%\)가 되는 특수한 경우다.
경계 \(w = 4\) 자체는 동점이다. 누적 비율이 정확히 \(4/8 = 0.5\)이므로 "\(1/2\) 이상"으로 읽는 이 구현은 \(4\)를 돌려주고, "\(1/2\) 초과"로 읽으면 \(100\)을 돌려준다. 동점을 어느 쪽으로 보낼지는 규약이며, 둘 사이 아무 값이나 골라도 가중중앙값의 정의를 만족한다.
def weighted_mean(data, weights):
    return np.sum(data * weights) / np.sum(weights)

def weighted_median(data, weights):
    """누적 가중치가 절반에 도달하는 값을 찾는다."""
    order = np.argsort(data)            # 값의 크기 순으로 정렬한 순서
    sorted_data = data[order]
    sorted_w = weights[order]           # 가중치도 같은 순서로 따라간다
    cum_w = np.cumsum(sorted_w) / np.sum(sorted_w)   # 누적 가중치 비율
    idx = np.searchsorted(cum_w, 0.5)   # 0.5를 처음 넘는 위치
    return sorted_data[idx]


# 마지막 관측값이 이상치이고 가중치도 큰 경우.
data = np.array([1.0, 2.0, 3.0, 4.0, 100.0])
weights = np.array([1.0, 1.0, 1.0, 1.0, 3.0])
print(f"가중평균   {weighted_mean(data, weights):8.2f}   <- 이상치에 끌려간다")
print(f"가중중앙값 {weighted_median(data, weights):8.2f}   <- 버틴다")
출력:
가중평균      44.29   <- 이상치에 끌려간다
가중중앙값     4.00   <- 버틴다
임계값 \(w = 4\)의 양옆을 훑어 본다.
# w 를 4 의 양옆으로 조금씩 옮기며 가중중앙값이 언제 넘어가는지 본다.
for w in (3.0, 3.9, 4.0, 4.001, 5.0):
    ws = np.array([1.0, 1.0, 1.0, 1.0, w])
    print(f"w = {w:>5}  이상치 가중치 몫 {w / ws.sum():.4f}   "
          f"가중중앙값 {weighted_median(data, ws):6.1f}   "
          f"가중평균 {weighted_mean(data, ws):6.2f}")
출력:
w =   3.0  이상치 가중치 몫 0.4286   가중중앙값    4.0   가중평균  44.29
w =   3.9  이상치 가중치 몫 0.4937   가중중앙값    4.0   가중평균  50.63
w =   4.0  이상치 가중치 몫 0.5000   가중중앙값    4.0   가중평균  51.25
w = 4.001  이상치 가중치 몫 0.5001   가중중앙값  100.0   가중평균  51.26
w =   5.0  이상치 가중치 몫 0.5556   가중중앙값  100.0   가중평균  56.67
유도한 임계값이 정확히 맞는다. 몫이 \(0.4937\)일 때까지 가중중앙값은 \(4\)에 붙어 있고, \(0.5001\)이 되는 순간 \(100\)으로 건너뛴다. 동점인 \(0.5000\)에서는 위에서 말한 대로 \(4\)가 나왔다.
두 추정량이 무너지는 방식이 다르다는 점이 요점이다. 가중평균은 \(44.29 \to 50.63 \to 51.25 \to 56.67\)로 매끄럽게 끌려가 어디서부터 못 믿을지 알 수 없다. 가중중앙값은 임계값까지 꿈쩍도 않다가 한 번에 건너뛴다. 전자는 언제나 조금씩 틀리고, 후자는 대개 맞다가 가끔 통째로 틀린다.
보기 3. 중앙값 절대편차. \(N(0,1)\)에서 100개를 뽑고(\(\bar x = 0.0811\), \(s = 0.9670\)이 나왔다), 거기에 \(50\) 하나를 덧붙인다.
(1) 이상치를 더한 뒤의 표본표준편차 \(s'\)를 정확한 식으로 예측하시오. 같은 일이 MAD 에는 왜 일어나지 않는가.
(2) 코드로 확인하시오. 깨끗한 자료에서 \(s = 0.967\), \(1.4826 \times \text{MAD} = 1.049\)로 둘이 다른데, 어느 쪽이 더 미덥지 못한가.
풀이
(1) 해석적으로. 관측값 \(n\)개에 하나(\(y\))를 덧붙일 때 제곱합(sum of squares)이 어떻게 변하는지는 5.1절의 증명 상자에 있는 항등식을 두 덩어리에 적용하면 나온다. 크기 \(n_A\)·\(n_B\)의 두 그룹을 합칠 때
이고, 여기서는 \(B\)가 점 하나라 \(\mathrm{SS}_B = 0\)이다. 그러므로
이다. \(n = 100\), \(s = 0.9670\), \(\bar x = 0.0811\), \(y = 50\)을 넣으면
원래 제곱합 \(92.6\)에 견주어 새 점 하나가 \(2467\)을 보탰다. \(27\)배다. \(y\)를 키우면 \(s' \approx |y|/\sqrt{n+1}\)로 한없이 커지므로 표준편차의 붕괴점은 \(0\)이다.
MAD 에는 같은 일이 일어날 수 없다. MAD 는 편차의 중앙값이므로 그 값이 몇인지는 순위에만 달려 있고 크기에는 달려 있지 않다. \(y\) 하나를 더하면 중앙값의 자리가 한 칸 옮겨 갈 뿐이고, \(100\)개의 중앙값(50·51번째의 평균)이 \(101\)개의 중앙값(51번째)으로 바뀌는 정도다. \(y\)를 \(50\)이 아니라 \(10^6\)으로 해도 MAD 는 똑같이 나온다.
견줄 이론값도 적어 두자. \(N(0,1)\)에서 \(\text{MAD} \to \Phi^{-1}(0.75) = 0.6745\)이므로 \(1.4826 \times \text{MAD} \to 1\)이고 \(s \to 1\)이다. \(n = 100\)에서 두 추정량의 산포는 다르다. \(\operatorname{sd}(s) \approx 1/\sqrt{2(n-1)} = 0.0711\)이고, MAD 쪽은 정규에서의 효율이 \(37\%\)뿐이라
로 \(1.6\)배 넓다.
(2) 수치적으로.
def mad(data):
    """중앙값 절대편차. 편차를 제곱하지 않고 중앙값을 취한다."""
    med = np.median(data)
    return np.median(np.abs(data - med))


# 정규자료와 그 자료에 이상치 하나를 더한 것을 비교한다.
rng = np.random.default_rng(0)
clean = rng.normal(0, 1, 100)
dirty = np.append(clean, 50.0)     # 이상치 하나만 추가

for name, d in [("깨끗한 자료", clean), ("이상치 1개 추가", dirty)]:
    # 1.4826을 곱하면 정규분포에서 sigma의 일치추정량이 된다
    print(f"{name:16} 표준편차 {d.std(ddof=1):6.3f}   "
          f"1.4826*MAD {1.4826 * mad(d):6.3f}")
출력:
깨끗한 자료           표준편차  0.967   1.4826*MAD  1.049
이상치 1개 추가        표준편차  5.059   1.4826*MAD  1.063
(1)의 예측을 숫자로 맞춰 본다.
# (1) 의 합치기 항등식이 정말 맞는지 확인한다.
n = len(clean)
xbar, s = clean.mean(), clean.std(ddof=1)
pred = np.sqrt((( n - 1) * s**2 + n / (n + 1) * (50 - xbar)**2) / n)
print(f"clean: xbar = {xbar:.4f},  s = {s:.4f}")
print(f"예측 s' = {pred:.4f}   실제 s' = {dirty.std(ddof=1):.4f}")
print(f"MAD: clean {mad(clean):.4f}  ->  dirty {mad(dirty):.4f}")
# 이상치를 50 대신 100만으로 바꿔도 MAD 는 그대로다.
wilder = np.append(clean, 1e6)
print(f"이상치를 1e6 으로:  s' = {wilder.std(ddof=1):.1f},  MAD = {mad(wilder):.4f}")
출력:
clean: xbar = 0.0811,  s = 0.9670
예측 s' = 5.0594   실제 s' = 5.0594
MAD: clean 0.7073  ->  dirty 0.7173
이상치를 1e6 으로:  s' = 99503.7,  MAD = 0.7173
예측이 소수 넷째 자리까지 맞는다. 그리고 마지막 줄이 (1)의 두 번째 주장을 그대로 보여 준다. 이상치를 \(50\)에서 \(10^6\)으로, 곧 2만 배로 키우니 \(s'\)는 \(5.06\)에서 \(99{,}503.7\)로 함께 커졌지만 MAD 는 \(0.7173\)에서 한 자리도 움직이지 않았다. 근사식 \(|y|/\sqrt{n+1} = 10^6/\sqrt{101} = 99{,}503.7\)이 소수 첫째 자리까지 맞는 것도 볼 만하다. 이상치가 충분히 크면 \(s\)는 다른 자료를 잊고 이상치만 잰다.
(2)의 물음에는 "MAD 쪽이 더 미덥지 못하다"가 답이다. 깨끗한 자료에서 참값은 \(\sigma = 1\)인데 \(s = 0.967\)은 \(-0.46\) 표준오차, \(1.4826\,\text{MAD} = 1.049\)는 \(+0.42\) 표준오차 떨어져 있다. 거리는 비슷해 보이지만 자가 다르다. \(s\)의 표준오차는 \(0.071\)이고 MAD 쪽은 \(0.117\)이다. 깨끗한 자료에서는 MAD 가 \(s\)보다 \(1.6\)배 넓게 흔들린다. 이것이 로버스트성의 값이고, 이상치 하나가 들어오는 순간 그 값은 충분히 싸진다.
보기 4. 오염 아래에서 측도 견주기. \(N(50, 10^2)\)에서 100개를 뽑고, 거기에 \((200, 250, 300, -100, -150)\) 다섯 개를 섞어 \(n = 105\)로 만든다. 오염 비율이 \(4.8\%\)다.
(1) 깨끗한 자료에서 일곱 측도가 각각 얼마쯤 나와야 하는지와 그 표준오차를 적으시오.
(2) 오염된 자료의 평균과 표준편차는 모의실험 없이 정확히 예측할 수 있다. 다섯 이상치가 아는 수이기 때문이다. 예측하고 확인하시오.
풀이
(1) 이론값. \(\mu = 50\), \(\sigma = 10\), \(n = 100\)이다. 위치 쪽 넷은 모두 \(50\) 둘레에, 척도 쪽 셋은 각자의 보정상수만큼 떨어진 자리에 있어야 한다.
| 측도 | 기댓값 | 표준오차 | 근거 |
|---|---|---|---|
| 평균 | \(50\) | \(1.000\) | \(\sigma/\sqrt n\) |
| 중앙값 | \(50\) | \(1.253\) | \(\sqrt{\pi/2}\,\sigma/\sqrt n\) |
| \(10\%\) 절사평균 | \(50\) | \(1.028\) | 모의 (\(\mathrm{ARE} = 0.95\)) |
| \(20\%\) 절사평균 | \(50\) | \(1.067\) | 모의 (\(\mathrm{ARE} = 0.88\)) |
| 표준편차 | \(9.975\) | \(0.710\) | \(c_4\sigma\) (\(c_4 = 0.99748\)), \(\sigma\sqrt{1-c_4^2}\) |
| IQR | \(13.303\) | \(1.545\) | \(1.349\sigma\) |
| MAD | \(6.692\) | \(0.780\) | \(0.6745\sigma\) |
중앙값의 표준오차가 평균의 \(\sqrt{\pi/2} = 1.2533\)배라는 것이 앞 쪽 표본평균의 효율성에서 본 식이고, 그 역제곱 \(2/\pi = 0.637\)이 중앙값의 효율이다. 척도 쪽 세 줄의 기댓값은 \(n = 100\)에서 모의로 재어 적은 것이며, 셋 다 \(\sigma = 10\)보다 조금 작다. \(s\)는 \(c_4\)만큼, MAD 와 IQR 은 유한표본 편향(bias) 때문이다.
(2) 오염 자료의 정확한 예측. 두 그룹을 합칠 때 평균은 가중평균이고, 제곱합은 보기 3에서 쓴 항등식을 그대로 쓴다. 깨끗한 쪽을 \(A\)(\(n_A = 100\), 평균 \(a\), 제곱합 \(\mathrm{SS}_A = 99 s_A^2\)), 이상치 쪽을 \(B\)(\(n_B = 5\))라 하면
이다. 이상치 다섯 개의 평균은 \(b = (200+250+300-100-150)/5 = 100\)이고 그 제곱합은
이다. 깨끗한 쪽은 아래 출력이 주는 \(a = 48.9615\), \(s_A = 9.0817\), 곧 \(\mathrm{SS}_A = 8{,}165.2\)를 쓴다.
\(\mathrm{SS}\) 의 세 조각 크기를 보라. 깨끗한 100개가 보탠 것이 \(8{,}165\)인데 이상치 다섯 개가 \(175{,}000\)에 더해 중심 차이에서 \(12{,}400\)을 더 보탰다. 전체의 \(96\%\)가 관측값의 \(4.8\%\)에서 온다.
모의실험으로 둘을 다 확인한다.
np.random.seed(42)

# 평균 50, 표준편차 10 인 깨끗한 자료 100개.
clean = np.random.normal(loc=50, scale=10, size=100)

# 여기에 멀리 떨어진 값 다섯 개를 섞는다. 전체의 5%가 안 되는 양이다.
outliers = np.array([200, 250, 300, -100, -150])
contaminated = np.concatenate([clean, outliers])

# 같은 표를 두 자료에 대해 뽑아 어느 측도가 얼마나 흔들리는지 나란히 본다.
for label, data in [("Clean", clean), ("Contaminated", contaminated)]:
    print(f"\n{label} data (n = {len(data)}):")
    print(f"  Mean             = {data.mean():.2f}")
    print(f"  Median           = {np.median(data):.2f}")
    print(f"  Trimmed mean 10% = {trimmed_mean(data, 0.10):.2f}")
    print(f"  Trimmed mean 20% = {trimmed_mean(data, 0.20):.2f}")
    print(f"  Std dev          = {data.std(ddof=1):.2f}")
    print(f"  IQR              = {np.percentile(data, 75) - np.percentile(data, 25):.2f}")
    print(f"  MAD              = {mad(data):.2f}")
출력:
Clean data (n = 100):
  Mean             = 48.96
  Median           = 48.73
  Trimmed mean 10% = 49.11
  Trimmed mean 20% = 49.13
  Std dev          = 9.08
  IQR              = 10.07
  MAD              = 4.96

Contaminated data (n = 105):
  Mean             = 51.39
  Median           = 48.84
  Trimmed mean 10% = 49.24
  Trimmed mean 20% = 49.28
  Std dev          = 43.36
  IQR              = 11.15
  MAD              = 5.61
(2)의 예측을 네 자리까지 맞춰 본다.
# (2) 에서 손으로 계산한 두 값을 합치기 항등식으로 그대로 재현한다.
a, sA = clean.mean(), clean.std(ddof=1)
SS_A = 99 * sA**2
b = outliers.mean()
SS_B = ((outliers - b) ** 2).sum()
SS = SS_A + SS_B + (100 * 5 / 105) * (a - b) ** 2
print(f"clean: 평균 {a:.4f}  s {sA:.4f}  SS_A {SS_A:.1f}")
print(f"이상치: 평균 {b:.1f}  SS_B {SS_B:.1f}  중심차 항 {(100*5/105)*(a-b)**2:.1f}")
print(f"예측 오염평균 {(100 * a + 5 * b) / 105:.4f}   실제 {contaminated.mean():.4f}")
print(f"예측 오염 s   {np.sqrt(SS / 104):.4f}   실제 {contaminated.std(ddof=1):.4f}")
출력:
clean: 평균 48.9615  s 9.0817  SS_A 8165.2
이상치: 평균 100.0  SS_B 175000.0  중심차 항 12404.4
예측 오염평균 51.3919   실제 51.3919
예측 오염 s   43.3645   실제 43.3645
평균과 표준편차 둘 다 넷째 자리까지 맞는다. 모의실험이 아니라 산술이다. 이상치가 무엇인지 알면 평균과 표준편차가 어디로 갈지 정확히 계산되며, 그만큼 이 두 측도는 오염에 투명하게 끌려간다.
(1)의 표와 깨끗한 자료의 출력을 견주면 흥미로운 것이 하나 나온다.
| 측도 | 기댓값 | 표준오차 | 관측 | \(z\) |
|---|---|---|---|---|
| 평균 | \(50\) | \(1.000\) | \(48.96\) | \(-1.04\) |
| 중앙값 | \(50\) | \(1.253\) | \(48.73\) | \(-1.01\) |
| 표준편차 | \(9.975\) | \(0.710\) | \(9.08\) | \(-1.26\) |
| IQR | \(13.303\) | \(1.545\) | \(10.07\) | \(-2.09\) |
| MAD | \(6.692\) | \(0.780\) | \(4.96\) | \(-2.22\) |
이 표본은 IQR 과 MAD 가 유난히 작게 나온 표본이다. 각각 아래쪽 \(1.4\%\), \(1.0\%\) 자리에 있다. 둘이 나란히 낮은 것은 우연이 두 번 겹친 것이 아니라 \(\operatorname{corr}(\text{MAD}, \text{IQR}) = 0.93\)으로 거의 같은 것을 재기 때문이다. 둘 다 가운데 절반의 폭을 보는 통계량이라 자료의 중앙부가 유난히 촘촘하면 함께 작아진다. 같은 자료에서 \(s\)가 \(-1.26\)에 그친 것은 \(s\)가 꼬리까지 보기 때문이다.
그러니 이 쪽의 결론을 "로버스트 측도가 언제나 낫다"로 읽으면 안 된다. 깨끗한 자료만 놓고 보면 \(\hat\sigma_{\text{MAD}} = 1.4826 \times 4.96 = 7.35\)가 참값 \(10\)에서 \(26\%\) 빗나갔고 \(s = 9.08\)은 \(9\%\) 빗나갔다. 이상치가 없는 자료에서는 고전적 측도가 이긴다. 오염이 들어오는 순간 \(s\)가 \(43.36\)으로 날아가고 MAD 는 \(4.96 \to 5.61\)에 머무는 것이 뒤집히는 지점이다.
이상치의 영향
관측값 105개 중 이상치 5개가 평균을 2 남짓 옮기고(약 49에서 약 51로) 표준편차는 네 배 넘게 키운다. 반면 중앙값, 절사평균, IQR, MAD는 거의 영향을 받지 않는다.
보기 5. 오염을 늘려 가며 보는 붕괴점. 보기 4의 깨끗한 자료 100개에 값이 \(300\)인 이상치를 \(m = 0, 1, \dots, 20\)개 덧붙이며 여섯 측도를 따라간다.
(1) 표본평균과 표본중앙값이 \(m\)에 따라 어떻게 움직이는지 식으로 적으시오.
(2) \(10\%\) 절사평균은 정확히 어느 \(m\)에서 무너지는가. \(m\)을 하나 더 넣기 전까지는 멀쩡하다가 그 다음부터 꺾이는 자리를 유도하고 그림에서 확인하시오.
풀이
(1) 해석적으로. 평균은 그냥 가중평균이다. 깨끗한 100개의 평균을 \(a = 48.9615\)라 두면
이고, \(m \to \infty\)에서 \(300\)으로 간다. \(m = 1\)만 넣어도 \(51.447\)로 \(2.5\)나 올라간다. 붕괴점 \(0\)이란 이런 뜻이다.
중앙값은 전혀 다르게 움직인다. 덧붙인 \(m\)개가 모두 위쪽이므로 이들은 정렬된 자료의 맨 뒤 \(m\)칸을 차지할 뿐이고, 중앙값의 자리는 여전히 깨끗한 자료 안에 있다. 전체 크기가 \(n' = 100+m\)이므로
이다. 여기서 \(x_{(\cdot)}\)은 깨끗한 자료 100개의 순서통계량이다. 이상치의 값 \(300\)이 식에 들어오지 않는다. \(300\)을 \(3 \times 10^9\)으로 바꿔도 같은 값이 나온다. 중앙값이 올라가는 것은 이상치에 끌려서가 아니라 중앙값을 읽는 자리가 위로 밀려서이며, \(m \le 20\)에서 자리가 \(50.5\)번째에서 \(60.5\)번째로 열 칸 옮겨 간다. 깨끗한 자료의 그 구간이 촘촘하므로 이동 폭이 작다.
(2) 절사평균이 꺾이는 자리. \(n' = 100+m\)개에서 \(10\%\) 절사는 양 끝에서 \(k = \lfloor 0.1 n' \rfloor\)개씩 버린다. 이상치는 맨 위 \(m\)칸에 있으므로 \(m \le k\)이면 전부 버려지고 \(m > k\)이면 남는다. 조건을 풀면
이다. \(m = 11\)이면 \(\lfloor 111/10 \rfloor = 11 \ge 11\)이라 아직 안전하고, \(m = 12\)이면 \(\lfloor 112/10 \rfloor = 11 < 12\)라 이상치 하나가 창에 남는다. 따라서 꺾이는 자리는
다. 자료의 \(12/112 = 10.7\%\)가 오염된 지점이며, 이름값대로 \(10\%\) 언저리다. 참고로 창에 남는 이상치 수는 \(m - k\)이므로 \(m = 20\)에서는 \(20 - 12 = 8\)개가 평균에 섞인다.
그림으로 확인한다.
import matplotlib.pyplot as plt

# 앞에서는 오염 여부를 두 점(있다/없다)으로만 보았다. 여기서는 오염을
# 0개부터 20개까지 조금씩 늘려 가며 각 측도가 무너지는 지점을 찾는다.
n_out_range = range(0, 21)
means, medians, trims = [], [], []
stds, iqrs, mads_list = [], [], []

for n_out in n_out_range:
    # 300 짜리 이상치를 n_out 개 덧붙인다. 나머지 100개는 그대로다.
    extra = np.full(n_out, 300.0)
    data = np.concatenate([clean, extra])
    means.append(data.mean())
    medians.append(np.median(data))
    trims.append(trimmed_mean(data, 0.10))
    stds.append(data.std(ddof=1))
    iqrs.append(np.percentile(data, 75) - np.percentile(data, 25))
    mads_list.append(mad(data))

# 왼쪽은 중심의 측도, 오른쪽은 산포의 측도다. 평균과 표준편차는 처음부터
# 곧장 올라가고, 중앙값과 MAD 는 오염이 절반에 이를 때까지 버틴다.
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(13, 5))

ax1.plot(list(n_out_range), means, 'o-', label='Mean', markersize=4)
ax1.plot(list(n_out_range), medians, 's-', label='Median', markersize=4)
ax1.plot(list(n_out_range), trims, 'D-', label='Trimmed Mean (10%)', markersize=4)
ax1.set_xlabel('Number of outliers added (value = 300)')
ax1.set_ylabel('Estimated location')
ax1.set_title('Location Estimators vs Outlier Count')
ax1.legend()

ax2.plot(list(n_out_range), stds, 'o-', label='Std Dev', markersize=4)
ax2.plot(list(n_out_range), iqrs, 's-', label='IQR', markersize=4)
ax2.plot(list(n_out_range), mads_list, 'D-', label='MAD', markersize=4)
ax2.set_xlabel('Number of outliers added (value = 300)')
ax2.set_ylabel('Estimated scale')
ax2.set_title('Scale Estimators vs Outlier Count')
ax2.legend()

plt.tight_layout()
plt.show()
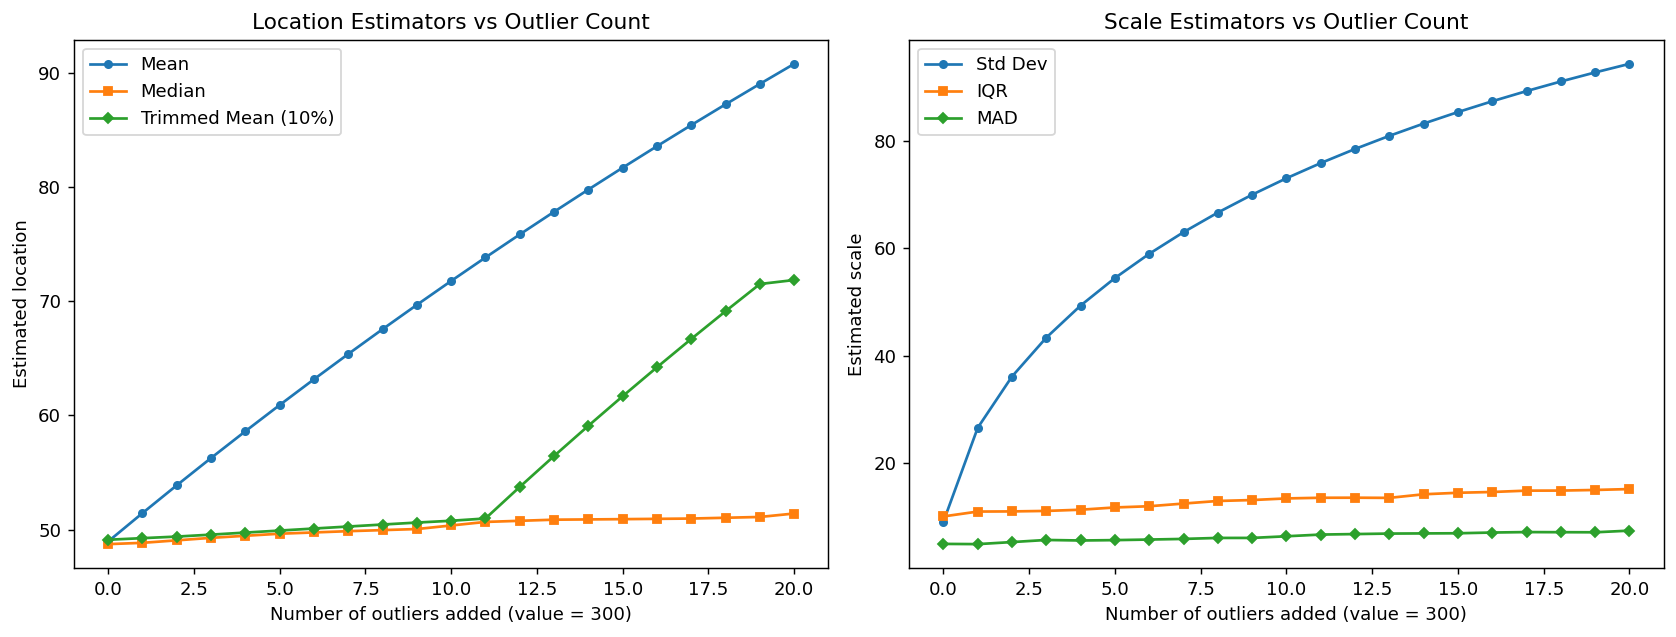
그림의 세 곡선을 수로 꺼내 (1)·(2)와 맞춰 본다.
# (1) 과 (2) 의 예측을 한 표에 모아 확인한다.
cs = np.sort(clean)              # 깨끗한 자료의 순서통계량
a = clean.mean()
print(f"{'m':>3} {'평균':>8} {'예측':>8} | {'중앙값':>8} {'예측':>8} | {'10%절사':>9} {'k':>3}")
for m in (0, 1, 5, 10, 11, 12, 13, 20):
    data = np.concatenate([clean, np.full(m, 300.0)])
    n2 = 100 + m
    k = int(np.floor(0.1 * n2))
    # 이상치가 모두 위쪽이므로 중앙값은 깨끗한 자료의 순서통계량에서 읽힌다
    pred_med = (cs[(n2 - 1) // 2] if n2 % 2 else
                0.5 * (cs[n2 // 2 - 1] + cs[n2 // 2]))
    print(f"{m:>3} {data.mean():>8.3f} {(100 * a + 300 * m) / n2:>8.3f} | "
          f"{np.median(data):>8.3f} {pred_med:>8.3f} | "
          f"{trimmed_mean(data, 0.1):>9.3f} {k:>3}")
출력:
  m       평균       예측 |      중앙값       예측 |     10%절사   k
  0   48.962   48.962 |   48.730   48.730 |    49.115  10
  1   51.447   51.447 |   48.844   48.844 |    49.253  10
  5   60.916   60.916 |   49.642   49.642 |    49.918  10
 10   71.783   71.783 |   50.363   50.363 |    50.777  11
 11   73.839   73.839 |   50.675   50.675 |    50.976  11
 12   75.859   75.859 |   50.773   50.773 |    53.743  11
 13   77.842   77.842 |   50.870   50.870 |    56.450  11
 20   90.801   90.801 |   51.411   51.411 |    71.866  12
평균과 중앙값의 예측이 셋째 자리까지 모두 맞는다. 그리고 (2)가 꼭 집어 말한 자리가 그대로 드러난다. \(10\%\) 절사평균은 \(m = 11\)까지 \(50.976\)으로 중앙값과 나란히 가다가 \(m = 12\)에서 \(53.743\)으로 \(2.8\)이나 뛴다. 그 뒤로는 한 걸음에 \(2.6\) 남짓씩 꾸준히 올라가 \(m = 20\)에서 \(71.866\)이 된다. 그림 왼쪽 판에서 초록 마름모가 \(x = 11\)과 \(12\) 사이에서 꺾이는 것이 이 자리다.
자세히 보면 마지막 걸음만 유독 짧다. \(m = 19\)에서 \(71.515\)이고 \(m = 20\)에서 \(71.866\)이라 \(0.35\)밖에 오르지 않았다. \(k = \lfloor 0.1 n' \rfloor\)이 \(m = 20\)에서 \(11\)에서 \(12\)로 한 칸 커져 창에 남는 이상치 수 \(m - k\)가 \(8\)에 그대로 머물렀기 때문이다. \(\lfloor \cdot \rfloor\)이 만드는 계단이고, 그림에서도 그 자리만 평평하다.
세 곡선의 모양이 서로 다른 것이 이 그림의 전부다.
- 평균(파랑): 처음부터 직선으로 올라간다. 안전한 구간이 아예 없다.
- \(10\%\) 절사평균(초록): \(m \le 11\)에서는 중앙값과 거의 겹쳐 있다가 임계값을 넘는 순간 평균과 같은 기울기로 꺾인다. 보호가 켜져 있다 꺼지는 스위치이지 서서히 약해지는 것이 아니다.
- 중앙값(주황): \(m = 20\)까지 \(48.73 \to 51.41\)로 \(2.7\)만 올라간다. 그나마도 이상치에 끌린 것이 아니라 읽는 자리가 밀린 것이다. 붕괴점이 \(50\%\)이므로 \(m = 100\)이 되어야 무너진다.
오른쪽 판도 같은 이야기다. 표준편차는 \(m = 1\)에서 벌써 \(9.08 \to 26.56\)으로 세 배가 되고, MAD 는 \(4.96 \to 7.42\)(\(m = 20\))로, IQR 은 \(10.07 \to 15.16\)으로 완만히 오른다. 두 로버스트 척도가 오르는 것도 이상치 값에 끌려서가 아니라 가운데 절반의 자리가 밀렸기 때문이다.
읽는 법 — 붕괴점이 가른다¶
- 평균과 표준편차는 깨끗한 정규 자료에서 최적이지만 이상치에 얼마든지 민감하다(붕괴점 0).
- 중앙값과 MAD는 붕괴점이 50%이다 — 자료의 절반 가까이가 오염되어도 여전히 유의미하다.
- 절사평균은 조절 가능한 절충안을 준다: 절사비율이 작으면 효율을 유지하면서 적당한 로버스트성을 얻는다.
- 가중추정량은 관측값의 품질이 다를 때 유용하지만, 가중치 자체가 로버스트하게 정해지지 않으면 가중평균은 여전히 이상치에 민감하다.
- 실무에서는 고전적 추정량과 로버스트 추정량을 함께 계산하는 것이 좋다. 둘이 크게 다르면 자료를 더 들여다볼 이유가 된다.
연습문제¶
연습문제 1. \(\{1, 3, 5, 7, 9, 11, 100\}\)의 20% 절사평균을 계산하라. 표본평균, 중앙값과 비교하라.
풀이
\(n = 7\), \(\alpha = 0.2\), \(k = \lfloor 1.4 \rfloor = 1\).
가장 작은 1개와 가장 큰 1개를 절사하면 \(\{3, 5, 7, 9, 11\}\)이 남는다. 절사평균 = \((3+5+7+9+11)/5 = 7\).
표본평균: \((1+3+5+7+9+11+100)/7 \approx 19.4\). 이상치에 지배된다.
중앙값: \(7\) (가운데 값).
절사평균과 중앙값은 모두 7을 주는 반면 표본평균은 오해를 부른다. 로버스트 추정량은 자료의 깨끗한 부분의 "전형적인" 값을 되찾아 준다.
연습문제 2. \(n = 30\)인 Gamma(3, 2) 자료에서 부트스트랩(bootstrap) 표준오차를 구하라. 평균과 중앙값에 대한 이론적/점근적 공식과 비교하라.
풀이
import numpy as np
from scipy import stats
rng = np.random.default_rng(0)
n, B = 30, 5000
x = rng.gamma(shape=3, scale=2, size=n)
mean_boot, med_boot = np.empty(B), np.empty(B)
for b in range(B):
    xb = rng.choice(x, size=n, replace=True)
    mean_boot[b] = xb.mean(); med_boot[b] = np.median(xb)
print(f"SE(mean): boot={mean_boot.std(ddof=1):.3f}, theory={x.std(ddof=1)/np.sqrt(n):.3f}")
m = np.median(x); f_hat = stats.gaussian_kde(x)(m)[0]
print(f"SE(med): boot={med_boot.std(ddof=1):.3f}, asymp={1/(2*f_hat*np.sqrt(n)):.3f}")
출력:
SE(mean): boot=0.577, theory=0.585
SE(med): boot=0.856, asymp=0.771
평균: 부트스트랩과 이론이 잘 일치한다.
중앙값: \(n = 30\)에서 부트스트랩이 점근 공식보다 대개 5–15% 크다 — 점근 공식은 아직 완전히 도달하지 않은 대표본 영역을 가정하기 때문이다. 부트스트랩이 유한표본 거동을 더 정확히 포착한다.
연습문제 3. 절사평균과 윈저화 평균의 붕괴점. 20% 절사에서 추정량을 얼마든지 멀리 밀어내려면 자료의 몇 퍼센트가 오염되어야 하는가?
풀이
20% 절사(\(\alpha = 0.2\), \(k = \lfloor 0.2n \rfloor\))에서 절사평균은 \(X_{(k+1)}\)부터 \(X_{(n-k)}\)까지를 평균한다. 이 평균을 얼마든지 움직이려면 절사 후 남는 범위 안쪽의 관측값을 적어도 하나 오염시켜야 한다 — 즉 가운데 관측값 하나를 극단적으로 만들어야 한다.
한쪽 꼬리의 순서통계량을 가운데로 밀어넣으려면 그 꼬리에서 \(k\)개보다 많은 오염이 필요할 수 있다. 실질적인 붕괴점: \(k/n = \alpha = 0.2\), 즉 20%.
일반 규칙: \(\alpha\)-절사평균의 붕괴점은 \(\alpha\)이다. 절사를 늘리면 로버스트성이 올라가고 정규 아래에서의 효율은 내려간다.
연습문제 4. 정규 자료에서 절사평균과 표본평균의 점근 상대효율. 절사를 늘릴수록 효율이 떨어지는 이유는?
풀이
절사는 정보를 버린다. 정규 자료에서는 모든 관측값이 평균에 관한 정보를 담고 있으므로 무엇을 버리든 유효표본크기가 줄어든다.
구체적으로 \(\alpha\)-절사평균의 점근분산은 대략 \(\sigma^2 \cdot c(\alpha)/n\)이며 \(\alpha > 0\)이면 \(c(\alpha) > 1\)이다. ARE = \(1/c(\alpha) < 1\).
전형적인 값: \(\alpha = 0.1\)이면 ARE \(\approx 0.94\). \(\alpha = 0.2\): \(\approx 0.87\). 중앙값(\(\alpha = 0.5\)): \(\approx 0.64\). \(\S 3\) 의 표와 같은 수이고, 이 쪽의 \(\alpha\) 는 한쪽에서 떼어 내는 비율이다 — 합계로 세는 관례의 \(0.97\)·\(0.94\) 를 여기 옮겨 적으면 위 쪽지가 경고한 그 혼동이 된다.
결론: 약한 절사(10–20%)는 정규 아래에서 효율을 거의 잃지 않으면서 상당한 로버스트성을 준다. 과감한 절사(중앙값 쪽으로)는 로버스트성의 이득이 크지 않은 채 효율만 잃는다(붕괴점 0.2 대신 0.5가 필요한 경우는 드물다).
연습문제 5. M-추정량은 절사평균을 일반화한다. 후버의 \(M\)-추정량과 그 붕괴점/효율을 간단히 설명하라.
풀이
후버의 M-추정량은 \(\sum \psi((X_i - \hat\mu)/s) = 0\)을 푼다. 여기서 \(|u| \le c\)이면 \(\psi(u) = u\), \(|u| > c\)이면 \(\psi(u) = c \cdot \text{sign}(u)\)이다. 가운데에서는 OLS처럼, 꼬리에서는 중앙값처럼 행동한다.
\(c\)가 작으면 중앙값처럼, \(c\)가 크면 표본평균처럼 행동한다.
표준적인 선택 \(c = 1.345 \sigma\) 는 정규 아래에서 효율 \(95\%\) 를 준다. 위치모수에 대한 후버 M-추정량의 붕괴점은 \(c\) 와 무관하게 \(0.5\) 다 — \(\psi\) 가 유계라 관측값 하나가 추정값을 끌고 갈 수 없기 때문이다. \(c\) 가 정하는 것은 붕괴점이 아니라 효율과 로버스트성의 트레이드오프이다.
실무에서 M-추정량이 절사평균을 앞서는 이유는 이렇다.
- OLS와 중앙값 사이를 매끄럽게 이어준다(급격한 절단이 없다).
- 공변량을 넣을 수 있다(로버스트 회귀).
- 중간 정도의 오염 수준에서 효율이 더 좋다.
statsmodels.RLM을 비롯한 대부분의 현대 통계 소프트웨어에서 기본 로버스트 추정량이다.
연습문제 6. 추정량별로 정리하라. 표본평균·중앙값·절사평균·M-추정량 각각에 대해 그것을 고를 조건을 적으시오. 아래 연습문제 10 은 같은 재료를 판단 순서로 다시 묶으므로, 여기서는 추정량 쪽에서 본다.
풀이
표본평균을 쓸 때는 이렇다.
- 자료가 근사적으로 대칭이고 대략 정규일 때.
- 완전한 효율이 필요할 때(큰 \(n\) 또는 정밀한 추정이 필요할 때).
- 이상치가 없다고 믿거나 이미 전처리했을 때.
중앙값을 쓸 때는 이렇다.
- 자료에 극단적인 이상치가 있거나 꼬리가 두꺼울 때.
- 최대 붕괴점(50%)을 원할 때.
- 효율이 중요하지 않을 때(큰 \(n\)을 쓸 수 있을 때).
절사평균을 쓸 때는 이렇다.
- 중간 정도의 이상치가 예상될 때(오염 5–20%).
- 효율과 로버스트성 사이의 절충을 원할 때.
- 단순하고 잘 알려진 추정량이 필요할 때.
M-추정량을 쓸 때는 이렇다.
- 유연성이 필요할 때(회귀 맥락, 사용자 정의 손실).
- 중간 정도의 오염에서 절사평균보다 나은 효율을 원할 때.
- 전용 소프트웨어를 쓸 수 있을 때.
실무에서는 깨끗한 자료에는 평균, "이상치가 잦은" 자료에는 중앙값, 판단이 서지 않으면 절사평균(10–20%)을 기본으로 삼는다.
연습문제 7. 로버스트 추정량으로 가설검정과 신뢰구간을 만드는 방법을 적어라. 절사평균에 기반한 \(t\) 검정(예이의 검정)의 자유도는 얼마인가?
풀이
예이(Yuen)의 절사평균 \(t\) 검정. 절사평균 \(\bar X_\alpha\)와 윈저화 분산 \(s_w^2\)을 써서
를 계산하고, 자유도 \(h-1\)인 \(t\) 분포와 비교한다. 여기서 \(h = n-2\lfloor\alpha n\rfloor\)은 절사 후 남은 관측 수다.
\(n=50\), \(\alpha=0.2\)면 \(\lfloor10\rfloor=10\)개씩 잘라 \(h=30\)이고 자유도가 29다. 표본평균 \(t\) 검정의 49보다 작다.
왜 윈저화 분산인가. 절사평균의 점근분산이
이고 \(\sigma_w^2\)이 윈저화한 분포의 분산이기 때문이다. 절사한 자료의 분산을 그냥 쓰면 안 된다. 잘라 낸 관측값이 여전히 변동에 기여하기 때문이며, 그것을 경계값으로 대체해 반영하는 것이 윈저화다.
다른 방법들.
- 부트스트랩. 가장 일반적이다. 절사평균의 부트스트랩 분포에서 백분위나 BCa 구간을 얻는다. 분포 가정이 거의 없고 비대칭 구간을 준다.
- 순열검정(permutation test). 두 집단 비교에서 절사평균 차이를 통계량으로 삼아 표지를 섞는다.
- M-추정량의 왈드 구간. \(\operatorname{SE}^2 = E[\psi^2]/\{n(E[\psi'])^2\}\)을 표본에서 추정해 \(\hat\theta\pm1.96\operatorname{SE}\).
성능. 예이의 검정은 꼬리가 두껍거나 치우친 자료에서 표본평균 \(t\) 검정보다 제1종 오류율이 훨씬 안정적이고 검정력도 높다. 윌콕스의 연구가 이를 폭넓게 보고했으며, 이분산이 있는 두 표본 비교에서도 웰치식 보정과 결합해 쓴다.
연습문제 8. 회귀에서의 로버스트 추정을 위치 문제와 견주어 설명하라. 잔차 이상치와 지렛값의 차이가 왜 중요한가?
풀이
두 종류의 이상치.
- 잔차 이상치(수직 이상치). \(y\)가 회귀선에서 크게 벗어나지만 \(x\)는 평범한 점. \(\psi\)를 유계로 만들면(후버 회귀) 잘 막힌다.
- 지렛값(leverage point). \(x\)가 자료 중심에서 멀리 떨어진 점. \(y\)가 직선 위에 있으면(좋은 지렛값) 오히려 추정을 정밀하게 해 주지만, 벗어나면(나쁜 지렛값) 회귀선 전체를 끌고 간다.
왜 중요한가. 위치 문제에서는 이상치가 한 종류뿐이지만 회귀에서는 둘이고, 둘을 막는 방법이 다르다.
| 방법 | 잔차 이상치 | 나쁜 지렛값 | 붕괴점 |
|---|---|---|---|
| 최소제곱 | 취약 | 취약 | 0 |
| 후버 M-추정 | 로버스트 | 취약 | 0 |
| GM-추정(유계영향) | 로버스트 | 어느 정도 | \(\le 1/(p+1)\) |
| LTS(최소절사제곱) | 로버스트 | 로버스트 | \(\approx 0.5\) |
| MM-추정 | 로버스트 | 로버스트 | 0.5 |
후버 회귀의 한계. \(\psi\)가 잔차를 자르지만, 지렛값이 큰 점은 잔차가 작게 나온다. 회귀선이 그 점을 지나도록 끌려갔기 때문이다. 잔차를 보고 판단하는 방법으로는 잡을 수 없다.
로 지렛값 \(h_{ii}\)가 1에 가까우면 잔차가 0에 가까워진다.
해결.
- 가중치를 \(x\)에도 준다. GM-추정량은 \(\psi(r_i)w(x_i)\) 꼴로 지렛값에도 가중치를 준다.
- 고붕괴점 방법. LTS는 \(n\)개 잔차 제곱 중 작은 \(h\)개의 합을 최소로 한다. \(x\) 공간의 이상치까지 자동으로 배제되지만 효율이 낮다(정규에서 약 7%).
- MM-추정. LTS로 고붕괴점 초기값을 잡고 재하강 M-추정으로 효율을 올린다. 붕괴점 0.5와 정규 효율 95%를 동시에 달성하며, 현재 표준적인 권고다.
진단이 먼저. 어느 방법을 쓰든 지렛값 \(h_{ii}\)와 스튜던트화 잔차를 그려 보는 것이 출발점이다. 쿡 거리(Cook's distance)가 둘을 결합한 영향력 척도이며, 큰 값을 보이는 관측값을 개별적으로 확인해야 한다.
연습문제 9. 로버스트 방법이 언제 오히려 나쁜 선택인지 세 가지 상황을 들어라.
풀이
(1) 자료가 실제로 정규에 가깝고 표본이 작을 때. 로버스트 방법은 정규에서 효율을 잃는다. \(n=15\)인 깨끗한 정규 자료에서 20% 절사평균을 쓰면 효율 13%를 버리는데(\(\S 3\) 의 표), 그 정도 표본에서는 13%가 아깝다. 이상치가 있다는 증거가 없으면 표준 방법이 낫다.
(2) 극단값이 관심 대상일 때. 로버스트 방법은 극단값의 영향을 줄이도록 설계되었다. 그런데
- 금융 위험관리: 꼬리 손실이 바로 관심사다.
- 보험 요율 산정: 대형 사고가 손해율을 좌우한다.
- 신뢰성 공학: 조기 고장이 문제다.
이런 경우 극단값을 눌러 버리는 것이 분석의 목적을 배반한다. 꼬리를 직접 모형화하는 극단값 이론이 필요하다.
(3) 왜도(skewness)가 분포의 본질일 때. 연습문제 18 이 보이듯, 로그정규 자료의 큰 값들은 오염이 아니다. 절사하면 추정 대상이 정의되지 않는 양으로 바뀐다. 이때는 변환이나 적절한 분포족을 쓰는 것이 옳다.
그 밖에.
- 결과를 보고해야 할 상대가 표준 방법을 기대할 때. 규제기관이나 학술지가 특정 방법을 요구하면, 로버스트 결과는 민감도 분석으로 곁들이는 편이 현실적이다.
- 표본이 매우 클 때. \(n\)이 충분히 크면 중심극한정리(central limit theorem)가 강하게 작동해 표본평균의 분포가 안정된다. 다만 분산이 무한하면 여전히 안 되므로 꼬리 진단은 해야 한다.
- 계산 비용이 문제일 때. MM-추정이나 MCD는 반복적이고 무겁다. 실시간 시스템에서는 부담이 될 수 있다.
권고. 로버스트 방법을 기본값으로 삼기보다 표준 방법과 함께 계산해 비교하는 것이 실용적이다. 두 결과가 비슷하면 안심하고 표준 결과를 보고하고, 크게 다르면 그 이유를 조사한다. 차이 자체가 진단 정보다.
연습문제 10. 같은 재료를 판단 순서로 묶어라. 자료를 받아 들고 어느 추정량으로 갈지 정하는 절차를 단계로 적고, 첫 단계가 「무엇을 추정하려는가」여야 하는 까닭을 밝히시오. 연습문제 6 이 추정량별로 적은 것을 여기서는 흐름으로 세운다.
풀이
1단계 — 무엇을 추정하려는가.
- 총액이나 기대값이 필요하다(세수, 총비용, 보험 기대손실) → 평균. 다른 선택지가 없다. 총액 = 평균 × 개수이기 때문이다.
- 전형적인 값이 필요하다(중위소득, 대표 가격) → 중앙값.
- 대칭 중심을 효율적으로 추정하고 싶다 → 다음 단계로.
2단계 — 자료를 본다.
- 히스토그램, 상자그림(box plot), Q-Q 그림을 그린다.
- 본체에서 뚝 떨어진 소수의 점 → 오염. 3단계로.
- 매끄럽게 이어지는 긴 꼬리 → 왜도. 1단계로 돌아가 목적을 다시 확인하거나 로그 변환을 고려한다.
- 대칭이고 이상치 없음 → 표본평균. 가장 효율적이다.
3단계 — 오염이 확인되면 원인을 조사한다.
- 기록 오류가 확인됨 → 고치거나 제외한다. 무엇을 왜 했는지 기록한다.
- 원인 불명이거나 실제 관측 → 로버스트 방법으로.
4단계 — 로버스트 추정량을 고른다.
| 상황 | 권장 |
|---|---|
| 기본값 | 20% 절사평균 또는 후버 M-추정(\(c=1.345\)) |
| 대칭성을 믿을 수 있음 | 호지스–레만(효율 95.5%) |
| 오염이 매우 심함(\(>25\%\)) | 중앙값 |
| 회귀 | MM-추정 |
5단계 — 반드시 함께 한다.
- 표준 방법과 로버스트 방법을 모두 계산해 비교한다. 큰 차이는 보고할 가치가 있는 발견이다.
- 적절한 표준오차를 쓴다. 절사평균에 \(s/\sqrt n\)을 쓰면 안 된다.
- 어떤 방법을 왜 썼는지 보고한다. \(\alpha\)나 \(c\) 같은 조율상수도 함께.
- 조율상수를 자료를 보고 고르지 않는다. 미리 정한다.
연습문제 11. 자료 \(\{1, 2, 3, 4, 5, 6, 7, 8, 9, 100\}\)에 대해 평균, 중앙값, 10% 절사평균을 계산하라. 어느 추정량이 "전형적인" 값을 가장 잘 나타내는가?
풀이
평균: \(\frac{1+2+3+4+5+6+7+8+9+100}{10} = \frac{145}{10} = 14.5\)
중앙값: 정렬한 자료가 10개이므로 중앙값은 5번째와 6번째의 평균이다: \((5+6)/2 = 5.5\).
10% 절사평균: \(n = 10\), \(\alpha = 0.10\)이므로 양 끝에서 \(k = \lfloor 10 \times 0.10 \rfloor = 1\)개씩 절사한다. 남는 것: \(\{2, 3, 4, 5, 6, 7, 8, 9\}\). 평균: \(44/8 = 5.5\).
평균(14.5)은 100이라는 이상치 하나 때문에 자료 대부분보다 훨씬 위로 끌려간다. 중앙값(5.5)과 절사평균(5.5)은 이 이상치를 무시하고 전형적인 값을 더 잘 나타낸다. \(\square\)
연습문제 12. 표본중앙값의 붕괴점이 \(\lfloor(n-1)/2\rfloor / n\)이며 큰 \(n\)에서 50%에 가까워짐을 증명하라.
풀이
관측값 \(x_1 \leq x_2 \leq \cdots \leq x_n\)을 생각하자. 중앙값은 대략 \(x_{(\lceil n/2 \rceil)}\)이다.
중앙값을 얼마든지 크게 만들려면 자료의 절반 이상이 극단이 되도록 충분히 많은 관측값을 바꿔야 한다. 구체적으로 \(\lceil n/2 \rceil\)개를 \(+\infty\)로 가는 값으로 바꾸어야 하며, 그러면 새 중앙값이 그 극단값 중 하나가 된다.
\(\lfloor (n-1)/2 \rfloor\)개만 바꾸면 원래 관측값이 적어도 \(\lceil (n+1)/2 \rceil\)개 남는다. 중앙값은 이 원래 값들 사이에 놓이므로 유계로 남는다.
따라서 붕괴점은 \(\lfloor (n-1)/2 \rfloor / n\)이다. \(n\)이 홀수이면 \((n-1)/(2n)\), 짝수이면 \((n-2)/(2n)\)이다. 두 경우 모두 \(n \to \infty\)일 때 붕괴점이 \(1/2 = 50\%\)에 가까워진다. \(\square\)
연습문제 13. \(X \sim N(\mu, \sigma^2)\)에서 \(\text{MAD} = \Phi^{-1}(3/4) \cdot \sigma \approx 0.6745\sigma\)임을 보이고, 따라서 \(1.4826 \times \text{MAD}\)가 \(\sigma\)의 일치추정량임을 보여라.
풀이
\(X \sim N(\mu, \sigma^2)\)에서 편차 \(|X - \mu|\)는 반정규분포를 따른다. \(|X - \mu|\)의 중앙값은 다음을 만족하는 값 \(m\)이다.
즉 \(P(-m \leq X - \mu \leq m) = 1/2\)이므로 \(\Phi(m/\sigma) - \Phi(-m/\sigma) = 1/2\), 따라서 \(2\Phi(m/\sigma) - 1 = 1/2\)이고 \(\Phi(m/\sigma) = 3/4\)이다.
그러므로 \(m = \sigma \Phi^{-1}(3/4) \approx 0.6745\sigma\)이다.
(참 중앙값 \(\mu\)를 쓴) 모집단 MAD는 \(0.6745\sigma\)와 같다. 표본중앙값의 일치성과 연속사상정리에 의해 표본 MAD는 모집단 MAD로 수렴한다.
따라서 \(\hat{\sigma} = \text{MAD}/0.6745 = 1.4826 \times \text{MAD}\)는 \(\sigma\)의 일치추정량(consistent estimator)이다. \(\square\)
연습문제 14. 관측값 200개의 자료에서 평균 50, 표준편차 10, 중앙값 49, MAD 6.5를 얻었다. 이상치나 비정규성의 증거가 있는가? 고전적 추정량과 로버스트 추정량의 비를 써서 답을 정당화하라.
풀이
정규성 아래에서 기대되는 바는 이렇다.
- 평균 \(\approx\) 중앙값: 여기서는 \(50 \approx 49\)로 잘 맞는다. 오른쪽으로 약간 치우쳤다.
- \(\text{MAD} \approx 0.6745\sigma\): 기대 MAD \(= 0.6745 \times 10 = 6.745\). 관측된 MAD \(= 6.5\). 비: \(6.5/6.745 = 0.964\).
- \(\hat{\sigma}_{\text{MAD}} = 1.4826 \times 6.5 = 9.637\) 대 \(s = 10\). 비: \(s/\hat{\sigma}_{\text{MAD}} = 10/9.637 = 1.038\).
고전적 표준편차가 로버스트 추정값보다 약 3.8% 클 뿐이다. 이상치가 상당했다면 \(s\)가 \(\hat{\sigma}_{\text{MAD}}\)보다 훨씬 컸을 것이다(비가 1.2 이상이면 우려할 만하다).
모든 짝(평균/중앙값, \(s\)/MAD 기반 \(\hat{\sigma}\))의 추정값이 거의 일치하므로 자료는 큰 이상치 오염 없이 근사적으로 정규라고 볼 수 있다. 약간의 불일치는 \(n = 200\)에서의 정상적인 표본변동 범위 안이다. \(\square\)
연습문제 15. \(\alpha\)-절사평균의 로버스트성–효율성 트레이드오프를 설명하라. \(n = 100\)인 정규 자료에서 표본평균 대비 10% 절사평균의 점근 상대효율은 얼마인가?
풀이
트레이드오프: \(\alpha\)를 키우면 로버스트성이 좋아지지만(붕괴점이 높아지지만) 정규 모형 아래에서 효율이 떨어진다(좋은 자료를 버리기 때문이다). \(\alpha = 0\)이면 평균(완전한 효율, 로버스트성 0)이고, \(\alpha \to 0.5\)이면 중앙값(최대 로버스트성, 정규 자료에서 효율 63.7%)에 가까워진다.
정규 자료에서 \(\alpha\)-절사평균의 점근분산은
꼴로 쓸 수 있으며, \(\alpha > 0\)이면 \(c(\alpha) > 1\)이다. 표본평균 대비 점근 상대효율(ARE)은
이다. \(\alpha = 0.10\)(10% 절사)이면 ARE가 대략 0.94이다(절사평균이 자료가 담은 정보의 약 94%를 쓴다).
즉 정규성 아래에서 효율을 약 6%만 잃으면서 붕괴점 10%를 얻는다(오염을 10%까지 견딘다). 일반적으로 훌륭한 트레이드오프로 여겨지며, 10% 절사평균이 많은 응용에서 인기 있는 기본값인 이유이다. \(\square\)
연습문제 16. 호지스–레만 추정량 \(\hat\mu_{\text{HL}} = \operatorname{median}_{i\le j}\dfrac{X_i+X_j}{2}\)을 정의하고, 붕괴점과 정규분포에서의 효율을 적어라.
풀이
정의. 모든 쌍(자기 자신과의 쌍 포함)의 평균 \(\binom{n+1}{2}\)개를 만들어 그 중앙값을 취한다. 이 값들을 월시 평균이라 한다.
성질.
| 항목 | 값 |
|---|---|
| 붕괴점 | \(1-1/\sqrt2 \approx 0.29\) |
| 정규분포 효율 | \(3/\pi \approx 0.955\) |
| 라플라스 효율 | 1.5 |
| \(t_3\) 효율 | 1.6 |
놀라운 조합이다. 정규분포에서 표본평균의 95.5% 효율을 내면서 붕괴점이 29%다. 중앙값(효율 64%, 붕괴점 50%)이나 표본평균(효율 100%, 붕괴점 0%)의 양극단 사이에서 대단히 유리한 지점이다.
왜 효율이 높은가. 중앙값은 자료를 순위로만 요약해 크기 정보를 버리지만, 호지스–레만은 쌍의 평균을 쓰므로 크기 정보를 상당 부분 살린다. 그러면서 중앙값을 취해 극단값의 영향을 막는다.
윌콕슨 검정과의 관계. 호지스–레만 추정량은 윌콕슨 부호순위 검정을 뒤집어 얻는 추정량이다. 즉 \(\hat\mu_{\text{HL}}\)을 귀무값으로 두면 윌콕슨 통계량이 정확히 중앙에 놓인다. 같은 방식으로 신뢰구간도 얻을 수 있어, 검정과 추정이 일관된다.
가정. 분포가 대칭이어야 한다. 치우친 분포에서는 평균도 중앙값도 아닌 값을 추정한다.
계산. 순진하게 하면 \(O(n^2)\)이지만 \(O(n\log n)\) 알고리즘이 알려져 있다. \(n\)이 수만 이하면 문제가 없다.
실무 권고. 대칭성을 믿을 수 있고 이상치가 걱정되면 호지스–레만이 절사평균보다 나은 선택인 경우가 많다. 조율상수를 정할 필요가 없다는 점도 장점이다.
연습문제 17. 로버스트 추정량의 표준오차를 어떻게 구하는지 세 가지 방법으로 설명하라. 표본평균의 \(s/\sqrt n\)에 해당하는 것이 무엇인가?
풀이
(1) 영향함수 기반(해석적). 점근분산이
이므로, \(\text{IF}\)의 공식이 있으면 그것을 표본에서 추정한다.
- 중앙값: \(\operatorname{SE} \approx \dfrac{1}{2\hat f(\tilde x)\sqrt n}\). 밀도 추정이 필요하다는 점이 걸림돌이다. 커널 밀도추정을 써야 하고 대역폭 선택에 민감하다.
- M-추정량: \(\operatorname{SE}^2 \approx \dfrac{E[\psi^2]}{n\{E[\psi']\}^2}\)을 표본 평균으로 추정한다. 밀도 추정이 필요 없어 실용적이다.
- 절사평균: 윈저화 분산으로
$$ \operatorname{SE}(\bar X_\alpha) \approx \frac{s_w}{(1-2\alpha)\sqrt n} $$
이며 \(s_w\)는 윈저화한 자료의 표준편차다. 계산이 간단해 가장 실용적이다.
(2) 부트스트랩. 재표집해 \(\hat\theta^*\)의 표준편차를 쓴다.
- 장점: 어떤 추정량에도 쓸 수 있고 밀도 추정이 필요 없다.
- 단점: 중앙값처럼 매끄럽지 않은 통계량에서는 수렴이 느리다(\(n^{-1/4}\)). 그래도 \(n\)이 어지간하면 실용적으로 잘 작동한다.
(3) 잭나이프. \(\hat\theta_{(-i)}\)들의 산포를 쓴다.
- 주의: 중앙값에는 쓰면 안 된다. 관측값 하나를 빼면 중앙값이 이웃 순서통계량으로 점프하므로 잭나이프가 일치하지 않는다. 매끄러운 M-추정량에는 괜찮다.
권고. M-추정량이나 절사평균이면 (1)의 공식이 빠르고 정확하다. 중앙값이나 복잡한 추정량이면 부트스트랩이 안전하다. 어느 경우든 \(s/\sqrt n\)을 그대로 쓰면 안 된다. 그것은 표본평균 전용 공식이다.
연습문제 18. 로버스트 추정량을 쓰기로 했을 때 무엇을 추정하고 있는지가 달라질 수 있다. 대칭분포와 치우친 분포로 나누어 설명하라.
풀이
대칭분포. 평균·중앙값·절사평균·호지스–레만·M-추정량이 모두 같은 대칭 중심을 추정한다. 따라서 어느 것을 쓸지는 순전히 효율과 로버스트성의 문제이며, 추정 대상이 달라지지 않는다.
치우친 분포. 사정이 완전히 다르다. 로그정규 \(\mu=0\), \(\sigma=1\)에서
| 추정량 | 추정 대상 | 값 |
|---|---|---|
| 표본평균 | 평균 \(e^{\sigma^2/2}\) | 1.649 |
| 중앙값 | 중앙값 \(e^{\mu}\) | 1.000 |
| 20% 절사평균 | (그 둘도 아닌 제3의 양) | 약 1.21 |
| 최빈값 | \(e^{\mu-\sigma^2}\) | 0.368 |
네 값이 모두 다르다. 그리고 절사평균이 추정하는 양은 이름이 없다. 절사 비율 \(\alpha\)에 따라 연속적으로 변하는 범함수일 뿐이다.
이것이 왜 문제인가.
- 결론이 방법에 의존한다. "평균 소득"을 묻는데 절사평균을 보고하면 무엇을 답한 것인지 불명확하다.
- 비교가 어긋난다. 두 집단을 비교하는데 한쪽은 평균, 한쪽은 절사평균이면 비교 자체가 성립하지 않는다.
- 이상치와 왜도를 혼동한다. 로그정규의 큰 값들은 이상치가 아니라 분포의 정상적인 일부다. 잘라 내면 오염을 제거하는 것이 아니라 분포를 왜곡하는 것이다.
권고.
- 먼저 왜도인지 오염인지 판단한다. 히스토그램과 Q-Q 그림을 본다. 매끄럽게 이어지는 긴 꼬리는 왜도고, 본체에서 뚝 떨어진 몇 점은 오염이다.
- 왜도면 목적에 맞는 양을 고른다. 총액이 관심이면 평균, 전형적인 값이 관심이면 중앙값. 로그 변환 후 분석하는 것도 방법이다.
- 오염이면 로버스트 추정량이 옳다. 추정 대상은 여전히 오염되지 않은 분포의 중심이다.
- 어느 쪽이든 무엇을 추정했는지 명시한다.
연습문제 19. 로버스트 추정과 이상치 제거 후 표본평균은 어떻게 다른가? 후자의 문제점을 지적하라.
풀이
표면적으로는 비슷하다. 둘 다 극단값의 영향을 줄인다. 실제로 \(\alpha\) 절사평균은 "양끝 \(\alpha\)를 지우고 평균"이다.
결정적 차이 — 규칙이 사전에 정해졌는가.
| 절사평균 | 이상치 제거 후 평균 | |
|---|---|---|
| 기준 | \(\alpha\)를 미리 고정 | 자료를 보고 판단 |
| 제거 개수 | 언제나 \(2\lfloor\alpha n\rfloor\) | 자료마다 다름 |
| 점근이론 | 확립되어 있음 | 없음 |
| 표준오차 | 계산 가능 | 계산된 값이 틀림 |
이상치 제거의 문제점.
-
표준오차가 틀린다. 제거 후 남은 자료로 \(s/\sqrt{n'}\)을 계산하면, 제거 과정에서 자료가 인위적으로 좁아진 것을 반영하지 못한다. 분산을 체계적으로 과소평가하고 신뢰구간이 부당하게 좁아진다.
-
규칙이 자료에 의존한다. "\(3\sigma\)를 넘으면 제거"라는 규칙에서 \(\sigma\) 자체가 이상치에 부풀려져 있다. 큰 이상치가 임계값을 높여 자기 자신을 숨긴다(가리기 효과, masking).
-
반복하면 더 나빠진다. 제거하고 다시 계산해 또 제거하는 절차는 언제 멈출지 기준이 없고, 정상 관측값까지 깎아 내려갈 수 있다.
-
선택적 제거의 유혹. 결과가 마음에 들지 않을 때 이상치를 더 찾게 된다. 의도하지 않아도 일어나는 편향이다.
-
정보를 버린다. 극단값이 오염이 아니라 실제 현상이면, 그것이야말로 가장 중요한 정보일 수 있다(금융 위기, 부작용, 장비 고장).
권고.
- 로버스트 추정량을 쓴다. 규칙이 사전에 정해져 있고 이론이 갖춰져 있다.
- 제거해야 한다면 기록 오류가 확인된 경우로 한정하고, 제거 전후 결과를 모두 보고한다.
- 진단은 하되 자동 삭제는 하지 않는다. 이상치를 찾아내 원인을 조사하는 것이 옳은 순서다.
연습문제 20. 자료에 이상치가 있는지 판정하는 로버스트 진단 규칙을 설계하라. 왜 표본평균과 표본표준편차 기반 규칙(\(|x-\bar x|>3s\))을 쓰면 안 되는가?
풀이
\(3s\) 규칙의 문제. \(\bar x\)와 \(s\)가 이상치에 오염된다.
구체적인 예로 \(\{1,2,3,4,5,6,7,8,9,1000\}\)을 보자.
- \(\bar x = 104.5\), \(s = 314.5\).
- \(|1000-104.5| = 895.5 < 3(314.5) = 943.5\)이므로 1000이 이상치로 판정되지 않는다.
이것이 가리기 효과다. 이상치가 \(s\)를 부풀려 자기 자신을 임계값 안에 숨긴다. 이상치가 여럿이면 서로를 가려 주어 더 심해진다.
반대로 늪 효과(swamping)도 있다. 이상치가 \(\bar x\)를 끌고 가서 정상 관측값이 임계값 밖으로 밀려난다. 위 예에서 \(1\)은 \(\bar x\)에서 103.5 떨어져 있다.
로버스트 규칙. 중심과 척도를 모두 로버스트하게 잡는다.
같은 자료에서 중앙값이 5.5, MAD가 2.5이므로 축척된 MAD가 3.71이고
로 명확히 이상치로 잡힌다. 정상값들은 모두 \(|z|<1\)이다.
1.4826의 유래. 정규분포에서 \(\text{MAD} = \Phi^{-1}(0.75)\sigma = 0.6745\sigma\)이므로, 그 역수 \(1/0.6745 = 1.4826\)을 곱하면 \(\sigma\)의 일치추정량이 된다.
다른 로버스트 규칙.
- 상자그림 규칙: \(Q_1-1.5\,\text{IQR}\) 아래 또는 \(Q_3+1.5\,\text{IQR}\) 위. 정규분포에서 0.7%가 걸리도록 맞춰져 있다. 치우친 자료에는 조정된 상자그림(메드커플(medcouple) 보정)을 쓴다.
- 다변량: 로버스트 마할라노비스 거리(MCD 기반). 위의 \(3s\) 규칙과 마찬가지로 표본 평균·공분산을 쓰면 가리기가 일어난다.
판정 뒤에 할 일. 규칙은 후보를 찾아 줄 뿐이다. 찾은 관측값을 실제로 확인해 기록 오류인지, 다른 모집단에서 온 것인지, 정상적인 극단값인지 판단해야 한다. 자동 삭제는 하지 않는다.
정리하며¶
로버스트 평균은 이상적인 조건에서의 약간의 효율을 내주고 모형 이탈에 대한 안정성을 산다.
- 절사평균은 양쪽 끝 \(\lfloor n\alpha\rfloor\) 개를 버리고 평균한다. \(\alpha=0\) 이면 표본평균, \(\alpha=0.5\) 면 중앙값이므로 하나의 모수로 두 극단을 잇는 연속적인 가족이다.
- 윈저화 평균은 버리는 대신 가장 가까운 극단 아닌 값으로 대체한다. 표본크기가 유지되어 분산 추정이 간단해지는 것이 장점이다.
- 붕괴점이 로버스트성의 척도다. 표본평균은 \(0\)(관측 하나로 무너진다), \(\alpha\)-절사평균은 \(\alpha\), 중앙값은 \(0.5\) 로 최대다.
- \(\alpha\) 의 선택이 거래 조건이다. \(\alpha=0.1{-}0.2\) 가 실무의 관례로, 정규분포에서 효율을 몇 퍼센트만 잃으면서 오염에 대한 저항을 크게 얻는다.
- 표준오차 계산이 까다롭다. 절사평균의 분산에는 간단한 닫힌 형태가 없어 윈저화 분산을 쓰거나 부트스트랩에 의존한다. 이것이 로버스트 방법의 실무적 비용이다.
"이상치를 버린다"와 "로버스트 추정량을 쓴다"는 다르다. 앞의 것은 자료를 보고 사후에 정하는 임의적 결정이고, 뒤의 것은 미리 정해진 규칙이라 그 성질을 계산할 수 있다.
다음 절부터 분산의 추정으로 넘어간다. 중심이 아니라 산포를 재는 문제다.