분산분석의 금융 응용
개요
들어가는 이야기 — 평균이 상쇄를 지운다
전체 기간을 통째로 평균하면 반대 방향의 두 효과가 상쇄되어 없는 것처럼 보인다. 그러면 「두 전략에 차이가 없다」는 보고가 나온다. 국면을 적어 두지 않으면 반대 부호의 두 수가 한 수로 접힌다.
모멘텀 전략은 상승장에서 한 달에 \(+2.53\%\) 를 내고 하락장에서 \(-2.16\%\) 로 무너진다. 방어형 전략은 두 국면에서 \(+0.38\%\) 와 \(-0.12\%\) 사이로 거의 평평하다. 그런데 상승장과 하락장이 섞인 \(120\) 개월을 통째로 평균하면 모멘텀의 두 수가 서로 지워져 평균이 \(0.2\%\) 쯤에 놓이고, 이표본 \(t\) 검정의 \(p\) 가 \(0.586\) 이 된다.
이원배치로 쪼개면 같은 자료가 다른 말을 한다. 전략의 주효과는 \(F = 0.64\) 로 정말 없다 — 평균 성과는 두 전략이 비슷하고, 거기까지는 \(t\) 검정이 맞았다. 그런데 국면이 \(F = 42.79\), 교호작용(interaction)이 \(F = 27.34\) 다. 곧 자료에 있던 것은 「어느 전략이 나은가」가 아니라 「어느 국면에서 어느 전략이 나은가」였고, 평균은 그 물음을 지워 버렸다.
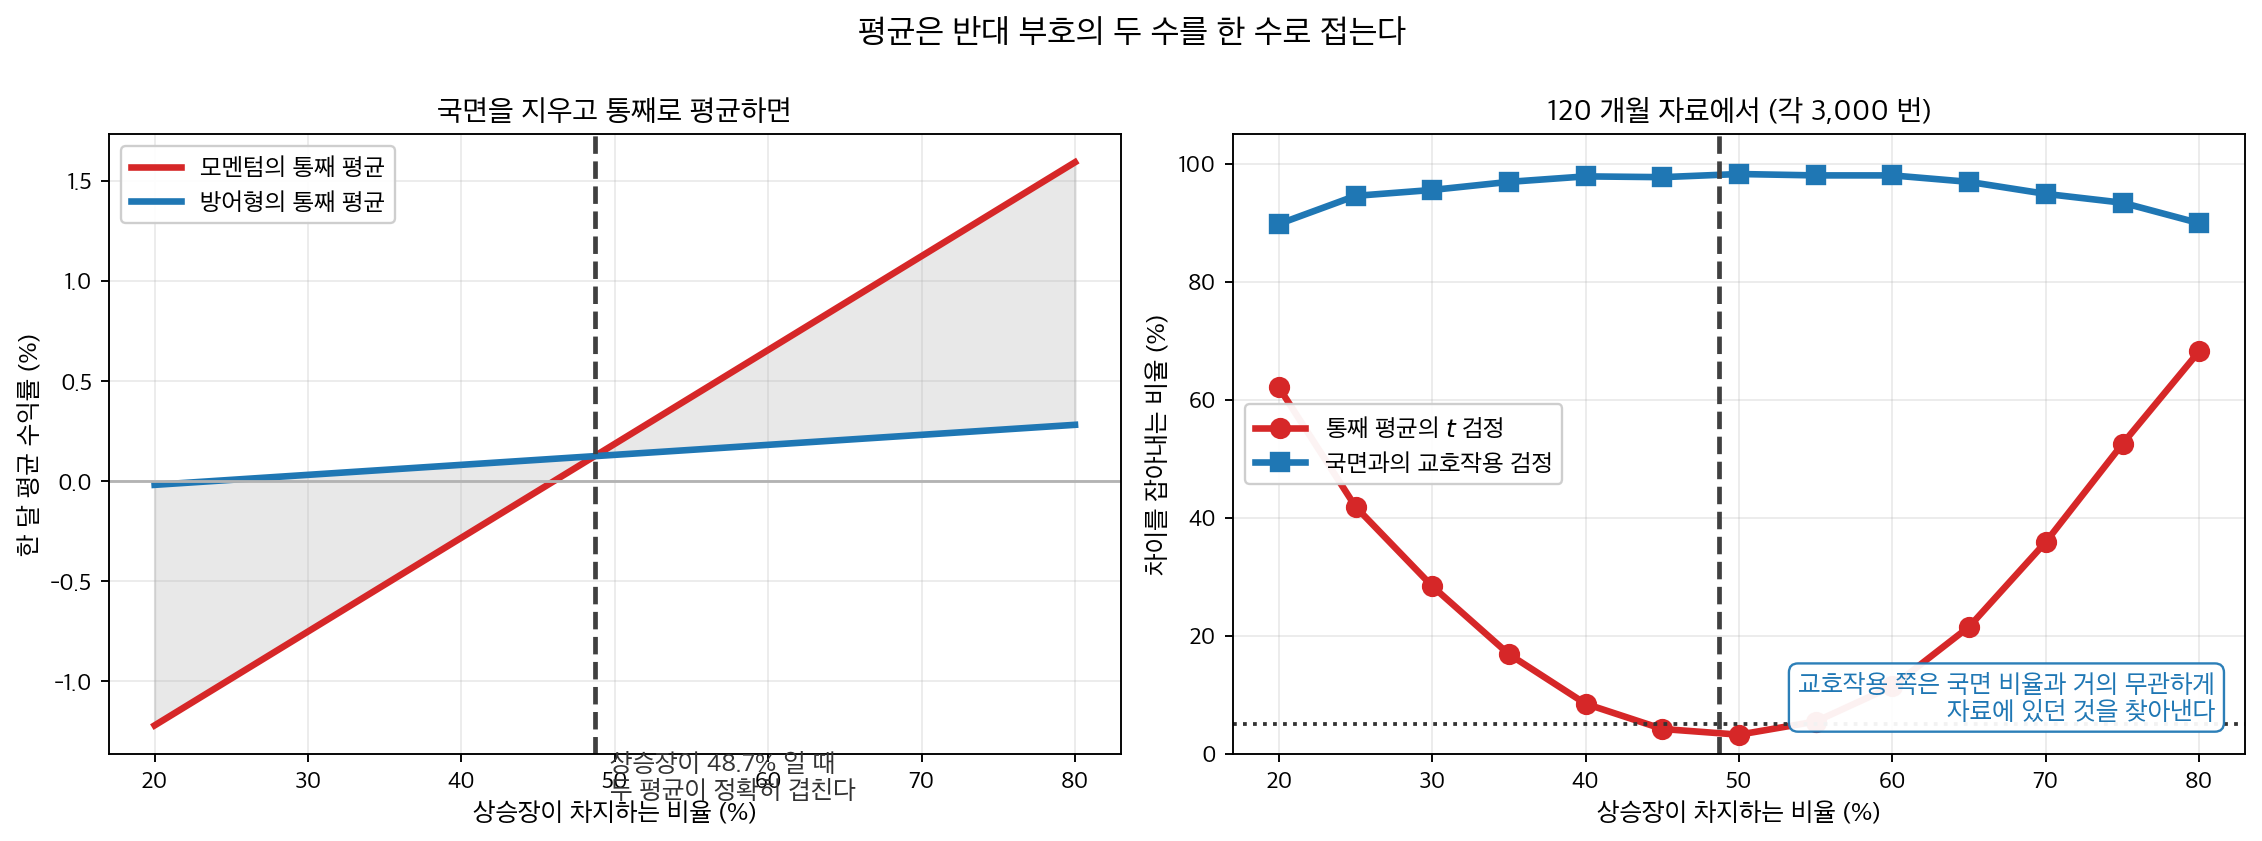
왼쪽. 상쇄는 아무 데서나 일어나지 않는다. 상승장이 \(48.7\%\) 일 때 모멘텀의 \(+2.53\) 과 \(-2.16\) 이 정확히 지워져 두 전략의 통째 평균이 겹친다. 자료가 그 근처에 있으면 \(t\) 검정은 「차이가 없다」고 말한다. 오른쪽. 그래서 \(t\) 검정의 검정력이 그 자리에서 \(3\%\) 까지 떨어진다 — 명목 \(5\%\) 보다도 낮다. 그런데 국면과의 교호작용 검정은 비율과 거의 무관하게 \(98\%\) 로 자료에 있던 것을 찾아낸다. 지워지는 것은 효과가 아니라 그 효과를 한 수로 접은 요약값이다.
그래서 보고할 수가 달라진다. 교호작용이 그만큼 크면 전략별 평균 하나가 아니라 국면별 평균 넷을 적어야 하고, 투자 결정도 「어느 전략을 고를까」에서 「지금이 어느 국면인가」로 옮겨 간다. 이 쪽은 먼저 금융 자료가 어기는 가정을 재고, 그다음 이 상쇄를 이원배치로 쪼갠다. 평균에서 상쇄되어 사라진 차이를 어느 분해가 드러내며, 그때 보고해야 할 수는 무엇인가. 아래 상자가 설명 요인이 셋을 넘어야 한다고 말한 논문을 따라간다.
확인한 곳 — 이 쪽 「셋을 넘어야 한다고 말한 논문」 상자와 그 출처 줄
금융 자료는 분산분석(analysis of variance)이 기대는 것을 거의 다 어긴다. 그런데 어기는 것들의 해로움이 통념과 반대다. 모두가 걱정하는 두꺼운 꼬리와 변동성 군집은 \(F\) 가 견디고(\(0.045\)·\(0.053\)), 아무도 세지 않는 공통 시장요인이 검정력을 통째로 가져간다. \(1\) 절이 그것을 재고 처방을 적는다.
그 위에 둘째 함정이 얹힌다 — 평균이 상쇄를 지운다. 국면을 적어 두지 않으면 반대 부호의 두 수가 한 수로 접혀 「차이가 없다」가 되고, 그 자리에서 \(t\) 검정의 검정력이 \(3\%\) 까지 떨어진다. \(2\) 절이 같은 자료를 이원배치로 쪼개어 무엇을 보고해야 하는지까지 간다.
\(3\) 절은 어디에 쓰는지의 목록이다 — 포트폴리오·섹터·팩터. 검정 자체는 \(10.1\) 과 \(10.2\) 에서 세운 것 그대로이고, 금융이 더하는 것은 새 검정이 아니라 위의 두 함정이다.
1. 걱정하는 것과 실제로 위험한 것이 다르다
금융 자료에 분산분석을 쓸 때 가장 먼저 나오는 걱정은 「수익률은 정규가 아니다」다. 꼬리가 두껍고, 왜도(skewness)가 있고, 변동성이 몰려 다닌다. 다 사실이다. 그런데 그 셋 다 \(F\) 를 망가뜨리지 않는다.
세 전략 \(\times\) \(60\) 개월에서 참 평균을 모두 같게 두고 수익률의 성질만 바꾸어 가며 \(5{,}000\) 번씩 재면 이렇다. 명목은 \(0.05\) 다.
| 수익률의 성질 | \(F\) 의 실제 오류율 | 판정 |
|---|---|---|
| 정규 (이상적) | \(0.0492\) | — |
| \(t_4\) 두꺼운 꼬리 | \(0.0454\) | 무해 |
| 왜도 (왜도 \(-1\)) | \(0.0528\) | 무해 |
| 변동성 군집 (GARCH) | \(0.0532\) | 무해 |
| 자기상관 \(\rho = 0.2\) | \(\mathbf{0.1312}\) | 위험 |
| 횡단면 상관 (공통 시장요인) | \(\mathbf{0.0010}\) | 위험 |
위험한 것은 분포가 아니라 상관이다. 균형 설계에서 중심극한정리(central limit theorem)가 꼬리와 왜도를 흡수해 주는 반면, 관측값이 서로 독립이 아니면 \(F\) 가 기대는 자유도 자체가 거짓이 된다. 재는 코드와 유도는 연습문제 7 에 있다.
마지막 줄이 가장 읽기 어렵다. 오류율 \(0.0010\) 은 명목의 \(50\) 분의 \(1\) 이니 「보수적이라 안전하다」로 읽고 싶어진다. 그 반대다. 전략들이 모두 같은 시장에 노출되어 있으면
에서 공통 요인 \(m_t\) 가 집단 내 변동 \(MSW\) 를 크게 부풀린다. 그런데 집단 평균의 차이는 \(m_t\) 의 영향을 거의 받지 않는다 — \(m_t\) 가 모든 전략에 똑같이 들어가 빼면 사라지기 때문이다. 그래서 \(F\) 의 분모만 커지고 분자는 그대로다. 기각을 못 하는 것이 아니라 기각할 힘이 없는 것이고, 그 대가는 오류율이 아니라 검정력에 나타난다(연습문제 8).
그래서 금융에서 분산분석이 기각하지 못했다는 말은 거의 정보가 없다
위의 두 상관에 더해 신호 자체가 작다. 기대수익률은 원래 극도로 부정확하게 추정되는 양이라(\(5.14\) 절), \(60\) 개월로 잡을 수 있는 전략 간 차이는 실무에서 의미 있는 크기보다 한참 크다. 연습문제 9 가 그 수를 구한다. 기각하지 못한 것을 「전략들이 같다」로 읽으면 안 되는 자리가 바로 여기다.
처방은 분포를 고치는 쪽이 아니라 설계를 고치는 쪽이다.
| 문제 | 처방 |
|---|---|
| 횡단면 상관 (공통 시장요인) | 반복측정 분산분석 · 초과수익률로 바꾸기 · 대응 비교 |
| 시계열 자기상관 | HAC 표준오차 · 시계열 모형 · 관측 간격 넓히기 |
| 집단 간 이분산 | 웰치 분산분석 (웰치의 일원배치 분산분석) |
마지막 줄만 분포에 관한 것이고, 그것도 변동성 군집이 아니라 전략 사이의 분산 차이를 뜻한다. 둘을 섞지 말 것 — 위 표가 재어 둔 대로 변동성 군집 자체는 무해하다.
2. 평균이 상쇄를 지운다 — 국면을 요인으로 넣는다
트레이더는 어떤 전략의 성과가 시장 국면(예: 상승장, 하락장, 횡보장)에 따라 달라지는지 평가하고 싶을 수 있다. 요인 A = 매매 전략, 요인 B = 시장 국면인 이원배치 분산분석(two-way analysis of variance)이 자연스럽다. 모형은
이며 \(Y_{ijk}\)는 국면 \(j\)의 기간 \(k\)에서 전략 \(i\)의 수익률, \(\alpha_i\)는 전략 \(i\)의 주효과, \(\beta_j\)는 국면 \(j\)의 주효과, \((\alpha\beta)_{ij}\)는 전략–국면 교호작용이다. 관심 있는 세 가지 가설검정은 다음과 같다.
- 전략 주효과: \(H_0: \alpha_1 = \alpha_2 = \cdots = 0\) (전략들의 평균 성과가 같다)
- 국면 주효과: \(H_0: \beta_1 = \beta_2 = \cdots = 0\) (국면이 평균 수익률에 영향을 주지 않는다)
- 교호작용: 모든 \(i, j\)에 대해 \(H_0: (\alpha\beta)_{ij} = 0\) (전략의 성과가 국면에 의존하지 않는다)
교호작용이 유의하면 특히 유익하다. 어떤 전략은 특정 국면에서 잘 작동하고 다른 국면에서는 부진함을 드러내며, 이는 국면을 고려한 자산배분에 직접적인 함의를 준다.
이 말의 힘은 주효과가 전혀 없는데도 교호작용이 있을 수 있다는 데 있다. 모멘텀 전략과 방어형 전략을 국면별로 20개월씩, 모두 120개월 관측한 자료를 보자.
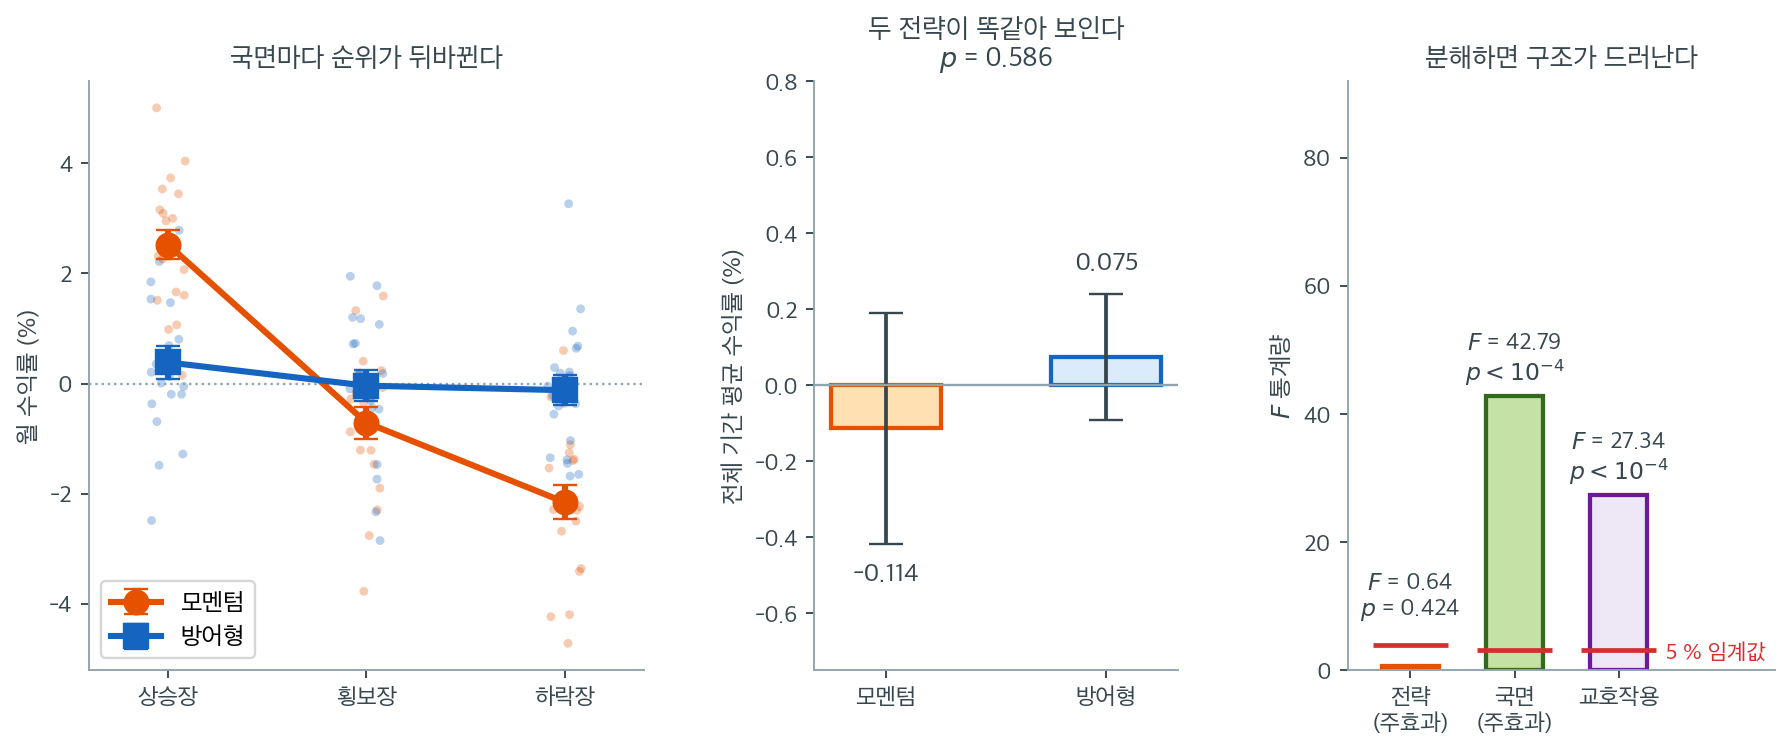
왼쪽에서 두 선이 상승장과 횡보장 사이에서 교차한다. 모멘텀은 상승장에서 월 \(+2.53\%\)를 내지만 하락장에서 \(-2.16\%\)로 무너진다. 방어형은 \(+0.38\%\)에서 \(-0.12\%\)까지 거의 평평하다. 국면에 따라 우열이 완전히 뒤집힌다.
가운데가 국면을 무시했을 때 보이는 그림이다. 전체 기간 평균은 모멘텀 \(-0.114\%\), 방어형 \(+0.075\%\)로 표준오차 안에서 구별되지 않는다. 이표본 \(t\)-검정의 \(p\)는 \(0.586\)이다. "두 전략의 성과에 차이가 없다"는 결론에 이르게 되는데, 이보다 잘못된 요약은 없다. 두 전략은 완전히 다르게 행동하고 있고, 단지 그 차이가 국면에 따라 부호를 바꾸면서 평균에서 상쇄되었을 뿐이다.
오른쪽이 이원배치 분산분석의 분해다. 전략의 주효과는 \(F = 0.64\), \(p = 0.424\)로 예상대로 유의하지 않다. 그러나 국면의 주효과는 \(F = 42.79\), 교호작용은 \(F = 27.34\)로 둘 다 \(p < 10^{-4}\)이다. 제곱합(sum of squares)으로 보면 국면이 \(142.06\), 교호작용이 \(90.76\)을 설명하는 반면 전략은 \(1.07\)에 불과하다. 자료의 구조가 전략 자체가 아니라 전략과 국면의 조합에 들어 있다는 뜻이다.
실무적 함의는 분명하다. 교호작용이 유의할 때 주변 평균 수익률을 보고하는 것은 정보를 감추는 일이다. 보고해야 할 것은 단순 효과 — 국면별로 따로 계산한 전략 차이 — 이고, 운용에 쓸 것은 "어느 전략이 더 나은가"가 아니라 "어느 국면에서 어느 전략을 쓸 것인가"이다. 이것이 국면 기반 자산배분(regime switching)의 통계적 근거이며, 백테스트 기간이 상승장에 치우쳐 있으면 왜 모멘텀 전략이 과대평가되는지도 같은 그림으로 설명된다.
3. 어디에 쓰는가
아래 셋은 \(10.1\) 의 일원배치와 \(10.2\) 의 이원배치를 금융의 말로 적은 것이다. 검정은 새로 배울 것이 없고, 달라지는 것은 집단을 무엇으로 정의하는가뿐이다. 다만 어느 쪽이든 \(1\) 절의 횡단면 상관이 따라오므로 같은 시점의 관측값이 서로 독립인지 먼저 따져야 한다.
포트폴리오 수익률 비교
포트폴리오 운용의 기본 질문 하나는 서로 다른 투자 전략이 의미 있게 다른 평균 수익률을 내는가이다. 어떤 분석가가 각기 다른 전략(예: 가치, 모멘텀, 저변동성)을 따르는 포트폴리오 \(k\)개를 운용하며 \(T\)개월 동안 월 수익률을 관측한다고 하자. 일원배치 분산분석(one-way analysis of variance)은
를 검정한다. 여기서 \(\mu_i\)는 전략 \(i\)의 모평균 월 수익률이다. 각 전략의 수익률이 근사적으로 정규이고 전략 사이의 분산이 같다면 F-통계량
은 \(H_0\) 아래에서 \(F_{k-1, \, N-k}\) 분포를 따르며 \(N = kT\)는 전체 수익률 관측 수이다.
등분산은 전략 사이의 이야기다
전략마다 변동성이 다르면 레빈 검정이 등분산을 기각하고, 그때는 고전 \(F\) 대신 웰치의 일원배치 분산분석을 쓴다. 여기서 말하는 것은 전략 사이의 분산 차이이지 한 계열 안의 변동성 군집이 아니다 — \(1\) 절이 잰 대로 변동성 군집 자체는 오류율에 무해하다.
섹터 분석
주식 분석가는 산업 섹터(예: 기술, 헬스케어, 에너지, 금융)에 따라 평균 수익률이 다른지 자주 묻는다. 여기서 집단은 섹터 분류로 정의되고, 각 관측값은 해당 섹터에 속한 종목의 일정 기간 수익률이다. 일원배치 분산분석의 가설은
이다. F-검정이 유의하면 섹터 소속이 수익률 변동의 의미 있는 부분을 설명함을 나타낸다. 그다음 사후 쌍별 비교(예: 투키 HSD)로 어느 섹터 쌍의 평균 수익률이 유의하게 다른지 찾는다. 효과크기(effect size) \(\eta^2 = \text{SSB}/\text{SST}\)는 전체 수익률 변동 중 섹터 차이로 설명되는 비율을 수치화한다.
팩터 모형 검정
파마–프렌치(Fama–French) 틀에서는 규모(시가총액)나 가치(장부가/시가 비율) 같은 특성에 따라 종목을 포트폴리오로 분류한다. 규모가 수익률의 횡단면 변동을 설명하는지 검정하려면 규모별 포트폴리오 \(k\)개를 만들어 평균 수익률에 일원배치 분산분석을 적용한다. 귀무가설(null hypothesis)은 모든 규모 집단이 같은 평균 수익률을 낸다는 것이다.
\(H_0\)을 기각하면 규모 프리미엄의 증거가 된다. 두 특성을 동시에 검정할 때(예: 규모와 가치)에는 이원배치 분산분석이 적절하며 모형은
이다. 여기서 \(\alpha_i\)는 규모 효과, \(\beta_j\)는 가치 효과, \((\alpha\beta)_{ij}\)는 규모와 가치 사이의 교호작용을 담는다. 교호작용 항이 유의하면 가치 프리미엄이 기업 규모에 의존함을(또는 그 반대를) 나타낸다.
그림으로 보는 통계학 1. 셋을 넘어야 한다고 말한 논문
위에서 팩터 하나의 유의성을 묻는 일은 간단해 보인다. \(t\) 를 구하고 \(2\) 를 넘는지 본다. 그런데 그 팩터가 몇 번째로 시험된 것인가를 묻는 순간 이야기가 달라진다.
\(2014\) 년 하비·류·주가 금융학계가 그때까지 발표한 수익률 예측 팩터를 세어 보았다. 학술지 논문 \(313\) 편과 작업논문 \(63\) 편을 훑어 팩터 \(316\) 개를 목록으로 만들었고, 그 수가 실제보다 적게 잡힌 것임을 스스로 밝혔다 — 「우리가 재어야 하는 것은 시험된 팩터의 수인데(관측할 수 없다) 유의수준을 넘지 못해 발표되지 않은 팩터는 보이지 않기 때문」이다.
그 위에서 그들이 내린 결론이 논문 초록에 있다.
「이만한 자료 채굴을 생각하면, 새로 발견된 팩터에 보통의 유의성 기준 — 이를테면 \(t\) 비가 \(2.0\) 보다 크다는 것 — 을 쓰는 일은 경제학적으로도 통계학적으로도 말이 되지 않는다. … 우리 모형의 추정은 새로 발견된 팩터가 훨씬 높은 임계값, 곧 \(t\) 비 \(3.0\) 을 넘어야 함을 시사한다. 의학 문헌의 최근 결론을 되울리며, 우리는 금융경제학에서 주장된 연구 결과 대부분이 거짓일 가능성이 높다고 본다.」
이것이 이 장의 다중비교(multiple comparisons) 문제이고, 재어 보면 그대로 나온다. 참 초과수익이 모두 \(0\) 인 전략 \(k\) 개를 월간 \(240\) 개(\(20\) 년치)로 만들어 보았다.
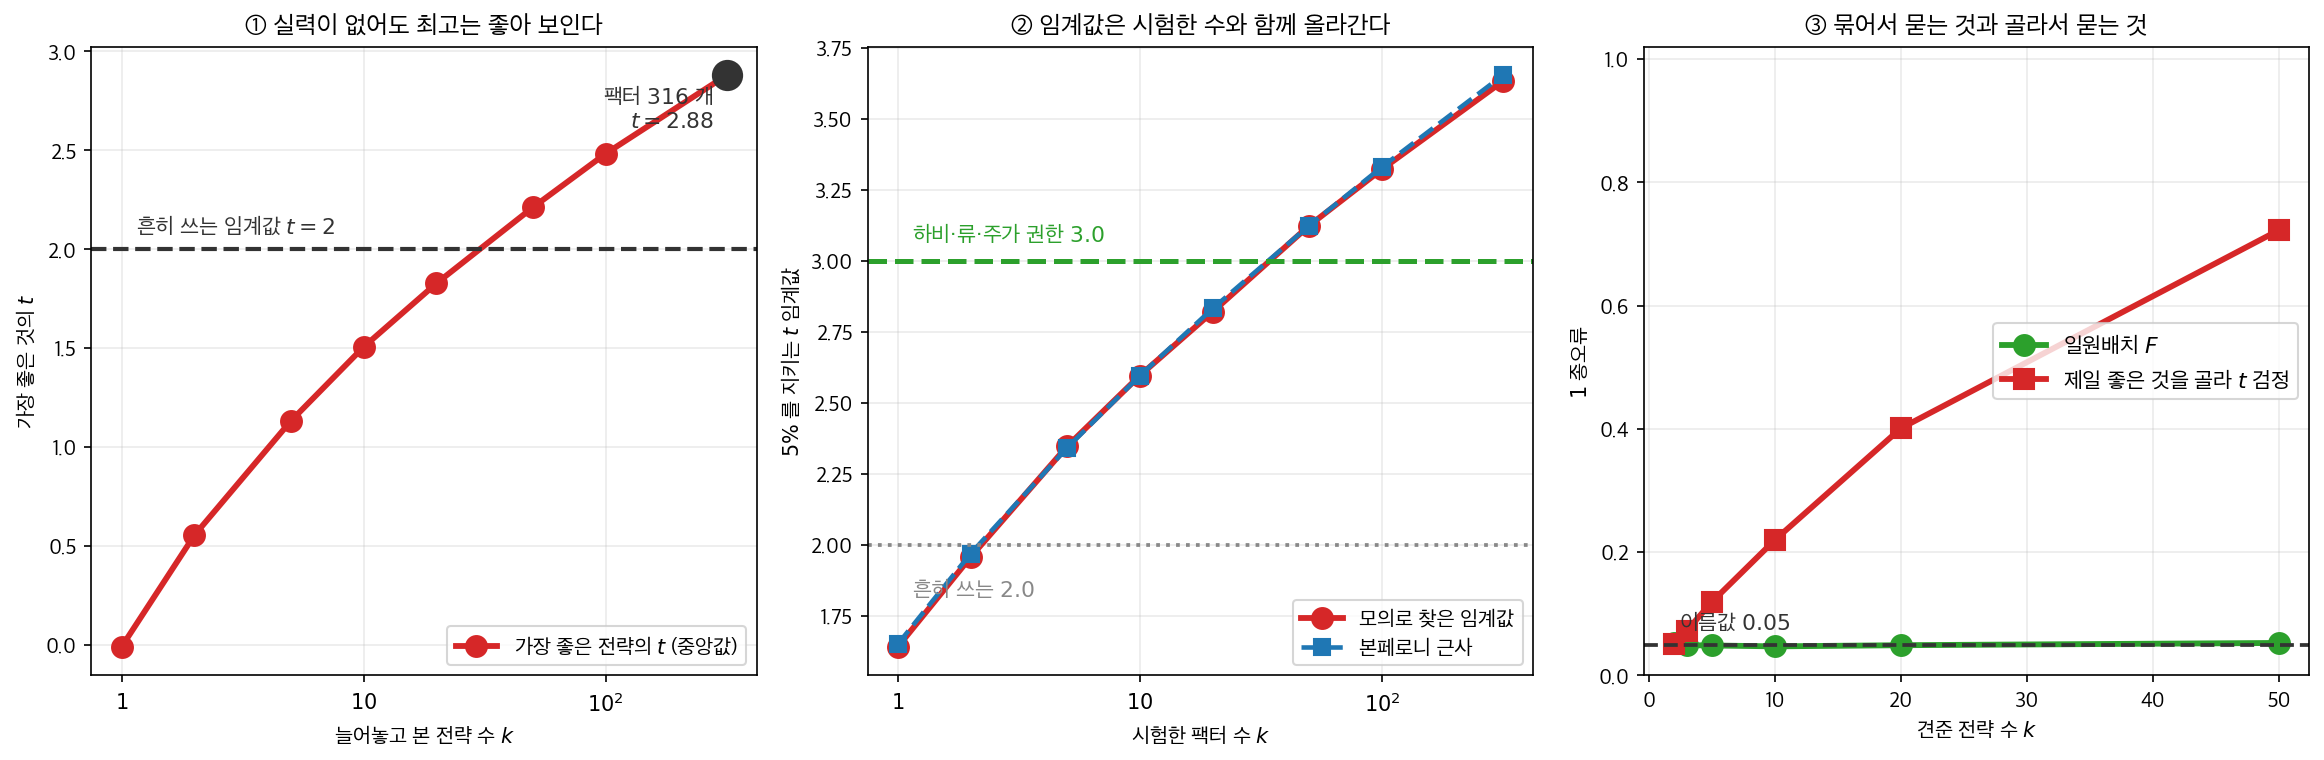
- ① 실력이 전혀 없는데도 가장 좋아 보이는 하나의 \(t\) 는 \(k\) 와 함께 올라간다. \(k = 10\) 이면 중앙값 \(1.51\), \(k = 50\) 이면 \(2.21\) 로 이미 임계값을 넘고, \(k = 316\) 이면 \(2.88\) 이다. 그 자리에서 \(t > 2.0\) 이 나올 확률은 \(0.999\) 다. \(316\) 개를 늘어놓으면 최고는 거의 반드시 좋아 보인다.
- ② 집단 전체의 \(1\) 종오류를 \(5\%\) 로 묶으려면 임계값을 얼마로 올려야 하는가. 모의로 찾은 값이 \(k = 10\) 에서 \(2.60\), \(k = 100\) 에서 \(3.32\), \(k = 316\) 에서 \(3.63\) 이고 본페로니 근사 \(3.66\) 과 거의 겹친다. 하비 등이 권한 \(3.0\) 은 이보다 낮은데, 가족 전체의 오류가 아니라 거짓발견율(false discovery rate)을 묶고 검정들 사이의 상관까지 넣었기 때문이다. 어느 쪽이든 \(2.0\) 은 아니다.
- ③ 이 장이 주는 답이 여기 있다. 참 평균이 모두 같을 때 일원배치 \(F\) 의 \(1\) 종오류는 \(k = 2\) 에서 \(0.053\), \(k = 50\) 에서 \(0.053\) 으로 \(k\) 와 무관하게 이름값을 지킨다. 반면 「제일 좋은 것을 골라 \(t\) 검정」은 \(0.051\) 에서 출발해 \(k = 50\) 에서 \(0.723\) 까지 간다. 묶어서 한 번 묻는 것과 보고 나서 골라 묻는 것은 다른 일이다.
보기 1 의 펀드 셋을 견줄 때 \(\S 3\) 이 세운 대로 \(F\) 를 먼저 돌리고 그 다음에 투키로 내려가는 순서가 괜히 있는 것이 아니다. 금융은 그 순서를 건너뛴 결과를 \(316\) 개의 팩터로 치렀다.
확인한 곳 — C. R. Harvey, Y. Liu, H. Zhu, … and the Cross-Section of Expected Returns, NBER Working Paper \(20592\) (\(2014\) 년 \(10\) 월; 뒤에 『Review of Financial Studies』에 실렸다). 인용한 초록 문장, 발표 논문 \(313\) 편과 작업논문 \(63\) 편에서 팩터 \(316\) 개를 목록으로 만든 것, 그리고 시험되었으나 발표되지 않은 팩터는 관측할 수 없어 그 수가 적게 잡혔다는 서술이 모두 거기 있다. 그림과 표의 수는 모두 직접 모의실험해 계산한 값이며 논문의 추정값이 아니다
보기 1. 세 펀드의 수익률 비교.
펀드 비교를 위한 일원배치 분산분석
어떤 분석가가 뮤추얼 펀드 세 개에 대해 월 수익률(%)을 네 개씩, 모두 12개 수집했다.
| 펀드 A | 펀드 B | 펀드 C |
|---|---|---|
| 1.2 | 0.8 | 2.1 |
| 0.9 | 1.1 | 1.8 |
| 1.5 | 0.6 | 2.4 |
| 1.1 | 0.9 | 1.9 |
풀이
**1단계: 집단 평균과 전체 평균을 계산한다.**

$\bar{Y}_A = 1.175$, $\bar{Y}_B = 0.850$, $\bar{Y}_C = 2.050$, $\bar{Y} = 1.358$

**2단계: 제곱합을 계산한다.**

$$
\text{SSB} = \sum_{i=1}^{3} n_i (\bar{Y}_i - \bar{Y})^2 = 4[(1.175 - 1.358)^2 + (0.850 - 1.358)^2 + (2.050 - 1.358)^2] \approx 3.082
$$

$$
\text{SSW} = \sum_{i=1}^{3} \sum_{j=1}^{4} (Y_{ij} - \bar{Y}_i)^2 \approx 0.528
$$

**3단계: 평균제곱과 F-통계량을 계산한다.**

$$
\text{MSB} = \frac{3.082}{3 - 1} = 1.541, \quad \text{MSW} = \frac{0.528}{12 - 3} = 0.0586
$$

$$
F = \frac{1.541}{0.0586} \approx 26.3
$$

**4단계: 판정.** 자유도 $k - 1 = 2$와 $N - k = 9$에서 $\alpha = 0.05$의 임계값은 $F_{0.05, 2, 9} \approx 4.26$이다. $26.3 \gg 4.26$이므로 $H_0$을 기각하고 세 펀드의 평균 수익률이 유의하게 다르다고 결론짓는다(p ≈ 0.0002).

**5단계: 사후분석.** 이어서 투키 HSD 검정으로 어느 펀드 쌍이 다른지 찾는다. 집단 평균을 보면 펀드 C의 뚜렷하게 높은 평균 수익률이 유의한 F-검정의 주된 원인일 가능성이 크다. 쌍별 비교 절차는 [투키 HSD](../post_hoc/tukey.md)를 보라.
연습문제
연습문제 1. 어떤 분석가가 세 투자 전략의 평균 월 수익률을 60개월에 걸쳐 비교했다. 분산분석의 F-통계량은 \(df_1 = 2\), \(df_2 = 177\)에서 4.21이다. \(\alpha = 0.05\)에서 전략들 사이에 유의한 차이가 있는가?
풀이
\(df_1 = 2\), \(df_2 = 177\)에서 임계값은 \(F_{0.05, 2, 177} \approx 3.05\)이다.
\(F = 4.21 > 3.05\)이므로 5% 수준에서 \(H_0\)을 기각한다. 적어도 한 전략의 평균 월 수익률이 다르다는 유의한 증거가 있다.
p 값은 F-분포에서 계산할 수 있다: \(P(F_{2, 177} > 4.21) \approx 0.016\). 어느 전략이 다른지 알려면 사후 쌍별 비교(예: 투키의 HSD)가 필요하다.
연습문제 2. 금융 자료에 분산분석을 적용할 때의 점검표를 만들어라.
풀이
핵심 수치 다섯.
| 사실 | 값 |
|---|---|
| 두꺼운 꼬리·GARCH의 영향 | 무해(0.045~0.053) |
| 자기상관 \(\rho=0.2\)의 오류율 | 0.131 |
| 횡단면 상관의 오류율 | 0.0003 |
| 반복측정으로 바꿀 때 검정력 | 0.385 → 0.906 |
| "가장 높은 달"을 고를 때 오류율 | 0.280 |
금융 자료의 특수성.
| 특징 | 분산분석에 미치는 영향 |
|---|---|
| 두꺼운 꼬리 | 거의 없음 |
| 변동성 군집 | 거의 없음 |
| 왜도 | 거의 없음 |
| 자기상관 | 오류율 2.6배 |
| 횡단면 상관 | 검정력 소멸 |
| 낮은 신호 대 잡음비 | 근본적 제약 |
통념과 반대로, 분포의 모양보다 상관 구조가 훨씬 중요하다.
점검표.
[설계]
  □ 비교 대상이 같은 기간을 공유하는가  →  반복측정/블록 설계
  □ 관심 비교가 몇 개인가  →  전체 F? 대조 비교? 모든 쌍?
  □ 검정력 계산 — 탐지 가능한 최소 차이는 얼마인가

[자료]
  □ 같은 기간·빈도·통화·배당 처리
  □ 생존 편향(survivorship bias) — 사라진 펀드가 빠졌는가
  □ 결측과 이상치(플래시 크래시 등)

[가정]
  □ 자기상관 (ACF, 더빈-왓슨)         ← 가장 중요
  □ 횡단면 상관 (전략 간 상관행렬)      ← 가장 중요
  □ 구조 변화 (기간을 나눠 재분석)
  □ 정규성은 마지막에 (대체로 무해)

[분석]
  □ 초과수익률 또는 팩터 조정 알파
  □ 반복측정 또는 블록 설계
  □ 자기상관이 있으면 HAC 표준오차
  □ 사후비교 보정

[보고]
  □ 효과크기(연환산 차이, 정보비율)와 구간
  □ 검정력의 한계를 명시
  □ 자료 준설 여부(사전 등록되었는가)
  □ 거래비용·세금 후에도 남는가
금융 특유의 함정 다섯.
| 함정 | 내용 |
|---|---|
| 자료 준설(data snooping) | 여러 전략·기간·지표를 탐색한 뒤 최선을 보고 |
| 생존 편향 | 망한 펀드가 자료에서 빠져 성과가 부풀려짐 |
| 선견 편향 | 당시에 알 수 없던 정보를 쓰는 백테스트 |
| 횡단면 상관 무시 | 독립집단 분산분석으로 검정력 소멸 |
| 거래비용 무시 | 통계적으로 유의해도 실행 후 사라짐 |
첫 번째가 가장 심각하다. "가장 높은 달"을 고르면 오류율이 0.280인데, 실무에서는 수백 개의 전략·기간·지표를 탐색한다. 그 뒤의 \(p\) 값은 아무 의미가 없다.
대응 — 표본 외 검증.
1. 자료를 훈련/검증 기간으로 나눈다
2. 훈련 기간에서 가설을 만든다
3. 검증 기간에서 그 가설만 검정한다
4. 검증 기간을 다시 쓰지 않는다
4번이 어렵다. 한 번 실패하면 다시 탐색하고 싶어지는데, 그러면 검증 기간이 훈련 기간이 되어 버린다.
결론 표.
| 질문 | 권장 방법 |
|---|---|
| 여러 전략의 평균 수익률 비교 | 반복측정 분산분석 또는 팩터 알파 |
| 펀드 대 벤치마크 | 초과수익률 일표본 검정 |
| 계절 이상현상 | 전체 분산분석 + 사전 지정 대비 |
| 섹터 비교 | 팩터 조정 후 반복측정 |
| 국면별 전략 성과 | 이원배치(전략 × 국면), 교호작용 |
한 문장. 금융 자료에서 분산분석의 적은 비정규성이 아니라 상관 구조와 낮은 신호 대 잡음비이며, 둘 다 설계로만 다룰 수 있다.
연습문제 3. 금융 수익률 자료가 분산분석의 가정을 자주 위반하는 이유를 설명하라. 가장 흔히 위반되는 가정이 무엇인지 밝히고 처방을 제시하라.
풀이
금융 수익률은 흔히 다음을 위반한다.
-
정규성(normality): 수익률은 두꺼운 꼬리(초과 첨도(kurtosis))를 보이고 때로 왜도도 있다. 극단적 사건(폭락, 급등)이 정규분포가 예측하는 것보다 자주 일어난다. 가장 흔히 위반되는 가정이다.
-
독립성(independence): 수익률에 계열상관(일간 수익률의 자기상관)이 있거나 변동성 군집(GARCH 효과)이 나타나 독립성 가정을 위반할 수 있다.
-
등분산: 전략이나 자산군마다 변동성이 다른 경우가 많다.
비정규성에 대한 처방: 집단당 \(n = 60\)개월이면 중심극한정리가 F-검정을 어느 정도 보호해 준다. 더 강한 로버스트성을 원하면 이렇게 한다.
- 크러스컬–월리스 검정(비모수(nonparametric) 대안)을 쓴다.
- 부트스트랩(bootstrap) 분산분석으로 분포 가정을 피한다.
- 분산분석 전에 순위 변환을 적용한다.
- 계열 의존에는 뉴이–웨스트 표준오차나 블록 부트스트랩을 쓴다.
연습문제 4. 어떤 포트폴리오 매니저가 자기 펀드의 평균 수익률이 두 벤치마크 지수와 다르다고 주장한다. 일원배치 분산분석을 써야 하는가, 더닛 검정을 써야 하는가? 설명하라.
풀이
더닛 검정이 더 적절하다. 매니저는 모든 집단을 쌍별로 비교하는 것이 아니라 하나의 처치(자기 펀드)를 여러 기준(두 벤치마크)과 비교하고 있기 때문이다.
더닛 검정은 "다대일" 비교를 위해 설계되었으며 이 비교 구조에서는 투키의 HSD나 본페로니보다 강력하다. 모든 \(\binom{k}{2}\)개의 쌍별 비교가 아니라 관심 있는 \(k - 1\)개의 비교(펀드 대 각 벤치마크)만 쓰면서 FWER을 통제한다.
일원배치 분산분석은 예비 전체검정으로 쓸 수 있지만, 어느 집단이든 다른 집단과 다른지를 검정하므로 매니저의 질문보다 넓다. 두 벤치마크가 서로 다르고 펀드는 둘 모두와 비슷하다면 분산분석은 기각하겠지만 매니저의 구체적인 질문에는 답하지 못한다.
연습문제 5. 달력의 월에 따라 평균 주식 수익률이 다른지("1월 효과"와 다른 계절 이상현상) 검정하는 데 분산분석을 어떻게 쓰는지 기술하라.
풀이
설정: 어떤 종목이나 지수의 월 수익률을 \(T\)년에 걸쳐 수집한다. 반응변수는 월 수익률이고 요인은 달력의 월(12개 수준: 1월, 2월, …, 12월)이다. 해마다 각 월에 관측값이 하나씩 생기므로 집단이 \(k = 12\)개, 집단당 관측값이 약 \(T\)개인 일원배치 분산분석 설계가 된다.
분산분석 검정: 귀무가설은 \(H_0: \mu_{\text{1월}} = \mu_{\text{2월}} = \dots = \mu_{\text{12월}}\)(계절 패턴 없음)이다. \(H_0\)을 기각하면 적어도 한 달의 평균 수익률이 유의하게 다름을 나타낸다.
후속 분석: 투키의 HSD나 더닛 검정으로 어느 달이 다른지 찾는다. 1월 효과를 특정해 검정하려면 1월의 평균을 나머지 11개월의 평균과 비교한다.
주의: 수익률은 달 사이에 계열상관이 있어 독립성을 위반할 수 있다. 겹치지 않는 연간 자료를 쓰거나 로버스트 표준오차를 적용하면 도움이 된다. 또한 과거 자료에서 발견된 달력 이상현상은 인지도와 거래가 늘면서 약해졌을 수 있다.
연습문제 6. 연습문제 4의 상황(펀드 하나 대 벤치마크 둘)을 구체적인 분석 계획으로 만들어라.
풀이
먼저 구조를 파악한다.
| 특징 | 이 상황 |
|---|---|
| 비교 대상 | 펀드 1개 대 벤치마크 2개 |
| 관심 비교 수 | 2개(벤치마크끼리는 관심 없음) |
| 자료 구조 | 같은 기간을 공유(횡단면 상관) |
| 대조군 | 벤치마크(둘) |
연습문제 4의 답 — 더넷도 일원배치도 최선이 아니다.
| 방법 | 문제 |
|---|---|
| 일원배치 \(F\) | "셋 중 어딘가 다르다"만 답함 |
| 더넷 | 대조군이 둘이라 표준 더넷이 맞지 않음 |
| 투키 | 벤치마크끼리 비교까지 보호(낭비) |
| 독립집단 가정 자체 | 같은 기간을 공유하므로 틀렸다 |
올바른 접근 — 초과수익률의 일표본 검정.
d1t = r_fund,t − r_bench1,t      (벤치마크 1 대비 초과)
d2t = r_fund,t − r_bench2,t      (벤치마크 2 대비 초과)

H0: E[d1] = 0   그리고   E[d2] = 0
왜 이것이 옳은가. 차이를 취하면
- 공통 시장 요인이 소거된다(연습문제 8)
- 각 검정이 자유도 \(T-1\)을 온전히 쓴다
- 해석이 직접적이다 — "벤치마크 대비 연 몇 %p"
분석 계획.
1. 자료 준비
   □ 같은 기간, 같은 빈도(월별)
   □ 배당·수수료 처리를 통일
   □ 결측 월 확인

2. 차이 계열 생성
   d1t, d2t 를 계산하고 시계열로 그린다

3. 가정 점검
   □ 자기상관 (더빈-왓슨, ACF) ← 가장 중요
   □ 정규성 (Q-Q, 비대칭·첨도)
   □ 구조 변화 (누적 차이 그림)

4. 검정
   □ 자기상관이 없으면: 일표본 t 검정 × 2, 홀름 보정
   □ 자기상관이 있으면: HAC(뉴이-웨스트) 표준오차
   □ 두꺼운 꼬리면: 순열검정 또는 부트스트랩

5. 보고
   □ 연환산 초과수익률과 95% 구간
   □ 정보비율 (초과수익 / 추적오차)
   □ 검정력 한계 (연습문제 9)
홀름 보정을 쓰는 이유. 비교가 2개뿐이고 사전에 정해져 있으므로 더넷의 상관 이득이 미미하다. 홀름이 간단하고 본페로니를 지배한다.
더 나은 방법 — 팩터 모형.
\(\alpha\)의 \(t\) 검정 하나로 끝난다. 벤치마크를 고를 필요도 없고, 위험 노출을 조정한 뒤의 초과수익을 직접 잰다.
| 초과수익률 \(t\) 검정 | 팩터 모형 \(\alpha\) | |
|---|---|---|
| 벤치마크 선택 | 필요 | 불필요 |
| 위험 조정 | \(\beta=1\) 가정 | 추정 |
| 다중성 | 벤치마크 수만큼 | 하나 |
| 해석 | "지수 대비" | "위험 조정 후" |
실무 권고. 벤치마크 비교와 팩터 알파를 둘 다 보고한다. 전자는 투자자에게 익숙하고, 후자는 통계적으로 엄밀하다.
검정력에 대한 정직한 진술. 연습문제 9가 보이듯, 60개월 자료로는 연 10%p 이상의 차이만 확실히 잡는다. 보고서에
"본 분석의 검정력은 연 \(X\)%p 의 초과수익을 탐지하는 데 80%이며, 그보다 작은 차이는 유의하지 않아도 배제할 수 없다."
를 반드시 넣는다.
연습문제 7. \(1\) 절의 표를 직접 재현하라 — 수익률의 성질을 하나씩 바꾸어 가며 \(F\) 의 실제 오류율을 재는 모의실험을 짠다. 아울러 흔한 처방 하나를 시험하시오. 분포가 문제라면 비모수검정이 고쳐 줄 것이다. 같은 여섯 조건에 크러스컬–월리스를 함께 돌려 그것이 통하는지 보고, 결과가 \(1\) 절의 진단과 어떻게 맞물리는지 밝히시오.
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

rng = np.random.default_rng(17001)
B = 5_000

def garch(n, rng, omega=0.05, a=0.10, b=0.85):
    """변동성 군집을 갖는 GARCH(1,1) 수익률."""
    s2 = omega / (1 - a - b)
    out = np.empty(n)
    for t in range(n):
        out[t] = np.sqrt(s2) * rng.normal()
        s2 = omega + a * out[t]**2 + b * s2
    return out

def ar1(n, rho, rng):
    e = rng.normal(0, np.sqrt(1 - rho**2), n)
    x = np.empty(n)
    x[0] = rng.normal()
    for t in range(1, n):
        x[t] = rho * x[t - 1] + e[t]
    return x

print("3전략 × 60개월, 참 평균 모두 같음. 명목 0.05")
print(f"{'수익률의 성질':>26s} {'F 오류율':>9s} {'KW 오류율':>10s}")
cases = {
    "정규 (이상적)": lambda: [rng.normal(0, 1, 60) for _ in range(3)],
    "t(4) 두꺼운 꼬리": lambda: [rng.standard_t(4, 60) for _ in range(3)],
    "비대칭 (왜도 -1)": lambda: [-(rng.gamma(4, 1, 60) - 4) / 2 for _ in range(3)],
    "변동성 군집 (GARCH)": lambda: [garch(60, rng) for _ in range(3)],
    "자기상관 ρ=0.2": lambda: [ar1(60, 0.2, rng) for _ in range(3)],
    "횡단면 상관 (공통요인)": None,
}
for lab, f in cases.items():
    a = b = 0
    for _ in range(B):
        if f is None:
            mkt = rng.normal(0, 1, 60)
            gs = [0.8 * mkt + rng.normal(0, 0.6, 60) for _ in range(3)]
        else:
            gs = f()
        a += stats.f_oneway(*gs).pvalue < 0.05
        b += stats.kruskal(*gs).pvalue < 0.05
    print(f"{lab:>26s} {a / B:9.4f} {b / B:10.4f}")
3전략 × 60개월, 참 평균 모두 같음. 명목 0.05
                   수익률의 성질     F 오류율     KW 오류율
                  정규 (이상적)    0.0492     0.0480
               t(4) 두꺼운 꼬리    0.0454     0.0462
               비대칭 (왜도 -1)    0.0528     0.0506
            변동성 군집 (GARCH)    0.0532     0.0496
                자기상관 ρ=0.2    0.1312     0.1266
             횡단면 상관 (공통요인)    0.0010     0.0014
\(F\) 열이 \(1\) 절의 표 그대로다. 두꺼운 꼬리와 왜도와 변동성 군집은 \(0.045\)~\(0.053\) 으로 명목을 지키고, 자기상관 \(\rho = 0.2\) 가 \(0.131\), 횡단면 상관이 \(0.001\) 이다. 까닭과 처방은 \(1\) 절에 적어 두었으므로 여기서는 둘째 물음으로 간다.
비모수로 바꾸어도 고쳐지지 않는다. 크러스컬–월리스 열을 보라.
| 수익률의 성질 | \(F\) | 크러스컬–월리스 |
|---|---|---|
| \(t_4\) 두꺼운 꼬리 | \(0.0454\) | \(0.0462\) |
| 변동성 군집 | \(0.0532\) | \(0.0496\) |
| 자기상관 \(\rho=0.2\) | \(0.1312\) | \(\mathbf{0.1266}\) |
| 횡단면 상관 | \(0.0010\) | \(\mathbf{0.0014}\) |
두 열이 사실상 같다. 위험한 두 줄에서 크러스컬–월리스도 똑같이 무너진다 — \(0.1266\) 과 \(0.0014\) 다.
이것이 \(1\) 절의 진단을 거꾸로 확인해 준다. 순위검정이 고쳐 주는 것은 분포이지 의존이 아니다. 크러스컬–월리스도 관측값이 서로 독립이라는 전제 위에서 자기 귀무분포를 세우므로, 그 전제가 깨지면 모수검정과 똑같이 틀린다. 그래서 「수익률이 정규가 아니니 비모수로 가자」는 처방은 무해한 것을 고치고 위험한 것은 그대로 둔다. 앞의 네 줄에서 두 열이 나란히 명목을 지키는 것이 그 말의 앞쪽이고, 뒤의 두 줄에서 나란히 무너지는 것이 뒤쪽이다.
연습문제 3의 답을 고쳐 쓰면.
| 통념 | 실제 |
|---|---|
| "수익률은 두꺼운 꼬리라 정규성이 깨진다" | 맞지만 \(F\)는 견딘다 |
| "변동성 군집이 문제다" | 오류율에는 무해 |
| "전략들이 같은 시장에 노출된다" | 가장 심각한 문제 |
| 자기상관 | 두 번째로 심각 |
처방.
| 문제 | 처방 |
|---|---|
| 횡단면 상관 | 반복측정 분산분석, 초과수익률, 대응 비교 |
| 자기상관 | HAC 표준오차, 시계열 모형, 관측 간격 확대 |
| 두꺼운 꼬리 | 대체로 무시 가능(표본이 작으면 순열검정) |
| 변동성 군집 | 무시 가능(또는 GARCH 모형화) |
연습문제 8. 연습문제 7이 발견한 횡단면 상관의 대가를 검정력으로 재고, 올바른 분석 방법을 보여라.
풀이
핵심 통찰. 전략들이 같은 기간을 공유하므로, 월이 블록 역할을 한다. 독립집단 설계가 아니라 반복측정(repeated measures, 블록) 설계로 봐야 한다.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

rng = np.random.default_rng(17002)
B = 4_000

def gen(mus, beta=0.8, sd_idio=0.6, T=60):
    """모든 전략이 같은 시장 요인에 노출된 수익률."""
    mkt = rng.normal(0, 1, T)
    return [beta * mkt + rng.normal(m, sd_idio, T) for m in mus]

print("3전략 × 60개월, 모두 시장에 β=0.8 로 노출. 명목 0.05")
print(f"{'상황':>24s} {'독립 F':>9s} {'반복측정 F':>11s} {'프리드먼':>9s}")
for lab, mus in [("귀무 μ=(0,0,0)", [0, 0, 0]),
                 ("대립 μ=(0,0.2,0.4)", [0, 0.2, 0.4]),
                 ("대립 μ=(0,0.1,0.2)", [0, 0.1, 0.2])]:
    a = b = c = 0
    for _ in range(B):
        gs = gen(mus)
        a += stats.f_oneway(*gs).pvalue < 0.05

        Y = np.array(gs)                       # k × T
        k, T = Y.shape
        gm, rm, cm = Y.mean(), Y.mean(1), Y.mean(0)
        SSt = T * ((rm - gm)**2).sum()         # 전략 효과
        SSe = ((Y - rm[:, None] - cm[None, :] + gm)**2).sum()
        F = (SSt / (k - 1)) / (SSe / ((k - 1) * (T - 1)))
        b += stats.f.sf(F, k - 1, (k - 1) * (T - 1)) < 0.05

        c += stats.friedmanchisquare(*Y).pvalue < 0.05
    print(f"{lab:>24s} {a / B:9.4f} {b / B:11.4f} {c / B:9.4f}")
3전략 × 60개월, 모두 시장에 β=0.8 로 노출. 명목 0.05
                      상황      독립 F      반복측정 F      프리드먼
            귀무 μ=(0,0,0)    0.0003      0.0570    0.0535
        대립 μ=(0,0.2,0.4)    0.3852      0.9060    0.8003
        대립 μ=(0,0.1,0.2)    0.0200      0.3543    0.2620
반복측정 분산분석이 검정력을 2.4배로 올린다(0.906 대 0.385).
| 상황 | 독립 \(F\) | 반복측정 \(F\) | 프리드먼 |
|---|---|---|---|
| 귀무 | 0.0003 | 0.057 | 0.054 |
| 대립 \(\mu_3=0.4\) | 0.385 | 0.906 | 0.800 |
| 대립 \(\mu_3=0.2\) | 0.020 | 0.354 | 0.262 |
독립 \(F\)의 귀무 오류율이 0.0003이다. 명목의 170분의 1로, 사실상 아무것도 기각하지 않는다.
왜 블록 설계가 이기는가. 월별 시장 변동 \(m_t\)가 모든 전략에 공통이므로, 블록 효과로 빼내면 오차에서 사라진다.
여기서 \(\beta^2\sigma_m^2=0.64\), \(\sigma_\varepsilon^2=0.36\)이므로 오차가 2.8배 줄어든다.
이것이 독립성 위반의 "좋은 쪽" 사례다. 상관을 인정하고 모형에 넣으면 오히려 이득이다.
금융에서의 표준 실천 넷.
| 방법 | 내용 |
|---|---|
| 초과수익률 | \(r_{it}-r_{ft}\) 또는 \(r_{it}-m_t\)로 시장을 뺀다 |
| 반복측정/블록 설계 | 월을 블록으로 |
| 팩터 모형 잔차 | CAPM·파마–프렌치로 조정한 알파를 비교 |
| 대응 비교 | 두 전략이면 차이 계열 \(r_{1t}-r_{2t}\)의 \(t\) 검정 |
세 번째가 학술 표준이다. 전략의 알파를 비교하면 공통 요인이 이미 제거되어 있다.
프리드먼 검정은 반복측정의 비모수판이다. 검정력이 0.800으로 모수 방법(0.906)보다 낮지만, 정규성 없이도 작동한다. 수익률이 극단적으로 두껍다면 고려할 만하다.
주의 — 구형성(sphericity) 가정. 반복측정 분산분석은 블록 내 공분산 구조에 조건이 있다. 전략 간 상관이 서로 다르면 그린하우스–가이서 보정이 필요하다.
연습문제 9. 연습문제 1의 \(F=4.21\)(\(df=2,177\))을 재해석하라. 60개월 자료에서 실제로 탐지 가능한 수익률 차이는 얼마인가?
풀이
import numpy as np
from scipy import stats

k, T = 3, 60
N = k * T
dfe = N - k
print(f"k={k}, 전략당 T={T}개월, ν={dfe}")
print(f"F = 4.21,  임계값 = {stats.f.ppf(0.95, k - 1, dfe):.4f},  "
      f"p = {stats.f.sf(4.21, k - 1, dfe):.4f}")
print(f"η² = {2 * 4.21 / (2 * 4.21 + dfe):.4f},  "
      f"ω² = {(2 * (4.21 - 1)) / (2 * 4.21 + dfe + 1):.4f}")

print("\n검정력 0.80 을 얻는 데 필요한 효과크기 (월 수익률 표준편차 σ 기준)")
print(f"{'월 변동성 σ':>12s} {'필요한 Cohen f':>14s} "
      f"{'최대-최소 평균차':>16s} {'연환산':>10s}")
for sd in [0.01, 0.02, 0.04, 0.06]:
    # f 를 이분법으로 찾는다
    lo, hi = 0.0, 2.0
    for _ in range(60):
        mid = (lo + hi) / 2
        lam = N * mid**2
        pw = stats.ncf.sf(stats.f.ppf(0.95, k - 1, dfe), k - 1, dfe, lam)
        if pw < 0.80:
            lo = mid
        else:
            hi = mid
    f = hi
    # μ=(−d/2, 0, d/2) 형태이면 f = d/(σ√6)
    d = f * sd * np.sqrt(6)
    print(f"{sd:12.2%} {f:14.4f} {d:16.2%} {12 * d:10.2%}")

print("\n관측된 F=4.21 에 대응하는 효과크기")
f_obs = np.sqrt(2 * 4.21 / N)
print(f"  Cohen f = {f_obs:.4f}")
for sd in [0.02, 0.04]:
    print(f"  월 변동성 {sd:.0%} 이면 최대-최소 평균차 "
          f"{f_obs * sd * np.sqrt(6):.2%}/월 = "
          f"{12 * f_obs * sd * np.sqrt(6):.2%}/년")
k=3, 전략당 T=60개월, ν=177
F = 4.21,  임계값 = 3.0470,  p = 0.0164
η² = 0.0454,  ω² = 0.0344

검정력 0.80 을 얻는 데 필요한 효과크기 (월 수익률 표준편차 σ 기준)
     월 변동성 σ    필요한 Cohen f        최대-최소 평균차        연환산
       1.00%         0.2333            0.57%      6.86%
       2.00%         0.2333            1.14%     13.72%
       4.00%         0.2333            2.29%     27.43%
       6.00%         0.2333            3.43%     41.15%

관측된 F=4.21 에 대응하는 효과크기
  Cohen f = 0.2163
  월 변동성 2% 이면 최대-최소 평균차 1.06%/월 = 12.71%/년
  월 변동성 4% 이면 최대-최소 평균차 2.12%/월 = 25.43%/년
\(p=0.0164\)로 유의하다. 연습문제 1의 답이 확인된다.
그런데 효과크기가 작다. \(\eta^2=0.045\), \(\omega^2=0.034\)로 전체 변동의 3~5%만 전략 차이로 설명된다.
검정력 관점에서 보면 문제가 드러난다.
| 월 변동성 | 탐지 가능한 연 수익률 차이 |
|---|---|
| 1% | 6.9%p |
| 2%(전형적 주식) | 13.7%p |
| 4% | 27.4%p |
월 변동성 2%(연 7%)인 전략에서 60개월로 탐지할 수 있는 것은 연 13.7%p 차이다. 이것은 엄청나게 큰 차이다.
실무에서 관심 있는 차이는 연 1~3%p 수준인데, 그것을 탐지하려면
235년의 자료가 필요하다.
이것이 금융 실증연구의 근본적 어려움이다.
| 문제 | 내용 |
|---|---|
| 신호 대 잡음비가 극단적으로 낮다 | 월 수익률 평균 0.6%, 표준편차 4% |
| 자료가 늘지 않는다 | 시간은 한 방향으로만 흐른다 |
| 구조가 변한다 | 235년 전 시장은 지금과 다르다 |
대응 넷.
| 방법 | 내용 |
|---|---|
| 횡단면 정보 사용 | 여러 종목·펀드를 동시에(패널) |
| 팩터 조정 | 공통 변동을 빼면 잔차 분산이 준다(연습문제 8) |
| 더 잦은 관측 | 일별·주별(다만 자기상관 주의) |
| 효과크기로 보고 | \(p\)가 아니라 샤프비율·정보비율의 구간 |
\(F=4.21\)을 어떻게 보고할까.
세 전략의 평균 월 수익률에 유의한 차이가 있다
(F(2, 177) = 4.21, p = 0.016, ω² = 0.034).

다만 설명되는 변동이 3.4% 에 불과하고, 이 표본으로 80% 검정력을
갖는 효과크기는 연 13.7%p 수준이다. 따라서 통계적 유의성을
실질적 우위의 증거로 삼기에는 신중해야 한다.

또한 세 전략이 같은 시장에 노출되어 있다면 독립집단 분산분석이
부적절하며, 반복측정 분석이나 팩터 조정 알파 비교가 필요하다.
연습문제 10. 연습문제 5의 "1월 효과"를 실제로 검정하는 코드를 만들고, 다중성과 자료 준설의 문제를 다루어라.
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

rng = np.random.default_rng(17003)

def monthly_anova(rets, months):
    """월별 평균 수익률의 차이를 분산분석으로 검정."""
    gs = [rets[months == m] for m in range(12)]
    return stats.f_oneway(*gs)

# 1) 실제로 계절성이 전혀 없는 자료
T_years = 30
months = np.tile(np.arange(12), T_years)
print(f"자료: {T_years}년 × 12개월 = {len(months)}개월")
print("\n(가) 계절성이 전혀 없을 때")
B = 5_000
a = b = 0
for _ in range(B):
    r = rng.normal(0.006, 0.04, len(months))
    a += monthly_anova(r, months).pvalue < 0.05
    # "가장 높은 달 대 나머지" 를 자료에서 골라 t 검정
    gm = np.array([r[months == m].mean() for m in range(12)])
    best = gm.argmax()
    t = stats.ttest_ind(r[months == best], r[months != best],
                        equal_var=False)
    b += t.pvalue < 0.05
print(f"  전체 분산분석의 오류율          {a / B:.4f}")
print(f"  '가장 높은 달' 을 골라 t 검정   {b / B:.4f}   ← 자료 준설")

# 2) 실제로 1월 효과가 있을 때의 검정력
print("\n(나) 1월만 평균이 δ 만큼 높을 때의 검정력")
print(f"{'δ (월)':>8s} {'연환산':>8s} {'분산분석':>9s} "
      f"{'1월 대 나머지 (사전지정)':>22s}")
for d in [0.005, 0.010, 0.020]:
    a = b = 0
    for _ in range(2_000):
        r = rng.normal(0.006, 0.04, len(months))
        r[months == 0] += d
        a += monthly_anova(r, months).pvalue < 0.05
        b += stats.ttest_ind(r[months == 0], r[months != 0],
                             equal_var=False).pvalue < 0.05
    print(f"{d:8.1%} {12 * d:8.1%} {a / 2000:9.4f} {b / 2000:22.4f}")
자료: 30년 × 12개월 = 360개월

(가) 계절성이 전혀 없을 때
  전체 분산분석의 오류율          0.0472
  '가장 높은 달' 을 골라 t 검정   0.2796   ← 자료 준설

(나) 1월만 평균이 δ 만큼 높을 때의 검정력
   δ (월)      연환산      분산분석        1월 대 나머지 (사전지정)
    0.5%     6.0%    0.0655                 0.1050
    1.0%    12.0%    0.1155                 0.2605
    2.0%    24.0%    0.3395                 0.7175
(가) 자료 준설의 대가가 0.280이다. 계절성이 전혀 없는데도 "가장 높은 달"을 고르면 열 번 중 세 번 가까이 유의하다.
| 절차 | 오류율 |
|---|---|
| 전체 분산분석 | 0.047 |
| "가장 높은 달" 선택 후 \(t\) 검정 | 0.280 |
이것이 "1월 효과" 문헌의 근본 문제다. 12개월 중 하나가 우연히 튀는 것은 당연하고, 그것을 사후에 고르면 통제가 무효다.
올바른 절차.
| 상황 | 절차 |
|---|---|
| 계절성이 있는지 묻는다 | 전체 분산분석 |
| 특정 달(1월)을 사전에 지목 | 1월 대 나머지 \(t\) 검정 |
| 자료를 보고 달을 고름 | 셰페 또는 투키 |
| 여러 달을 비교 | 투키(66쌍) |
(나) 검정력을 보면 사전 지정의 가치가 드러난다.
| 월별 \(\delta\) | 연환산 | 분산분석 | 사전 지정 \(t\) |
|---|---|---|---|
| 0.5% | 6.0% | 0.066 | 0.105 |
| 1.0% | 12.0% | 0.116 | 0.261 |
| 2.0% | 24.0% | 0.340 | 0.718 |
1월을 미리 지목하면 검정력이 2.3배다(\(\delta=1.0\%\)에서 0.261 대 0.116). 자유도 1의 대비가 자유도 11의 전체 검정보다 훨씬 강력하다.
그런데 "1월"을 어떻게 미리 알았는가. 1월 효과는 1976년 논문에서 처음 보고된 것이고, 그 자료를 보고 고른 것이다. 후속 연구에서 1월을 지목하는 것은 정당하지만, 원 발견 자체는 준설의 결과일 수 있다.
계절 이상현상 문헌의 교훈 넷.
| 교훈 | 내용 |
|---|---|
| 표본 외 검증 | 발견 이후 기간에서 재현되는가 |
| 다른 시장 | 미국 외 시장에서도 나타나는가 |
| 경제적 설명 | 왜 그런지 메커니즘이 있는가 |
| 거래비용 후 | 매매 비용을 빼고도 남는가 |
1월 효과는 발견 이후 크게 약화되었다고 보고된다. 표본 외 검증에 실패한 전형이다.
\(\delta=0.5\%\)/월(연 6%)의 효과도 사전 지정 \(t\) 의 검정력이 0.11뿐이라는 것도 중요하다. 30년 자료로도 계절 효과를 신뢰성 있게 잡기 어렵다.
정리하며
금융이 더하는 것은 새 검정이 아니라 두 함정이다. 검정 자체는 \(10.1\) 과 \(10.2\) 에서 세운 것 그대로다.
- 위험한 것은 분포가 아니라 상관이다. 두꺼운 꼬리(\(0.045\))·왜도(\(0.053\))·변동성 군집(\(0.053\))은 \(F\) 가 견딘다. 자기상관 \(\rho=0.2\) 가 \(0.131\) 로 위험하고, 공통 시장요인에 의한 횡단면 상관이 \(0.001\) 로 가장 고약하다.
- \(0.001\) 은 안전하다는 뜻이 아니다. 공통 요인이 \(MSW\) 만 부풀리고 집단 평균의 차이에는 들어가지 않으므로 \(F\) 의 분모만 커진다. 기각을 안 하는 것이 아니라 기각할 힘이 없는 것이고, 대가는 검정력에 나타난다.
- 처방은 분포가 아니라 설계를 고치는 것이다. 횡단면 상관에는 반복측정 분산분석이나 초과수익률, 자기상관에는 HAC 표준오차나 관측 간격 넓히기. 전략 사이의 이분산에만 웰치가 답이다.
- 평균이 상쇄를 지운다. 국면을 요인으로 넣지 않으면 반대 부호의 두 수가 접혀 「차이가 없다」가 된다(\(p = 0.586\)). 교호작용이 유의하면 주변 평균이 아니라 단순 효과를 보고하고, 물음도 「어느 전략인가」에서 「어느 국면에서 어느 전략인가」로 옮긴다.
- 그래서 기각하지 못한 것은 거의 정보가 없다. 기대수익률은 원래 극도로 부정확하게 추정되고(\(5.14\) 절) 위의 상관이 검정력을 더 깎으므로, 「전략들이 같다」로 읽으면 안 된다. \(5.12\) 절의 유효표본크기 문제가 그대로 나타난다.
다음 절 사례 연구로 10장을 마무리한다.