웰치의 이원배치 분산분석
들어가는 이야기 — 이분산보다 요인 누락이 먼저다
이분산을 고치는 일과 요인을 빠뜨리지 않는 일 가운데 뒤쪽이 먼저다. 요인을 빼고 분석하면 그 요인의 변동이 오차로 흘러들어 분모가 너무 커지고, 이분산 보정은 커진 그 분모를 고쳐 주지 않는다.
온도를 세 수준, 비료를 세 종류 두고 칸마다 하나씩만 관측한 자료가 그 자리를 보인다. 칸도 아홉이고 관측도 아홉이다. 요인을 하나씩 떼어 웰치 분산분석(analysis of variance)을 두 번 돌리면 \(p = 0.081821\) 과 \(p = 0.334719\) 로 둘 다 유의하지 않다. 이분산을 제대로 다루는 검정을 썼는데도 그렇다. 요인마다 수준이 셋이니 비교하는 것은 각각 세 평균이다.
같은 아홉 수를 \(3 \times 3\) 표로 보고 두 요인을 함께 넣으면 온도가 \(F = 62.0000\)(\(p = 0.000977\)), 비료가 \(F = 32.0000\) 이다. 달라진 것은 분모뿐이다 — 일원배치가 쓰던 산포 안에 다른 요인의 효과가 통째로 들어 있었고, 그것을 모형에 적어 넣자 오차가 \(2.3333\) 에서 \(0.1667\) 로 열네 배 작아졌다. 틀어진 방향은 효과를 놓치는 쪽이었다.
칸마다 관측값이 하나뿐이라는 점은 따로 적어 두어야 한다. 그러면 교호작용(interaction)을 추정할 자리가 남지 않으므로 교호작용이 없다고 가정한 셈이고, 그 가정이 틀렸다면 그 변동이 다시 오차로 들어간다. 순서를 뒤집으면 고친 것이 아무것도 아니게 된다. 가중평균과 자유도를 어떻게 만드는지는 \(\S 3\) 이 적고, 전통적 \(F\) 가 틀어지는 방향을 분산과 표본의 짝이 정한다는 것은 \(\S 5\) 의 상자가 따라간다.
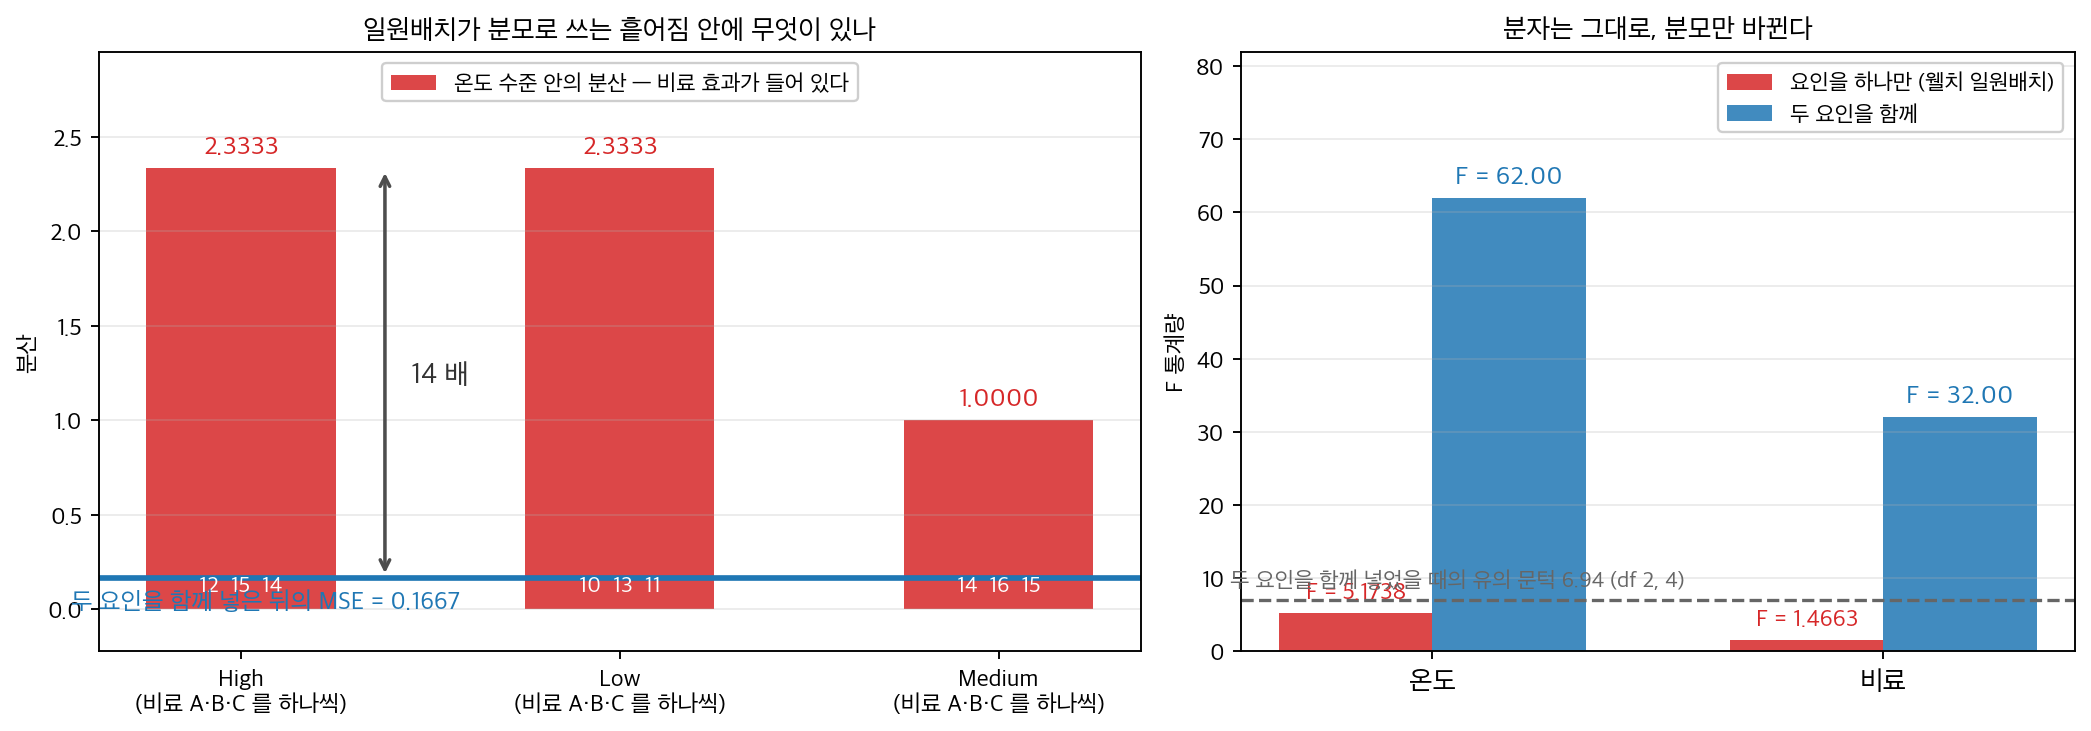
왼쪽 막대 안의 세 수를 볼 것. 온도 High 안의 \(12 \cdot 15 \cdot 14\) 는 비료 A·B·C 를 하나씩 받은 것이다. 그러니 그 분산 \(2.3333\) 은 오차가 아니라 비료 효과 그 자체이고, 일원배치는 그것을 분모로 쓴다. 비료를 모형에 적어 넣으면 남는 오차가 \(0.1667\) 로 \(14\) 배 줄어든다. 오른쪽이 그 결과다 — 분자는 거의 그대로이고 분모만 바뀌었는데 \(F\) 가 \(5.17\) 에서 \(62.00\) 으로 뛴다. 이분산 보정은 커진 그 분모를 고쳐 주지 않으므로, 요인을 빠뜨리지 않는 일이 먼저다.
확인한 곳 — 이 쪽 「틀어지는 방향은 짝이 정한다」 상자와 그 출처 줄
웰치의 이원배치 분산분석(two-way analysis of variance)은 등분산 가정이 어긋날 때 두 독립 요인에 걸쳐 평균을 비교할 수 있게 해 주는, 웰치 일원배치 분산분석(one-way analysis of variance)의 확장이다. 가중평균을 써서 이분산(분산이 서로 다름)을 조정하고 두 요인 사이의 교호작용 효과도 함께 다룬다.
1. 균형만으로는 지켜지지 않는다
쓰는 자리는 칸마다 분산이 다를 때다. 그런데 일원배치에서 외운 「균형이면 로버스트, 불균형이면 문제」가 이원배치에서는 그대로 통하지 않는다. \(\S 5\) 의 상자가 \(2\times2\) 설계에 참 효과를 모두 \(0\) 으로 두고 재어 둔 수가 그것이다. 가장 큰 표준편차가 가장 작은 것의 여섯 배일 때 교호작용 검정의 제\(1\)종 오류율(type I error rate)이 이렇다.
| 배치 (전체 표본 수는 같다) | 제\(1\)종 오류율 |
|---|---|
| 균형 | \(0.065\) |
| 큰 분산에 작은 표본 | \(\mathbf{0.259}\) |
| 큰 분산에 큰 표본 | \(\mathbf{0.0027}\) |
하나는 명목 수준 \(0.05\) 의 다섯 배이고 하나는 십팔 분의 일이다 — 부호가 반대다. 「불균형이면 문제」라는 말로는 어느 쪽인지 알 수 없는데, 한쪽은 없는 교호작용을 보고하고 다른 쪽은 있는 교호작용을 놓친다. 치르는 값이 전혀 다르다.
더 걸리는 것은 균형이 교호작용만 지켜 준다는 점이다. 같은 모의실험에서 분산이 요인 A 의 수준을 따라 달라지게 깔면 균형 설계의 주효과 검정마저 \(0.0022\) 로 깊이 보수적이 된다. 「균형이면 괜찮다」는 교호작용에 대한 말이지 모든 항에 대한 말이 아니다.
그래서 고르는 규칙을 이렇게 둔다.
- 불균형이 섞여 있으면 쓴다. 어느 쪽으로 틀어질지 미리 알 수 없으므로 재어 보고 고를 수도 없다.
- 균형이어도 분산이 요인의 수준을 따라 달라질 것 같으면 쓴다. 측정 단위가 수준마다 다르거나, 한 수준이 천장·바닥에 붙는 설계가 그렇다.
- 고르는 근거는 자료가 아니라 설계다. 등분산을 검정해서 정하면 그 뒤의 \(\alpha\) 보장이 유지되지 않는다 — 15.1절 분산 검정의 공통 가정 \(\S 5\) 가 그 까닭을 수로 따진다.
2. 무엇을 가정하고 무엇을 묻는가
이원배치이므로 묻는 것이 셋이다 — 요인 A 의 주효과, 요인 B 의 주효과, 그리고 둘의 교호작용. 각각에 대해 「그 효과가 없다」가 귀무가설(null hypothesis)이다.
- 요인 A. \(H_0\) 는 A 의 모든 수준에서 평균이 같다는 것, \(H_a\) 는 적어도 하나가 다르다는 것
- 요인 B. 같은 꼴로 세운다
- 교호작용. \(H_0\) 는 A 의 효과가 B 의 수준에 따라 달라지지 않는다는 것
믿는 것은 넷이다. 자료가 독립적으로 무작위 추출되었다는 것, 각 칸이 근사적으로 정규분포를 따른다는 것, 요인과 교호작용을 고정효과로 둔다는 것, 그리고 — 여기가 표준 이원배치와 갈리는 자리인데 — 칸마다 분산이 같지 않아도 된다는 것이다.
3. 어떻게 작동하고 어떻게 돌리는가
가중평균
얼개는 일원배치와 같다. 왜 분산의 역수로 가중하면 되는지, 그리고 그 보장이 어디까지 정확하고 어디서부터 근사인지는 10.4절 웰치의 일원배치 분산분석 정리 1 과 그 뒤의 쪽지에 있다 — 참분산을 알면 분자가 정확히 \(\chi^2_{k-1}\) 이고, \(s^2\) 으로 바꾸는 순간 근사가 된다. 여기서는 그 얼개를 칸 \((i,j)\) 로 옮긴다.
전통적인 분산분석처럼 분산을 합동하는 대신 웰치 방법은 각 집단의 가중치를 계산한다.
여기서 \(n_{ij}\)는 표본크기, \(s_{ij}^2\)은 요인 A의 수준 \(i\)와 요인 B의 수준 \(j\)에 해당하는 칸 \((i,j)\)의 분산이다.
검정통계량 — 가중평균과 웰치–새터스웨이트 자유도로
요인 A의 주효과, 요인 B의 주효과, 그리고 두 요인의 교호작용에 대해 각각 F-검정을 수행한다. 검정통계량(test statistic)은 가중된 집단 평균으로 유도하고, 분산이 서로 다른 점을 반영하기 위해 웰치–새터스웨이트 식으로 자유도를 조정한다.
수행 절차
- 자료 정리: 두 개의 독립 요인과 하나의 종속변수(dependent variable)를 포함해야 한다.
- 가설 진술: 주효과와 교호작용 효과에 대한 귀무가설과 대립가설(alternative hypothesis)을 정의한다.
- 가중평균 계산: 각 요인 수준의 가중 집단 평균과 분산을 계산한다.
- 자유도 조정: 웰치–새터스웨이트 식으로 유효 자유도를 계산한다.
- F-통계량 계산: 조정된 자유도로 주효과와 교호작용에 대해 각각 F-검정을 수행한다.
- 결과 해석: F-통계량을 임계값과 비교하거나 p 값을 쓴다.
- 사후분석: 유의한 차이가 발견되면 사후검정(post hoc test)을 수행한다 — 예컨대 게임스–하월이다.
4. Python 구현
두 요인(예: 온도와 비료 종류)이 식물 성장에 미치는 효과를 알아보는 실험을 생각하자.
보기 1. 요인을 하나씩 따로 보면 무엇을 잃는가. 자료는 온도 세 수준 × 비료 세 종류, 칸마다 관측값 하나씩인 \(3\times3\) 표다.
(1) pg.welch_anova 가 Temperature 에 대해 내놓은 \(F = 5.1738\), \(df_2 = 3.8192\) 를 세 집단의 평균·분산만으로 손으로 재현하시오(10.4절 웰치 공식을 그대로 쓴다).
(2) 이 자료는 사실 반복 없는 \(3\times3\) 이원배치다. 교호작용이 없다고 보는 가법모형 \(y_{ij} = \mu + \alpha_i + \beta_j + \varepsilon_{ij}\) 로 분산분석표를 만들고, (1)의 결과와 견주시오. 무엇이 달라지며 왜 달라지는가?
풀이
(1) 해석적으로. 10.4절의 웰치 통계량을 그대로 쓰면 된다. 온도 수준별 요약은
| 수준 | \(n\) | \(\bar y\) | \(s^2\) | \(w = n/s^2\) |
|---|---|---|---|---|
| High | \(3\) | \(13.6667\) | \(2.3333\) | \(1.2857\) |
| Low | \(3\) | \(11.3333\) | \(2.3333\) | \(1.2857\) |
| Medium | \(3\) | \(15.0000\) | \(1.0000\) | \(3.0000\) |
이고 \(W = \sum w_i\), \(\tilde y = \sum w_i \bar y_i / W\) 를 만든 뒤
을 계산한다. \(k = 3\) 이므로 보정계수가 \(\frac{2}{8} = \frac14\) 로 \(0\) 이 아니다. 아래에서 수로 확인한다.
(2) 가법 이원배치. 칸마다 관측값이 하나뿐이면 칸 안의 산포를 잴 수 없다. 그러나 교호작용이 없다고 가정하면 교호작용 제곱합(sum of squares)을 오차로 쓸 수 있고, 그러면
로 분해된다. 여기서 \(SS_A = b\sum_i(\bar y_{i\cdot}-\bar y)^2\), \(SS_B = a\sum_j(\bar y_{\cdot j}-\bar y)^2\) 이다.
핵심은 (1)의 일원배치가 쓴 "집단 안 변동"의 정체다. 온도 수준 High 안의 세 값 \(12, 15, 14\) 는 비료 A, B, C 를 하나씩 받은 것이므로, 그 산포는 순수한 오차가 아니라 비료 효과 + 오차다. 일원배치는 비료 효과를 통째로 잡음으로 떠넘긴다. 10.3절 게임스–하웰 검정 보기 2 에서 본 것과 같은 구조이고, 여기서는 그 대가가 훨씬 크다.
import pingouin as pg
import pandas as pd

# 예시 자료
data = {
    "Temperature": ["High", "High", "High", "Low", "Low", "Low", "Medium", "Medium", "Medium"],
    "Fertilizer": ["A", "B", "C", "A", "B", "C", "A", "B", "C"],
    "Growth": [12, 15, 14, 10, 13, 11, 14, 16, 15],
}
df = pd.DataFrame(data)

# welch_anova는 between에 요인을 **하나만** 받는다. 그래서 따로 두 번 돌린다.
# 이렇게 하면 각 주효과는 다른 요인을 무시한 채 계산되며, 교호작용은 볼 수 없다.
print(pg.welch_anova(dv="Growth", between="Temperature", data=df))
print(pg.welch_anova(dv="Growth", between="Fertilizer", data=df))
출력:
        Source  ddof1     ddof2         F     p_unc       np2
0  Temperature      2  3.819209  5.173804  0.081821  0.645833
       Source  ddof1     ddof2         F     p_unc       np2
0  Fertilizer      2  3.915497  1.466347  0.334719  0.333333
해석은 이렇다.
- 온도: \(F = 5.17\), \(p = 0.082\)로 \(\alpha = 0.05\)에서 유의하지 않다. 다만 칸당 관측값이 하나뿐이어서 검정력이 매우 낮다.
- 비료: \(F = 1.47\), \(p = 0.335\)로 유의하지 않다.
손계산으로 되살리고, 같은 자료를 \(3\times3\) 표로 보아 다시 분석한다.
import numpy as np
from scipy import stats


def welch_f_by_hand(groups):
    k = len(groups)
    n = np.array([len(g) for g in groups], float)
    m = np.array([g.mean() for g in groups])
    s2 = np.array([g.var(ddof=1) for g in groups])
    w = n / s2
    W = w.sum()
    Lam = (((1 - w / W) ** 2) / (n - 1)).sum()
    num = (w * (m - (w * m).sum() / W) ** 2).sum() / (k - 1)
    return num / (1 + 2 * (k - 2) / (k ** 2 - 1) * Lam), (k ** 2 - 1) / (3 * Lam)


for fac in ("Temperature", "Fertilizer"):
    gs = [v.values.astype(float) for _, v in df.groupby(fac)['Growth']]
    F, d2 = welch_f_by_hand(gs)
    print(f"{fac:>12}: 손계산 F = {F:.6f}, ddof2 = {d2:.6f}, "
          f"p = {stats.f(2, d2).sf(F):.6f}")

# 반복 없는 3x3 가법모형
M = df.pivot(index='Temperature', columns='Fertilizer', values='Growth').astype(float)
print("\n자료를 3x3 표로 보면")
print(M)
row, col = M.mean(axis=1), M.mean(axis=0)
grand = M.values.mean()
SSA = 3 * ((row - grand) ** 2).sum()
SSB = 3 * ((col - grand) ** 2).sum()
SST = ((M.values - grand) ** 2).sum()
SSE = SST - SSA - SSB
MSE = SSE / 4
print(f"\nSS(온도) = {SSA:.4f} (df 2),  SS(비료) = {SSB:.4f} (df 2),  "
      f"SS(오차) = {SSE:.4f} (df 4)")
print(f"SST = {SST:.4f},  MSE = {MSE:.6f}")
for name, SS in (("온도", SSA), ("비료", SSB)):
    F = (SS / 2) / MSE
    print(f"{name}: F = {F:.4f},  p = {stats.f(2, 4).sf(F):.6f}")
출력:
 Temperature: 손계산 F = 5.173804, ddof2 = 3.819209, p = 0.081821
  Fertilizer: 손계산 F = 1.466347, ddof2 = 3.915497, p = 0.334719

자료를 3x3 표로 보면
Fertilizer      A     B     C
Temperature
High         12.0  15.0  14.0
Low          10.0  13.0  11.0
Medium       14.0  16.0  15.0

SS(온도) = 20.6667 (df 2),  SS(비료) = 10.6667 (df 2),  SS(오차) = 0.6667 (df 4)
SST = 32.0000,  MSE = 0.166667
온도: F = 62.0000,  p = 0.000977
비료: F = 32.0000,  p = 0.003460
(1)이 맞는다. 손계산한 \(F = 5.173804\), \(df_2 = 3.819209\), \(p = 0.081821\) 이 pg.welch_anova 의 출력과 소수 여섯째 자리까지 같다. 비료 쪽도 마찬가지다.
(2)의 결과가 충격적이다. 같은 아홉 개 수를 \(3\times3\) 표로 보고 가법모형을 적합하면
| 원천 | \(SS\) | \(df\) | \(MS\) | \(F\) | \(p\) |
|---|---|---|---|---|---|
| 온도 | \(20.6667\) | \(2\) | \(10.3333\) | \(62.00\) | \(0.00098\) |
| 비료 | \(10.6667\) | \(2\) | \(5.3333\) | \(32.00\) | \(0.00346\) |
| 오차 | \(0.6667\) | \(4\) | \(0.1667\) |
로 두 효과가 모두 \(1\%\) 수준에서 유의하다. 일원배치 웰치가 \(p = 0.082\) 와 \(p = 0.335\) 를 준 바로 그 자료다.
까닭은 분모에 있다. 온도 수준 High 안의 세 값 \(12, 15, 14\) 는 비료 A·B·C 를 하나씩 받은 것이다. 그 분산 \(s^2 = 2.3333\) 은 오차가 아니라 비료 효과를 그대로 담고 있다. 일원배치가 쓰는 분모는 이 \(2.3333\) 언저리인데, 비료를 모형에 넣고 나면 남는 오차분산이 \(MSE = 0.1667\) 로 \(14\) 배 줄어든다. 분자는 거의 그대로이므로 \(F\) 가 \(5.17\) 에서 \(62\) 로 뛴다.
그러니 "분산이 다를 수 있으니 웰치를 쓰자"는 판단보다 "요인이 둘이니 둘 다 모형에 넣자"는 판단이 먼저다. 이 자료에서 웰치가 해 준 일은 거의 없고, 잃은 것은 비료 요인 전체였다.
두 가지를 덧붙여 둔다. 첫째, 가법모형은 교호작용이 없다고 가정한 것이고 칸마다 관측값이 하나뿐이라 그 가정을 검정할 수 없다. 교호작용이 실제로 있다면 \(MSE = 0.1667\) 은 과소추정이고 \(F = 62\) 도 부풀려진 값이다. 둘째, 이 가법모형은 등분산을 가정한다. 이분산까지 함께 다루면서 교호작용도 보려면 이원배치 웰치 분산분석 (로버스트 HC3) 으로 가야 한다.
pingouin에는 두 요인을 동시에 다루는 웰치 분산분석이 없다
pg.welch_anova는 between에 요인 하나만 받는다. 위 코드처럼 요인별로 따로 돌리면 주효과는 볼 수 있지만 교호작용은 검정할 수 없다. 교호작용을 포함한 이분산 이원배치 분석에는 완전 요인 OLS 모형에 HC3 로버스트 공분산을 결합한 왈드 F-검정을 쓴다. 자세한 내용은 이원배치 웰치 분산분석 (로버스트 HC3) 페이지를 보라.
또한 이 보기는 칸마다 관측값이 하나뿐이어서 칸 내 분산을 추정할 수 없다. 실제 이원배치 분석에는 칸마다 반복이 필요하다.
사후검정
주효과가 유의하면 어느 수준이 다른지 찾기 위해 게임스–하월 같은 사후검정을 쓴다.
보기 2. 게임스–하월 표의 여섯 열을 손으로 만들기. 게임스–하월은 "투키의 스튜던트화 범위(studentized range) + 웰치의 표준오차와 자유도"를 합친 절차다.
(1) 쌍 \((i,j)\) 에 대해
이고 \(p = P\!\left(Q_{k,\nu_{ij}} \ge \sqrt2\,|T|\right)\) 임을 적고, 유의해지는 임계값이 \(T^\ast = q_{0.95,\,k,\,\nu_{ij}}/\sqrt2\) 임을 보이시오. 투키와 달리 쌍마다 자유도와 임계값이 다르다는 점을 지적하시오.
(2) 출력표의 세 줄을 손으로 재현하고 각 \(|T|\) 를 그 쌍의 임계값과 견주시오. 또 분산을 그대로 둔 채 수준당 관측값만 늘리면 임계값과 "유의해지는 데 필요한 평균차"가 어떻게 줄어드는지 계산하시오.
풀이
(1) 해석적으로. 투키가 모든 쌍에 같은 표준오차 \(\sqrt{MSW(1/n_i+1/n_j)}\) 와 같은 자유도 \(N-k\) 를 쓰는 반면, 게임스–하월은 두 집단의 자료만으로 표준오차를 만들고(웰치) 자유도도 새터스웨이트 식으로 따로 잰다. 다중성 보정은 투키와 같은 스튜던트화 범위 분포로 한다.
스튜던트화 범위와 \(t\) 의 관계가 \(Q_{k,\nu} = \sqrt2\,|t|\) 꼴로 들어가므로, \(|T|\) 를 \(\sqrt2\) 배해 \(Q_{k,\nu_{ij}}\) 의 꼬리에서 읽으면 보정된 \(p\) 값이 된다. 뒤집으면 기각 조건이
다. 여기서 \(k\) 는 전체 집단 수(\(=3\))이지 비교에 참여한 둘이 아니다. 비교 개수를 셈에 넣는 것이 다중성 보정이기 때문이다.
중요한 차이는 \(\nu_{ij}\) 가 쌍마다 다르다는 것이다. 투키 표에서는 반폭 하나가 모든 쌍에 공통이었지만(10.2절 교호작용 효과 보기 2) 여기서는 쌍마다 임계값이 달라진다. 분산이 비슷한 두 집단을 견줄 때는 자유도가 \(n_i+n_j-2\) 에 가깝고, 분산이 크게 다르면 그보다 작아진다.
(2) 수치적으로.
# Temperature에 대한 Games-Howell 사후검정
post_hoc_temp = pg.pairwise_gameshowell(dv="Growth", between="Temperature", data=df)
print(post_hoc_temp.round(4).to_string(index=False))

# Fertilizer에 대한 Games-Howell 사후검정
post_hoc_fert = pg.pairwise_gameshowell(dv="Growth", between="Fertilizer", data=df)
print(post_hoc_fert.round(4).to_string(index=False))
출력:
   A      B  mean_A  mean_B    diff     se       T     df   pval  hedges
High    Low 13.6667 11.3333  2.3333 1.2472  1.8708 4.0000 0.2604  1.2220
High Medium 13.6667 15.0000 -1.3333 1.0541 -1.2649 3.4483 0.4915 -0.8262
 Low Medium 11.3333 15.0000 -3.6667 1.0541 -3.4785 3.4483 0.0660 -2.2722
A B  mean_A  mean_B    diff     se       T     df   pval  hedges
A B 12.0000 14.6667 -2.6667 1.4530 -1.8353 3.7409 0.2767 -1.1988
A C 12.0000 13.3333 -1.3333 1.6667 -0.8000 3.9936 0.7230 -0.5226
B C 14.6667 13.3333  1.3333 1.4907  0.8944 3.6697 0.6740  0.5842
어느 쌍도 유의하지 않다. 주효과 검정이 애초에 유의하지 않았으니 당연한 결과다.
효과크기(effect size) hedges가 \(-2.3\)에서 \(1.2\)까지로 상당히 큰데도 p 값이 크다는 점이 이 보기의 교훈이다. 표의 여섯 열을 손으로 만들어 그 까닭을 들여다본다.
from itertools import combinations

g = df.groupby('Temperature')['Growth'].agg(['mean', 'var', 'count'])
k = 3
print(f"{'pair':<14}{'diff':>9}{'se':>8}{'T':>9}{'df':>9}{'pval':>8}{'임계값 T*':>10}")
for a, b in combinations(['High', 'Low', 'Medium'], 2):
    ma, va, na = g.loc[a]
    mb, vb, nb = g.loc[b]
    se = np.sqrt(va / na + vb / nb)
    T = (ma - mb) / se
    nu = (va / na + vb / nb) ** 2 / ((va / na) ** 2 / (na - 1)
                                     + (vb / nb) ** 2 / (nb - 1))
    pval = stats.studentized_range.sf(np.sqrt(2) * abs(T), k, nu)
    thr = stats.studentized_range.ppf(0.95, k, nu) / np.sqrt(2)
    print(f"{a + '-' + b:<14}{ma - mb:>9.4f}{se:>8.4f}{T:>9.4f}{nu:>9.4f}"
          f"{pval:>8.4f}{thr:>10.4f}")

# 수준당 관측값을 늘리면 임계값이 얼마나 내려가는가 (분산은 그대로 둔다).
va, vb = 2.3333333, 1.0
print(f"\n{'수준당 n':>9}{'nu':>9}{'임계값 T*':>10}{'필요한 평균차':>14}")
for n in (3, 4, 5, 8, 20):
    se = np.sqrt(va / n + vb / n)
    nu = (va / n + vb / n) ** 2 / ((va / n) ** 2 / (n - 1) + (vb / n) ** 2 / (n - 1))
    thr = stats.studentized_range.ppf(0.95, k, nu) / np.sqrt(2)
    print(f"{n:>9}{nu:>9.3f}{thr:>10.4f}{thr * se:>14.4f}")
출력:
pair               diff      se        T       df    pval    임계값 T*
High-Low         2.3333  1.2472   1.8708   4.0000  0.2604    3.5640
High-Medium     -1.3333  1.0541  -1.2649   3.4483  0.4915    3.8425
Low-Medium      -3.6667  1.0541  -3.4785   3.4483  0.0660    3.8425

    수준당 n       nu    임계값 T*       필요한 평균차
        3    3.448    3.8425        4.0504
        4    5.172    3.2155        2.9353
        5    6.897    2.9558        2.4134
        8   12.069    2.6658        1.7208
       20   32.759    2.4546        1.0021
표가 통째로 재현된다. diff, se, T, df, pval 다섯 열이 pairwise_gameshowell 의 출력과 소수 넷째 자리까지 같다.
(1)의 "쌍마다 자유도가 다르다"가 눈에 보인다. High–Low 는 두 집단의 분산이 \(2.3333\) 으로 똑같아 \(\nu = 4 = n_1+n_2-2\) 를 온전히 받는다. 반면 Medium 이 끼는 두 비교는 분산이 \(2.3333\) 대 \(1.0\) 으로 달라 \(\nu = 3.4483\) 으로 깎이고, 그 대가로 임계값이 \(3.5640\) 에서 \(3.8425\) 로 \(8\%\) 올라간다.
세 \(|T|\) 가 모두 임계값 아래다. \(1.8708 < 3.5640\), \(1.2649 < 3.8425\), \(3.4785 < 3.8425\). 가장 가까운 Low–Medium 조차 \(0.36\) 모자라 \(p = 0.0660\) 이 되었다. 자유도가 \(3.45\) 밖에 안 되니 임계값이 \(3.84\) 까지 치솟은 것이고, 같은 \(|T| = 3.4785\) 라도 \(\nu = 20\) 이었다면 임계값이 \(2.53\) 이라 넉넉히 유의했을 것이다.
처방은 반복이다. 아래 표가 그것을 수로 말해 준다.
| 수준당 \(n\) | \(\nu\) | 임계값 \(T^\ast\) | 유의해지는 데 필요한 평균차 |
|---|---|---|---|
| \(3\) | \(3.45\) | \(3.8425\) | \(4.0504\) |
| \(4\) | \(5.17\) | \(3.2155\) | \(2.9353\) |
| \(5\) | \(6.90\) | \(2.9558\) | \(2.4134\) |
| \(8\) | \(12.07\) | \(2.6658\) | \(1.7208\) |
| \(20\) | \(32.76\) | \(2.4546\) | \(1.0021\) |
수준당 \(3\) 개에서는 평균차가 \(4.05\) 는 되어야 하는데 실제 차이는 \(3.667\) 이다. 수준당 하나씩만 더 붙여 \(4\) 개로 만들면 필요한 차이가 \(2.94\) 로 내려가 같은 차이가 유의해진다. 두 몫이 함께 움직이기 때문이다. 표준오차가 \(\sqrt{1/n}\) 으로 줄고, 자유도가 늘어 임계값 \(T^\ast\) 자체도 \(3.84\) 에서 \(3.22\) 로 내려간다.
효과크기가 크다는 것과 통계적으로 유의하다는 것은 별개다. hedges 가 \(-2.27\) 이나 되는 Low–Medium 이 유의하지 않은 것은 효과가 작아서가 아니라 그 효과를 잴 자가 너무 거칠기 때문이다.
"자유도가 3~4에 불과하면 아무리 큰 효과라도 유의성에 이르기 어렵다"는 말이 얼마나 심각한지는 임계값을 그려 보아야 실감이 난다. 게임스–하월은 스튜던트화 범위분포를 쓰므로, 집단이 \(k = 3\)일 때 유의해지는 데 필요한 통계량은 \(q_{0.95,\,3,\,\nu}/\sqrt{2}\)이다.
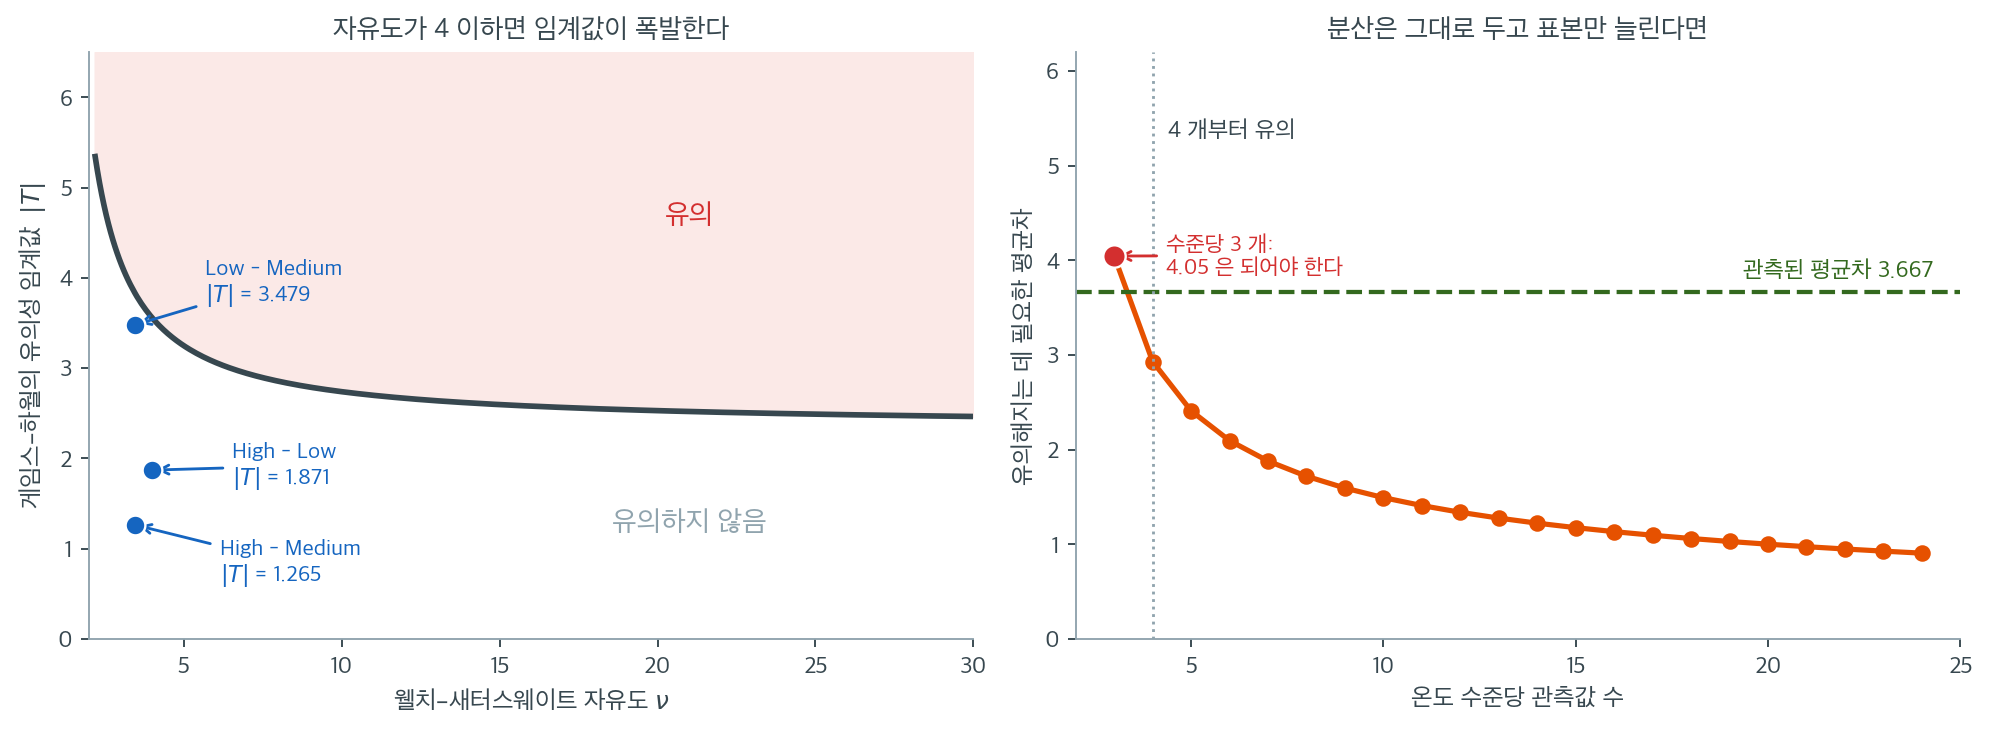
왼쪽 곡선이 그 임계값이다. \(\nu = 20\)이면 \(2.53\)으로 충분한데, \(\nu = 5\)에서 \(3.25\), \(\nu = 3.45\)에서 \(3.84\), \(\nu = 2.5\)에서는 \(4.77\)까지 치솟는다. 자유도가 하나 줄 때마다 임계값이 가팔라진다. 파란 점 셋이 위 보기의 실제 비교다. Low–Medium은 \(|T| = 3.479\)로 세 비교 중 가장 크지만 그 자유도에서의 임계값 \(3.838\)에 \(0.36\) 모자라 \(p = 0.066\)이 되었다. High–Low \((1.871)\)와 High–Medium \((1.265)\)는 훨씬 아래다. 세 점 모두 곡선 아래에 있다.
곡선이 \(\nu\)가 작을 때 이렇게 치솟는 이유는 분산 추정의 불확실성 때문이다. 자유도가 \(3\)이면 표본분산(sample variance) \(s^2\) 자체가 몇 배씩 틀릴 수 있고, 검정은 그 가능성까지 감안해 보수적으로 임계값을 올려 잡는다. 칸마다 관측값이 하나뿐인 설계에서 온도 수준당 관측값이 \(3\)개밖에 없으니 \(\nu\)가 \(3.45\)까지 떨어진 것이다. 웰치–새터스웨이트 식은 여기에 이분산의 대가까지 더해 \(\nu\)를 \(n_1 + n_2 - 2 = 4\)보다도 아래로 끌어내린다.
오른쪽은 처방이다. 두 집단의 분산 \(s^2 = 2.333\)과 \(1.000\)을 그대로 두고 수준당 관측값만 늘렸을 때, 유의해지려면 평균차가 얼마나 되어야 하는지를 그렸다. 수준당 \(3\)개에서는 \(4.05\)가 필요한데 관측된 차이는 \(3.667\)이다. 수준당 \(4\)개만 되어도 임계값이 \(2.93\)으로 떨어져 같은 차이가 유의해진다. 관측값을 하나씩 더 붙이는 것만으로 결론이 바뀌는 자리라는 뜻이며, 이것이 "칸마다 반복이 필요하다"는 위 경고의 구체적인 내용이다.
5. 무엇을 얻고 무엇을 내주는가
일원배치에서 본 교환이 그대로 따라온다. 얻는 것은 칸마다 분산이 달라도 된다는 것이고, 그래서 불균형 설계에서도 쓸 수 있으며 교호작용을 분산 차이에 휘둘리지 않고 잡아낸다.
내주는 것은 해석의 단순함이다. 칸마다 분산이 다르면 교호작용이 「효과의 차이」인지 「변동의 차이」인지 가리기가 어려워진다 — 평균의 차이를 재는 자가 칸마다 다르기 때문이다. 일원배치에서는 생기지 않던 문제이고, 그래서 이원배치에서는 교호작용 그림을 반드시 함께 보아야 한다(10.2절 교호작용 그림).
정규성(normality)은 여기서도 완화되지 않는다. 웰치가 버린 것은 등분산 하나뿐이다.
AI로 보는 통계학 1. 틀어지는 방향은 짝이 정한다
\(\S 5\) 은 이 방법의 값어치를 「전통적인 이원배치 분산분석과 달리 이분산을 조정한다」로 적는다. 그러면 전통적인 쪽은 어느 쪽으로 틀어지는가. 책 여러 곳에 적힌 경험칙은 일원배치의 것이다 — 「균형이면 로버스트, 불균형이면 문제」. 이원배치에서 그 「문제」의 부호가 하나로 정해지지 않는다는 것이 덜 알려져 있다.
\(2 \times 2\) 설계에 참 효과를 모두 \(0\) 으로 두고, 칸마다 분산을 다르게 준 뒤 표본을 세 가지로 나누어 보았다. 전체 표본 수는 세 경우 모두 같다.
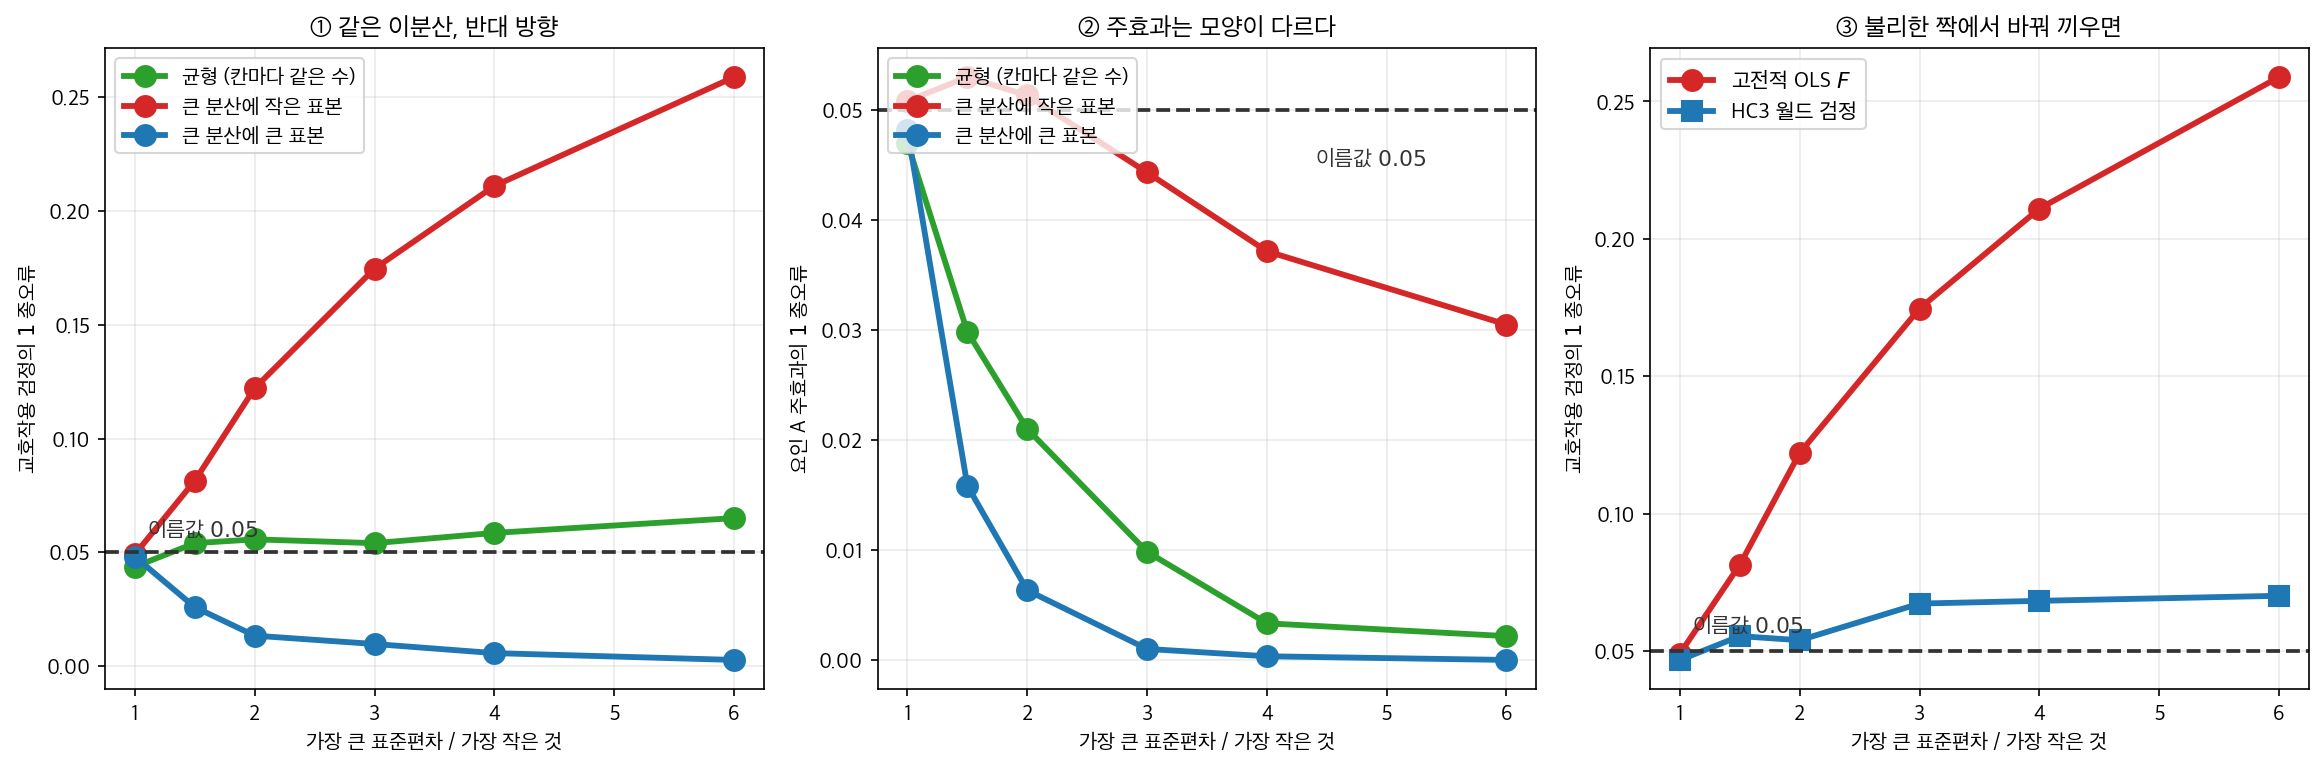
- ① 가장 큰 표준편차가 가장 작은 것의 \(6\) 배일 때, 교호작용 검정의 제\(1\)종 오류율이 균형에서 \(0.065\), 큰 분산에 작은 표본을 붙이면 \(0.259\), 큰 분산에 큰 표본을 붙이면 \(0.0027\) 이다. 같은 이분산이고 전체 표본도 같은데 하나는 명목 수준의 다섯 배, 하나는 십팔 분의 일이다. 부호가 반대다. 「불균형이면 문제」라는 말로는 어느 쪽인지 알 수 없고, 어느 쪽인지에 따라 치르는 값이 전혀 다르다 — 한쪽은 없는 교호작용을 보고하고 다른 쪽은 있는 교호작용을 놓친다.
- ② 주효과는 모양이 다르다. 여기서는 균형 설계마저 분산비 \(6\) 에서 \(0.0022\) 로 깊이 보수적이 된다. 분산이 요인 A 의 수준에 따라 달라지도록 깔아 두었기 때문이고, 그런 자리에서는 균형이 지켜 주지 못한다. 「균형이면 괜찮다」는 교호작용에 대한 말이지 모든 항에 대한 말이 아니다.
- ③ 가장 나쁜 경우에 분산 추정만 바꿔 끼워 보았다. 옆 쪽 이원배치 웰치 분산분석 (로버스트 HC3) 의 HC3 왈드 검정을 쓰면 \(0.259\) 가 \(0.070\) 으로 돌아온다. 완전히 \(0.05\) 는 아니지만 자릿수가 달라진다.
이 쪽의 가중 \(w_{ij} = n_{ij}/s_{ij}^2\) 이 하는 일이 바로 이것이다. 분산이 큰 칸의 발언권을 줄여 짝이 방향을 정하지 못하게 만든다. 전통적 \(F\) 가 합동분산(pooled variance) 하나로 모든 칸을 재는 한, 표본이 어디에 몰렸느냐가 결론의 부호까지 바꾼다.
이 상자는 모의실험만으로 이루어져 있다. 그림과 표의 수는 모두 직접 계산한 값이다
연습문제
연습문제 1. 이분산 이원배치 분석의 선택지를 정리하라.
풀이
문제 상황. 요인이 둘이고, 칸마다 분산이 다르며, 표본이 불균형하다. 표준 이원배치 \(F\)는 제1종 오류율이 0.24까지 치솟는다(연습문제 9).
선택지 다섯.
| 방법 | 장점 | 단점 |
|---|---|---|
| HC3 로버스트 왈드 \(F\) | 구현이 쉽다(cov_type="HC3") |
자유도가 정수로 고정 |
| 웰치–제임스(요한센) | 오류율이 가장 정확 | 직접 구현해야 |
| 변환 | 이분산과 비정규를 동시에 | 해석 척도가 바뀜 |
| 순열검정 | 분포 가정 없음 | 교호작용 검정이 까다로움 |
| 혼합효과/GLS | 분산 구조를 모형화 | 모형 설정이 복잡 |
순열검정(permutation test)의 어려움이 의외다. 주효과의 순열은 명확하지만, 교호작용의 귀무가설 아래에서 자료를 어떻게 섞어야 하는지가 자명하지 않다. 잔차 순열(Freedman–Lane 등) 같은 별도의 장치가 필요하다.
결정 흐름.
칸별 n, 평균, 분산을 먼저 본다
    │
    ├─ 칸당 반복이 없다  ──→ 이원배치 웰치는 불가
    │                        (투키 비가법성 검정 또는 설계 재검토)
    │
    └─ 반복이 있다
          │
          ├─ 분산비 < 2, 균형 ──→ 표준 이원배치 F 로 충분
          │
          └─ 그 외 ──→ HC3 (기본)  또는  웰치-제임스 (칸이 작을 때)
                          │
                          └─ 유의한 교호작용 → 단순효과 + 보정
구현 요점 넷.
- HC3에는 합 대비(sum-to-zero contrast)가 필수다. 처리 대비(treatment contrast)로 쓰면 "주효과"가 단순효과가 된다.
pg.welch_anova는 요인 하나만 받는다. 이원배치에 그대로 쓸 수 없다.- 웰치–제임스의 대비 행렬은 크로네커 곱으로 만든다.
- 어느 주변평균을 검정하는지 명시한다(연습문제 10).
보고 형식.
2×3 요인설계, 칸별 n = 8~12, 칸 분산 1.3~71.9 (57배 차이)
→ 등분산 가정 불가, 웰치-제임스(요한센 F 근사) 사용

  A 주효과   F(1, 21.2) =  8.01,  p = 0.010
  B 주효과   F(2, 26.5) = 24.88,  p < 0.001
  A×B       F(2, 26.5) =  3.20,  p = 0.057
핵심 수치 넷.
| 사실 | 값 |
|---|---|
| 이분산 아래 표준 \(F\)의 오류율(B 주효과) | 0.24 |
| 웰치–제임스·HC3의 오류율 | 0.045~0.054 |
| 칸당 \(n=1\)일 때 최소 탐지 차이 | 2.91\(\sigma\) |
| 비가중·가중 주변평균의 차이(예시) | 3.33 대 3.99 |
한 문장. 이원배치에서 이분산은 일원배치보다 더 위험하다. 교호작용 검정이 가장 크게 무너지는데, 하필 그것이 이원배치를 쓰는 이유이기 때문이다.
연습문제 2. 두 요인 실험에서 세 가지 토양과 두 가지 비료에 걸쳐 작물 수확량을 측정했다. 칸 분산은 2.1에서 14.8까지 분포하고 표본크기도 불균형하다(5에서 15까지). 표준 이원배치 분산분석이 부적절한 이유를 설명하고, 웰치의 이원배치 분산분석이 이 문제를 어떻게 다루는지 기술하라.
풀이
표준 이원배치 분산분석은 모든 칸에서 분산이 같다는 등분산성(homoscedasticity)을 가정한다. 여기서는 가장 큰 칸 분산(14.8)이 가장 작은 것(2.1)의 약 일곱 배이고 표본크기도 서로 다르다. 이 조합 때문에 합동분산 추정값이 대표성을 잃고, F-통계량이 편향되어 p 값이 부정확해진다.
웰치의 이원배치 분산분석은 각 칸에 \(w_{ij} = n_{ij}/s_{ij}^2\)의 가중치를 주는 가중평균을 계산하여 분산이 큰 칸의 영향력을 줄인다. 웰치–새터스웨이트 식으로 자유도를 조정하여 분산이 서로 다른 점을 반영하고, 그 결과 F-통계량이 올바른 표집분포(sampling distribution)를 따르게 된다.
연습문제 3. 웰치의 이원배치 분산분석에서 칸 \((i, j)\)의 가중치는 \(w_{ij} = n_{ij}/s_{ij}^2\)이다. \((n, s^2)\)가 \((10, 4.0)\), \((8, 12.0)\), \((15, 3.0)\)인 세 칸에 대해 가중치를 계산하고 어느 칸이 가중 전체평균에 가장 큰 영향을 주는지 설명하라.
풀이
가중치는 이렇게 된다.
- 칸 1: \(w_1 = 10/4.0 = 2.50\)
- 칸 2: \(w_2 = 8/12.0 = 0.667\)
- 칸 3: \(w_3 = 15/3.0 = 5.00\)
칸 3의 가중치가 가장 크다(5.00). 표본크기가 가장 크면서 분산이 가장 작아 평균이 가장 정밀하게 추정되기 때문이다. 칸 2는 분산이 크고 표본크기도 작아 평균 추정이 가장 덜 믿을 만하므로 가중치가 가장 작다.
연습문제 4. 웰치의 이원배치 분산분석에서 두 요인의 주효과는 유의하고 교호작용은 유의하지 않게 나왔다면 어떤 사후검정을 쓰겠는가? 이유는?
풀이
게임스–하월 검정이 적절한 사후 절차이다. 분산이 서로 다르기 때문에 웰치 분산분석을 썼으므로 사후검정도 등분산을 가정해서는 안 된다. 게임스–하월은 각 쌍별 비교마다 분산을 따로 추정하고 웰치–새터스웨이트 식으로 자유도를 조정한다. 투키의 HSD는 모든 집단의 등분산을 가정하므로 부적절하다.
연습문제 5. 본문 보기에는 두 가지 결함이 있다. 무엇인지 밝히고, 결함 없는 자료로 다시 분석하라.
풀이
결함 둘.
| 결함 | 결과 |
|---|---|
| 칸마다 관측이 하나뿐 | 칸 내 분산 \(s_{ij}^2\)을 추정할 수 없다 |
welch_anova를 요인별로 따로 호출 |
각 주효과가 다른 요인을 무시한다 |
두 번째가 더 미묘하다. pg.welch_anova(between="Temperature")는 비료를 전혀 모른다. 비료가 만드는 변동이 온도 집단 안의 잡음으로 남는다.
import numpy as np
import pandas as pd
import pingouin as pg
import statsmodels.api as sm
from statsmodels.formula.api import ols

# 칸마다 반복이 있고 분산도 칸마다 다른 2×3 자료
rng = np.random.default_rng(202)
a, b = 2, 3
mu = np.array([[10.0, 13.0, 16.0],
               [11.0, 14.0, 24.0]])       # A1·B2 에서 교호작용
sd = np.array([[1.0, 2.0, 6.0],
               [1.5, 3.0, 7.0]])          # 칸마다 다른 분산
ns = np.array([[12, 10, 8],
               [9, 12, 11]])              # 불균형

rows = []
for i in range(a):
    for j in range(b):
        rows.append(pd.DataFrame({"y": rng.normal(mu[i, j], sd[i, j], ns[i, j]),
                                  "A": f"A{i}", "B": f"B{j}"}))
df = pd.concat(rows, ignore_index=True)

print(df.groupby(["A", "B"]).y.agg(["size", "mean", "var"]).round(3).to_string())

print("\npingouin 주변 웰치 (다른 요인 무시)")
for f in ["A", "B"]:
    r = pg.welch_anova(dv="y", between=f, data=df)
    print(f"  {f}: F = {r.F[0]:8.4f}, df2 = {r.ddof2[0]:7.3f}, "
          f"p = {r.p_unc[0]:.4f}")

print("\n표준 이원배치 (제II형)")
print(sm.stats.anova_lm(ols("y ~ C(A)*C(B)", data=df).fit(),
                        typ=2).round(4).to_string())
       size    mean     var
A  B
A0 B0    12  10.109   1.272
   B1    10  13.713   1.814
   B2     8  16.181  21.283
A1 B0     9  11.282   6.237
   B1    12  13.790   5.857
   B2    11  24.174  71.906

pingouin 주변 웰치 (다른 요인 무시)
  A: F =   6.1709, df2 =  44.378, p = 0.0168
  B: F =  24.6111, df2 =  33.987, p = 0.0000

표준 이원배치 (제II형)
              sum_sq    df        F  PR(>F)
C(A)        124.1164   1.0   6.8635  0.0113
C(B)        987.4697   2.0  27.3031  0.0000
C(A):C(B)   178.9091   2.0   4.9468  0.0105
Residual   1012.6747  56.0      NaN     NaN
칸 분산이 1.27에서 71.91까지 57배 차이난다. 등분산 가정이 완전히 깨진 자료다.
세 가지 답이 모두 다르다.
| 방법 | A 주효과 \(p\) | 교호작용 |
|---|---|---|
| 주변 웰치 | 0.0168 | 검정 불가 |
| 표준 이원배치 | 0.0113 | 0.0105 |
| 웰치–제임스 | 0.0100 | 0.0567(연습문제 8) |
표준 이원배치는 교호작용을 \(p=0.0105\)로 유의하다고 한다. 그러나 이 자료는 칸 분산이 57배 차이나므로 그 \(p\)를 믿을 수 없다. 이분산을 제대로 다루면 \(p=0.057\)로 경계 밖이다(연습문제 8, 6).
주변 웰치가 그래도 쓸모 있는 경우. 교호작용이 없고 설계가 균형이면 주변 웰치의 주효과가 이원배치의 주효과와 거의 같다. 그러나 그것을 미리 알 수 없다는 것이 문제다.
정리 — 본문 접근의 한계 셋.
- 교호작용을 볼 수 없다. 이원배치의 존재 이유가 사라진다.
- 주효과가 다른 요인의 변동에 오염된다. 검정력을 잃는다.
- 칸당 반복이 없으면 웰치 자체가 성립하지 않는다. \(s_{ij}^2\)이 없다.
연습문제 6. 본문 보기에서 효과크기 \(|g|\)가 2를 넘는데도 유의하지 않았다. 칸당 반복이 없을 때의 대가를 정량화하라.
풀이
import numpy as np
from statsmodels.stats.libqsturng import qsturng

rng = np.random.default_rng(9090)
M = 20_000
print("세 집단, 집단당 n, 등분산 σ=1 — 게임스-하웰이 한 쌍을 잡을 확률")
print(f"{'n':>4s} {'d=1':>8s} {'d=2':>8s} {'d=3':>8s} {'d=4':>8s}")
for n in [3, 5, 10, 20]:
    out = []
    for d in [1, 2, 3, 4]:
        hit = 0
        for _ in range(M // 4):
            x = rng.normal(0, 1, n)
            y = rng.normal(d, 1, n)
            s = x.var(ddof=1) / n + y.var(ddof=1) / n
            df = s**2 / ((x.var(ddof=1) / n)**2 / (n - 1)
                         + (y.var(ddof=1) / n)**2 / (n - 1))
            hit += abs(x.mean() - y.mean()) / np.sqrt(s / 2) > qsturng(0.95, 3, df)
        out.append(hit / (M // 4))
    print(f"{n:4d} " + " ".join(f"{o:8.4f}" for o in out))

print("\n최소 탐지 차이 (등분산 가정)")
for n in [3, 5, 10]:
    df = 2 * (n - 1)
    q = qsturng(0.95, 3, df)
    print(f"  n={n:2d}: q(0.95, 3, {df}) = {q:.4f} "
          f"→ 최소 탐지 차이 ≈ {q * np.sqrt(1 / n):.3f}σ")
세 집단, 집단당 n, 등분산 σ=1 — 게임스-하웰이 한 쌍을 잡을 확률
   n      d=1      d=2      d=3      d=4
   3   0.0562   0.2112   0.4624   0.7126
   5   0.1434   0.5858   0.9290   0.9972
  10   0.3922   0.9590   1.0000   1.0000
  20   0.7526   1.0000   1.0000   1.0000

최소 탐지 차이 (등분산 가정)
  n= 3: q(0.95, 3, 4) = 5.0332 → 최소 탐지 차이 ≈ 2.906σ
  n= 5: q(0.95, 3, 8) = 4.0375 → 최소 탐지 차이 ≈ 1.806σ
  n=10: q(0.95, 3, 18) = 3.6080 → 최소 탐지 차이 ≈ 1.141σ
\(n=3\)에서는 \(d=3\)이어야 검정력이 0.46이다. \(d=1\)(코헨 기준 "큼")에서는 0.056으로 유의수준과 거의 같다.
| \(n\) | 최소 탐지 차이 | \(d=2\)의 검정력 |
|---|---|---|
| 3 | 2.91\(\sigma\) | 0.21 |
| 5 | 1.81\(\sigma\) | 0.58 |
| 10 | 1.14\(\sigma\) | 0.96 |
본문 보기가 정확히 이 상황이었다. 칸당 \(n=1\)이므로 주변 집단이 \(n=3\)이고, 관측된 \(|g|\)가 2.3이었는데 \(p=0.066\)이었다. 표에서 \(n=3\), \(d\approx2\)의 검정력이 0.21이다.
"효과크기가 큰데 유의하지 않다"는 말의 정확한 의미. 표본이 작으면
- 표본 효과크기 자체가 매우 불안정하다. \(n=3\)에서 \(\hat d\)의 표준오차가 \(\sqrt{2/3+\hat d^2/4}\)로 크다.
- 유의성의 임계값이 터무니없이 높다(2.91\(\sigma\)).
- 유의하게 나온 \(\hat d\)는 위로 크게 편향되어 있다(승자의 저주).
세 번째가 무섭다. \(n=3\)에서 유의한 결과만 모으면 효과크기가 체계적으로 부풀려진다. 최소 2.91\(\sigma\)를 넘어야 유의하므로, 참값이 1\(\sigma\)여도 보고되는 추정값은 3\(\sigma\) 이상이 된다.
\(n=10\)이면 상황이 달라진다. \(d=2\)에서 검정력 0.96, 최소 탐지 차이 1.14\(\sigma\)다. 칸당 반복을 열 개만 확보해도 쓸 만한 설계가 된다.
요인설계의 표본 계획. \(a\times b\) 설계에서 총 \(N=abn\)이 필요하다. \(2\times3\)에 칸당 10이면 \(N=60\)이다. 칸 수가 늘면 비용이 곱으로 커진다는 것이 요인설계의 현실적 제약이다.
연습문제 7. 교호작용이 있을 때 쓰는 단순효과 검정을 웰치–제임스 틀로 수행하라. 1자유도 대비가 웰치 \(t\) 검정과 같음을 확인하라.
풀이
단순효과의 대비. \(B=j\)에서 \(A\)의 효과는 칸 평균 벡터에 대해
이고, 대비 행렬은 해당 두 자리만 \(\pm1\)인 \(1\times ab\) 행렬이다.
import numpy as np
import pandas as pd
from scipy import stats

def welch_james(m, v, n, Cm):
    m, v, n = np.asarray(m, float), np.asarray(v, float), np.asarray(n, float)
    V = np.diag(v / n)
    Q = Cm.T @ np.linalg.inv(Cm @ V @ Cm.T) @ Cm
    T = m @ Q @ m
    q = np.linalg.matrix_rank(Cm)
    VQ = V @ Q
    A = 0.0
    for i in range(len(n)):
        E = np.zeros_like(V); E[i, i] = 1
        M = VQ @ E
        A += 0.5 * (np.trace(M)**2 + np.trace(M @ M)) / (n[i] - 1)
    c = q + 2 * A - 6 * A / (q + 2)
    f = q * (q + 2) / (3 * A)
    return T / c, q, f, stats.f.sf(T / c, q, f)

rng = np.random.default_rng(202)
a, b = 2, 3
mu = np.array([[10.0, 13.0, 16.0], [11.0, 14.0, 24.0]])
sd = np.array([[1.0, 2.0, 6.0], [1.5, 3.0, 7.0]])
ns = np.array([[12, 10, 8], [9, 12, 11]])
rows = []
for i in range(a):
    for j in range(b):
        rows.append(pd.DataFrame({"y": rng.normal(mu[i, j], sd[i, j], ns[i, j]),
                                  "A": f"A{i}", "B": f"B{j}"}))
df = pd.concat(rows, ignore_index=True)
cell = df.groupby(["A", "B"]).y.agg(["size", "mean", "var"])
m, v, n = cell["mean"].values, cell["var"].values, cell["size"].values

print("B 수준별 A 의 단순효과")
print(f"{'B':>4s} {'A1-A0':>8s} {'F':>9s} {'df2':>8s} {'p':>9s} "
      f"{'본페로니 p':>10s}   대조(웰치 t 검정)")
for j in range(b):
    Cm = np.zeros((1, 6))
    Cm[0, j], Cm[0, 3 + j] = -1, 1
    F, q, f, p = welch_james(m, v, n, Cm)
    tt = stats.ttest_ind(df[(df.A == "A1") & (df.B == f"B{j}")].y,
                         df[(df.A == "A0") & (df.B == f"B{j}")].y,
                         equal_var=False)
    print(f"B{j:>3d} {m[3 + j] - m[j]:8.3f} {F:9.4f} {f:8.3f} {p:9.4f} "
          f"{min(1, 3 * p):10.4f}   t² = {tt.statistic**2:.4f}, p = {tt.pvalue:.4f}")
B 수준별 A 의 단순효과
   B    A1-A0         F      df2         p     본페로니 p   대조(웰치 t 검정)
B  0    1.173    1.7228   10.457    0.2174     0.6522   t² = 1.7228, p = 0.2174
B  1    0.077    0.0089   17.706    0.9258     1.0000   t² = 0.0089, p = 0.9258
B  2    7.993    6.9466   16.008    0.0180     0.0539   t² = 6.9466, p = 0.0180
1자유도 대비의 \(F\)가 웰치 \(t^2\)과 정확히 같다. \(p\)도 같다. 자유도 근사까지 일치한다.
\(q=1\)이면 요한센의 보정이 새터스웨이트로 환원되기 때문이다. \(q=1\)에서
이고, \(A\)가 곧 새터스웨이트 자유도의 역수가 된다.
결과를 읽자.
| \(B\) | \(A_1-A_0\) | 보정 전 \(p\) | 본페로니 \(p\) |
|---|---|---|---|
| \(B_0\) | \(+1.17\) | 0.217 | 0.652 |
| \(B_1\) | \(+0.08\) | 0.926 | 1.000 |
| \(B_2\) | \(+\mathbf{7.99}\) | 0.018 | 0.054 |
\(B_2\)에서만 효과가 크다(\(+7.99\)). 이것이 교호작용의 정체다.
본페로니 보정 후 \(p=0.054\)로 경계 밖이다. 교호작용 검정 자체가 \(p=0.057\)이었으므로(연습문제 8) 일관된 결과다. 이 자료는 "\(B_2\)에서 차이가 있어 보이지만 확언할 수 없다"가 정직한 결론이다.
왜 자료를 크게 만들었는데도 유의하지 않은가. \(B_2\) 칸의 분산이 21.3과 71.9로 압도적이다. 차이 7.99가 커 보여도 표준오차가 3.0 수준이다. 이분산이 검정력을 삼킨다.
단순효과를 볼 때의 원칙 넷.
- 교호작용이 유의할 때만 본다(또는 사전 계획된 경우).
- 다중비교(multiple comparisons) 보정을 반드시 한다.
- 각 칸의 분산을 따로 쓴다(합동하지 않는다).
- 차이의 신뢰구간을 함께 보고한다.
연습문제 8.
웰치–제임스 검정을 직접 구현하라. 요한센(1980)의 \(F\) 근사를 쓰고, 일원배치에서 pingouin의 웰치와 일치하는지로 검증하라.
풀이
발상. 칸 평균 벡터 \(\hat{\boldsymbol\mu}=(\bar y_{11},\dots,\bar y_{ab})'\)의 공분산은
이다(칸이 독립이므로 대각행렬). 검정하고 싶은 가설은 대비 행렬 \(\mathbf C\)로
라 쓸 수 있고, 왈드 통계량은
이다. \(T\)는 점근적으로 \(\chi^2_q\)이지만 작은 표본에서는 너무 크다. 요한센의 보정은
이고 \(A\)는 각 칸의 자유도로부터 계산한다.
import numpy as np
import pandas as pd
from scipy import stats
import pingouin as pg

def welch_james(m, v, n, Cm):
    """요한센(1980)의 웰치-제임스 검정. Cm 은 칸 평균에 대한 대비 행렬."""
    m, v, n = np.asarray(m, float), np.asarray(v, float), np.asarray(n, float)
    V = np.diag(v / n)
    Q = Cm.T @ np.linalg.inv(Cm @ V @ Cm.T) @ Cm
    T = m @ Q @ m
    q = np.linalg.matrix_rank(Cm)
    VQ = V @ Q
    A = 0.0
    for i in range(len(n)):
        E = np.zeros_like(V)
        E[i, i] = 1
        M = VQ @ E
        A += 0.5 * (np.trace(M)**2 + np.trace(M @ M)) / (n[i] - 1)
    c = q + 2 * A - 6 * A / (q + 2)
    f = q * (q + 2) / (3 * A)
    return T / c, q, f, stats.f.sf(T / c, q, f)

def factorial_contrasts(a, b):
    """a×b 요인설계의 주효과·교호작용 대비 행렬."""
    Ja, Jb = np.ones(a) / a, np.ones(b) / b
    Ca, Cb = np.zeros((a - 1, a)), np.zeros((b - 1, b))
    for i in range(a - 1):
        Ca[i, i], Ca[i, i + 1] = 1, -1
    for j in range(b - 1):
        Cb[j, j], Cb[j, j + 1] = 1, -1
    return np.kron(Ca, Jb), np.kron(Ja, Cb), np.kron(Ca, Cb)

# --- 검증 1: 일원배치에서 pingouin 과 일치하는가 ---
rng = np.random.default_rng(42)
ns1, mus, sds = [12, 18, 9], [0, 0.4, 0.9], [1.0, 2.0, 3.0]
gs = [rng.normal(u, s, n) for n, u, s in zip(ns1, mus, sds)]
C1 = np.array([[1.0, -1, 0], [0, 1, -1]])
F, q, f, p = welch_james([g.mean() for g in gs],
                         [g.var(ddof=1) for g in gs], ns1, C1)
print(f"웰치-제임스: F = {F:.6f}, df = ({q}, {f:.6f}), p = {p:.6f}")
d1 = pd.DataFrame({"y": np.concatenate(gs),
                   "g": np.concatenate([[f"G{i}"] * n
                                        for i, n in enumerate(ns1)])})
r = pg.welch_anova(dv="y", between="g", data=d1)
print(f"pingouin  : F = {r.F[0]:.6f}, df = ({r.ddof1[0]}, "
      f"{r.ddof2[0]:.6f}), p = {r.p_unc[0]:.6f}")

# --- 적용 2: 연습문제 5 의 2×3 자료 ---
rng = np.random.default_rng(202)
a, b = 2, 3
mu = np.array([[10.0, 13.0, 16.0], [11.0, 14.0, 24.0]])
sd = np.array([[1.0, 2.0, 6.0], [1.5, 3.0, 7.0]])
ns = np.array([[12, 10, 8], [9, 12, 11]])
rows = []
for i in range(a):
    for j in range(b):
        rows.append(pd.DataFrame({"y": rng.normal(mu[i, j], sd[i, j], ns[i, j]),
                                  "A": f"A{i}", "B": f"B{j}"}))
df = pd.concat(rows, ignore_index=True)
cell = df.groupby(["A", "B"]).y.agg(["size", "mean", "var"])
m, v, n = cell["mean"].values, cell["var"].values, cell["size"].values

CA, CB, CAB = factorial_contrasts(a, b)
print("\n2×3 웰치-제임스")
for lab, Cm in [("A 주효과", CA), ("B 주효과", CB), ("A×B", CAB)]:
    F, q, f, p = welch_james(m, v, n, Cm)
    print(f"  {lab:8s} F = {F:8.4f}  df = ({q}, {f:7.3f})  p = {p:.4f}")
웰치-제임스: F = 2.062345, df = (2, 17.185272), p = 0.157479
pingouin  : F = 2.062345, df = (2, 17.185272), p = 0.157479

2×3 웰치-제임스
  A 주효과    F =   8.0112  df = (1,  21.182)  p = 0.0100
  B 주효과    F =  24.8803  df = (2,  26.461)  p = 0.0000
  A×B      F =   3.2044  df = (2,  26.461)  p = 0.0567
일원배치에서 소수점 여섯 자리까지 일치한다. 요한센의 검정이 웰치의 일반화임이 확인된다.
2×3 결과가 표준 이원배치와 갈린다.
| 효과 | 표준 \(F\) | 웰치–제임스 |
|---|---|---|
| A 주효과 | \(p=0.0113\) | \(p=0.0100\) |
| B 주효과 | \(p<0.0001\) | \(p<0.0001\) |
| A×B | \(p=\mathbf{0.0105}\) | \(p=\mathbf{0.0567}\) |
교호작용의 판정이 뒤집힌다. 표준 \(F\)는 유의, 웰치–제임스는 비유의다. 어느 쪽을 믿어야 하나.
웰치–제임스다. 칸 분산이 57배 차이나는 자료에서 표준 \(F\)의 \(p\)는 신뢰할 수 없다. 연습문제 9가 이를 모의실험으로 확인한다.
대비 행렬이 이 구현의 핵심이다. 크로네커 곱으로 쓰면
이다. \(\mathbf J_b=\frac1b\mathbf 1_b'\)가 평균을 내는 연산이고, \(\mathbf C_a\)가 차이를 내는 연산이다. 주효과는 "한쪽은 평균, 한쪽은 차이", 교호작용은 "양쪽 다 차이"다.
이 틀의 확장성. \(\mathbf C\)만 바꾸면 어떤 대비든 검정할 수 있다. 단순효과(연습문제 7), 추세 대비, 특정 칸 쌍의 비교가 모두 같은 함수로 처리된다.
연습문제 9. 표준 이원배치 \(F\), 웰치–제임스, HC3 로버스트 왈드 \(F\)의 제1종 오류율을 이분산 아래에서 비교하라.
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np
import pandas as pd
from scipy import stats
import statsmodels.api as sm
from statsmodels.formula.api import ols

def welch_james(m, v, n, Cm):
    m, v, n = np.asarray(m, float), np.asarray(v, float), np.asarray(n, float)
    V = np.diag(v / n)
    Q = Cm.T @ np.linalg.inv(Cm @ V @ Cm.T) @ Cm
    T = m @ Q @ m
    q = np.linalg.matrix_rank(Cm)
    VQ = V @ Q
    A = 0.0
    for i in range(len(n)):
        E = np.zeros_like(V); E[i, i] = 1
        M = VQ @ E
        A += 0.5 * (np.trace(M)**2 + np.trace(M @ M)) / (n[i] - 1)
    c = q + 2 * A - 6 * A / (q + 2)
    return stats.f.sf(T / c, q, q * (q + 2) / (3 * A))

def factorial_contrasts(a, b):
    Ja, Jb = np.ones(a) / a, np.ones(b) / b
    Ca, Cb = np.zeros((a - 1, a)), np.zeros((b - 1, b))
    for i in range(a - 1):
        Ca[i, i], Ca[i, i + 1] = 1, -1
    for j in range(b - 1):
        Cb[j, j], Cb[j, j + 1] = 1, -1
    return np.kron(Ca, Jb), np.kron(Ja, Cb), np.kron(Ca, Cb)

a, b = 2, 3
CA, CB, CAB = factorial_contrasts(a, b)
NS = np.array([[15, 12, 6], [14, 10, 5]])     # 작은 칸에 큰 분산 = 역페어링
SD = np.array([[1.0, 2.0, 5.0], [1.0, 2.0, 5.0]])

rng = np.random.default_rng(1212)
B = 1_500
cnt = {k: np.zeros(3) for k in ["표준 F", "웰치-제임스", "HC3"]}
for _ in range(B):
    rows = []
    for i in range(a):
        for j in range(b):
            rows.append(pd.DataFrame({"y": rng.normal(0, SD[i, j], NS[i, j]),
                                      "A": f"A{i}", "B": f"B{j}"}))
    df = pd.concat(rows, ignore_index=True)
    cell = df.groupby(["A", "B"]).y.agg(["size", "mean", "var"])
    m, v, n = cell["mean"].values, cell["var"].values, cell["size"].values

    t = sm.stats.anova_lm(ols("y ~ C(A)*C(B)", data=df).fit(), typ=2)
    cnt["표준 F"] += np.array([t.loc["C(A)", "PR(>F)"],
                               t.loc["C(B)", "PR(>F)"],
                               t.loc["C(A):C(B)", "PR(>F)"]]) < 0.05
    cnt["웰치-제임스"] += np.array([welch_james(m, v, n, CA),
                                    welch_james(m, v, n, CB),
                                    welch_james(m, v, n, CAB)]) < 0.05

    fit = ols("y ~ C(A, Sum)*C(B, Sum)", data=df).fit(cov_type="HC3")
    idx = list(fit.params.index)
    ps = []
    for pick in [lambda s: s.startswith("C(A, Sum)[") and ":" not in s,
                 lambda s: s.startswith("C(B, Sum)[") and ":" not in s,
                 lambda s: ":" in s]:
        nm = [x for x in idx if pick(x)]
        R = np.zeros((len(nm), len(idx)))
        for r, x in enumerate(nm):
            R[r, idx.index(x)] = 1
        ps.append(float(fit.f_test(R).pvalue))
    cnt["HC3"] += np.array(ps) < 0.05

print("2×3 완전 귀무, n=[[15,12,6],[14,10,5]], σ=[[1,2,5],[1,2,5]], B=1500")
print(f"{'방법':>12s} {'A 주효과':>9s} {'B 주효과':>9s} {'A×B':>9s}")
for k, x in cnt.items():
    print(f"{k:>12s} {x[0] / B:9.4f} {x[1] / B:9.4f} {x[2] / B:9.4f}")
2×3 완전 귀무, n=[[15,12,6],[14,10,5]], σ=[[1,2,5],[1,2,5]], B=1500
          방법     A 주효과     B 주효과       A×B
        표준 F    0.0687    0.2400    0.2113
      웰치-제임스    0.0467    0.0467    0.0447
         HC3    0.0487    0.0540    0.0493
표준 \(F\)의 B 주효과 오류율이 0.24다. 명목의 다섯 배다. 교호작용도 0.21이다.
| 효과 | 표준 \(F\) | 웰치–제임스 | HC3 |
|---|---|---|---|
| A 주효과 | 0.069 | 0.047 | 0.049 |
| B 주효과 | 0.240 | 0.047 | 0.054 |
| A×B | 0.211 | 0.045 | 0.049 |
A 주효과만 비교적 멀쩡하다(0.069). 분산이 B의 수준에 따라서만 달라지기 때문이다. A의 두 수준은 분산 구조가 같으므로 합동이 덜 해롭다.
B 주효과와 교호작용이 크게 무너진다. 이 둘은 분산이 다른 칸들을 직접 비교한다. \(\sigma=5\)인 칸의 \(n\)이 5~6뿐인데 합동 MSE는 \(n=15\)인 \(\sigma=1\) 칸에 지배된다.
웰치–제임스와 HC3이 모두 명목 수준을 지킨다. 접근이 전혀 다른데도 결과가 같다.
| 웰치–제임스 | HC3 | |
|---|---|---|
| 출발점 | 칸 평균의 공분산 | 회귀계수의 로버스트 공분산 |
| 자유도 | 요한센 근사(소수) | \(N-p\) (정수) |
| 구현 | 직접 작성 | cov_type="HC3" |
| 불균형 | 자연스럽게 처리 | 합 대비 필수 |
웰치–제임스가 미세하게 더 정확하다(0.045~0.047 대 0.049~0.054). 자유도를 표본 구조에 맞춰 줄이기 때문이다. HC3은 자유도를 \(N-p\)로 고정하므로 작은 칸이 있으면 약간 관대하다(명목보다 조금 자주 기각한다).
실무 권고. HC3이 손쉽고 충분히 좋다. 칸이 아주 작거나(\(n_{ij}\leq5\)) 정밀한 오류율 통제가 필요하면 웰치–제임스를 쓴다.
연습문제 10. 불균형 설계에서 "\(A\)의 주효과"에 두 가지 정의가 있다. 둘을 계산해 비교하고, 웰치–제임스가 어느 쪽을 검정하는지 밝혀라.
풀이
두 정의.
import numpy as np
import pandas as pd

mu = np.array([[10.0, 13.0, 16.0],
               [11.0, 14.0, 24.0]])
ns = np.array([[12, 10, 8],
               [9, 12, 11]])

print("칸 평균")
print(pd.DataFrame(mu, index=["A0", "A1"],
                   columns=["B0", "B1", "B2"]).to_string())
print("\n칸 크기")
print(pd.DataFrame(ns, index=["A0", "A1"],
                   columns=["B0", "B1", "B2"]).to_string())

un = mu.mean(1)
wt = (mu * ns).sum(1) / ns.sum(1)
print(f"\n{'':4s} {'비가중 주변평균':>14s} {'가중 주변평균':>13s}")
for i, lab in enumerate(["A0", "A1"]):
    print(f"{lab:4s} {un[i]:14.4f} {wt[i]:13.4f}")
print(f"{'차이':4s} {un[1] - un[0]:14.4f} {wt[1] - wt[0]:13.4f}")

unb = mu.mean(0)
wtb = (mu * ns).sum(0) / ns.sum(0)
print(f"\nB 수준별  비가중 {np.round(unb, 3).tolist()}   "
      f"가중 {np.round(wtb, 3).tolist()}")
칸 평균
      B0    B1    B2
A0  10.0  13.0  16.0
A1  11.0  14.0  24.0

칸 크기
    B0  B1  B2
A0  12  10   8
A1   9  12  11

           비가중 주변평균       가중 주변평균
A0          13.0000       12.6000
A1          16.3333       16.5938
차이           3.3333        3.9938

B 수준별  비가중 [10.5, 13.5, 20.0]   가중 [10.429, 13.545, 20.632]
A의 효과가 3.33이냐 3.99냐. 20% 차이다.
왜 다른가. \(A_1\)에서 \(B_2\)(가장 큰 칸 평균 24)의 표본이 11개로 많고, \(A_0\)에서는 8개로 적다. 가중 평균이 \(A_1\)을 더 밀어 올린다.
웰치–제임스는 비가중을 검정한다. 대비 행렬에
를 썼기 때문이다. \(n_{ij}\)가 들어가지 않는다.
어느 쪽이 옳은가. 설계의 성격에 달렸다.
| 상황 | 옳은 정의 |
|---|---|
| \(n_{ij}\)가 우연히 달라짐(결측, 탈락) | 비가중 |
| \(n_{ij}\)가 모집단 비율을 반영 | 가중 |
| 실험 설계(연구자가 배정) | 비가중 |
| 표본조사(층별 비율이 모집단 구조) | 가중 |
예시로 보면 분명하다. 약 \(A\)의 효과를 남녀(요인 \(B\))에 걸쳐 본다고 하자.
- "평균적인 사람에게 약 \(A\)가 얼마나 효과적인가" → 모집단의 남녀 비율로 가중
- "약 \(A\)가 효과적인가(성별과 무관하게)" → 비가중(남녀를 대등하게)
표본이 우연히 남성 위주로 모였다면 가중은 위험하다. 표본의 불균형이 모집단을 반영하지 않기 때문이다.
제곱합 유형과의 대응.
| 제곱합 | 검정하는 주변평균 |
|---|---|
| 제I형 | 순서에 의존(해석 어려움) |
| 제II형 | 가중에 가까움 |
| 제III형 | 비가중 |
| 웰치–제임스 | 비가중 |
웰치–제임스는 제III형에 대응한다. 그래서 연습문제 9에서 HC3 + 합 대비(제III형)와 결과가 비슷했다.
보고할 때. 어느 주변평균을 검정했는지 명시한다. "비가중 주변평균(최소제곱평균)으로 \(A\)의 주효과를 검정했다"고 쓰면 독자가 오해하지 않는다.
교호작용이 없으면 이 구분이 사라진다. \(\mu_{ij}=\mu+\alpha_i+\beta_j\)이면 두 주변평균의 차이가 같다. 불균형과 교호작용이 함께 있을 때만 문제가 된다.
정리하며
웰치의 발상을 요인이 둘인 설계로 확장한다.
- 일원배치와 같은 원리다. 칸마다 분산을 따로 추정하고 가중하며, 자유도를 근사한다.
- 교호작용까지 다룬다. 주효과 둘과 교호작용 하나를 모두 이분산 아래에서 검정할 수 있다.
- 구현이 표준화되어 있지 않다. 일원배치의 웰치는 널리 제공되지만 이원배치판(웰치–제임스)은 주류 라이브러리에 없는 경우가 많아, 다음다음 절의 로버스트 OLS 접근이 현실적인 대안이 된다.
- 불균형 설계에서 가치가 크다. 설문이나 관찰자료처럼 칸마다 관측 수와 변동이 다른 상황이 전형적이다.
- 정규성은 여전히 가정한다. 이분산만 해결할 뿐이다.
다음 절 웰치 분산분석의 제1종 오류와 검정력 모의실험에서 그 이득을 수치로 확인한다.