모형을 세우면 무엇을 버는가
개요
같은 포아송 자료에 적합 둘을 걸었다. 분포를 가정하고 수 하나로 요약한 쪽은 남겨 둔 시험자료에서 RMSE 가 \(0.01882\), 관측 빈도를 그대로 쓴 쪽은 \(0.03342\) 이고, 모형이 정확히 맞는 동안 모수적 쪽이 네 번에 세 번 넘게 이긴다. 그런데 참분포를 조금만 어긋내면 두 쪽이 뒤집히는 자리가 \(n^{*} \approx 174\) 로 내려앉아, 승부를 가른 표본크기가 이미 교차점 너머가 된다. 가정 하나를 지키는 값이 표본크기에 이렇게 매달려 있다면, 모형을 세워 무엇을 벌고 그 벌이는 어디까지 가는가.
포아송 자료 하나에 두 가지 적합을 나란히 놓는다. 하나는 분포를 가정하고 모수를 최대가능도로 맞춘 것이고(수 하나, \(\hat\lambda\)), 다른 하나는 관측된 빈도를 그대로 쓴 것이다(상자마다 하나씩, 경험 PMF). 둘을 남겨 둔 시험자료에서 재면 모형을 세운 값이 수로 나온다.
이 쪽이 묻는 것은 「비모수(nonparametric) 추정을 어떻게 하는가」가 아니라 「모형을 세우면 무엇을 버는가」다. 경험 PMF 는 그 벌이를 재기 위한 기준선으로만 쓴다 — 비모수적 방법 자체는 16장 비모수 검정과 17장 재표집 방법이 맡는다.
답은 셋이다. 모형이 맞는 동안은 꼬리 확률을 가운데 자료에서 빌려 와 이기고, 틀린 정도가 언제 추월당하는지를 정하며(\(n^{*} \propto \text{편향}^{-2}\)), 추월하는 것은 모형 없음이 아니라 더 넓은 모형족이다.
1. 포아송 모형을 적합한다
\(X_1, \ldots, X_n \overset{\text{iid}}{\sim} \text{Poisson}(\lambda)\) 의 최대가능도추정량은 \(\hat\lambda_{\text{MLE}} = \bar x\) 다 — 유도와 성질은 포아송분포의 최대가능도 정리 1 에 있다. 여기서는 그 적합값을 경험분포와 견줄 한쪽 끝으로만 쓴다. 적합이 내놓는 확률질량함수(probability mass function)는
이고, 상자 \(K\) 개의 확률을 수 하나로 적은 것이다. 견줄 상대는 상자마다 하나씩 세는 상대도수 \(\hat p_k = (\text{도수})/n\) 이다.
보기 1. 포아송분포(Poisson distribution)의 MLE. \(X_1, \ldots, X_n\)이 독립인 \(\text{Poisson}(\lambda)\)일 때 \(\lambda = 4.5\), \(n = 200\)인 자료를 만들어 적합한다.
(1) \(\hat\lambda\)를 유도하고 최대임을 확인하시오. 자료가 모두 \(0\)인 경우까지 공식이 통하는가. \(\hat\lambda\)의 표준오차도 구하시오.
(2) 코드가 \(\hat\lambda = 4.4800\)을 준다. (1)의 표준오차에 비추어 그럴듯한 값인가.
풀이
(1) 해석적으로. \(\lambda\)에 의존하지 않는 \(-\sum\log(x_i!)\)를 빼면
이다. 미분해 \(0\)으로 두면
최대임의 확인. \(\sum x_i > 0\)일 때
이 \(\lambda > 0\) 전체에서 성립하므로 \(\ell\)이 엄밀히 오목하고 정류점이 유일한 전역 최대다.
끝점. \(\sum x_i = 0\)이면(관측이 모두 \(0\)이면) 위 이계도함수가 \(0\)이 되어 오목성 논증이 통하지 않는다. 그러나 이때 \(\ell(\lambda) = -n\lambda\)가 순감소함수이므로 최대는 왼쪽 끝 \(\lambda = 0\)이고, 이는 \(\bar x = 0\)을 공식에 넣은 값과 같다. \(\hat\lambda = \bar x\)가 그대로 통한다.
표준오차. 관측 하나의 피셔 정보는
이므로
이다. \(\operatorname{Var}(\bar X) = \operatorname{Var}(X)/n = \lambda/n\)과 같은 값이다. 포아송에서 분산이 평균과 같다는 사실이 여기에 그대로 나타난다. 표본평균(sample mean)은 하한을 등호로 달성한다.
(2) 수치적으로. 적합한 뒤 참값에서 몇 표준오차나 떨어졌는지 함께 찍는다.
import numpy as np
from scipy import stats

def poisson_mle_demo(n_train=200, n_test=200, lam_true=4.5):
    """포아송분포의 MLE — 모수적 적합과 비모수적 적합을 견준다."""
    np.random.seed(42)
    train = np.random.poisson(lam_true, n_train)
    test = np.random.poisson(lam_true, n_test)

    lam_hat = train.mean()
    k_max = max(train.max(), test.max()) + 1
    k_vals = np.arange(k_max)

    # 모수적 적합: MLE를 넣은 확률질량함수.
    pmf_param = stats.poisson.pmf(k_vals, lam_hat)

    # 비모수적 적합: 자료의 상대도수를 그대로 쓴다.
    pmf_train = np.bincount(train, minlength=k_max) / n_train
    pmf_test = np.bincount(test, minlength=k_max) / n_test

    # 시험자료에서의 RMSE.
    err_param = np.sqrt(np.mean((pmf_param - pmf_test)**2))
    err_nonparam = np.sqrt(np.mean((pmf_train - pmf_test)**2))

    print(f"True lambda = {lam_true:.2f}")
    print(f"MLE lambda_hat = {lam_hat:.4f}")
    print(f"Test RMSE -- parametric: {err_param:.5f}")
    print(f"Test RMSE -- nonparametric: {err_nonparam:.5f}")

    # 아래 그림에서 다시 쓰도록 계산 결과를 돌려준다
    return k_vals, pmf_param, pmf_train, pmf_test

k_vals, pmf_param, pmf_train, pmf_test = poisson_mle_demo()

# (1) 에서 구한 표준오차와 견준다. 함수가 안에서 씨앗을 다시 심으므로
# 여기서 같은 자료를 다시 만들어도 값이 같다.
np.random.seed(42)
train = np.random.poisson(4.5, 200)
lam_hat = train.mean()
se = np.sqrt(4.5 / 200)

print(f"\nsum x_i = {train.sum()},  n = {len(train)}")
print(f"lambda-hat = x-bar = {lam_hat:.4f}")
print(f"SE(lambda-hat) = sqrt(lambda/n) = {se:.4f}")
print(f"(lambda-hat - lambda)/SE = {(lam_hat - 4.5) / se:+.3f}")
print(f"표본분산 = {train.var(ddof=1):.4f}  (포아송이면 평균과 같아야 한다)")
출력:
True lambda = 4.50
MLE lambda_hat = 4.4800
Test RMSE -- parametric: 0.01882
Test RMSE -- nonparametric: 0.03342

sum x_i = 896,  n = 200
lambda-hat = x-bar = 4.4800
SE(lambda-hat) = sqrt(lambda/n) = 0.1500
(lambda-hat - lambda)/SE = -0.133
표본분산 = 4.7634  (포아송이면 평균과 같아야 한다)
그럴듯한 값이다. \(\hat\lambda = 4.48\)이 참값 \(4.5\)에서 \(0.02\) 떨어져 있고 표준오차가 \(0.15\)이므로 \(0.13\) 표준오차, 거의 한가운데다. \(\hat\lambda = \sum x_i / n = 896/200\)이 정확히 \(4.48\)이어서 유도한 공식과 코드가 같은 수를 준다.
표본분산(sample variance) \(4.7634\)가 표본평균 \(4.48\)과 가깝다는 것도 함께 볼 만하다. 포아송이면 평균과 분산이 같아야 하므로, 둘이 크게 어긋나면 포아송 가정 자체를 의심해야 한다는 신호가 된다. 여기서는 비가 \(4.7634/4.48 = 1.063\)으로 \(1\)에 가깝다.
출력의 RMSE 두 줄은 아래 보기 2에서 이론값과 함께 따진다.
2. 경험분포와 견주면
보기 2. 모수적 적합과 경험분포의 비교. 보기 1의 적합을 훈련자료와 시험자료에 나란히 겹쳐 그린다.
(1) 시험자료에 대한 RMSE의 이론값을 모수적·비모수적 두 쪽 모두 구하시오. 왜 모수적 쪽이 작아야 하는가.
(2) 그림을 그려 무엇이 보이는지 적고, 보기 1이 준 \(0.01882\)와 \(0.03342\)가 (1)의 이론값과 맞는지 모의실험으로 확인하시오.
풀이
(1) 해석적으로. 참 확률을 \(p_k\), 상자 수를 \(K\), 훈련·시험 표본크기를 모두 \(n\)이라 하자.
비모수적 쪽. 각 상자의 상대도수는 \(\hat p_k = (\text{도수})/n\)이고 \(n\hat p_k \sim \text{Binomial}(n, p_k)\)이므로 \(\operatorname{Var}(\hat p_k) = p_k(1-p_k)/n\)이다. 훈련과 시험이 독립이므로
모수적 쪽. 적합값은 \(\tilde p_k = e^{-\hat\lambda}\hat\lambda^k/k!\)이고 \(\hat\lambda\) 둘레에서 한 번 펴면
이다(\(\operatorname{Var}(\hat\lambda) = \lambda/n\)을 썼다). 시험자료의 잡음은 그대로 남으므로
왜 모수적 쪽이 작은가. 두 식을 나란히 놓으면 차이가 분명하다. 비모수적 쪽은 상자마다 따로 추정하므로 잡음 항이 \(p_k(1-p_k)/n\)으로 \(p_k\)에 일차다. 모수적 쪽은 상자 \(K\)개를 숫자 하나(\(\hat\lambda\))로 요약하므로 잡음 항이 \(p_k^2\)에 비례한다. 확률은 \(1\)보다 작으니 \(p_k^2 \ll p_k\)이고, 그만큼 추정 잡음이 줄어든다. \(K\)개의 자유도를 \(1\)개로 줄인 대가가 이것이다 — 모형이 맞다는 전제 아래에서.
\(\lambda = 4.5\), \(n = 200\), \(K = 12\)를 넣으면
이다(아래 코드가 이 수를 찍는다).
(2) 수치적으로. 먼저 그림이다.
import matplotlib.pyplot as plt

# 위 함수가 돌려준 값을 그대로 쓴다.
fig, axes = plt.subplots(1, 2, figsize=(12, 5))

# 왼쪽: 훈련자료에 대한 적합.
# 막대(모수적 MLE)와 점(경험적 PMF)이 잘 겹친다. 같은 자료로 맞췄으니 당연하다.
axes[0].bar(k_vals, pmf_param, color="white", edgecolor="black",
            lw=1.5, label="Parametric (MLE)")
axes[0].plot(k_vals, pmf_train, "ko", ms=5, label="Empirical (train)")
axes[0].set_title("Poisson: Train Fit")
axes[0].legend()

# 오른쪽: **보지 않은** 시험자료에 대한 적합. 여기가 진짜 시험이다.
# 막대는 왼쪽과 똑같다(모형은 훈련자료로만 맞췄으므로).
# 빨간 점만 새 자료로 바뀌었는데도 막대를 잘 따라간다.
# 반면 경험적 PMF는 훈련자료의 우연한 들쭉날쭉함까지 외웠기 때문에
# 새 자료에서는 오차가 더 크다. 위 출력의 RMSE 두 값이 그 차이다.
axes[1].bar(k_vals, pmf_param, color="white", edgecolor="black",
            lw=1.5, label="Parametric (MLE)")
axes[1].plot(k_vals, pmf_test, "ro", ms=5, label="Empirical (test)")
axes[1].set_title("Poisson: Test Fit")
axes[1].legend()

plt.tight_layout()
plt.show()
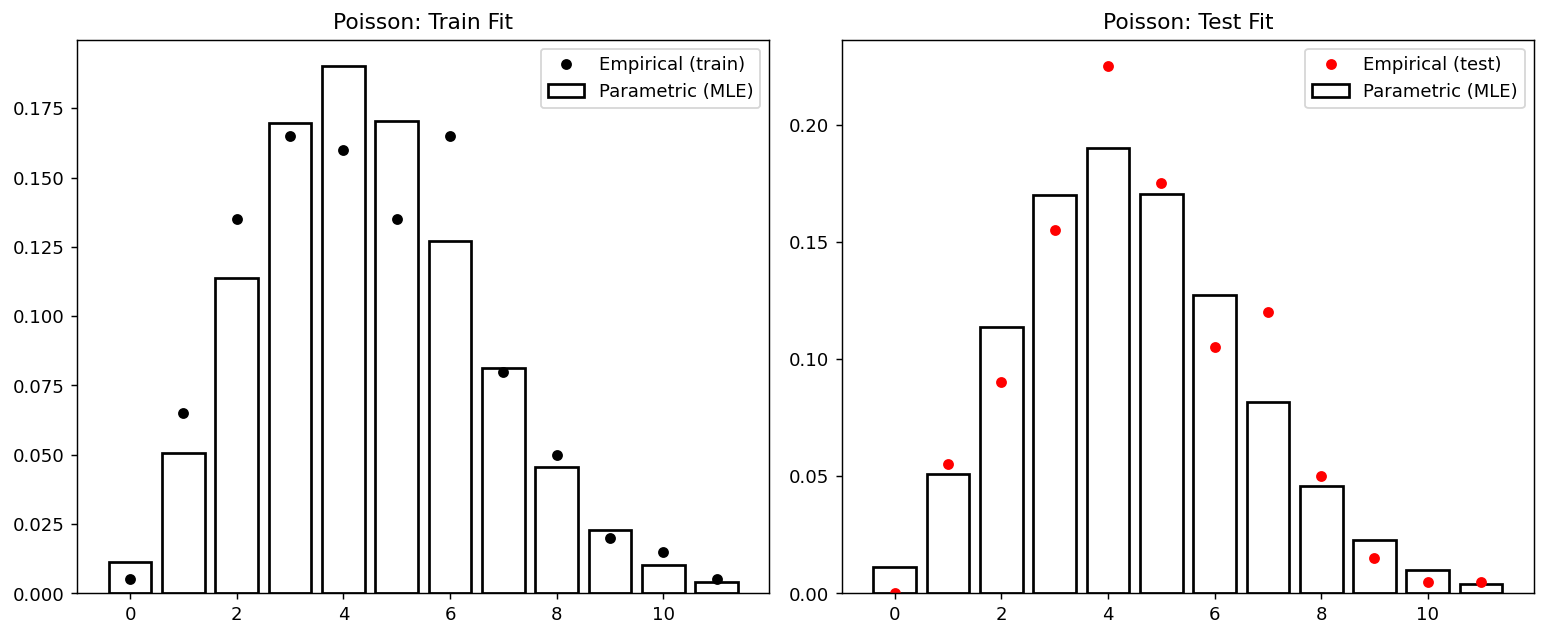
왼쪽은 당연하고 오른쪽이 시험이다. 왼쪽에서 막대(모수적 적합)와 점(훈련자료의 경험 PMF)이 잘 겹치는 것은 같은 자료로 맞췄으니 놀랍지 않다. 오른쪽은 막대가 똑같은데 점만 보지 않은 시험자료로 바뀌었고, 그래도 막대를 잘 따라간다.
가장 눈에 띄는 것은 \(k = 0\)이다. 시험자료에는 \(0\)이 한 번도 없어서 빨간 점이 바닥에 붙어 있는데 포아송 막대는 \(0.0113\)을 준다. 상대도수가 \(0/200\)이라고 해서 확률이 정말 \(0\)인 것은 아니다. \(k = 9, 10, 11\)에서도 시험 도수가 각각 \(3, 1, 1\)개뿐이라 점이 크게 흔들리는 반면 막대는 매끄럽다. 모수적 적합은 꼬리의 확률을 가운데 자료에서 빌려 온다. (1)에서 잡음 항이 \(p_k\) 대신 \(p_k^2\)에 비례한 것이 이 "빌려 옴"의 수치적 모습이다.
물론 모수적 적합도(goodness of fit) 어긋난다. \(k = 7\)에서 막대는 \(0.0814\)인데 시험 점은 \(0.1200\)이다. 다만 같은 자리에서 훈련자료의 경험 PMF는 \(0.0800\)이어서 역시 비껴난다. 상자별로 보면 어느 쪽이 이길지 알 수 없고, 전체 평균에서 차이가 난다.
이제 (1)의 이론값을 확인한다.
import numpy as np
from scipy import stats

lam, n, K = 4.5, 200, 12          # K = 위 적합이 쓴 상자 수 k_max
k = np.arange(K)
p = stats.poisson.pmf(k, lam)

# (1) 의 이론값.
mse_np = np.mean(2 * p * (1 - p) / n)
mse_pa = np.mean(p * (1 - p) / n + p**2 * (k - lam)**2 / (lam * n))
print(f"이론  비모수 RMSE = {np.sqrt(mse_np):.5f}")
print(f"이론  모수   RMSE = {np.sqrt(mse_pa):.5f}   (비 {np.sqrt(mse_np / mse_pa):.3f})")

# 같은 실험을 4000번 반복해 평균제곱오차를 잰다.
rng = np.random.default_rng(1)
A, B = [], []
for _ in range(4000):
    tr = rng.poisson(lam, n)
    te = rng.poisson(lam, n)
    pp = stats.poisson.pmf(k, tr.mean())
    ptr = np.bincount(tr, minlength=K)[:K] / n
    pte = np.bincount(te, minlength=K)[:K] / n
    A.append(np.mean((pp - pte)**2))
    B.append(np.mean((ptr - pte)**2))
A, B = np.array(A), np.array(B)
print(f"\n모의  비모수 RMSE = {np.sqrt(B.mean()):.5f}")
print(f"모의  모수   RMSE = {np.sqrt(A.mean()):.5f}   (비 {np.sqrt(B.mean() / A.mean()):.3f})")
print(f"모수 쪽이 이긴 비율 = {(A < B).mean():.3f}")

# 보기 1 이 준 한 번의 값은 이 분포의 어디쯤인가.
print(f"\n0.01882 는 모수 RMSE 분포의 {(np.sqrt(A) < 0.01882).mean():.0%} 분위")
print(f"0.03342 는 비모수 RMSE 분포의 {(np.sqrt(B) < 0.03342).mean():.0%} 분위")
출력:
이론  비모수 RMSE = 0.02681
이론  모수   RMSE = 0.01971   (비 1.360)

모의  비모수 RMSE = 0.02701
모의  모수   RMSE = 0.01984   (비 1.362)
모수 쪽이 이긴 비율 = 0.871

0.01882 는 모수 RMSE 분포의 51% 분위
0.03342 는 비모수 RMSE 분포의 85% 분위
이론과 모의가 맞는다. 비모수 \(0.02681\) 대 \(0.02701\), 모수 \(0.01971\) 대 \(0.01984\)로 둘 다 \(1\%\) 안에서 일치하고 비도 \(1.360\) 대 \(1.362\)다. (1)의 분해가 옳았다.
보기 1의 한 번은 조금 유리한 뽑기였다. 모수 쪽 \(0.01882\)는 분포의 \(51\%\) 분위로 전형적인데, 비모수 쪽 \(0.03342\)는 \(85\%\) 분위로 평소보다 나쁜 쪽이다. 그래서 그 한 번에서는 비가 \(0.03342/0.01882 = 1.78\)로 보였지만 평균적으로는 \(1.36\)이다. 한 번의 실행에서 본 격차를 그대로 일반화하면 안 된다는 뜻이고, 이 쪽에서 가장 조심해야 할 대목이다.
모수적 쪽이 언제나 이기지는 않는다. \(4000\)번 중 \(87.1\%\)에서만 이겼다. 모형이 정확히 맞는 이 유리한 상황에서도 여덟 번에 한 번은 경험 PMF가 더 나은데, 모형이 틀어지면 그 비율이 빠르게 뒤집힌다. 아래 경고 상자가 말하는 바가 이것이다.
3. 모형이 맞으면 모수적이 이긴다
- 모수적 모형이 더 잘 일반화된다. 가정한 모형족이 옳으면(자료가 실제로 포아송분포에서 나왔으면) MLE에 기반한 모수적 PMF가 비모수적 경험 PMF보다 시험자료의 RMSE가 대체로 작다. 모수적 모형은 함수 형태를 통해 모든 \(k\) 값에 걸쳐 "힘을 빌려" 온다.
- 비모수적 모형은 더 유연하지만 잡음이 많다. 경험 PMF는 훈련 자료에서 관측되지 않은 값에 확률 0을 부여한다. 훈련 표본이 작으면(포아송에서 \(n = 200\)) 이 이산성 효과가 꼬리에서 두드러진다.
- 포아송 로그가능도는 오목하므로 기울기 기반 최적화가 유일한 전역 MLE 로 수렴함이 보장된다. 기하분포도 그러하며, 그 곡면은 기하분포의 최대가능도 보기 2 가 그린다.
- 모형 설정 오류의 위험. 참 자료생성과정이 포아송이 아니면 모수적 모형이 자료를 체계적으로 잘못 적합할 수 있고, 그때는 비모수적 접근이 더 나을 수 있다.
모수적 가정이 중요하다
모수적 적합이 시험자료에서 더 나은 성능을 보이는 것은 모형이 올바르게 설정되었을 때의 이야기이다. 경험분포보다 모수적 모형을 믿기 전에 언제나 적합도를 확인하라(예: 카이제곱 검정, QQ 그림).
AI로 보는 통계학 1. 자료가 모형을 앞지르는 지점
위 경고 상자가 조건을 달았다 — 「모형이 올바르게 설정되었을 때」. 그러면 모형이 조금 틀렸을 때는 어떻게 되는가. 승부가 사라지는 것이 아니라 표본크기에 달리게 된다.
참분포를 평균이 같은(\(4.5\)) 음이항으로 바꾸어 보자. 포아송이 틀리는 지점은 딱 하나, 분산을 평균과 같게 강제한다는 것이다. 여기서는 참분포의 분산/평균을 \(1.5\) 로 두었다. 모수적 적합은 여전히 \(\hat\lambda = \bar x\) 이고, 재는 것은 참 PMF 까지의 RMSE 다.
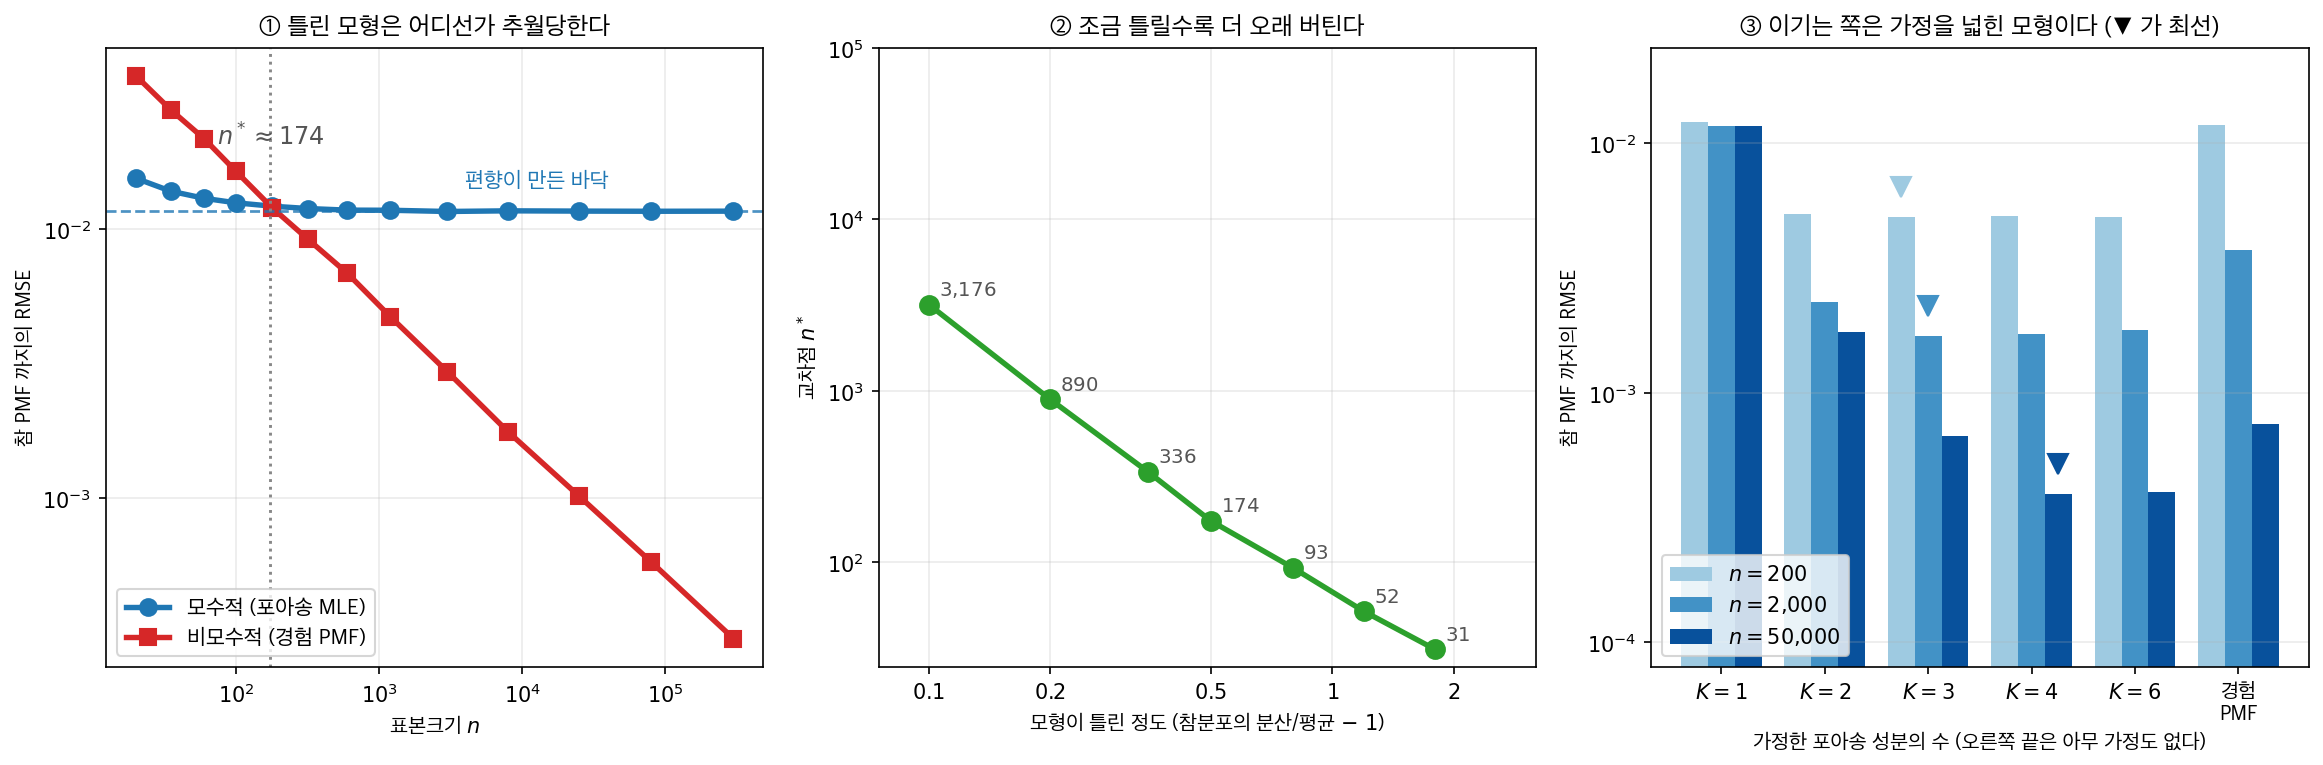
① 바닥이 있는 쪽과 없는 쪽. 경험 PMF 의 오차는 \(1/\sqrt n\) 으로 끝없이 내려간다. 모수적 쪽은 내려가다 멈춘다 — 분산이 \(0\) 이 되어도 편향이 남기 때문이다.
| \(n\) | 모수적 | 경험 PMF | 모수적이 이긴 비율 |
|---|---|---|---|
| \(20\) | \(0.01541\) | \(0.03700\) | \(99.5\%\) |
| \(100\) | \(0.01249\) | \(0.01636\) | \(78.7\%\) |
| \(180\) | \(0.01213\) | \(0.01195\) | \(44.3\%\) |
| \(1{,}200\) | \(0.01172\) | \(0.00472\) | \(0\%\) |
| \(300{,}000\) | \(0.01163\) | \(0.00030\) | \(0\%\) |
\(n^{*} \approx 174\) 에서 뒤집힌다. 이 쪽이 승부를 가른 \(n = 200\) 은 교차점 바로 너머다 — 분산/평균이 \(1\) 에서 \(1.5\) 로 어긋나는 것만으로 보기 2 의 판정이 반대가 된다.
② 얼마나 틀렸느냐가 그 지점을 정한다. 불일치를 키우며 교차점을 다시 재면
| 분산/평균 | \(1.1\) | \(1.35\) | \(1.5\) | \(2.2\) | \(2.8\) |
|---|---|---|---|---|---|
| 편향 바닥 | \(0.00279\) | \(0.00866\) | \(0.01163\) | \(0.02218\) | \(0.02881\) |
| 교차점 \(n^{*}\) | \(3{,}176\) | \(336\) | \(174\) | \(52\) | \(31\) |
| \(n^{*} \times\) 편향\(^2\) | \(0.0248\) | \(0.0252\) | \(0.0236\) | \(0.0254\) | \(0.0258\) |
마지막 줄이 요점이다. 편향이 \(10.3\) 배로 벌어지는 동안 \(n^{*} \times\) 편향\(^2\) 은 \(0.024\) 언저리에 그대로 있다. 편향은 줄지 않고 분산은 \(1/n\) 로 주니 둘이 맞서는 자리가 \(n \propto \text{편향}^{-2}\) 인 것이고, 이것이 가정 하나를 버릴 권리를 자료 얼마로 사는지를 적어 놓은 식이다. 불일치를 절반으로 줄이면 버티는 표본은 네 배가 된다.
③ 그런데 이기는 쪽은 가정을 버린 쪽이 아니다. 여기까지만 보면 「자료가 많으면 모형을 버려라」로 읽기 쉽다. 포아송 성분 \(K\) 개의 혼합을 EM 으로 맞춰 같이 재 보면 그렇지 않다.
| \(K=1\) | \(K=2\) | \(K=3\) | \(K=4\) | 경험 PMF | |
|---|---|---|---|---|---|
| \(n = 200\) | \(0.01210\) | \(0.00516\) | \(\mathbf{0.00502}\) | \(0.00507\) | \(0.01174\) |
| \(n = 2{,}000\) | \(0.01167\) | \(0.00230\) | \(\mathbf{0.00168}\) | \(0.00172\) | \(0.00373\) |
| \(n = 50{,}000\) | \(0.01164\) | \(0.00174\) | \(0.00067\) | \(\mathbf{0.00039}\) | \(0.00075\) |
경험 PMF 는 세 줄 어디에서도 최선이 아니다. \(n = 200\) 에서 이미 성분 둘짜리 혼합이 경험 PMF 의 절반 이하이고, \(n = 50{,}000\) 에서는 최선의 \(K\) 가 \(4\) 로 올라가며 격차가 두 배가 된다. 까닭은 \(\S 3\) 이 적은 그대로다 — 경험 PMF 는 상자 \(31\) 개를 따로따로 세지만 \(K = 4\) 혼합은 수 일곱 개로 모든 \(k\) 에 걸쳐 힘을 빌려 온다.
그래서 세 판이 함께 말하는 것. ①②는 고정된 틀린 모형이 언제 추월당하는지를 말하고, ③은 추월하는 것이 모형 없음이 아니라 더 넓은 모형족임을 말한다. 리치 서튼이 \(2019\) 년에 「쓰라린 교훈」에서 적은 것도 그 구별이다 — \(70\) 년의 인공지능 연구에서 이긴 것은 「계산을 받아먹는 일반적인 방법」이었고, 사람의 지식을 집어넣는 길이 진 까닭은 그 지식이 틀려서가 아니라 「방법을 복잡하게 만들어 계산을 받아먹기 어렵게」 했기 때문이라는 것이다. 심층신경망은 가정이 없는 모형이 아니라 자료를 더 먹을수록 더 넓어질 수 있게 만든 모형족이다.
②의 식은 그 교훈의 척도다. 자료가 열 배가 되면 편향이 \(\sqrt{10}\) 분의 \(1\) 인 모형까지 감당할 수 있게 된다 — 자료가 늘었다는 것은 가정을 덜 해도 된다는 뜻이고, 덜 할 수 있는 만큼이 정확히 저만큼이다.
확인한 곳 — 리치 서튼의 「The Bitter Lesson」(\(2019\) 년 \(3\) 월 \(13\) 일, incompleteideas.net)을 직접 읽었다 — 「\(70\) 년의 인공지능 연구에서 읽어 낼 수 있는 가장 큰 교훈은 계산을 받아먹는 일반적인 방법이 끝내 가장 효과적이며 그것도 큰 차이로 그렇다는 것이다」와 「사람의 지식을 쓰는 접근은 방법을 복잡하게 만들어 계산을 받아먹는 일반적인 방법에 덜 어울리게 하는 경향이 있다」가 글머리 문단에 그대로 있다. 글의 날짜와 지은이도 그 쪽에서 읽었다 · 표와 그림의 수는 모두 직접 모의실험한 값이다
연습문제
연습문제 1. 포아송의 MLE에서 \(\hat{\lambda} = \bar{x}\)가 정류점일 뿐 아니라 전역 최댓값임을 2계도함수 조건으로 확인하라.
풀이
로그가능도는 이렇게 된다.
여기서 \(C\)는 \(\lambda\)에 의존하지 않는다. 1계도함수는 이렇게 된다.
0으로 두면 \(\hat{\lambda} = \bar{x}\)이다.
2계도함수는 이렇게 된다.
\(\sum x_i \geq 0\)이고 \(\lambda > 0\)이므로 모든 \(\lambda > 0\)에서 \(d^2\ell/d\lambda^2 \leq 0\)이다. \(\sum x_i > 0\)이면 부등호가 엄격하므로 \(\hat{\lambda} = \bar{x}\)가 전역 최댓값임이 확인된다. (모든 관측값이 0이면 \(\hat{\lambda} = 0\)이며 이는 경계에서의 최댓값이다.) \(\square\)
연습문제 2. 포아송분포에서 i.i.d.로 \(n = 500\)개를 관측했고 표본평균이 \(\bar{x} = 3.2\)이다. 피셔 정보량을 사용하여 \(\lambda\)에 대한 근사적인 95% 신뢰구간을 구성하라.
풀이
포아송 관측값 하나에 대한 피셔 정보량은 이렇게 된다.
\(n\)개 관측값에서 전체 피셔 정보량은 \(nI(\lambda) = n/\lambda\)이다. MLE의 점근정규성에 의해 이렇게 된다.
\(\hat{\lambda} = 3.2\), \(n = 500\)을 대입하면 이렇게 된다.
95% 신뢰구간은 이렇게 된다.
\(\square\)
연습문제 3. 모형이 올바르게 설정되었을 때 비모수적 (경험 PMF) 추정량이 불편인데도 모수적 MLE보다 시험자료의 RMSE가 큰 이유를 설명하라. 편향–분산 트레이드오프(trade-off)은 어떤 역할을 하는가?
풀이
경험 PMF는 각 확률 \(P(X = k)\)를 비율 \(\hat{p}_k = n_k / n\)으로 따로따로 추정한다. 각 \(\hat{p}_k\)는 불편이고 분산은 이렇게 된다.
모수적 MLE는 모수 하나(\(p\)나 \(\lambda\))를 추정하고 그로부터 PMF 전체를 유도한다. \(P(X = k)\)의 모수적 추정량은 (비선형 대입 때문에) 유한표본에서 편향되지만, 각 \(k\)마다 하나씩이 아니라 자유도 하나만 추정하므로 분산이 훨씬 작다.
전체 평균제곱오차(mean squared error)는 다음과 같이 분해된다.
비모수적 추정량은 편향이 0이지만 (특히 \(n_k\)가 작은 꼬리에서) 분산이 크다. 모수적 MLE는 설정이 올바르면 편향이 무시할 만하고, 함수 형태가 PMF의 모양을 제약하므로 분산이 작다. 모수적 모형이 유리한 편향–분산 트레이드오프를 달성하여 시험자료에서 RMSE가 더 작아진다.
모형이 잘못 설정되면 모수적 추정량에 사라지지 않는 편향이 생기고, 그때는 비모수적 추정량이 이길 수 있다. \(\square\)
연습문제 4. 같은 계수 자료에 기하분포와 포아송분포를 모두 적합했다. 어느 쪽이 나은지 판단하는 방법을 세 가지 들고, 각각의 장단점을 적어라.
풀이
두 분포는 내포 관계가 아니므로(한쪽이 다른 쪽의 특수한 경우가 아니므로) 가능도비(likelihood ratio) 검정을 그대로 쓸 수 없다. 다음 세 가지가 표준적인 방법이다.
(1) 정보기준 비교. 모수 개수가 둘 다 1개이므로 벌점이 같고, 결국 최대 로그가능도를 직접 비교하면 된다.
- 장점: 간단하고 내포 관계가 필요 없다.
- 단점: 차이가 얼마나 커야 의미 있는지에 대한 기준이 없다. 관례적으로 AIC 차이가 2 이상이면 주목할 만하다고 본다.
(2) 적합도 검정(goodness-of-fit test). 관측 도수와 각 모형의 기대 도수를 카이제곱으로 비교한다.
- 장점: 어느 구간에서 어긋나는지 잔차로 볼 수 있다. 두 모형 모두 나쁠 가능성도 잡아낸다.
- 단점: 기대도수가 5 미만인 범주를 합쳐야 하고, 그 방식에 따라 결과가 달라진다.
(3) 평균–분산 관계 진단. 포아송은 분산 = 평균, 기하분포(실패 횟수 판본)는 분산 \(= \frac{1-p}{p^2}\), 평균 \(=\frac{1-p}{p}\)이므로
이다. 표본에서 \(s^2/\bar x\)를 계산해 1에 가까우면 포아송, 1보다 뚜렷이 크면 기하 쪽을 의심한다.
- 장점: 계산이 즉시 되고 해석이 직관적이다. 적합 전에 먼저 해 볼 수 있다.
- 단점: 이 비가 크다고 기하분포인 것은 아니다. 음이항이나 영과잉일 수도 있다.
권고. 셋을 함께 쓴다. 진단으로 방향을 잡고, 정보기준으로 고르고, 적합도 검정과 잔차로 고른 모형이 실제로 맞는지 확인한다. 두 모형 중 나은 쪽을 고르는 것과 그 모형이 자료에 맞는 것은 다른 문제다.
연습문제 5. 포아송 모형을 적합했는데 표본분산이 표본평균의 세 배였다. 이를 무시하고 포아송 MLE의 표준오차를 그대로 쓰면 어떤 결과가 생기는가? 정량적으로 답하라.
풀이
참 분산. 실제 자료의 분산이 \(3\lambda\)라면
이다.
포아송 가정이 주는 값. 포아송에서는 분산 = 평균이라고 보므로
으로 참값의 3분의 1이다.
결과.
- 표준오차가 \(\sqrt3 = 1.73\)배 과소평가된다.
- 신뢰구간의 폭이 참으로 필요한 것의 58%에 지나지 않는다. 명목 95% 구간의 실제 포함확률이 약 74%로 떨어진다(\(2\Phi(1.96/\sqrt3)-1 = 0.742\)).
- \(z\) 통계량이 1.73배 부풀어 오른다. 참 \(z\)가 1.2인 효과가 2.08로 나와 유의해 보인다. 명목 5% 검정의 실제 제1종 오류율이 약 26%다(\(2\Phi(-1.96/\sqrt3) = 0.258\)).
고치는 법.
- 준포아송. 산포모수 \(\hat\phi = X^2/(n-p)\)를 추정해 모든 표준오차에 \(\sqrt{\hat\phi}\)를 곱한다. 계수 추정값은 그대로다. 여기서는 \(\hat\phi \approx 3\)이므로 표준오차를 1.73배 키운다.
- 음이항. 분산 \(\mu + \mu^2/k\)를 명시적으로 모형화한다. 준포아송이 분산을 \(\phi\mu\)(평균에 비례)로 두는 것과 달리 음이항은 이차 관계를 가정하므로, 어느 쪽이 자료에 맞는지 잔차로 확인해야 한다.
- 로버스트 표준오차. 샌드위치 추정량을 쓴다. 분산 구조를 특정하지 않아도 되지만 효율을 잃는다.
놓치기 쉬운 이유. 과대산포가 있어도 계수 추정값은 그대로 나오고 적합도 그림도 그럴듯해 보인다. 표준오차만 조용히 틀린다. 그래서 포아송 회귀를 적합하면 반드시 \(\hat\phi\)를 확인하는 것이 기본 절차다.
연습문제 6. 비모수적 경험 PMF 추정과 모수적 MLE의 차이를 편향–분산 관점에서 정리하고, 어느 쪽을 언제 써야 하는지 적어라.
풀이
경험 PMF. \(\hat p_k = n_k/n\)으로 각 값의 확률을 따로 추정한다.
- 편향: 0이다. \(E[\hat p_k] = p_k\).
- 분산: \(p_k(1-p_k)/n\)으로 값마다 독립적으로 추정하므로, 값의 개수 \(K\)가 많으면 각 추정값이 적은 관측에 기댄다. 꼬리에서는 \(n_k\)가 0이나 1이라 \(\hat p_k\)가 거의 잡음이다.
모수적 MLE. 분포족을 가정하고 모수 하나(또는 몇 개)만 추정한다.
- 편향: 모형이 틀리면 있다. 참 분포가 그 족에 없으면 아무리 \(n\)이 커도 남는다.
- 분산: 매우 작다. 모든 관측값이 한 모수를 함께 추정하는 데 쓰이므로, 꼬리의 확률도 중앙의 자료에서 얻은 정보로 채워진다.
트레이드오프.
에서 모수적 방법은 편향을 감수하고 분산을 크게 줄인다. 모형이 대략 맞으면 이 거래가 압도적으로 유리하다. 연습문제 3에서 본 대로 경험 PMF가 불편인데도 시험자료의 RMSE가 더 큰 이유가 이것이다.
고르는 기준.
| 상황 | 권장 |
|---|---|
| \(n\)이 작고 \(K\)가 큼 | 모수적 |
| 꼬리 확률을 추정해야 함 | 모수적(외삽 가능) |
| \(n\)이 아주 크고 \(K\)가 작음 | 비모수적 |
| 모형이 미덥지 않음 | 비모수적 또는 유연한 모수족 |
| 관측되지 않은 값의 확률이 필요 | 모수적(경험 PMF는 0을 준다) |
절충안도 있다. 평활을 넣은 비모수 추정(커널 평활, 라플라스 보정), 모수가 여럿인 유연한 족(음이항, 영과잉, 혼합), 모수적 추정을 비모수적으로 보정하는 준모수 방법이 그런 예다. 실무에서는 모수 모형으로 시작해 잔차로 불일치를 확인하고, 어긋난 부분만 유연하게 만드는 순서가 대체로 좋다.
정리하며
같은 계수 자료에 모수적 모형과 경험분포를 나란히 적합해 시험자료에서 견주었다.
- 모형 하나가 상자 \(K\) 개를 덮는다. 포아송 적합은 수 하나(\(\hat\lambda = \bar X\))로 모든 \(k\) 의 확률을 적고, 경험 PMF 는 상자마다 하나씩 쓴다. 그 차이가 추정 잡음을 \(p_k\) 에서 \(p_k^2\) 에 비례하게 줄이며, 그것이 「꼬리를 가운데서 빌려 온다」의 수치적 모습이다.
- 남겨 둔 시험자료에서 비교하는 것이 요점이다. 경험 확률질량함수는 훈련자료를 그대로 외우므로 훈련에서는 완벽하지만, 관측되지 않은 값에 확률 \(0\) 을 주어 새 자료에서 무너진다.
- 모형이 맞으면 모수적 적합이 일반화에서 이긴다. 분포의 모양을 가정한 덕분에 관측되지 않은 값에도 합리적인 확률을 배정한다. 이것이 모수적 모형의 본질적 이득이다.
- 모형이 틀리면 그 이득이 손해로 바뀐다. 자료가 과대산포인데 포아송을 쓰면 꼬리를 심하게 과소평가한다. 적합 뒤에 표본분산과 표본평균을 비교하는 진단이 반드시 따라야 하는 이유다.
- 1장의 편향–분산 절충이 분포 적합에서 나타난 모습이기도 하다. 모수적 모형은 편향을 들이고 분산을 줄인다.
이것으로 6.1절이 끝난다. 가능도의 개념에서 시작해 여러 분포의 최대가능도추정량을 유도하고, 점근 성질과 정보량, 수치 최적화까지 보았다.
다음 절 적률법의 기초로 넘어간다. 최대가능도보다 오래되고 계산이 간단한 또 하나의 추정 전략이다.