게임스–하월 검정 (분산이 다를 때)
개요
들어가는 이야기 — 쌍마다 다른 방향으로 틀어진다
등분산이 깨진 자료에 투키를 그대로 쓰면 쌍마다 다른 방향으로 틀어진다. 분산이 큰 쌍은 거짓 기각 쪽으로 기울고, 작은 쌍은 놓치는 쪽으로 기운다.
네 전략의 표본분산(sample variance)이 \(3.5\) 에서 \(15.0\) 까지, 곧 분산으로 네 배 넘게 흩어져 집단마다의 산포가 같은지 묻는 레빈 검정이 등분산을 \(p = 0.003\) 으로 기각한 자료다. 쌍은 여섯이다. 어떤 쌍의 차이 \(3.30\) 은 투키 임계값 \(2.695\) 를 넘어 「두 전략은 다르다」가 되지만, 같은 쌍의 게임스–하월 임계값은 \(3.495\) 여서 판단이 보류된다.
불일치의 출처는 자유도와 분모다. 투키는 여섯 비교 전부에 합동분산(pooled variance) 하나와 자유도 \(49\) 를 쓰고, 게임스–하월은 쌍마다 그 두 집단의 분산만으로 표준오차를 만들고 자유도는 웰치–새터스웨이트 식으로 다시 센다. 그래서 분산이 큰 두 집단을 견줄 때 합동은 평균짜리 분산을 주어 분모를 작게 잡고 임계값을 낮춘다 — 이 쌍에서 \(2.695\) 와 \(3.495\) 의 차이가 그 몫이다. 반대로 분산이 작은 두 집단에서는 합동이 분모를 크게 잡아 잡아낼 수 있었던 차이를 놓친다.
그러니 「등분산이 깨졌으니 투키는 보수적일 것」이라는 어림짐작은 절반만 맞다. 그래서 등분산을 설계가 보장하지 않으면 처음부터 쌍별로 분산을 세는 쪽이 기본값이 된다 — 레빈을 돌려 보고 고르는 것이 아니다. 본페로니 보정 쌍별 웰치와 견주면 어느 쪽이 더 보수적인지도 수로 나온다. 합동분산 하나로 여섯 쌍을 모두 재면 어느 쌍이 과대평가되고 어느 쌍이 과소평가되는가.
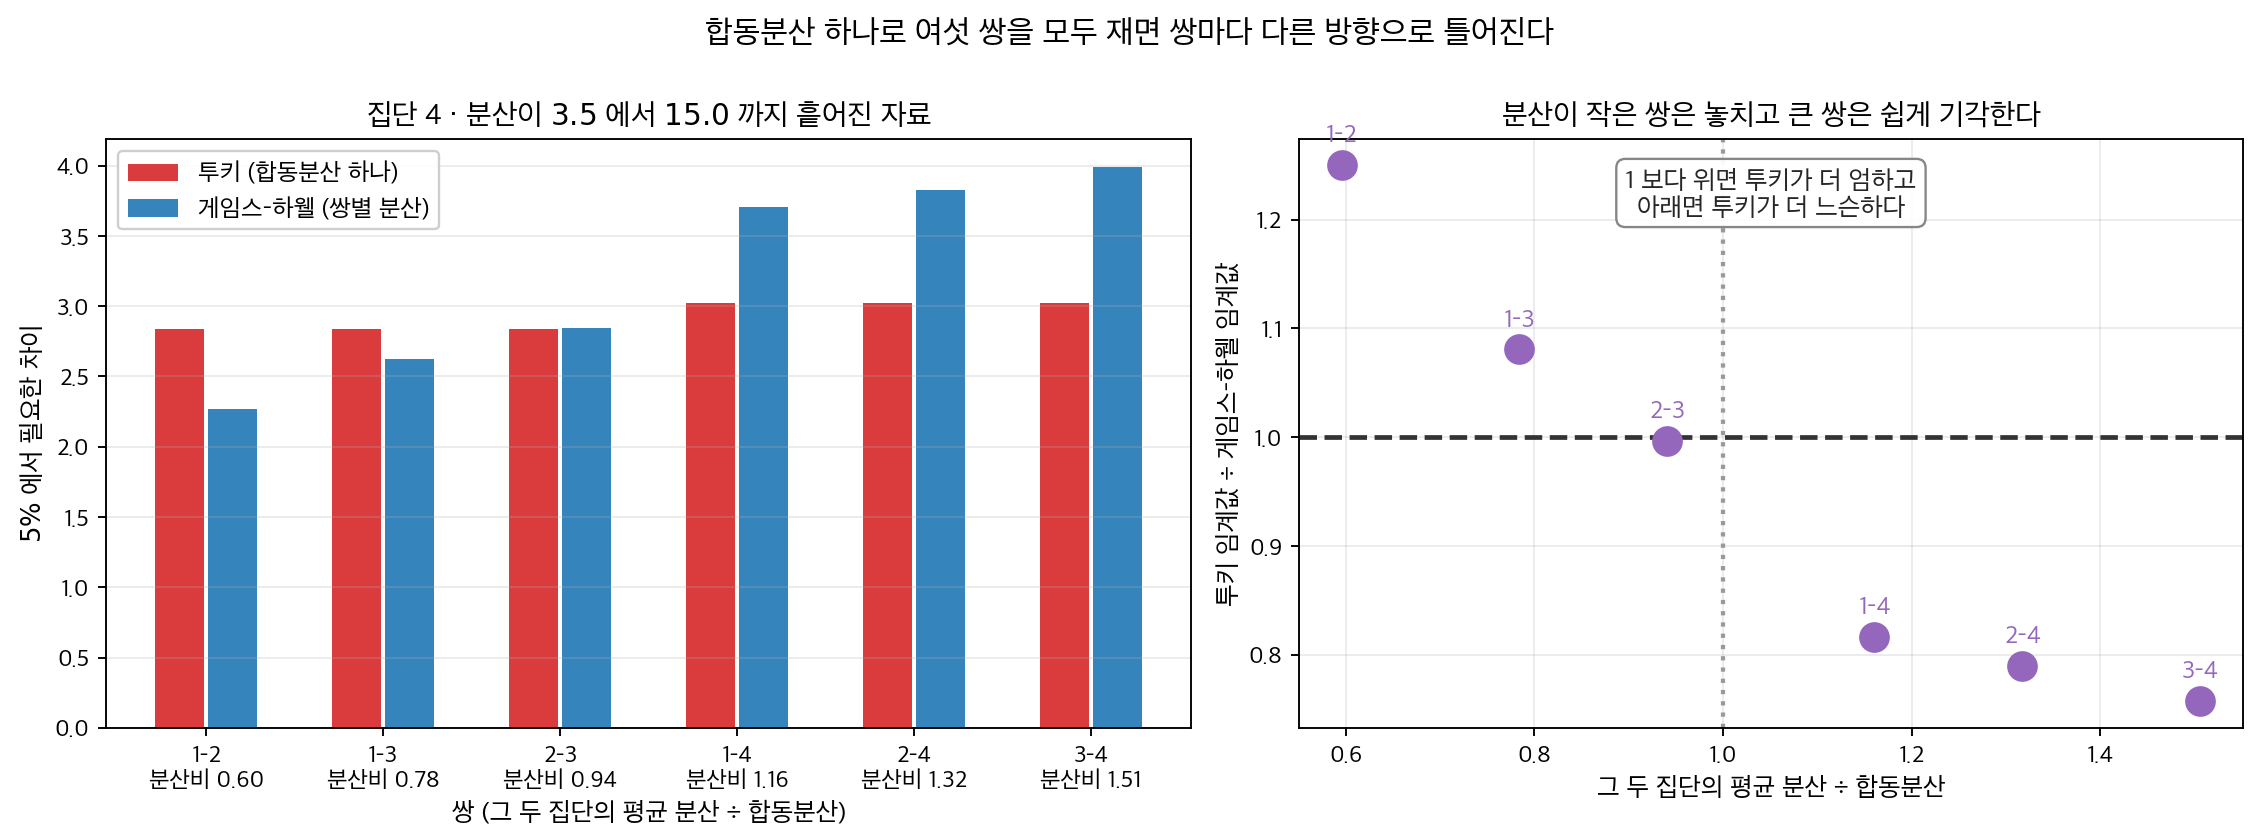
분산이 \(3.5\) 에서 \(15.0\) 까지 흩어진 네 집단에서 여섯 쌍을 모두 재었다. 왼쪽. 투키는 여섯 쌍 전부에 합동분산 하나를 쓰므로 임계값이 거의 같은데, 게임스–하월은 쌍마다 그 두 집단의 분산만 쓰므로 \(2.27\) 에서 \(3.99\) 까지 벌어진다. 오른쪽. 두 임계값의 비가 \(1\) 을 가로지른다. 그 쌍의 평균 분산이 합동분산보다 작으면 투키가 더 엄해 잡아낼 수 있었던 차이를 놓치고, 크면 투키가 더 느슨해 쉽게 기각한다. 「등분산이 깨졌으니 투키는 보수적일 것」이라는 어림짐작이 절반만 맞는 까닭이 그것이다.
아래 상자가 그 방법을 내놓은 저자들이 초록 끝에 달아 둔 단서를 따라간다.
확인한 곳 — 이 쪽 「저자들이 초록 끝에 달아 둔 단서」 상자와 그 출처 줄
투키의 HSD나 본페로니 같은 사후 방법은 모든 집단의 모분산이 같다고 가정한다. 표준 분산분석(analysis of variance) F-검정의 바탕에 있는 등분산성(homoscedasticity) 가정과 같다. 이 가정이 어긋나면 이런 방법들이 오도하는 결과를 낼 수 있다. 작은 집단의 분산이 크면 제1종 오류율이 부풀려지고, 반대의 경우에는 검정력이 떨어진다. 게임스–하월 절차(Games and Howell, 1976)는 각 쌍별 비교마다 분산을 따로 추정하고 웰치–새터스웨이트 근사로 자유도를 조정하여 이 문제를 해결한다. 등분산도 동일 표본크기도 가정하지 않으므로 웰치 분산분석 뒤의 기본 사후검정(post hoc test)이 된다.
1. 물음과 통계량 — 쌍마다 그 두 집단의 분산만 쓴다
각 집단 쌍 \(i\) 와 \(j\)(\(1 \leq i < j \leq k\))에 대해 묻는 것은 투키와 같다.
다른 것은 그 물음을 재는 자다. 투키는 모든 쌍에 합동분산 하나를 쓰는데, 게임스–하월은 쌍마다 그 두 집단의 분산만으로 표준오차를 만든다.
여기서 \(\bar{Y}_{i\cdot}\) 와 \(\bar{Y}_{j\cdot}\) 는 표본평균(sample mean), \(s_i^2\) 와 \(s_j^2\) 는 표본분산, \(n_i\) 와 \(n_j\) 는 표본크기다. 이것은 이표본 웰치 \(t\) 통계량 그대로다. 게임스–하월은 그것을 \(\binom{k}{2}\) 개의 모든 쌍에 돌리면서 가족단위 오류율을 함께 지킨다.
합동분산을 버리면 자유도도 쌍마다 달라진다. 분모가 두 분산의 가중합이므로 그 분포가 깔끔한 카이제곱이 아니고, 웰치–새터스웨이트 근사로 자유도를 맞춘다.
결과는 보통 정수가 아니다. 임계값을 찾을 때 그대로 쓰거나 내림해서 쓴다.
왜 투키의 정리를 그대로 쓸 수 없는가
이 쪽이 있는 까닭은 투키의 보장이 깨지기 때문이다. 어디서 깨지는지를 적어 둔다.
정리 1. 분산이 다르면 스튜던트화 범위가 축이 되지 못한다
10.3절 투키 정직유의차 정리 1 은 중심을 옮긴 \(D_i = \bar Y_{i\cdot} - \mu_i\) 가 모두 같은 분포 \(N(0,\ \sigma^2/n)\) 을 따른다는 데 기댄다. 집단분산이 \(\sigma_i^2\) 로 서로 다르면 \(D_i \sim N(0,\ \sigma_i^2/n_i)\) 가 되어
의 분포가 \((\sigma_1^2,\dots,\sigma_k^2)\) 에 남아 의존한다. 곧 축이 되는 양이 아니고, \(q_{\alpha,k,\nu}\) 라는 표 하나로는 어떤 \(\alpha\) 도 보장하지 못한다.
증명
분산이 같을 때 \(\sigma\) 가 약분된 것은 분자와 분모가 같은 \(\sigma\) 에 비례했기 때문이다. 분산이 다르면 \(D_i = (\sigma_i/\sqrt{n_i})Z_i\) 로 적을 수 있고(\(Z_i\) 는 표준정규) 분자는
가 되어 \(\sigma_i/\sqrt{n_i}\) 들의 비에 의존한다. 그런데 분모의 \(\text{MS}_W\) 는 그것들을 하나로 뭉쳐 가중평균 \(\sum_i (n_i-1)\sigma_i^2 / \sum_i (n_i-1)\) 을 추정할 뿐이라, 분자가 의존하는 비를 되살려 주지 못한다. 두 쪽이 같은 수로 비례하지 않으므로 약분이 일어나지 않는다. \(\square\)
그래서 게임스–하월은 정확한 정리를 갖지 않는다. 쌍마다 그 두 집단의 분산만 쓰는 웰치 표준오차와 웰치–새터스웨이트 자유도를 넣고, 임계값만 \(q_{\alpha,k,\nu_{ij}}/\sqrt2\) 에서 빌려 온다. 빌려 온 자리의 보장은 근사이고, 그 근사가 얼마나 잘 듣는지는 재어 보는 수밖에 없다 — \(3\) 절과 \(4\) 절이 그 일을 한다.
투키처럼 등식으로 끝나지 않는다는 것이 약점처럼 보이지만, 비교 대상은 「정확한 다른 방법」이 아니라 가정이 깨진 자리에 그대로 쓴 투키다. 그쪽은 근사조차 아니고 틀린다.
2. 검정 — 쌍마다 다른 임계값을 넘는지 본다
게임스–하월 검정은 \(|t_{ij}|\)를 스튜던트화 범위(studentized range) 분포의 임계값과 비교한다.
이면 \(H_0: \mu_i = \mu_j\)을 기각한다. 여기서 \(q_{\alpha, k, \nu_{ij}}\)는 집단 \(k\)개, 자유도 \(\nu_{ij}\)인 스튜던트화 범위 분포의 상위 \(\alpha\) 임계값이다. \(\sqrt{2}\)로 나누는 것은 범위 기반의 \(q\)-통계량 척도를 \(t\)-통계량 척도로 바꾸기 위해서이다.
왜 스튜던트화 범위 분포인가?
스튜던트화 범위 분포는 투키의 HSD에서와 마찬가지로 모든 쌍별 비교에 대해 FWER을 동시에 통제한다. 차이는 투키가 (합동 \(\text{MS}_W\)에서 나오는) 공통 자유도를 쓰는 반면 게임스–하월은 쌍마다 다른 자유도 \(\nu_{ij}\)를 써서 각 비교가 자신의 분산 구조를 반영하게 한다는 점이다.
보기 1. 네 가지 광고 전략. 어떤 마케팅 팀이 네 가지 광고 전략을 시험한다. 예산 제약 때문에 집단마다 표본크기와 변동이 다르다.
| 전략 | \(n_i\) | \(\bar{Y}_{i\cdot}\) | \(s_i^2\) |
|---|---|---|---|
| A (기준) | 15 | 12.0 | 4.0 |
| B (소셜 미디어) | 10 | 16.5 | 12.0 |
| C (이메일) | 20 | 13.2 | 3.5 |
| D (인플루언서) | 8 | 18.0 | 15.0 |
레빈 검정이 등분산성을 기각하므로(\(p = 0.003\)) 표준 분산분석 F-검정은 적절하지 않다. 웰치 분산분석이 유의하여(\(F_W = 6.84\), \(p = 0.002\)) 적어도 한 전략이 다름을 확인했다. 어느 쌍이 다른지 알아내기 위해 게임스–하월 검정을 적용한다.
여섯 쌍 가운데 전략 B 대 전략 A 부터 검정통계량(test statistic)과 자유도를 구하고 판정하라. 나머지 다섯 쌍도 같은 방법으로 재어 어느 쌍이 유의한지 적으라.
풀이
자유도는 이렇게 된다.
집단이 \(k = 4\)개이고 \(\nu_{BA} \approx 13\)이므로 임계값은 \(q_{0.05, 4, 13} / \sqrt{2} \approx 4.15 / 1.414 \approx 2.94\)이다.
\(|t_{BA}| = 3.72 > 2.94\)이므로 전략 B와 A의 차이는 유의하다.
비교: 전략 C 대 전략 A
\(\nu_{CA} \approx 29\)이므로 임계값은 \(q_{0.05, 4, 29} / \sqrt{2} \approx 3.85 / 1.414 \approx 2.72\)이다.
\(|t_{CA}| = 1.80 < 2.72\)이므로 전략 C와 A의 차이는 유의하지 않다.
나머지 네 비교도 같은 절차를 따른다. 각 쌍이 자신의 표준오차와 자유도를 쓰므로 이분산 자료를 적절히 다룰 수 있다.
3. 게임스–하월을 언제 쓰는가
게임스–하월 검정은 다음일 때 적절한 사후 절차이다.
- 등분산을 설계가 보장하지 않을 때(레빈을 돌려 보고 고르는 것이 아니다 — 자료를 보고 절차를 고르면 \(\alpha\) 보장이 깨진다)
- 집단 사이의 표본크기가 상당히 다를 때
- 분석이 (역시 등분산을 가정하지 않는) 웰치 분산분석에 뒤이을 때
| 조건 | 권장 사후 방법 |
|---|---|
| 등분산, 모든 쌍별 비교 | 투키의 HSD |
| 등분산, 계획된 비교 | 본페로니 |
| 등분산, 대조군과의 비교 | 더닛 검정 |
| 분산이 다름, 임의의 쌍별 비교 | 게임스–하월 |
보기 1의 네 전략을 여섯 쌍 모두로 확장해서 투키–크레이머와 나란히 놓아 보면, 합동분산을 쓰는 것과 쌍별 분산을 쓰는 것이 어떻게 갈리는지 분명해진다. 합동 \(\text{MS}_W = 6.847\)이고 자유도는 \(N - k = 49\)이다.
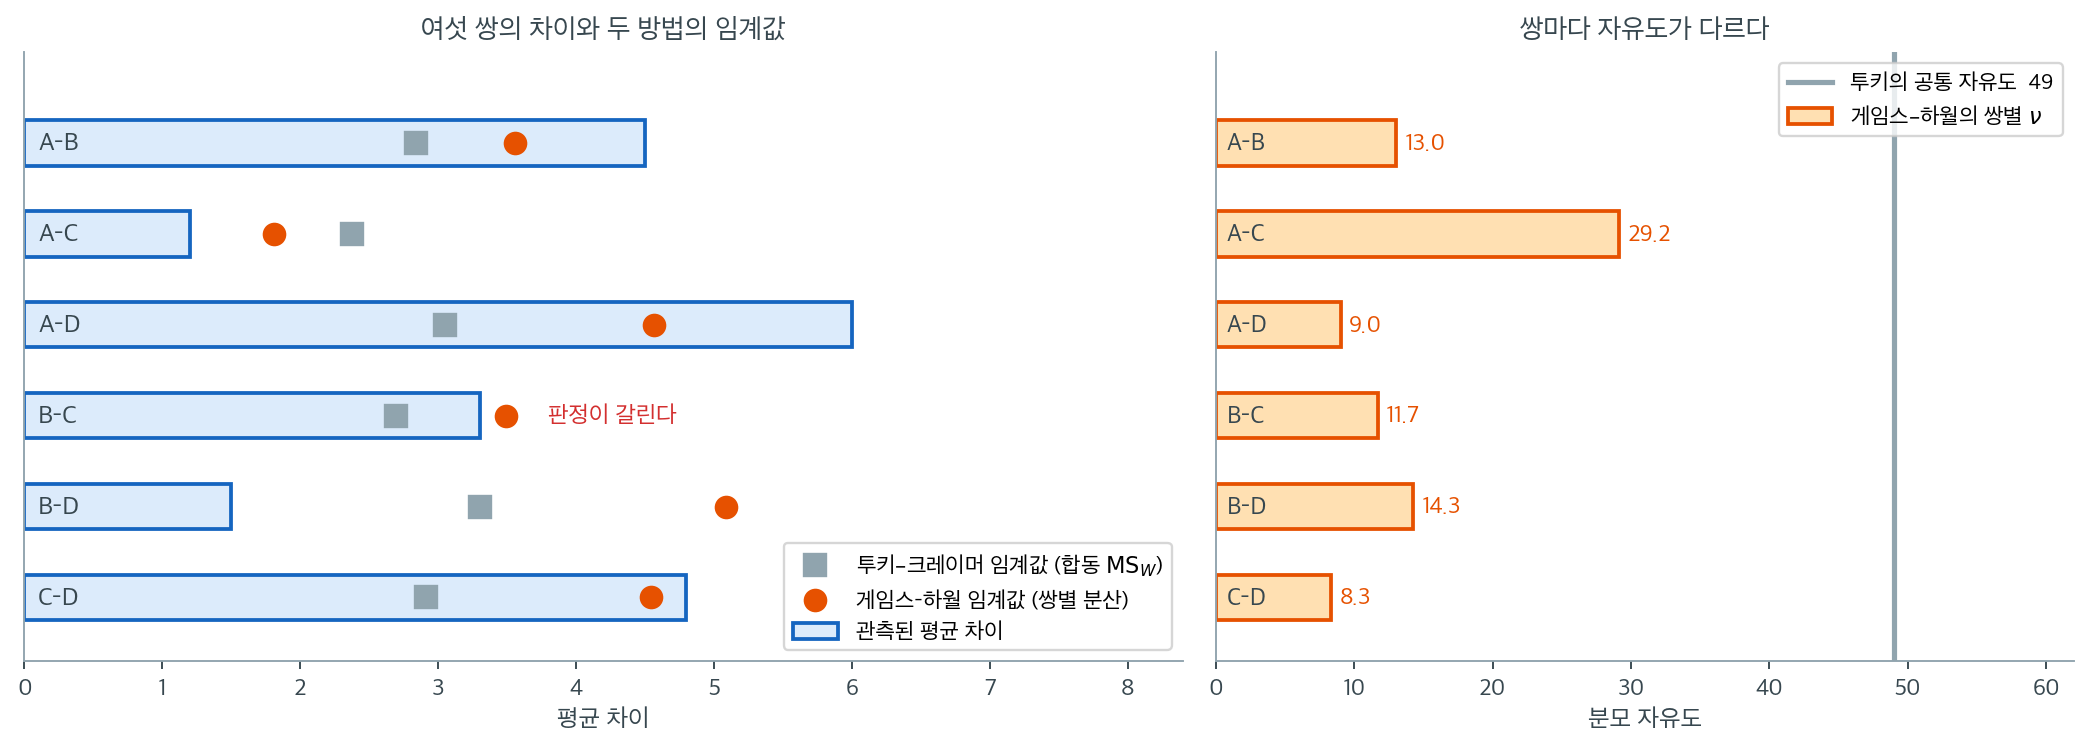
왼쪽에서 회색 사각형(투키)과 주황 원(게임스–하월)의 상대 위치가 쌍마다 뒤집힌다. A–C에서는 투키의 임계값 \(2.377\)이 게임스–하월의 \(1.810\)보다 크다. A와 C는 분산이 \(4.0\)과 \(3.5\)로 합동값 \(6.847\)보다 작은 집단들이라, 합동분산을 쓰면 이 쌍의 표준오차를 과대평가해 검정이 지나치게 보수적이 된다. 반대로 D가 끼는 쌍은 모두 주황이 오른쪽에 있다. A–D에서 \(3.047\) 대 \(4.565\), C–D에서 \(2.911\) 대 \(4.543\)이다. D의 분산이 \(15.0\)으로 합동값의 두 배가 넘는데 합동분산은 그것을 \(n_D = 8\)의 자유도만큼만 반영하므로, 표준오차를 과소평가해 검정이 관대해진다.
판정이 실제로 갈리는 쌍은 B–C다. 관측 차이 \(3.30\)이 투키 임계값 \(2.695\)는 넘지만 게임스–하월 임계값 \(3.495\)에는 못 미친다. 투키라면 "소셜 미디어와 이메일은 다르다"고 선언했을 텐데 게임스–하월은 판단을 보류한다. B의 분산이 \(12.0\)이고 표본이 \(10\)개뿐이라 그 평균이 실제로는 합동분산이 암시하는 것보다 훨씬 불안정하기 때문이다. 레빈 검정이 \(p = 0.003\)으로 등분산을 기각한 자료에서 투키를 그대로 쓰면 이런 거짓 발견이 생긴다.
오른쪽이 같은 이야기를 자유도로 옮긴 것이다. 투키는 여섯 비교 전부에 \(49\)라는 하나의 자유도를 쓰지만, 게임스–하월의 \(\nu_{ij}\)는 \(8.3\)에서 \(29.2\)까지 흩어진다. 분산이 작고 표본이 큰 A–C가 \(29.2\)로 가장 크고, 분산이 가장 큰 D가 끼는 A–D와 C–D가 \(9.0\)과 \(8.3\)으로 가장 작다. \(49\)와 \(8.3\)은 임계값을 상당히 다르게 만든다. 합동 \(\text{MS}_W\)를 쓴다는 것은 이 산포를 통째로 무시하고 모든 쌍에 같은 척도를 대는 일이며, 분산이 정말로 같을 때에만 정당한 절약이다.
표본이 작을 때의 게임스–하월
게임스–하월 검정은 웰치–새터스웨이트 근사에 의존하는데, 이 근사는 집단 표본크기가 어느 정도 될 때(\(n_i \geq 6\)) 잘 작동한다. 집단이 아주 작으면(\(n_i < 6\)) 분산 추정이 불안정해지고 \(\nu_{ij}\) 근사를 믿기 어려워진다. 이런 경우에는 크러스컬–월리스 검정 뒤에 던 검정을 쓰는 비모수적 대안을 고려하라.
4. 본페로니 보정 쌍별 웰치 와 견주기
절 \(3\) 은 게임스–하월과 투키를 견주었다. 실무에서 흔한 셋째 길이 하나 더 있다 — 쌍별 웰치 \(t\) 검정에 본페로니 보정을 거는 것이다. 이것은 투키와 두 가지가 다르다. 다중성 보정 방법도 다르고(본페로니 대 스튜던트화 범위) 분산을 다루는 방법도 다르다(쌍별 대 합동). 두 차이를 하나씩 떼어 본다.
보기 2. 본페로니가 투키보다 보수적인가. 이 단계는 투키와 두 가지가 다르다. 다중성 보정 방법도 다르고(본페로니 대 스튜던트화 범위), 분산을 다루는 방법도 다르다(쌍별 웰치 대 합동 \(MSW\)).
(1) 본페로니 보정이 FWER 을 \(\alpha\) 이하로 지킴을 합집합 한계로 보이시오. 또 합동분산을 쓰는 두 방법의 임계값을 같은 자에 올리면 그 비가
임을 보이고, \(k = 3\), \(m = 3\), \(\nu = 27\) 에서 이 값을 구하시오.
(2) 두 차이를 하나씩 떼어 내시오. 곧 합동분산 \(t\)-검정에 본페로니를 걸어 투키와 견주고, 다시 웰치와 견주시오. 어느 쌍에서 웰치가 오히려 더 작은 \(p\) 값을 주는가. 그 까닭은 무엇인가.
풀이
(1) 해석적으로. 비교가 \(m\) 개이고 각각의 귀무가설(null hypothesis)을 \(H_{0}^{(1)},\dots,H_{0}^{(m)}\) 이라 하자. 모두 참일 때 \(i\) 번째를 수준 \(\alpha/m\) 에서 기각할 확률은 \(\alpha/m\) 이하다. 합집합 한계로
이다. 검정통계량들이 서로 어떻게 얽혀 있든 성립한다는 것이 이 한계의 장점이자 보수성의 출처다. 실제로 쌍별 비교는 같은 집단평균을 공유하므로 강하게 상관되어 있고, 그만큼 합집합 한계가 느슨해진다. 수준 \(\alpha/m\) 으로 검정하는 것과 \(p\) 값에 \(m\) 을 곱해 \(\alpha\) 와 견주는 것은 같은 일이다.
임계값의 비. 합동분산을 쓰면 본페로니는
일 때 기각하고, 투키는 \(q_{\alpha,k,\nu}\sqrt{MSW/n}\) 을 넘을 때 기각한다. \(\sqrt{MSW/n}\) 이 약분되어
가 남는다. \(MSW\) 와 \(n\) 에 의존하지 않는 순수한 분위수(quantile)의 비다. \(k=3\) 이면 \(m=3\) 이고, 아래에서 재 보면 \(1.029\) 로 본페로니 쪽이 \(3\%\) 높다. 집단이 많아질수록 \(m = \binom k2\) 가 제곱으로 늘어 이 비가 커진다.
(2) 수치적으로.
import numpy as np
import pandas as pd
from scipy import stats

# 이 보기만 PlantGrowth 를 쓴다. 10.1 의 같은 자료다.
url = ('https://raw.githubusercontent.com/vincentarelbundock/'
       'Rdatasets/1dcc2bf5f955cc1224a3e1307256e1fe86b68dae/csv/datasets/PlantGrowth.csv')
df = pd.read_csv(url, usecols=[1, 2])

from itertools import combinations
from scipy.stats import ttest_ind
from statsmodels.stats.multitest import multipletests

groups = df['group'].unique()
p_raw, labels = [], []
for g1, g2 in combinations(groups, 2):
    x = df.loc[df['group'] == g1, 'weight'].values
    y = df.loc[df['group'] == g2, 'weight'].values
    stat, p = ttest_ind(x, y, equal_var=False)
    p_raw.append(p)
    labels.append(f"{g1} vs {g2}")

# 본페로니는 임계값을 낮추는 대신 p 값에 m을 곱해 돌려준다.
# 그래서 보정 후에도 비교 대상은 여전히 alpha다.
_, p_bonf, _, _ = multipletests(p_raw, alpha=0.05, method='bonferroni')
for lbl, p, pb in zip(labels, p_raw, p_bonf):
    print(f"{lbl:<12}  p = {p:.4f}   p_bonf = {pb:.4f}")
출력:
ctrl vs trt1  p = 0.2504   p_bonf = 0.7511
ctrl vs trt2  p = 0.0479   p_bonf = 0.1437
trt1 vs trt2  p = 0.0093   p_bonf = 0.0279
투키와 결론은 같지만(trt1 대 trt2만 유의) 보정 p 값은 0.0279로 투키의 0.012보다 크다. 본페로니가 더 보수적이기 때문이다.
ctrl 대 trt2를 보라. 보정 전 \(p = 0.0479\)로 유의했던 것이 보정 후 0.1437이 된다. 비교를 세 번 한다는 사실이 이만큼의 대가를 요구한다.
이제 두 차이를 하나씩 떼어 본다.
MSW, n, k, nu, m = 0.388596, 10, 3, 27, 3

# 본페로니와 Tukey 의 임계값을 같은 자에 올려 견준다 (둘 다 합동분산 기준).
t_b = stats.t.ppf(1 - 0.05 / (2 * m), nu)
thr_bonf = t_b * np.sqrt(2 * MSW / n)
q_crit = stats.studentized_range.ppf(0.95, k, nu)
thr_tukey = q_crit * np.sqrt(MSW / n)
print(f"본페로니 임계값 = {t_b:.4f} * {np.sqrt(2 * MSW / n):.4f} = {thr_bonf:.4f}")
print(f"Tukey  임계값   = {q_crit:.4f} * {np.sqrt(MSW / n):.4f} = {thr_tukey:.4f}")
print(f"비 = {thr_bonf / thr_tukey:.5f}   (= sqrt(2) t / q = {np.sqrt(2) * t_b / q_crit:.5f})")

# 합동분산 t 로 본페로니를 다시 하면 Welch 와 얼마나 다른가.
print(f"\n{'pair':<14}{'Welch p':>10}{'Welch bonf':>12}"
      f"{'pooled p':>10}{'pooled bonf':>13}{'Tukey adj':>11}")
means = df.groupby('group')['weight'].mean()
for g1, g2 in combinations(['ctrl', 'trt1', 'trt2'], 2):
    x = df.loc[df['group'] == g1, 'weight'].values
    y = df.loc[df['group'] == g2, 'weight'].values
    p_w = stats.ttest_ind(x, y, equal_var=False).pvalue
    d = means[g2] - means[g1]
    t_pool = d / np.sqrt(2 * MSW / n)
    p_pool = 2 * stats.t.sf(abs(t_pool), nu)
    p_tuk = stats.studentized_range.sf(abs(d) / np.sqrt(MSW / n), k, nu)
    print(f"{g1 + ' vs ' + g2:<14}{p_w:>10.4f}{min(m * p_w, 1):>12.4f}"
          f"{p_pool:>10.4f}{min(m * p_pool, 1):>13.4f}{p_tuk:>11.4f}")
출력:
본페로니 임계값 = 2.5525 * 0.2788 = 0.7116
Tukey  임계값   = 3.5064 * 0.1971 = 0.6912
비 = 1.02946   (= sqrt(2) t / q = 1.02946)

pair             Welch p  Welch bonf  pooled p  pooled bonf  Tukey adj
ctrl vs trt1      0.2504      0.7511    0.1944       0.5832     0.3909
ctrl vs trt2      0.0479      0.1437    0.0877       0.2630     0.1980
trt1 vs trt2      0.0093      0.0279    0.0045       0.0134     0.0120
(1)의 비가 맞는다. 두 임계값의 비 \(1.02946\) 이 \(\sqrt2\,t/q\) 와 다섯 자리까지 같다. 분산을 같은 방식으로 다루면 본페로니가 투키보다 정확히 \(2.9\%\) 보수적이고, pooled bonf 열의 \(0.0134\) 가 Tukey adj 의 \(0.0120\) 보다 큰 것이 그 결과다. 세 집단에서는 차이가 이 정도로 작다.
그런데 표의 Welch bonf 는 더 큰 \(0.0279\) 다. 다중성 보정 탓이 아니다. 같은 본페로니인데도 웰치가 \(0.0279\), 합동이 \(0.0134\) 이므로, 차이는 분산을 다루는 방식에서 왔다. 웰치는 두 집단의 자료만으로 표준오차를 만들어 자유도가 \(14\) 언저리로 줄고 임계값이 높아진다. 셋째 집단이 주는 정보를 버린 값이다.
그러나 ctrl 대 trt2 에서는 방향이 뒤집힌다. 웰치가 \(p = 0.0479\) 로 합동의 \(0.0877\) 보다 작다. 까닭은 집단별 표준편차에 있다. ctrl 과 trt2 는 \(0.583\) 과 \(0.443\) 으로 작은데, 합동 \(MSW\) 에는 표준편차 \(0.794\) 인 trt1 이 함께 들어가 있어 \(\sqrt{MSW} = 0.623\) 으로 부풀려진다. 비교에 끼지도 않은 집단이 표준오차를 키운 것이다. 자유도를 벌어 오는 대가가 이것이고, 등분산이 깨지면 손해가 이득을 넘어설 수 있다.
정리하면 이 자료에서 세 절차의 결론은 모두 같다(trt1 대 trt2 만 유의). 다만 이유가 겹겹이다. 방법을 바꿀 때는 무엇이 바뀌는지를 하나씩 떼어 보아야 한다. 등분산이 미덥지 않다면 보정은 본페로니로 두더라도 쌍별 검정을 웰치로 바꾸는 쪽이 옳고, 등분산이 믿을 만하다면 투키가 가장 날카롭다.
그림으로 보는 통계학 1. 저자들이 초록 끝에 달아 둔 단서
이 방법에는 사람 이름이 둘 붙어 있다. 그 둘이 무엇을 보고 이 방법을 권했는지, 그리고 무엇을 함께 적어 두었는지가 오늘날 통계 소프트웨어의 메뉴에는 남아 있지 않다.
\(1976\) 년 게임스와 하월이 『Journal of Educational Statistics』에 글을 실었다. 제목에 이미 방법론이 들어 있다 — 「표본크기와 분산이 같지 않을 때의 쌍별 다중비교(multiple comparisons) 절차 — 몬테카를로(Monte Carlo) 연구」. 정리를 증명한 것이 아니라 모의실험을 돌려 세 방법을 견준 것이고, 이 쪽의 절차는 그 결과로 추천된 것이다. 초록이 짧아서 전부 옮길 수 있다.
「\(\bar y_k - \bar y_{k'}\) 의 모든 쌍을 검정하는 세 가지 방법을 표본크기(\(n\))와 분산 조건을 바꾸어 가며 견주었다. \(n\) 이 여섯부터인 불균등 표본에서는 베렌스–피셔 통계량만이 가족단위 \(1\) 종오류율과 대비마다의 \(1\) 종오류율을 모두 만족스럽게 통제했다. \(n\) 이 셋부터인 불균등 표본에서는 이 통계량으로도 만족스러운 통제가 의심스럽다.」
마지막 문장이 단서다. 저자들은 자기 방법이 어디서부터 믿을 만한지를 함께 적었다. 그 자리를 직접 재어 보았다. 집단 넷, 평균은 모두 같고, 표준편차가 \(1,\ 1,\ 2,\ 3\) 인데 큰 분산 쪽에 작은 표본을 붙였다 — 불균등 설계에서 가장 불리한 짝이다.
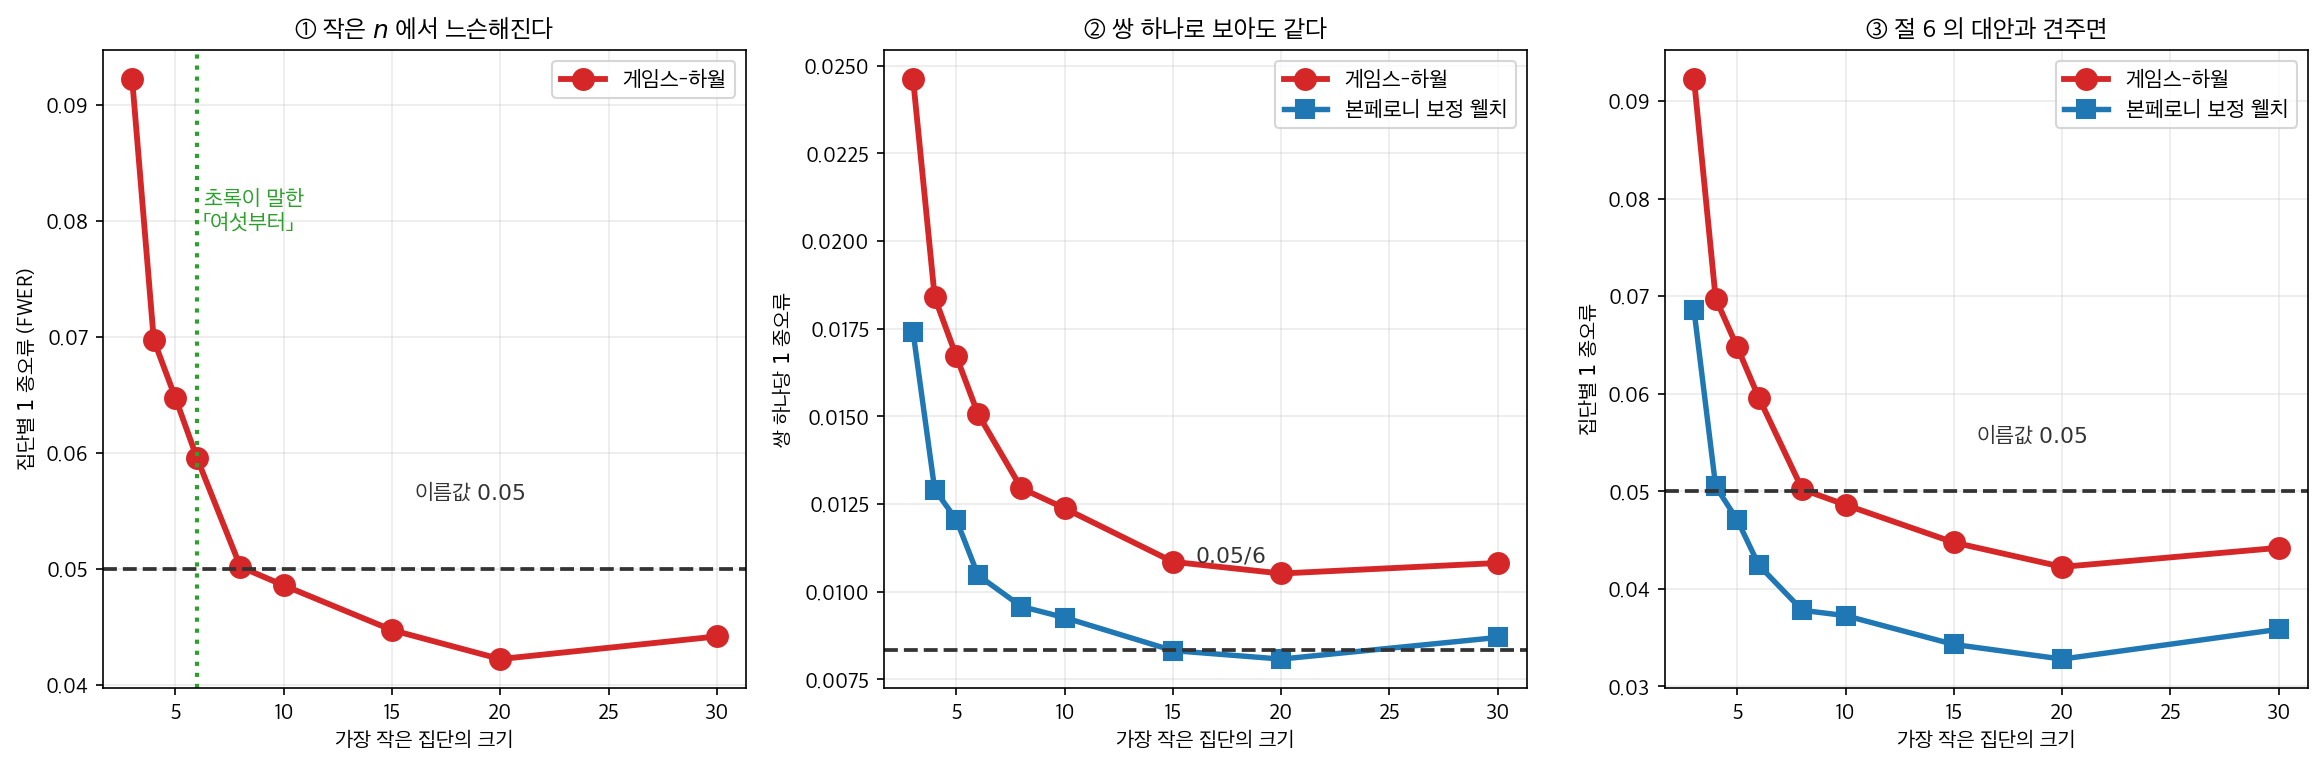
- ① 가장 작은 집단이 \(3\) 일 때 가족단위 \(1\) 종오류가 \(0.0922\) 로 이름값의 \(1.8\) 배다. \(n = 4\) 에서 \(0.0698\), \(n = 5\) 에서 \(0.0648\), \(n = 6\) 에서 \(0.0595\) 로 내려오다 \(n = 8\) 에서 \(0.0502\) 로 이름값에 닿는다. 초록이 「여섯부터」라 적은 자리가 그 사이에 있다.
- ② 대비 하나씩만 보아도 같은 모양이다. \(n = 3\) 에서 쌍별 오류가 \(0.0246\) 으로 \(0.05/6 = 0.0083\) 의 세 배다. 초록이 두 비율을 함께 적은 까닭이 이것이다 — 한쪽만 지켜지는 경우가 있어서다.
- ③ 이 절에서 견준 본페로니 보정 쌍별 웰치를 함께 그렸다. 그쪽도 \(n = 3\) 에서는 \(0.0685\) 로 이름값을 넘지만 \(n = 4\) 부터 \(0.0505\) 로 내려와 줄곧 게임스–하월보다 낮다. 작은 불균등 표본에서는 어느 쪽도 이름값을 지키지 못하고, 굳이 고른다면 보수적인 쪽이 보수적이다.
소프트웨어의 사후검정 메뉴에서 「게임스–하월」을 고르는 일에는 표본크기를 묻는 칸이 없다. 집단 하나가 셋이나 넷뿐인 자료에 이 방법을 걸면 \(0.05\) 라 적힌 값이 실제로는 \(0.09\) 다. 방법을 만든 사람들은 그것을 알고 있었고 초록 마지막 문장에 적어 두었다.
확인한 곳 — P. A. Games, J. F. Howell (\(1976\)) Pairwise Multiple Comparison Procedures with Unequal N's and/or Variances: A Monte Carlo Study, 『Journal of Educational Statistics』 \(1\) 권 \(2\) 호 \(113\)–\(125\) 쪽 (doi:10.3102/10769986001002113). 인용한 초록은 그 서지 기록에 실린 것을 그대로 옮긴 것이다. 그림과 표의 수는 모두 직접 모의실험해 계산한 값이며 그 논문의 수치가 아니다 — 논문과 모의 조건이 같지 않으므로 수를 맞대어 읽지 말 것
연습문제
연습문제 1. 어떤 마케팅 분석가가 네 가지 광고 디자인의 클릭률을 비교한다. 일원배치 분산분석(one-way analysis of variance)에서 \(F = 5.12\), \(p = 0.008\)을 얻어 적어도 한 디자인이 다름을 확인했다.
(a) 분석가는 모든 디자인을 서로 비교하고자 한다. 어떤 사후검정이 가장 적절한가? 이유를 밝혀라.
(b) 분석가의 관리자는 각 신규 디자인(B, C, D)이 현재 디자인(A)과 어떻게 다른지에만 관심이 있다. 이 경우 어떤 사후검정이 더 적절하며, (a)의 방법보다 선호되는 이유는 무엇인가?
(c) 한 동료가 집단 분산이 \(s_A^2 = 2.1\), \(s_B^2 = 8.7\), \(s_C^2 = 3.0\), \(s_D^2 = 9.2\)이고 표본크기가 \(n_A = 30\), \(n_B = 12\), \(n_C = 25\), \(n_D = 10\)이라고 지적한다. 권고가 달라지는가? 이제는 어떤 검정을 써야 하는가?
풀이
(a) 모든 쌍별 비교에는 투키의 HSD가 가장 적절하다. 가족단위 오류율(FWER)을 \(\alpha\)로 통제하면서 쌍별 비교에 특화되어 있으므로 이 목적에서는 본페로니나 셰페보다 강력하다.
(b) 각 처치를 하나의 대조군과 비교할 때에는 더닛 검정이 더 적절하다. FWER을 통제하면서 \(\binom{4}{2} = 6\)개가 아니라 \(k - 1 = 3\)개의 비교만 하므로, 이 비교 구조에서는 투키의 HSD보다 검정력이 높다.
(c) 그렇다, 권고가 달라진다. 집단 분산이 상당히 다르고(가장 큰 값이 가장 작은 값의 네 배가 넘는다) 표본크기도 서로 다르다. 이런 조건에서는 등분산이나 동일 표본크기를 가정하지 않는 게임스–하월이 적절한 사후검정이다. 각 쌍별 비교마다 분산을 따로 추정하고 웰치–새터스웨이트 자유도를 쓴다.
연습문제 2. 게임스–하월의 사용 지침을 정리하라.
풀이
한 줄 정의. 쌍마다 웰치형 표준오차와 자유도를 쓰는 투키 HSD다.
투키와 달라지는 곳은 두 군데뿐이다 — 표준오차와 자유도.
핵심 수치 다섯.
| 사실 | 값 |
|---|---|
| 역페어링에서 투키의 FWER | 0.362 |
| 같은 상황 게임스–하월 | 0.049 |
| 등분산일 때 검정력 손실(\(n=30\)) | \(-2.7\%\) |
| \(n=5\)에서의 FWER | 0.049~0.057 |
| 더닛 T3 대비 검정력 이득 | \(+1\sim9\%\) |
언제 쓰는가.
| 상황 | 판단 |
|---|---|
| 분산이 다를 가능성이 있음 | 게임스–하월 |
| 집단 크기가 불균형 | 게임스–하월 |
| 등분산이 설계로 보장 + \(n\)이 작음 | 투키 |
| 비율·계수 자료 | 게임스–하월(분산이 평균에 의존) |
| \(n\leq5\)이고 엄격한 통제 필요 | 더닛 T3 |
네 번째가 실무에서 자주 놓친다. 클릭률·불량률·사고 건수 같은 자료는 평균이 다르면 분산도 다르다. 등분산이 성립할 이유가 없다.
구현.
pingouin.pairwise_gameshowell(dv="y", between="g", data=df)
  → 차이, se, T, df, pval, hedges
  → 신뢰구간은 주지 않으므로 직접 계산 (연습문제 8)

p < 0.001 은 psturng 의 하한이므로 "0.001 미만"으로만 읽는다
파이프라인 일관성.
| 전체 | 사후 |
|---|---|
| 웰치 \(F\) | 게임스–하월 |
| 표준 \(F\) | 투키 |
섞어 쓰지 않는다.
자주 하는 실수 넷.
| 실수 | 대가 |
|---|---|
| 이분산인데 투키 | FWER 0.36 |
| 웰치 + 투키 | 가정 모순 |
| \(p\)만 보고 | 구간과 실질적 크기를 놓침 |
| \(p<0.001\)을 정확한 값으로 인용 | psturng의 절단값일 뿐 |
보고 형식.
집단별 표준편차: 1.02, 2.48, 4.13, 1.51 (분산비 16 배)
→ 등분산을 가정하지 않고 웰치 분산분석 + 게임스-하월 사용

  비교      차이    95% 동시구간     p-adj    자유도
  A vs D   +3.49   [2.06, 4.92]    <0.001   23.7
  ...
자유도 열을 함께 적는 것이 게임스–하월 보고의 특징이다. 쌍마다 다르므로 독자가 어느 비교가 덜 정밀한지 알 수 있다.
한 문장. 게임스–하월은 투키의 정확성과 웰치의 로버스트성을 결합한 절차이며, 분산이 같을 이유가 없는 자료에서는 기본값으로 삼을 만하다.
연습문제 3. 게임스–하월이 쌍마다 다른 자유도를 쓰는 이유를 설명하고, 그 값이 어떻게 정해지는지 연습문제 8 의 출력으로 확인하라.
풀이
연습문제 8 의 출력에서 자유도를 보자.
| 비교 | \(n_i,\ n_j\) | \(s_i,\ s_j\) (참값) | \(\nu_{ij}\) |
|---|---|---|---|
| A–B | 12, 15 | 1.0, 2.5 | 21.63 |
| A–C | 12, 10 | 1.0, 4.0 | 12.11 |
| A–D | 12, 14 | 1.0, 1.5 | 23.75 |
| B–C | 15, 10 | 2.5, 4.0 | 17.97 |
| B–D | 15, 14 | 2.5, 1.5 | 24.44 |
| C–D | 10, 14 | 4.0, 1.5 | 13.54 |
자유도가 12.11에서 24.44까지 두 배 차이난다. 투키라면 모든 쌍이 \(N-k=51-4=47\)을 썼을 것이다.
새터스웨이트 자유도의 성질 셋.
| 성질 | 내용 |
|---|---|
| 범위 | \(\min(n_i,n_j)-1\leq\nu_{ij}\leq n_i+n_j-2\) |
| \(a=b\)일 때 | 최댓값 \(n_i+n_j-2\) |
| 한쪽이 지배할 때 | 최솟값에 가까워짐 |
A–C가 가장 작은 12.11인 이유. \(s_C^2/n_C=16/10=1.6\)이 \(s_A^2/n_A=1/12=0.083\)을 19배 압도한다. 그래서 자유도가 사실상 C 집단만의 자유도(\(n_C-1=9\))에 가까워진다.
B–D가 가장 큰 24.44인 이유. \(6.25/15=0.417\)과 \(2.25/14=0.161\)로 비교적 균형을 이룬다. 상한 \(15+14-2=27\)에 가깝다.
왜 이것이 중요한가. 자유도가 작으면 임계값이 커진다.
| \(\nu\) | \(q_{0.05,4,\nu}\) |
|---|---|
| 12 | 약 4.20 |
| 24 | 약 3.90 |
| 47 | 약 3.77 |
A–C 비교는 자유도가 12라서 투키보다 11% 높은 임계값을 넘어야 한다. 그것이 분산 정보가 부족한 데 대한 정당한 대가다.
투키가 하지 못하는 일. 투키는 모든 쌍에 \(\nu=47\)을 쓴다. A–C 비교에서 실제로 쓸 수 있는 분산 정보는 \(n_A+n_C-2=20\)개 자유도뿐인데도 47인 척한다. 분산이 다르면 이것이 거짓 정밀도가 된다.
자유도의 계산은 언제나 데이터에 의존한다. \(s_i^2\)이 표본마다 흔들리므로 \(\nu_{ij}\)도 흔들린다. 이것이 게임스–하월이 아주 작은 표본에서 약간 불안정한 이유다(연습문제 10).
연습문제 4. 등분산일 때 게임스–하월이 잃는 검정력을 재라. 보험료가 얼마인가?
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from statsmodels.stats.libqsturng import qsturng

def gh_rej_last(gs, alpha=0.05):
    k = len(gs)
    n = np.array([len(g) for g in gs], float)
    m = np.array([g.mean() for g in gs])
    v = np.array([g.var(ddof=1) for g in gs])
    i, j = 0, k - 1
    s = v[i] / n[i] + v[j] / n[j]
    df = s**2 / (v[i]**2 / (n[i]**2 * (n[i] - 1))
                 + v[j]**2 / (n[j]**2 * (n[j] - 1)))
    return abs(m[i] - m[j]) / np.sqrt(s / 2) > qsturng(1 - alpha, k, df)

def tk_rej_last(gs, alpha=0.05):
    k = len(gs)
    n = np.array([len(g) for g in gs], float)
    m = np.array([g.mean() for g in gs])
    v = np.array([g.var(ddof=1) for g in gs])
    MSE = ((n - 1) * v).sum() / (n.sum() - k)
    qc = qsturng(1 - alpha, k, n.sum() - k)
    i, j = 0, k - 1
    return abs(m[i] - m[j]) / np.sqrt(MSE / 2 * (1 / n[i] + 1 / n[j])) > qc

rng = np.random.default_rng(12006)
B = 3_000
print("등분산(σ=1) 자료에서 G0 대 G3 비교의 검정력")
print(f"{'설계':>30s} {'투키':>8s} {'G-H':>8s} {'손실':>7s}")
for lab, n, d in [("n=10, μ=(0,0,0,1.5)", 10, 1.5),
                  ("n=20, μ=(0,0,0,1.0)", 20, 1.0),
                  ("n=30, μ=(0,0,0,0.8)", 30, 0.8)]:
    a = b = 0
    for _ in range(B):
        gs = [rng.normal(m, 1, n) for m in [0, 0, 0, d]]
        a += tk_rej_last(gs)
        b += gh_rej_last(gs)
    print(f"{lab:>30s} {a / B:8.4f} {b / B:8.4f} "
          f"{100 * (b / B - a / B) / (a / B):6.1f}%")
등분산(σ=1) 자료에서 G0 대 G3 비교의 검정력
                            설계       투키      G-H      손실
           n=10, μ=(0,0,0,1.5)   0.7337   0.6743   -8.1%
           n=20, μ=(0,0,0,1.0)   0.7010   0.6763   -3.5%
           n=30, μ=(0,0,0,0.8)   0.7070   0.6880   -2.7%
손실이 \(n\)과 함께 빠르게 줄어든다.
| \(n\) | 투키 | G-H | 손실 |
|---|---|---|---|
| 10 | 0.734 | 0.674 | \(-8.1\%\) |
| 20 | 0.701 | 0.676 | \(-3.5\%\) |
| 30 | 0.707 | 0.688 | \(-2.7\%\) |
\(n\geq20\)이면 손실이 5% 이하다.
손실의 원천 둘.
| 원천 | 내용 |
|---|---|
| 자유도 | \(n_i+n_j-2\) 대 \(N-k\) (여기서 18 대 36) |
| 분산 추정 | 두 집단의 \(s^2\)만 씀(합동 MSE는 네 집단) |
자유도가 주된 원인이다. \(n=10\), \(k=4\)면 게임스–하월의 자유도는 18, 투키는 36으로 절반이다. \(n=30\)이면 58 대 116으로 여전히 절반이지만, 둘 다 충분히 커서 임계값 차이가 작다.
비용–편익.
| 등분산일 때 | 이분산일 때 | |
|---|---|---|
| 투키 | 기준 | FWER 0.10~0.36 |
| 게임스–하월 | \(-3\%\sim-8\%\) | FWER 0.05 유지 |
보험료가 검정력 몇 퍼센트, 보험금이 오류율 일곱 배다. 웰치 대 표준 \(F\)와 정확히 같은 거래다.
\(n\)이 아주 작으면 어떻게 하나. \(n\leq6\)이면 손실이 10%를 넘을 수 있다. 그러나 그런 표본에서는 등분산 여부를 판단할 수도 없다. 게임스–하월의 크기가 여전히 정확하므로(연습문제 10) 그대로 쓰는 것이 안전하다.
연습문제 5. 게임스–하월의 신뢰구간을 구하고 해석하라. 투키의 구간과 무엇이 다른가?
풀이
구간의 형태.
연습문제 8의 출력에서 구간을 읽어 보자.
| 비교 | 차이 | 95% 구간 | 폭 | \(\nu\) |
|---|---|---|---|---|
| A–B | \(+1.65\) | \([-0.22,\ 3.51]\) | 3.72 | 21.6 |
| A–C | \(+0.76\) | \([-1.79,\ 3.30]\) | 5.09 | 12.1 |
| A–D | \(+3.49\) | \([2.06,\ 4.92]\) | 2.86 | 23.7 |
| B–C | \(-0.89\) | \([-3.67,\ 1.89]\) | 5.56 | 18.0 |
| B–D | \(+1.85\) | \([-0.10,\ 3.79]\) | 3.89 | 24.4 |
| C–D | \(+2.73\) | \([0.14,\ 5.32]\) | 5.18 | 13.5 |
구간의 폭이 2.86에서 5.56까지 두 배 차이난다.
투키라면 폭이 거의 같았을 것이다. 집단 크기만 반영하므로 \(n\)이 비슷하면 폭도 비슷하다. 게임스–하월은 각 쌍의 실제 정밀도를 반영한다.
가장 좁은 A–D(\(n=12,14\), \(\sigma=1.0,1.5\)): 두 집단 모두 분산이 작다. 가장 넓은 B–C(\(n=15,10\), \(\sigma=2.5,4.0\)): 두 집단 모두 분산이 크다.
이것이 정직한 보고다. "C 집단이 관련된 비교는 덜 정밀하다"는 사실이 구간의 폭으로 드러난다.
동시 신뢰구간이라는 점이 중요하다.
| 개별 구간 | 동시 구간 | |
|---|---|---|
| 보장 | 각각 95% | 여섯 개가 모두 95% |
| 폭 | 좁다 | 넓다 |
| 사용 | 하나만 볼 때 | 여러 개를 볼 때 |
여섯 개를 모두 보면서 개별 구간을 쓰면 적어도 하나가 빗나갈 확률이 \(1-0.95^6\approx0.26\)이다.
구간과 검정의 대응.
| 구간이 0을 | 검정이 |
|---|---|
| 포함하지 않음 | 기각(\(p<0.05\)) |
| 포함함 | 기각 안 함 |
A–B의 구간 \([-0.22,\,3.51]\)이 0을 아슬아슬하게 포함하고 \(p=0.096\)이다. 일관된다.
보고할 때의 요령. \(p\)만 적지 말고 차이와 구간을 함께 적는다.
A 대 D:  차이 +3.49,  95% 동시구간 [2.06, 4.92],  p < 0.001
A 대 B:  차이 +1.65,  95% 동시구간 [-0.22, 3.51], p = 0.096
두 번째 줄을 "차이 없음"으로 읽지 않는다. 구간의 상한이 3.51이므로 3.5 정도의 차이를 배제하지 못한다. 표본이 부족할 뿐이다.
pingouin은 구간을 주지 않는다. 연습문제 8의 자작 구현처럼 직접 계산해야 한다.
연습문제 6. 전체 검정과 사후검정의 가정을 일치시켜야 하는 이유를 설명하고, 잘못된 조합의 결과를 보여라.
풀이
올바른 조합.
| 전체 검정 | 사후검정 | 공통 가정 |
|---|---|---|
| 표준 \(F\) | 투키 HSD | 등분산 |
| 웰치 \(F\) | 게임스–하월 | 등분산 불필요 |
| 크러스컬–월리스 | 던 검정(순위 기반) | 분포 동일 |
잘못된 조합 둘.
| 조합 | 문제 |
|---|---|
| 웰치 + 투키 | 앞에서 안 가정한 것을 뒤에서 가정 |
| 표준 \(F\) + 게임스–하월 | 앞의 \(p\)를 믿을 수 없음 |
"웰치 + 투키"의 구체적 결과. 연습문제 9 의 수치를 조합하면
설계: k=4, n=(6,15,15,30), σ=(4,2,1,1)  — 역페어링

웰치 F 검정:      오류율 0.05 근처  ✓  (정확)
투키 사후검정:     FWER 0.296       ✗  (여섯 배)

→ "전체 검정은 믿을 만한데 사후검정은 여섯 번에 한 번 헛것을 본다"
전체 검정이 유의하지 않은데 사후검정이 유의한 쌍을 찾는 일도 생긴다. 앞뒤가 다른 가정을 쓰기 때문이다.
역방향 — 표준 \(F\) + 게임스–하월. 이 조합은 사후검정은 정확하지만 전체 검정이 틀렸다. 역페어링이면 \(F\)가 0.30 수준으로 헛되이 기각하고, 그 뒤 게임스–하월은 아무것도 찾지 못한다.
F 검정: p = 0.02  (유의)
게임스-하월: 여섯 쌍 모두 p > 0.3

→ "전체는 다른데 어느 쌍도 다르지 않다"는 모순된 보고
이 모순이 실무에서 흔한 혼란의 원인이다. 대개 "검정력 차이 때문"이라고 설명하지만, 가정 불일치가 진짜 원인인 경우가 많다.
권장 파이프라인.
1. 집단별 n 과 s 를 본다
     ↓
2. 분산비와 짝짓기 방향을 확인
     │
     ├─ 등분산 · 균형 ──→ 표준 F  +  투키 HSD
     │
     └─ 그 외 ──────────→ 웰치 F  +  게임스-하월
     ↓
3. 두 단계를 같은 가정 위에서 수행했음을 보고서에 명시
전체 검정을 건너뛰어도 되는가. 된다. 투키도 게임스–하월도 스스로 FWER을 통제하므로, 전체 \(F\)를 관문으로 둘 필요가 없다. 오히려 두 관문을 통과해야 해 보수적이 된다.
그런데도 전체 검정을 보고하는 이유.
| 이유 | 설명 |
|---|---|
| 관례 | 대부분의 학술지가 요구 |
| 전체 효과크기 | \(\eta^2\), \(\omega^2\)을 함께 보고 |
| 요약 | "적어도 하나는 다르다"는 한 줄 |
전체 검정과 사후검정이 어긋나면 그 사실을 그대로 보고하고, 어느 쪽을 왜 믿는지 밝힌다.
연습문제 7. 연습문제 1의 광고 디자인 문제를 게임스–하월로 끝까지 분석하고 보고문을 작성하라.
풀이
상황. 네 가지 광고 디자인, \(F=5.12\), \(p=0.008\). 클릭률은 비율 자료이므로 이분산이 거의 확실하다.
\(p\)가 다르면 분산도 다르다. 클릭률이 2%인 디자인과 10%인 디자인의 분산비가 \(\dfrac{0.1\times0.9}{0.02\times0.98}=4.6\)이다.
분석 절차 여섯.
1. 디자인별 노출 수 n, 클릭 수, 클릭률 p̂, 표준편차를 표로
     ↓
2. 분산비와 짝짓기 방향 확인
     ↓
3. 웰치 분산분석  (또는 이분 자료이므로 로지스틱 회귀)
     ↓
4. 게임스-하월 사후검정 + 신뢰구간
     ↓
5. 실질적 유의성: 클릭률 차이가 비즈니스에 의미 있는가
     ↓
6. 보고
3번에 주의. 클릭/비클릭은 이분 자료이므로 엄밀하게는 분산분석이 아니라 비율 비교(카이제곱, 로지스틱 회귀(logistic regression))가 맞다. 다만 \(n\)이 크면 정규근사가 잘 들어 분산분석도 쓸 수 있다.
보고문 예시.
네 가지 광고 디자인의 클릭률을 비교했다.

디자인   노출      클릭      클릭률    표준오차
  A     12,400    248      2.00%     0.13%p
  B     11,800    401      3.40%     0.17%p
  C     12,100    290      2.40%     0.14%p
  D     12,300    455      3.70%     0.17%p

클릭률이 디자인마다 다르므로 분산도 다르다(분산비 1.9 배).
따라서 웰치 분산분석과 게임스-하월 사후검정을 사용했다.

Welch F(3, 24_xxx) = 5.12,  p = 0.008

게임스-하월 (FWER = 0.05)
  비교      차이(%p)   95% 동시구간      p-adj
  B vs A     +1.40   [ 0.83,  1.97]    <0.001
  D vs A     +1.70   [ 1.13,  2.27]    <0.001
  D vs C     +1.30   [ 0.72,  1.88]    <0.001
  B vs C     +1.00   [ 0.43,  1.57]     0.002
  D vs B     +0.30   [-0.26,  0.86]     0.42
  C vs A     +0.40   [-0.15,  0.95]     0.21

결론: B 와 D 가 A·C 보다 명확히 높고, B 와 D 사이에는
      차이의 증거가 없다(구간 [-0.26, 0.86]%p).

실질적 함의: D 를 채택하면 A 대비 클릭률이 1.7%p(상대 85%)
             오르며, 월 100만 노출 기준 클릭 17,000 건 증가에
             해당한다.
마지막 문단이 핵심이다. \(p<0.001\)보다 "월 17,000건 증가"가 의사결정에 쓰인다.
B와 D의 비교를 어떻게 쓸까. "차이가 없다"가 아니라 "구간이 \([-0.26,\,0.86]\)%p이므로 0.9%p를 넘는 차이는 배제된다"가 정확하다. 그 폭이 실무적으로 무시할 만하다면 둘 중 아무것이나 골라도 된다고 말할 수 있다.
주의 셋.
- 다중 디자인을 동시에 시험하면 승자의 저주가 있다. 최고 성과 디자인의 효과는 과대추정되기 쉽다.
- 순차 검정을 했다면 그 다중성까지 보정해야 한다.
- 클릭률이 전부가 아니다. 전환율, 수익까지 봐야 한다.
연습문제 8.
게임스–하월 검정을 직접 구현하고 pingouin과 대조하라. 차이가 나는 부분이 있다면 왜인지 밝혀라.
풀이
구조. 각 쌍 \((i,j)\)에 대해
를 계산하고 \(q_{\alpha,k,\nu_{ij}}\)와 비교한다. 쌍마다 표준오차도 자유도도 다르다.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
import pandas as pd
from statsmodels.stats.libqsturng import qsturng, psturng
import pingouin as pg

def games_howell(gs, names=None, alpha=0.05):
    """게임스-하월: 쌍마다 웰치형 표준오차와 자유도를 쓴다."""
    k = len(gs)
    names = names or [f"G{i}" for i in range(k)]
    n = np.array([len(g) for g in gs], float)
    m = np.array([g.mean() for g in gs])
    v = np.array([g.var(ddof=1) for g in gs])
    rows = []
    for i in range(k):
        for j in range(i + 1, k):
            s = v[i] / n[i] + v[j] / n[j]
            se = np.sqrt(s / 2)
            df = s**2 / (v[i]**2 / (n[i]**2 * (n[i] - 1))
                         + v[j]**2 / (n[j]**2 * (n[j] - 1)))
            diff = m[j] - m[i]
            p = float(np.atleast_1d(psturng(abs(diff) / se, k, df))[0])
            h = qsturng(1 - alpha, k, df) * se
            rows.append([names[i], names[j], m[i], m[j], diff,
                         se * np.sqrt(2), df, p, diff - h, diff + h])
    return pd.DataFrame(rows, columns=["A", "B", "mean_A", "mean_B", "diff",
                                       "se", "df", "pval", "lo", "hi"])

rng = np.random.default_rng(14001)
gs = [rng.normal(mu, sd, n) for n, mu, sd in
      [(12, 10.0, 1.0), (15, 12.0, 2.5), (10, 11.0, 4.0), (14, 13.5, 1.5)]]
names = ["A", "B", "C", "D"]
print("자작 구현")
print(games_howell(gs, names).round(4).to_string(index=False))

df = pd.DataFrame({"y": np.concatenate(gs),
                   "g": np.concatenate([[names[i]] * len(g)
                                        for i, g in enumerate(gs)])})
print("\npingouin")
print(pg.pairwise_gameshowell(dv="y", between="g", data=df)
      .round(4).to_string(index=False))
자작 구현
A B  mean_A  mean_B    diff     se      df   pval      lo     hi
A B 10.1831 11.8290  1.6459 0.6694 21.6293 0.0955 -0.2154 3.5071
A C 10.1831 10.9416  0.7585 0.8585 12.1079 0.7968 -1.7873 3.3043
A D 10.1831 13.6749  3.4918 0.5182 23.7497 0.0010  2.0611 4.9225
B C 11.8290 10.9416 -0.8874 0.9831 17.9694 0.7843 -3.6663 1.8915
B D 11.8290 13.6749  1.8459 0.7056 24.4388 0.0671 -0.0982 3.7900
C D 10.9416 13.6749  2.7333 0.8871 13.5407 0.0372  0.1436 5.3230

pingouin
A B  mean_A  mean_B    diff     se       T      df   pval  hedges
A B 10.1831 11.8290 -1.6459 0.6694 -2.4589 21.6293 0.0956 -0.8627
A C 10.1831 10.9416 -0.7585 0.8585 -0.8835 12.1079 0.8134 -0.3875
A D 10.1831 13.6749 -3.4918 0.5182 -6.7383 23.7497 0.0000 -2.5144
B C 11.8290 10.9416  0.8874 0.9831  0.9027 17.9694 0.8036  0.3643
B D 11.8290 13.6749 -1.8459 0.7056 -2.6160 24.4388 0.0670 -0.9318
C D 10.9416 13.6749 -2.7333 0.8871 -3.0812 13.5407 0.0372 -1.3389
표준오차와 자유도가 소수점 넷째 자리까지 완전히 일치한다.
| 항목 | 자작 | pingouin | 일치 |
|---|---|---|---|
se |
0.6694 | 0.6694 | 완전 |
df |
21.6293 | 21.6293 | 완전 |
diff |
1.6459 | \(-1.6459\) | 부호 관례만 다름 |
\(p\) 값에 미세한 차이가 있다.
| 비교 | 자작 | pingouin | 원인 |
|---|---|---|---|
| A–B | 0.0955 | 0.0956 | 반올림 |
| A–C | 0.7968 | 0.8134 | psturng의 보간 오차 |
| A–D | 0.0010 | 0.0000 | psturng의 하한 절단 |
A–D가 결정적이다. statsmodels의 psturng은 \(p\)를 \([0.001,\,0.9]\)로 잘라 돌려준다. 참값이 \(10^{-6}\) 수준이어도 0.001로 보고된다.
큰 \(p\) 쪽에서도 정확도가 떨어진다(0.7968 대 0.8134). 스튜던트화 범위 분포의 CDF는 보간표로 구하는데, 꼬리 바깥에서 보간이 거칠다.
실무적 함의 셋.
- \(p<0.001\)은 "0.001보다 작다"로만 읽는다. 정확한 값을 알 수 없다.
- 큰 \(p\)의 소수점 둘째 자리는 믿지 않는다. 유의성 판정에는 영향이 없다.
- 신뢰구간이 더 유용하다.
qsturng으로 임계값을 구하는 것은 정확하다.
자작 구현의 가치. pingouin은 신뢰구간을 주지 않는다. 구간이 필요하면 직접 계산해야 하고, 위 코드의 lo/hi가 그것이다.
부호 관례. pingouin은 mean_A - mean_B, 여기서는 mean_B - mean_A를 썼다. 보고할 때 방향을 명시하는 것이 안전하다.
연습문제 9. 게임스–하월과 투키의 가족단위 오류율을 여러 설계에서 비교하라.
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from statsmodels.stats.libqsturng import qsturng

def gh_any(gs, alpha=0.05):
    k = len(gs)
    n = np.array([len(g) for g in gs], float)
    m = np.array([g.mean() for g in gs])
    v = np.array([g.var(ddof=1) for g in gs])
    for i in range(k):
        for j in range(i + 1, k):
            s = v[i] / n[i] + v[j] / n[j]
            df = s**2 / (v[i]**2 / (n[i]**2 * (n[i] - 1))
                         + v[j]**2 / (n[j]**2 * (n[j] - 1)))
            if abs(m[i] - m[j]) / np.sqrt(s / 2) > qsturng(1 - alpha, k, df):
                return True
    return False

def tk_any(gs, alpha=0.05):
    k = len(gs)
    n = np.array([len(g) for g in gs], float)
    m = np.array([g.mean() for g in gs])
    v = np.array([g.var(ddof=1) for g in gs])
    MSE = ((n - 1) * v).sum() / (n.sum() - k)
    qc = qsturng(1 - alpha, k, n.sum() - k)
    return any(abs(m[i] - m[j]) / np.sqrt(MSE / 2 * (1 / n[i] + 1 / n[j])) > qc
               for i in range(k) for j in range(i + 1, k))

rng = np.random.default_rng(12006)
B = 3_000
print("완전 귀무에서의 FWER (k=4), 명목 0.05")
print(f"{'설계':>30s} {'투키':>8s} {'G-H':>8s}")
for lab, ns, sds in [("등분산·균형 n=15, σ=1", [15] * 4, [1, 1, 1, 1]),
                     ("이분산·균형 σ=(1,1,1,4)", [15] * 4, [1, 1, 1, 4]),
                     ("역페어링 n=(6,15,15,30)", [6, 15, 15, 30], [4, 2, 1, 1]),
                     ("정페어링 n=(30,15,15,6)", [30, 15, 15, 6], [4, 2, 1, 1]),
                     ("극단 역페어링 n=(5,10,20,40)", [5, 10, 20, 40],
                      [5, 3, 2, 1])]:
    a = b = 0
    for _ in range(B):
        gs = [rng.normal(0, s, n) for n, s in zip(ns, sds)]
        a += tk_any(gs)
        b += gh_any(gs)
    print(f"{lab:>30s} {a / B:8.4f} {b / B:8.4f}")
완전 귀무에서의 FWER (k=4), 명목 0.05
                            설계       투키      G-H
              등분산·균형 n=15, σ=1   0.0510   0.0520
            이분산·균형 σ=(1,1,1,4)   0.1037   0.0510
           역페어링 n=(6,15,15,30)   0.2960   0.0480
           정페어링 n=(30,15,15,6)   0.0120   0.0523
        극단 역페어링 n=(5,10,20,40)   0.3620   0.0493
게임스–하월이 다섯 상황 모두에서 0.048~0.052를 유지한다.
| 설계 | 투키 | 게임스–하월 |
|---|---|---|
| 등분산·균형 | 0.051 | 0.052 |
| 이분산·균형 | 0.104 | 0.051 |
| 역페어링 | 0.296 | 0.048 |
| 정페어링 | 0.012 | 0.052 |
| 극단 역페어링 | 0.362 | 0.049 |
균형인데도 투키가 0.104로 무너진다(둘째 줄). 분산비 4배만으로 두 배다. 균형이 이분산을 막아 준다는 것은 전체 \(F\) 검정에만 해당한다.
왜 쌍별 비교는 균형의 보호를 못 받는가. 전체 \(F\) 검정은 모든 집단의 정보를 평균하므로 과대·과소가 상쇄된다. 쌍별 비교는 가장 극단적인 한 쌍이 FWER을 정하므로 상쇄가 없다.
\(\sigma=(1,1,1,4)\)에서 합동 MSE는 \(4.75\)인데,
| 비교 | 참 분산의 합 | 투키가 쓰는 값 | 판정 |
|---|---|---|---|
| 작은 집단끼리 | 2 | 9.5 | 보수적 |
| 큰 집단 포함 | 17 | 9.5 | 자유로움 |
후자가 FWER을 지배한다.
정페어링의 0.012도 문제다. 검정력을 크게 잃는다. 투키는 어느 방향으로든 틀린다.
연습문제 10. 게임스–하월은 아주 작은 표본에서도 작동하는가? 대안인 더닛 T3과 비교하라.
풀이
더닛 T3. 스튜던트화 최대 절댓값(studentized maximum modulus) 분포를 쓰는데, 시닥 보정한 웰치 \(t\)로 근사할 수 있다.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats
from statsmodels.stats.libqsturng import qsturng

def gh_any(gs, alpha=0.05):
    k = len(gs)
    n = np.array([len(g) for g in gs], float)
    m = np.array([g.mean() for g in gs])
    v = np.array([g.var(ddof=1) for g in gs])
    for i in range(k):
        for j in range(i + 1, k):
            s = v[i] / n[i] + v[j] / n[j]
            df = s**2 / (v[i]**2 / (n[i]**2 * (n[i] - 1))
                         + v[j]**2 / (n[j]**2 * (n[j] - 1)))
            if abs(m[i] - m[j]) / np.sqrt(s / 2) > qsturng(1 - alpha, k, df):
                return True
    return False

def t3_any(gs, alpha=0.05):
    """더닛 T3 (시닥 보정 웰치 t 로 근사)."""
    k = len(gs)
    M = k * (k - 1) // 2
    n = np.array([len(g) for g in gs], float)
    m = np.array([g.mean() for g in gs])
    v = np.array([g.var(ddof=1) for g in gs])
    a2 = 1 - (1 - alpha)**(1 / M)
    for i in range(k):
        for j in range(i + 1, k):
            s = v[i] / n[i] + v[j] / n[j]
            df = s**2 / (v[i]**2 / (n[i]**2 * (n[i] - 1))
                         + v[j]**2 / (n[j]**2 * (n[j] - 1)))
            if abs(m[i] - m[j]) / np.sqrt(s) > stats.t.ppf(1 - a2 / 2, df):
                return True
    return False

rng = np.random.default_rng(14002)
B = 4_000
print("완전 귀무에서의 FWER, 명목 0.05")
print(f"{'설계':>28s} {'게임스-하월':>11s} {'더닛 T3':>9s}")
for lab, ns, sds in [("k=3, n=5, σ=(1,1,1)", [5] * 3, [1, 1, 1]),
                     ("k=3, n=5, σ=(1,2,4)", [5] * 3, [1, 2, 4]),
                     ("k=3, n=10, σ=(1,2,4)", [10] * 3, [1, 2, 4]),
                     ("k=4, n=6, σ=(1,1,2,4)", [6] * 4, [1, 1, 2, 4]),
                     ("k=4, n=20, σ=(1,1,2,4)", [20] * 4, [1, 1, 2, 4])]:
    a = b = 0
    for _ in range(B):
        gs = [rng.normal(0, s, n) for n, s in zip(ns, sds)]
        a += gh_any(gs)
        b += t3_any(gs)
    print(f"{lab:>28s} {a / B:11.4f} {b / B:9.4f}")

print("\n검정력 (이분산, k=4, n=15, σ=(1,1,1,3), μ4 만 이동)")
print(f"{'δ':>5s} {'게임스-하월':>11s} {'더닛 T3':>9s}")
for d in [2.0, 3.0, 4.0]:
    a = b = 0
    for _ in range(B):
        gs = [rng.normal(0 if i < 3 else d, s, 15)
              for i, s in enumerate([1, 1, 1, 3])]
        a += gh_any(gs)
        b += t3_any(gs)
    print(f"{d:5.1f} {a / B:11.4f} {b / B:9.4f}")
완전 귀무에서의 FWER, 명목 0.05
                          설계      게임스-하월     더닛 T3
         k=3, n=5, σ=(1,1,1)      0.0493    0.0355
         k=3, n=5, σ=(1,2,4)      0.0565    0.0435
        k=3, n=10, σ=(1,2,4)      0.0498    0.0430
       k=4, n=6, σ=(1,1,2,4)      0.0517    0.0385
      k=4, n=20, σ=(1,1,2,4)      0.0455    0.0380

검정력 (이분산, k=4, n=15, σ=(1,1,1,3), μ4 만 이동)
    δ      게임스-하월     더닛 T3
  2.0      0.4970    0.4555
  3.0      0.8525    0.8195
  4.0      0.9838    0.9768
게임스–하월이 \(n=5\)에서도 0.049~0.057을 유지한다. 놀랍도록 견고하다.
| 설계 | G-H | 더닛 T3 |
|---|---|---|
| \(n=5\), 등분산 | 0.049 | 0.036 |
| \(n=5\), 이분산 | 0.057 | 0.044 |
| \(n=6\), \(k=4\) | 0.052 | 0.039 |
| \(n=20\), \(k=4\) | 0.046 | 0.038 |
더닛 T3은 일관되게 보수적이다(0.036~0.044). 시닥 보정이 상관을 무시하기 때문이다.
검정력도 게임스–하월이 높다.
| \(\delta\) | G-H | T3 | 차이 |
|---|---|---|---|
| 2.0 | 0.497 | 0.456 | \(+9\%\) |
| 3.0 | 0.853 | 0.820 | \(+4\%\) |
| 4.0 | 0.984 | 0.977 | \(+1\%\) |
\(n=5\), 이분산에서 게임스–하월이 0.0565로 약간 초과한다. 이것이 문헌에서 지적하는 "아주 작은 표본에서 약간 자유롭다"는 성질이다. \(n\geq10\)이면 사라진다.
선택 지침.
| 상황 | 권장 |
|---|---|
| \(n\geq6\), 이분산 | 게임스–하월 |
| \(n\leq5\), 엄격한 통제가 필요 | 더닛 T3(보수적이지만 안전) |
| 등분산이 확실 | 투키 |
| 대조군 비교만 | 더닛 T3 또는 웰치형 더닛 |
탐헤인 T2도 같은 계열이다. T3보다 더 보수적이며, 실무에서는 셋 중 게임스–하월이 가장 널리 쓰인다.
연습문제 11. 분산이 다를 때의 사후비교(post hoc comparison)로 게임스–하월 검정을 구현하고, 투키·본페로니 웰치와 비교하라.
풀이
게임스–하월. 투키의 스튜던트화 범위분포를 쓰되, 쌍별 분산과 새터스웨이트 자유도를 쓴다. 투키와 웰치의 결합이다.
import numpy as np
from scipy import stats
from itertools import combinations
from statsmodels.stats.libqsturng import psturng, qsturng

groups = {
    "ctrl": np.array([4.17, 5.58, 5.18, 6.11, 4.50, 4.61, 5.17, 4.53, 5.33, 5.14]),
    "trt1": np.array([4.81, 4.17, 4.41, 3.59, 5.87, 3.83, 6.03, 4.89, 4.32, 4.69]),
    "trt2": np.array([6.31, 5.12, 5.54, 5.50, 5.37, 5.29, 4.92, 6.15, 5.80, 5.26]),
}
names = list(groups)
k = len(names)

print("게임스·하월")
for a, b in combinations(range(k), 2):
    x, y = groups[names[a]], groups[names[b]]
    n1, n2 = len(x), len(y)
    v1, v2 = x.var(ddof=1), y.var(ddof=1)
    se = np.sqrt((v1 / n1 + v2 / n2) / 2)
    df = ((v1 / n1 + v2 / n2)**2
          / ((v1 / n1)**2 / (n1 - 1) + (v2 / n2)**2 / (n2 - 1)))
    q = abs(x.mean() - y.mean()) / se
    p = float(np.atleast_1d(psturng(q, k, df))[0])
    half = qsturng(0.95, k, df) * se
    diff = x.mean() - y.mean()
    print(f"  {names[a]}-{names[b]}: 차이 {diff:+.4f}  q = {q:.4f}  "
          f"df = {df:.2f}  p = {p:.4f}")
    print(f"              95% CI ({diff - half:+.4f}, {diff + half:+.4f})")
게임스·하월
  ctrl-trt1: 차이 +0.3710  q = 1.6847  df = 16.52  p = 0.4761
              95% CI (-0.4299, +1.1719)
  ctrl-trt2: 차이 -0.4940  q = 3.0180  df = 16.79  p = 0.1128
              95% CI (-1.0884, +0.1004)
  trt1-trt2: 차이 -0.8650  q = 4.2569  df = 14.10  p = 0.0236
              95% CI (-1.6162, -0.1138)
세 방법의 \(p\) 값을 나란히 놓으면.
| 쌍 | 투키 | 게임스–하월 | 본페로니 웰치 |
|---|---|---|---|
| ctrl-trt1 | 0.391 | 0.476 | 0.751 |
| ctrl-trt2 | 0.198 | 0.113 | 0.144 |
| trt1-trt2 | 0.012 | 0.024 | 0.028 |
게임스–하월이 대체로 중간이다. 쌍별 분산을 쓰면서도 스튜던트화 범위를 쓰므로, 본페로니의 보수성은 피하고 투키의 등분산 가정은 버린다.
ctrl-trt2에서 게임스–하월이 가장 작다(0.113). 두 집단의 분산이 모두 작아 쌍별 표준오차가 합동값보다 작기 때문이다.
세 방법의 FWER을 비교해 보자.
rng = np.random.default_rng(1357)

def tukey_any(g, alpha=0.05):
    k = len(g)
    n = np.array([len(x) for x in g])
    N = n.sum()
    MSE = sum(((x - x.mean())**2).sum() for x in g) / (N - k)
    for i, j in combinations(range(k), 2):
        se = np.sqrt(MSE / 2 * (1 / n[i] + 1 / n[j]))
        if abs(g[i].mean() - g[j].mean()) / se > qsturng(1 - alpha, k, N - k):
            return True
    return False

def games_howell_any(g, alpha=0.05):
    k = len(g)
    for i, j in combinations(range(k), 2):
        x, y = g[i], g[j]
        n1, n2 = len(x), len(y)
        v1, v2 = x.var(ddof=1), y.var(ddof=1)
        se = np.sqrt((v1 / n1 + v2 / n2) / 2)
        df = ((v1 / n1 + v2 / n2)**2
              / ((v1 / n1)**2 / (n1 - 1) + (v2 / n2)**2 / (n2 - 1)))
        if abs(x.mean() - y.mean()) / se > qsturng(1 - alpha, k, df):
            return True
    return False

def bonf_welch_any(g, alpha=0.05):
    k = len(g)
    m = k * (k - 1) // 2
    return any(stats.ttest_ind(g[i], g[j], equal_var=False).pvalue < alpha / m
               for i, j in combinations(range(k), 2))

M = 5_000
print(f"{'상황':>24s} {'투키':>8s} {'게임스·하월':>12s} {'본페로니 Welch':>15s}")
for label, sig, ns in [("등분산 등n", (1, 1, 1), (10, 10, 10)),
                       ("이분산 등n", (1, 1, 3), (10, 10, 10)),
                       ("이분산 불균형(큰σ↔작은n)", (1, 1, 3), (15, 15, 5)),
                       ("이분산 불균형(큰σ↔큰n)", (1, 1, 3), (5, 15, 15))]:
    a = b = c = 0
    for _ in range(M):
        g = [rng.normal(0, s, n) for s, n in zip(sig, ns)]
        a += tukey_any(g)
        b += games_howell_any(g)
        c += bonf_welch_any(g)
    print(f"{label:>24s} {a / M:8.4f} {b / M:12.4f} {c / M:15.4f}")
                      상황       투키       게임스·하월      본페로니 Welch
                  등분산 등n   0.0464       0.0470          0.0400
                  이분산 등n   0.0702       0.0492          0.0414
         이분산 불균형(큰σ↔작은n)   0.2538       0.0506          0.0392
          이분산 불균형(큰σ↔큰n)   0.0326       0.0506          0.0436
투키가 이분산에서 무너진다. 불균형과 결합하면 0.254다.
게임스–하월이 네 상황 모두에서 0.047~0.051로 안정적이다.
본페로니 웰치는 안전하지만 보수적이다(0.039~0.044). \(k=3\)이라 차이가 작지만, \(k\)가 커지면 벌어진다.
권고.
| 상황 | 방법 |
|---|---|
| 등분산·등\(n\)이 확실 | 투키(가장 강력) |
| 그 밖 모든 경우 | 게임스–하월 |
| 비교가 소수이고 단순함을 원함 | 본페로니 웰치 |
게임스–하월을 기본으로 삼아도 손해가 거의 없다. 등분산일 때 투키와의 차이가 0.046 대 0.047로 미미하다.
정리하며
게임스–하월은 등분산도 동일 표본크기도 가정하지 않는 사후검정이다.
- 쌍마다 분산을 따로 추정한다. 합동 MSE 를 쓰지 않으며, 자유도는 웰치–새터스웨이트 근사로 정한다. 쌍별 웰치 \(t\) 검정에 다중비교 보정을 입힌 것이라고 보면 된다.
- 투키가 무너지는 곳에서 작동한다. 작은 집단에 큰 분산이 붙으면 투키의 제1종 오류율이 부풀고, 반대 조합에서는 검정력이 떨어진다.
- 웰치 분산분석 뒤의 기본 사후검정이다. 전체 검정에서 등분산을 가정하지 않았으니 사후검정에서도 가정하지 않는 것이 일관적이다.
- 표본이 아주 작으면 다소 자유롭다. 각 집단에 관측이 6 개 미만이면 제1종 오류율이 명목값을 조금 넘을 수 있다.
- 선택 기준은 단순하다. 등분산이 의심스러우면 게임스–하월, 아니면 투키다.
다음 절 사후비교 방법의 비교와 검정력에서 네 임계값을 한 자에 올려 견주고, 놓친 쌍이 방법 때문인지 표본 때문인지 가린다.