베셀 수정
1. 들어가며 — 여덟 수로 나누기가 갈린다
\(\{2, 4, 4, 4, 5, 5, 7, 9\}\) 는 분산을 손으로 셈해 보일 때 자주 쓰이는 자료다. 합이 \(40\), 평균이 \(5\), 제곱합(sum of squares)이 \(32\) 라 \(8\) 로 나누면 \(4.0000\) 이 딱 떨어진다. 그런데 분모를 \(7\) 로 바꾸면 \(4.5714\) 가 나오고, 깔끔하게 떨어지는 쪽이 편향된 쪽이다. 분모를 한 칸 줄이는 것뿐인데 분산이 \(14.29\%\), 표준편차가 \(6.90\%\) 움직인다. 관측값은 여덟 개 그대로인데, 그 한 칸은 무엇을 세고 있는 것인가.
베셀 수정은 표본분산(sample variance) 공식의 분모에 \(n\) 대신 \(n-1\)을 쓰는 것을 말하며, 그 결과 모분산의 불편추정량(unbiased estimator)을 얻는다. 프리드리히 베셀(Friedrich Bessel)의 이름을 딴 이 수정은 같은 자료로 평균을 추정하느라 자유도 하나가 "소모"되어 소박한 추정량(\(n\)으로 나누기)이 참 분산을 체계적으로 과소추정한다는 사실을 보정한다.
정의 1. 베셀 수정 표본분산
베셀 수정 표본분산은 다음과 같다.
대부분의 통계 소프트웨어에서 쓰는 표준적인 "표본분산"이다(예: numpy.var(ddof=1), R의 var()).
2. 불편성의 증명
정리 1. 베셀 수정 표본분산은 불편이다
\(X_1, \ldots, X_n\)이 평균 \(\mu\), 분산 \(\sigma^2\)을 갖는 독립인 확률변수이면
이다.
증명
앞 쪽이 세운 소박한 분산추정량 정리 1 의 제곱합 항등식에서 출발한다. 임의의 \(\mu\) 에 대해 \(\sum_i (X_i - \bar X)^2 = \sum_i (X_i - \mu)^2 - n(\bar X - \mu)^2\) 이므로, 양변의 기댓값을 취하면 이렇게 된다.
따라서 이렇게 된다.
왜 n-1인가? 자유도 논증
\(n\)개의 편차 \(d_i = X_i - \bar{X}\)는 다음 제약을 받는다.
즉 편차 중 \(n-1\)개만이 독립적으로 자유롭게 변할 수 있다. 이를 두고 자유도가 \(n-1\)이라고 한다. 관측값의 개수(\(n\))가 아니라 자유도(\(n-1\))로 나누면 편향이 보정된다.
일반 원리: 추정한 모수가 \(k\)개일 때 분산을 추정하려면 \(n - k\)로 나눈다.
- 평균을 모르고 \(X\)의 분산을 추정: \(n - 1\)로 나눈다
- 계수가 \(p\)개인 회귀: 잔차분산은 \(n - p\)를 쓴다
"자유도 하나를 소모한다"는 말은 추상적으로 들리지만 실제로는 아주 구체적인 일이다. \(n = 5\)짜리 표본 하나의 편차를 그려 보면 바로 보인다.
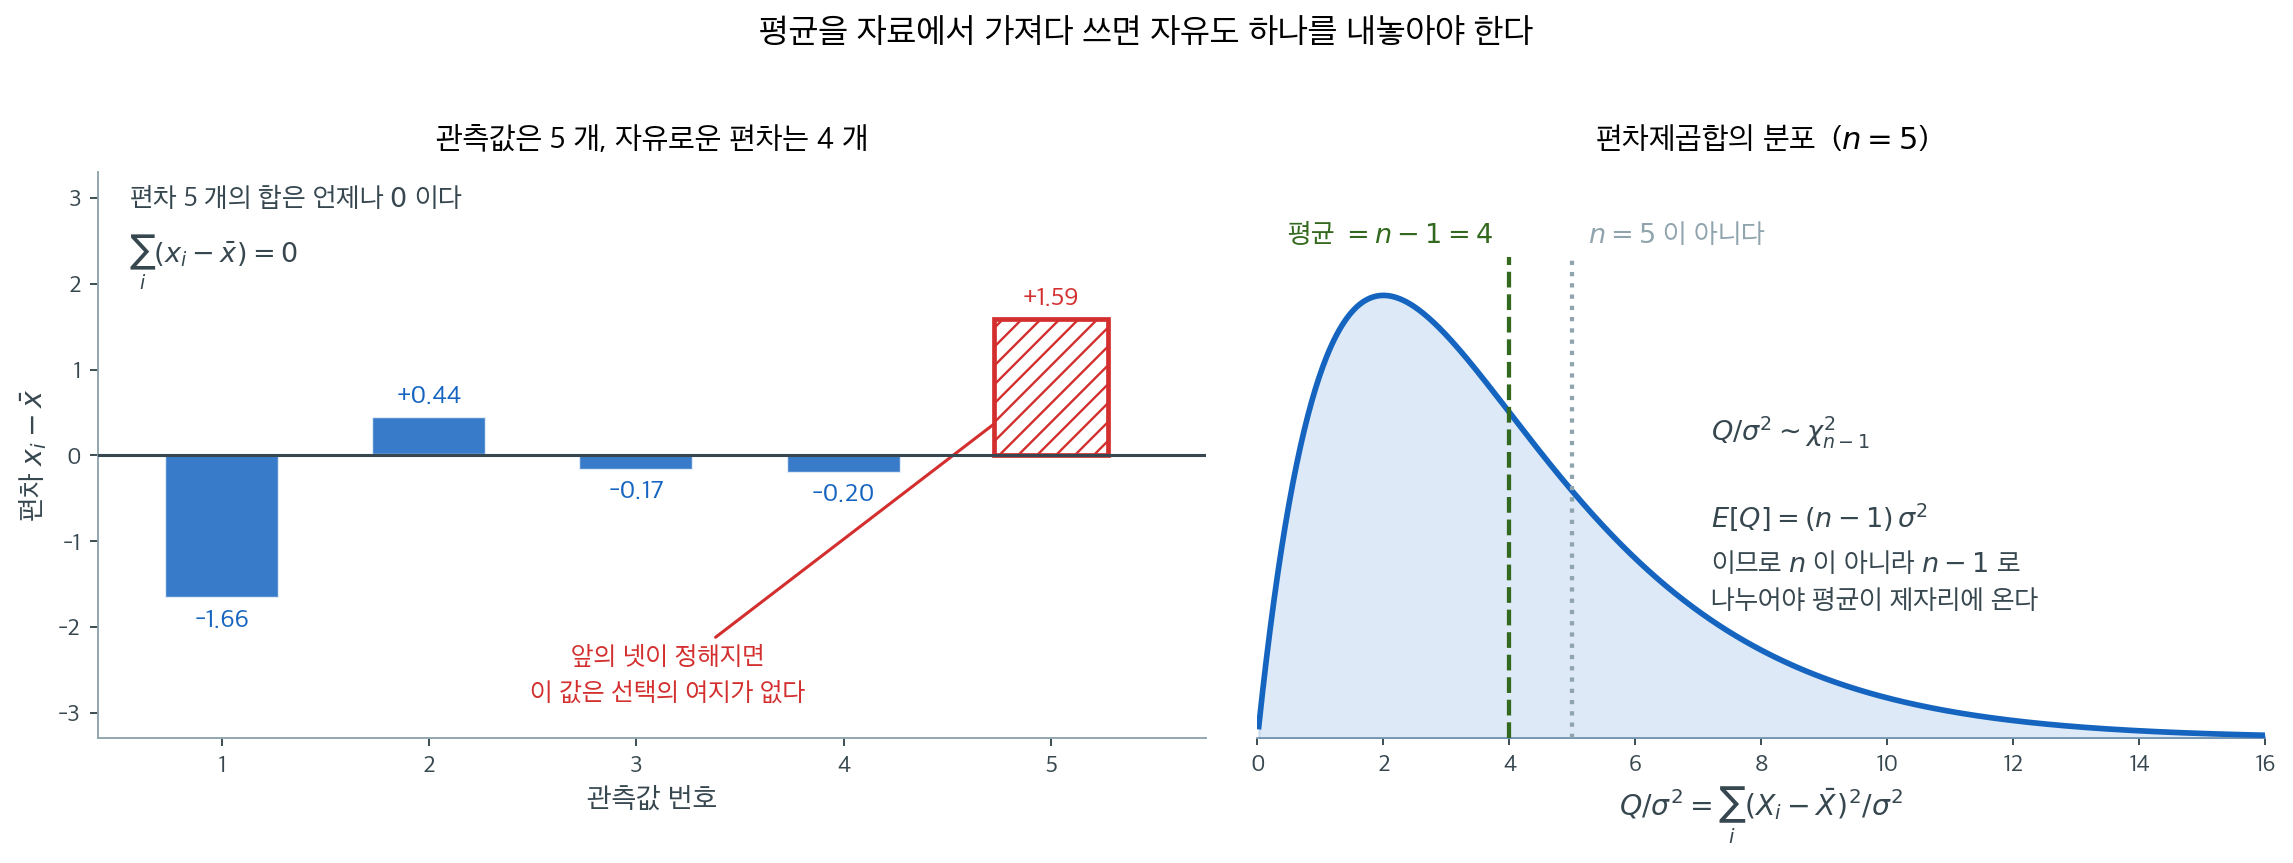
왼쪽 막대가 이 표본의 편차 \(x_i - \bar{x}\)다. 값은 \(-1.66,\; +0.44,\; -0.17,\; -0.20,\; +1.59\)이고 합은 정확히 \(0\)이다. 여기서 중요한 것은 다섯 번째 막대에 선택의 여지가 없다는 점이다. 앞의 네 값을 알면 마지막 값은 \(-(-1.66 + 0.44 - 0.17 - 0.20) = +1.59\)로 자동으로 결정된다. 빗금으로 그린 이유가 그것이다. 관측값은 다섯 개지만 산포에 대해 말해 주는 독립적인 숫자는 넷뿐이다.
오른쪽이 그 결과다. 정규성(normality) 아래에서 \(Q/\sigma^2 = \sum_i (X_i-\bar{X})^2/\sigma^2\)은 자유도 \(4\)인 카이제곱분포(chi-squared distribution)를 따르고, 그 분포의 평균은 \(4\)다. 관측값 개수인 \(5\)가 아니다. 분포가 통째로 왼쪽으로 한 칸 밀려 있는 셈인데, 이 "한 칸"이 곧 \(\sigma^2\) 하나만큼의 편향이다. \(Q\)를 \(n = 5\)로 나누면 평균이 \(0.8\sigma^2\)에 오고, \(n - 1 = 4\)로 나누어야 정확히 \(\sigma^2\)에 온다.
이렇게 보면 베셀 수정은 "\(n\)이 작을 때 쓰는 보정"이 아니라 나눌 때 세는 단위를 관측값 개수에서 자유도로 바꾼 것이다. 회귀에서 \(n - p\)로 나누는 것도, 분산분석(analysis of variance)에서 각 제곱합에 저마다 다른 자유도가 붙는 것도 전부 같은 규칙의 반복이다.
3. S² 의 분포는 5.6 이 맡는다
불편성은 모집단의 모양을 묻지 않지만 분포는 묻는다. 정규모집단이면 \((n-1)S^2/\sigma^2 \sim \chi^2_{n-1}\) 이고, 거기서 \(\operatorname{Var}(S^2) = 2\sigma^4/(n-1)\) 과 \(\bar X \perp S^2\) 이 따라 나온다. 셋 다 5.6절 분산의 표집분포 정리 2 가 세우고, 같은 절의 네 쪽이 모집단을 바꿔 가며 그 결과가 정규 전용이라는 것을 수로 보인다 — 불일치의 배율 \((\beta_2-1)/2\) 는 표본크기를 아무리 키워도 그대로 남는다.
이 쪽이 쓰는 것은 그 가운데 자유도 하나다. 카이제곱의 자유도가 \(n-1\) 인 것과 분모가 \(n-1\) 인 것이 같은 하나를 세는 일이라는 점을 아래 절이 따라간다.
4. 불편이지만 평균제곱오차가 최소는 아니다
분산과 평균제곱오차
정규모집단에서 이렇게 된다.
일치성
\(S^2\)은 \(\sigma^2\)에 대해 일치한다.
대안과의 평균제곱오차 비교
정규모집단에서 이렇게 된다.
불편추정량이 편향된 소박한 추정량보다 평균제곱오차(mean squared error)가 크다. 불편성이 분산 증가라는 대가를 치르며, (평균제곱오차 관점에서) 그 분산 증가가 편향 감소보다 크기 때문이다.
5. 실질적 의의
언제 중요한가?
\(n\)으로 나누는 것과 \(n-1\)로 나누는 것의 차이는 다음과 같다.
| \(n\) | \((n-1)/n\) | 상대오차 |
|---|---|---|
| 3 | 0.667 | 33.3% |
| 5 | 0.800 | 20.0% |
| 10 | 0.900 | 10.0% |
| 30 | 0.967 | 3.3% |
| 100 | 0.990 | 1.0% |
| 1000 | 0.999 | 0.1% |
\(n > 30\)이면 실질적인 차이가 작다. \(n < 10\)이면 수정이 상당하다.
표준편차의 편향
\(S^2\)은 \(\sigma^2\)에 대해 불편이지만, 표본표준편차 \(S = \sqrt{S^2}\)은 \(\sigma\)에 대해 불편이 아니다. (\(\sqrt{\cdot}\)가 오목이므로) 옌센 부등식에 의해 이렇게 된다.
정규모집단에서 이렇게 된다.
보정인자 \(c_4 = \sqrt{2/(n-1)} \cdot \Gamma(n/2)/\Gamma((n-1)/2)\)를 쓰면 \(\sigma\)의 불편추정량 \(\hat{\sigma} = S/c_4\)를 얻을 수 있다.
6. 소프트웨어 구현
소프트웨어마다 기본값이 다르다.
| 소프트웨어 | var() 기본값 |
나누는 수 |
|---|---|---|
Python numpy.var() |
\(n\) (모집단) | ddof=0 |
Python numpy.var(ddof=1) |
\(n-1\) (표본) | ddof=1 |
R var() |
\(n-1\) (표본) | — |
Excel VAR.S() |
\(n-1\) (표본) | — |
Excel VAR.P() |
\(n\) (모집단) | — |
pandas .var() |
\(n-1\) (표본) | ddof=1 |
흔한 함정: ddof=1 없이 numpy.var()를 쓰면 편향된(소박한) 추정량이 나온다. 불편 표본분산을 원한다면 항상 ddof=1을 지정하라.
7. 일반화: 회귀에서의 자유도
선형회귀(linear regression) \(Y = X\beta + \epsilon\)에서 잔차분산추정량은 다음과 같다.
여기서 \(p\)는 추정한 계수의 개수이다. 이는 베셀 수정을 일반화한 것이다: 추정한 모수 하나마다 자유도 하나를 잃는다.
AI로 보는 통계학 1. 모수마다 자유도 하나씩이라는 셈이 끝나는 자리
바로 위에서 \(\hat\sigma^2 = \mathrm{RSS}/(n-p)\) 로 베셀 수정을 일반화했다. 모수 하나마다 자유도 하나를 잃는다는 셈이다. 이 셈에는 끝이 있다. \(p\) 가 \(n\) 에 닿으면 나눌 것이 없어지고, 넘어서면 음수로 나누게 된다. 오늘 쓰이는 모형은 거의 언제나 그 너머에 있다 — 모수가 자료보다 많은 쪽이 기본값이다.
관측 \(30\) 개에 다항식 차수를 올려 가며 그 자리를 지나가 보자.
import numpy as np
from numpy.polynomial import legendre as LG

rg = np.random.default_rng(1)
NN, SIG = 30, 0.5
xg = np.linspace(-1, 1, NN)
truth = lambda t: 1 + 2*t - 1.5*t**2
yg = truth(xg) + rg.normal(0, SIG, NN)
xh = rg.uniform(-1, 1, 4000)                     # 남겨 둔 자료
yh = truth(xh) + rg.normal(0, SIG, 4000)

print(f"  관측 {NN} 개, 참 모형은 2 차, 참 잡음 분산 σ² = {SIG**2}\n")
print("   차수   모수 p   n - p       RSS      RSS/(n-p)      남겨 둔 MSE")
for deg in (2, 10, 20, 25, 29, 31):
    B = LG.legvander(xg, deg)
    co = np.linalg.lstsq(B, yg, rcond=None)[0]
    rss = float(((yg - B @ co) ** 2).sum())
    pp, dof = deg + 1, NN - (deg + 1)
    s2 = "     0/0 꼴" if dof == 0 else f"{rss/dof:11.4f}"
    mse = float(((yh - LG.legvander(xh, deg) @ co) ** 2).mean())
    print(f"   {deg:4d}   {pp:5d}   {dof:5d}  {rss:9.5f}  {s2}    {mse:14.4g}")
출력:
  관측 30 개, 참 모형은 2 차, 참 잡음 분산 σ² = 0.25

   차수   모수 p   n - p       RSS      RSS/(n-p)      남겨 둔 MSE
      2       3      27    4.76414       0.1764            0.2613
     10      11      19    3.49844       0.1841            0.2995
     20      21       9    0.68544       0.0762             7.699
     25      26       4    0.20550       0.0514             151.9
     29      30       0    0.00000       0/0 꼴         4.577e+09
     31      32      -2    0.00000      -0.0000          2.42e+06
맨 윗줄이 참 모형이다. 공식이 \(0.1764\) 를 주고 남겨 둔 자료가 \(0.2613\) 을 주어 둘 다 참값 \(0.25\) 언저리다. 공식이 제 일을 하는 구간이다.
차수 \(25\) 를 보라. 공식은 \(0.0514\) 라 한다 — 참 잡음 분산의 오분의 일이다. 모형이 잡음보다 더 잘 맞춘다는 말이니 있을 수 없는 일인데, 같은 모형을 남겨 둔 자료에 대 보면 \(151.9\) 다. 공식은 모형이 다섯 배 좋다고 하고 자료는 육백 배 나쁘다고 한다. \(n-p\) 가 \(4\) 로 줄어들면서 분모가 분자보다 빨리 작아진 탓이다.
차수 \(29\) 에서 \(n - p = 0\) 이 되어 식이 \(0/0\) 이 되고, 차수 \(31\) 에서는 \(n-p = -2\) 라 분산 추정값이 음수로 나온다. 분산이 음수일 수 없으니 식이 끝난 것이다. 고칠 수 있는 종류의 고장이 아니다 — 자유도를 「자료의 개수에서 모수의 개수를 뺀 것」으로 세는 발상 자체가 \(p < n\) 을 전제로 하기 때문이다.
그래서 모수가 자료보다 많은 모형에서는 이 식을 아예 쓰지 않는다. 대신 마지막 열이 하는 일을 한다 — 남겨 둔 자료에서 직접 재는 것이다. 교차검증(cross-validation)이 통계학의 교양이 아니라 필수품이 된 까닭이 여기에 있다. 세어서 아는 길이 막히면 떼어 놓고 재는 수밖에 없다.
덧붙여, 정칙화를 건 모형에서는 유효자유도라는 다른 셈이 쓰인다. 모수의 개수가 아니라 \(\mathrm{tr}(H)\) 처럼 모형이 자료를 얼마나 따라갔는지를 재는 양이고, 그 값은 \(p\) 와 달리 정수일 필요도 없고 \(n\) 을 넘지도 않는다. 베셀의 \(n-1\) 은 그 가운데 가장 단순한 경우 — 평균 하나를 자료에서 정했으니 \(1\) 을 뺀다 — 였던 셈이다.
8. 금융과의 연결 — 관측이 스물한 개면 수정이 중요해진다
-
실현변동성: 일중 수익률로 일별 실현변동성을 계산할 때는 \(n\)이냐 \(n-1\)이냐가 대개 무의미하다(관측값이 많다). 그러나 일별 자료로 월별 변동성을 구할 때(약 21개 관측값)는 수정이 의미가 있다.
-
추적오차: 포트폴리오와 벤치마크의 추적오차는 베셀 수정을 써서 \(S = \sqrt{\frac{1}{n-1}\sum(r_p - r_b)^2}\)로 계산한다.
-
위험 배분: 포트폴리오 위험의 분산분해는 \(n-1\)로 나누는 불편 공분산행렬을 쓴다.
9. 핵심 공식 — n 과 n−1 이 무엇을 바꾸는가
| 양 | 공식 |
|---|---|
| 베셀 수정 분산 | \(S^2 = \frac{1}{n-1}\sum(X_i - \bar{X})^2\) |
| 불편성 | \(E[S^2] = \sigma^2\) |
| 분포 (정규) | \((n-1)S^2/\sigma^2 \sim \chi^2_{n-1}\) |
| 분산 (정규) | \(\text{Var}(S^2) = 2\sigma^4/(n-1)\) |
| \(S\)는 \(\sigma\)에 대해 편향 | \(E[S] < \sigma\) (옌센 부등식) |
| 일반적인 회귀 | \(\hat{\sigma}^2 = \text{RSS}/(n-p)\) |
10. 수정을 수로 확인하기
절 \(2\) 의 불편성, 절 \(3\) 의 \((n-1)S^2/\sigma^2 \sim \chi^2_{n-1}\), 절 \(6\) 의 소프트웨어 기본값 — 세우기만 한 것들을 하나씩 짚는다. 자유도가 왜 \(n-1\) 인지부터 시작해서, 표준편차에는 불편성이 옮겨 가지 않는다는 데까지 간다.
보기 1. 자유도가 n-1인 이유. \(N(5, 2^2)\)에서 \(n = 5\)를 한 번 뽑아 \(\bar X\)에서 잰 편차와 참 평균 \(\mu\)에서 잰 편차를 나란히 적는다.
(1) 두 제곱합의 차이가 정확히 얼마인지 식으로 적으시오. 그 차이의 기댓값은 얼마인가.
(2) 출력에서 그 차이가 \(0.792\)로 나왔다. (1)이 말하는 값과 다른데, 어긋난 것인가.
풀이
(1) 해석적으로. 제곱을 펼치면 교차항이 정리되어 정확한 항등식이 나온다.
가운데 교차항 \(2(\bar X - \mu)\sum_i(X_i - \bar X)\)가 \(\sum_i (X_i - \bar X) = 0\) 때문에 통째로 사라진다. 출력의 "\(\texttt{Sum}(X_i - \bar X) = 0\) (always 0)" 줄이 바로 그 제약이고, 자유도가 \(n\)이 아니라 \(n-1\)인 까닭도 같은 한 줄이다. 편차 다섯 개 가운데 넷을 알면 다섯째가 자동으로 정해진다.
따라서 두 제곱합의 차이는
이다. 언제나 \(\bar X\) 쪽이 작거나 같다. \(\bar X\)가 제곱합을 최소로 만드는 점이기 때문이고, 등호는 \(\bar X = \mu\)일 때뿐이다.
그 차이의 기댓값은 \(\operatorname{Var}(\bar X) = \sigma^2/n\)에서
다. 평균적으로 정확히 \(\sigma^2\) 하나만큼 모자라고, 그 하나를 메우려고 \(n\)이 아니라 \(n-1\)로 나눈다.
(2) 한 표본의 값과 기댓값은 다르다. \(n(\bar X - \mu)^2 = \sigma^2 \cdot \frac{n(\bar X-\mu)^2}{\sigma^2}\)이고 둘째 인자가 \(\chi^2_1\)을 따르므로, 이 차이는 \(4\chi^2_1\)을 따르는 확률변수다. \(\chi^2_1\)은 중앙값이 \(0.455\)라 절반은 기댓값의 절반에도 못 미친다. 출력의 \(0.792\)는 \(\chi^2_1 = 0.198\)에 해당하고 그 아래쪽 확률이 \(0.344\)이므로, 세 번에 한 번쯤 나오는 평범한 값이다. 어긋난 것이 아니라 기댓값은 한 번의 표본에서 보이지 않는 양일 뿐이다.
출력을 한 줄씩 읽는다.
import numpy as np
def degrees_of_freedom_intuition(seed=42):
    """자유도가 왜 n이 아니라 n-1인지를 표본 하나로 눈에 보이게 한다."""
    rng = np.random.default_rng(seed)
    mu, sigma, n = 5.0, 2.0, 5      # n=5로 작게 잡아 다섯 줄을 다 볼 수 있게 한다
    sample = rng.normal(mu, sigma, n)
    x_bar = sample.mean()

    # 같은 자료에 대해 두 가지 편차를 계산한다.
    #   dev_xbar: 표본평균에서 잰 편차. 합이 **반드시 0**이다.
    #             다섯 개 중 넷을 알면 나머지 하나가 자동으로 정해지므로
    #             자유롭게 움직일 수 있는 것은 4개(= n-1)뿐이다.
    #   dev_mu  : 참 평균에서 잰 편차. 합이 0일 이유가 없다.
    dev_xbar = sample - x_bar
    dev_mu   = sample - mu

    # 아래 출력에서 SS(X̄) < SS(μ) 이고 그 차이가 정확히 n(X̄-μ)^2 이다.
    # 표본평균이 자기 자료에 "가장 가까운" 점이라 제곱합을 최소로 만들기 때문이며,
    # 이 체계적 축소를 되돌리는 것이 n-1로 나누는 일이다.

    for i in range(n):
        print(f"  X_{i+1}={sample[i]:.3f}  "
              f"X_i-X̄={dev_xbar[i]:.3f}  X_i-μ={dev_mu[i]:.3f}")

    print(f"\n  Sum(X_i - X̄) = {sum(dev_xbar):.6f}  (always 0)")
    print(f"  Sum(X_i - μ)  = {sum(dev_mu):.3f}  (not 0)")
    print(f"  SS(X̄) = {np.sum(dev_xbar**2):.3f}")
    print(f"  SS(μ)  = {np.sum(dev_mu**2):.3f}")
    print(f"  Difference = n·(X̄−μ)² = {n*(x_bar-mu)**2:.3f}")
degrees_of_freedom_intuition()
출력:
  X_1=5.609  X_i-X̄=1.008  X_i-μ=0.609
  X_2=2.920  X_i-X̄=-1.682  X_i-μ=-2.080
  X_3=6.501  X_i-X̄=1.899  X_i-μ=1.501
  X_4=6.881  X_i-X̄=2.279  X_i-μ=1.881
  X_5=1.098  X_i-X̄=-3.504  X_i-μ=-3.902

  Sum(X_i - X̄) = -0.000000  (always 0)
  Sum(X_i - μ)  = -1.991  (not 0)
  SS(X̄) = 24.923
  SS(μ)  = 25.715
  Difference = n·(X̄−μ)² = 0.792
네 줄이 (1)과 맞는다. \(\mathrm{SS}(\mu) - \mathrm{SS}(\bar X) = 25.715 - 24.923 = 0.792\)이고 마지막 줄의 \(n(\bar X - \mu)^2\)와 같다. \(\sum(X_i - \bar X)\)가 \(-0.000000\)으로 기계 오차만 남고, \(\sum(X_i - \mu) = -1.991\)은 \(0\)이 아니다. 실제로 \(\bar x = 5 - 1.991/5 = 4.6018\)이므로 \(5(4.6018-5)^2 = 0.7928\)로 셋째 자리까지 맞는다.
(2)를 반복 1만 번으로 확인한다.
import numpy as np
# 한 표본에서는 0.792 였다. 반복하면 그 평균이 sigma^2 = 4 로 가는가.
rng2 = np.random.default_rng(7)
diffs = []
for _ in range(10_000):
    s = rng2.normal(5.0, 2.0, 5)
    diffs.append(5 * (s.mean() - 5.0) ** 2)
diffs = np.array(diffs)
print(f"n(X̄-μ)² 의 평균   = {diffs.mean():.4f}   (이론 σ² = 4)")
print(f"           중앙값 = {np.median(diffs):.4f}   (이론 4 × 0.4549 = {4*0.45494:.4f})")
print(f"0.792 이하가 나올 비율 = {np.mean(diffs <= 0.792):.4f}   (이론 0.3440)")
출력:
n(X̄-μ)² 의 평균   = 4.0124   (이론 σ² = 4)
           중앙값 = 1.8324   (이론 4 × 0.4549 = 1.8198)
0.792 이하가 나올 비율 = 0.3434   (이론 0.3440)
평균이 \(4.0124\)로 \(\sigma^2 = 4\)를 맞힌다. 1만 번에서 이 평균의 표준오차가 \(\sqrt{2\sigma^4/10^4} = 0.0566\)이므로 \(0.22\) 표준오차 거리다.
그런데 중앙값은 \(1.83\)으로 평균의 절반도 되지 않는다. \(\chi^2_1\)이 \(0\) 근처에 몰려 있고 오른쪽으로 길게 끌리는 분포라 그렇다. 그래서 한 표본만 보면 "\(\sigma^2\)만큼 모자란다"는 말이 눈에 띄지 않고, 실제로 \(0.792\) 이하가 나올 확률이 \(34.4\%\)다.
보정이 \(n-1\)이라는 고정된 수인 까닭이 여기에 있다. 자료마다 모자란 양이 \(0\)에서 수십까지 들쭉날쭉한데, 그것을 자료별로 보정할 길은 없다(\(\mu\)를 모르니 \(n(\bar X-\mu)^2\)을 계산할 수 없다). 대신 평균적으로 정확히 맞도록 분모를 한 칸 줄인다. 불편성이 "한 번의 추정이 맞는다"가 아니라 "반복의 중심이 맞는다"라는 말의 뜻이 이 보기에 그대로 들어 있다.
두 제곱합을 잇는 핵심 항등식은 다음과 같다.
\(E[n(\bar{X} - \mu)^2] = \sigma^2\)이므로, \(\bar{X}\)로부터의 편차는 평균적으로 정확히 \(\sigma^2\)만큼 \(\mu\)로부터의 편차를 과소평가한다.
보기 2. 네 분포에서 확인하는 불편성. 모양이 전혀 다른 네 모집단(\(N(0,16)\), \(\text{Exp}(4)\), \(\text{Uniform}\), \(\chi^2_{16}\))에서 \(n = 20\)씩 뽑아 \(S^2\)을 20만 번 기록한다. 앞의 셋은 참 분산을 \(16\) 으로 맞추어 두었고 \(\chi^2_{16}\) 만 \(\sigma^2 = 2d = 32\) 다 — 그 어긋남이 아래 풀이에서 쓰인다.
(1) \(E[S^2] = \sigma^2\)이 모집단의 모양과 무관하게 성립하는 까닭을 적으시오.
(2) 네 줄의 "편향"이 각각 얼마만큼 흔들릴지 미리 구하고, 출력이 그 안에 드는지 판정하시오.
풀이
(1) 해석적으로. 증명의 뼈대는 항등식
하나이고, 양변의 기댓값을 취하면 \(n\sigma^2 - \sigma^2 = (n-1)\sigma^2\)이 된다. 이 계산은 5.1절의 증명 상자에 한 줄씩 적혀 있으므로 여기서 반복하지 않는다.
반복하지 않는 대신 무엇을 썼는지만 짚어 두자. 쓴 것은 두 가지다.
- \(E[(X_i - \mu)^2] = \sigma^2\) — 분산의 정의.
- \(\operatorname{Var}(\bar X) = \sigma^2/n\) — 독립성(independence).
분포의 모양은 어디에도 들어오지 않는다. 치우쳤든, 이산이든, 꼬리가 두껍든 분산만 유한하면 \(E[S^2] = \sigma^2\)이다. (뒤의 보기 3이 다루는 \(\chi^2\) 분포 결과는 사정이 전혀 다르다. 그쪽은 정규성이 꼭 필요하다.)
(2) 변동의 크기. 모의 편향의 표준오차는 \(\operatorname{sd}(S^2)/\sqrt B\)이고, \(S^2\)의 분산은 모집단의 4차 적률에 달려 있다.
여기서 \(\gamma_2\)가 초과첨도다. 불편성은 모양과 무관하지만 정밀도는 모양에 크게 달려 있다는 것이 요점이며, 네 모집단의 \(\gamma_2\)가 각각 \(0\), \(6\), \(-1.2\), \(12/16 = 0.75\)다.
| 모집단 | \(\sigma^2\) | \(\gamma_2\) | \(\operatorname{Var}(S^2)\) | 몬테카를로 표준오차 |
|---|---|---|---|---|
| \(N(0, 16)\) | \(16\) | \(0\) | \(26.95\) | \(0.0116\) |
| \(\text{Exp}(4)\) | \(16\) | \(6\) | \(103.75\) | \(0.0228\) |
| \(\text{Uniform}\) | \(16\) | \(-1.2\) | \(11.59\) | \(0.0076\) |
| \(\chi^2_{16}\) | \(32\) | \(0.75\) | \(146.19\) | \(0.0270\) |
모의실험과 맞춰 본다.
import numpy as np

def unbiasedness_across_distributions(n_sim=200_000, seed=42):
    """베셀 보정의 불편성이 모집단 모양과 무관함을 네 분포에서 확인한다."""
    rng = np.random.default_rng(seed)
    sigma = 4.0
    sigma2 = sigma**2
    n = 20

    # 모양이 전혀 다른 분포 넷을 준비하되 **참 분산이 얼마인지 알 수 있게** 맞춘다.
    #   Exp(scale=s)     의 분산은 s^2
    #   Uniform(0, 2s√3) 의 분산은 (2s√3)^2/12 = s^2
    #   Chi²(df=k)       의 분산은 2k
    # 베셀 보정의 불편성은 정규성을 전혀 요구하지 않으므로,
    # 네 경우 모두 편향이 0에 가깝게 나와야 한다.
    # (반면 뒤에 나오는 카이제곱분포 결과는 정규성이 꼭 필요하다.)
    distributions = {
        f'Normal(0, {sigma2})':    (lambda: rng.normal(0, sigma, n), sigma2),
        f'Exp(scale={sigma})':     (lambda: rng.exponential(sigma, n), sigma2),
        f'Uniform':                (lambda: rng.uniform(0, 2*sigma*np.sqrt(3), n), sigma2),
        f'Chi²(df={int(sigma2)})': (lambda: rng.chisquare(int(sigma2), n), 2*sigma2),
    }

    for name, (sampler, true_var) in distributions.items():
        s2_vals = np.array([np.var(sampler(), ddof=1) for _ in range(n_sim)])
        print(f"{name:<25} True σ²={true_var:.2f}  "
              f"E[S²]={s2_vals.mean():.4f}  Bias={s2_vals.mean()-true_var:.4f}")
unbiasedness_across_distributions()
출력:
Normal(0, 16.0)           True σ²=16.00  E[S²]=15.9995  Bias=-0.0005
Exp(scale=4.0)            True σ²=16.00  E[S²]=15.9970  Bias=-0.0030
Uniform                   True σ²=16.00  E[S²]=16.0088  Bias=0.0088
Chi²(df=16)               True σ²=32.00  E[S²]=32.0208  Bias=0.0208
(2)의 자로 재면 네 줄이 모두 들어온다.
| 모집단 | 모의 편향 | 몬테카를로 표준오차 | \(z\) |
|---|---|---|---|
| \(N(0, 16)\) | \(-0.0005\) | \(0.0116\) | \(-0.04\) |
| \(\text{Exp}(4)\) | \(-0.0030\) | \(0.0228\) | \(-0.13\) |
| \(\text{Uniform}\) | \(+0.0088\) | \(0.0076\) | \(+1.16\) |
| \(\chi^2_{16}\) | \(+0.0208\) | \(0.0270\) | \(+0.77\) |
네 줄 모두 \(1.2\) 표준오차 안이고, 어느 모집단에서도 왜도(skewness)의 흔적이 없다.
겉보기 수와 자를 뒤바꿔 읽지 않도록 조심해야 한다. 가장 큰 편향 \(0.0208\)은 \(\chi^2_{16}\)에서 나왔는데 자로 재면 \(0.77\)에 지나지 않고, 그보다 작은 \(0.0088\)이 균등분포에서는 \(1.16\)이다. 균등분포가 가장 정밀한 까닭은 초과첨도가 \(-1.2\)로 음수여서 꼬리가 짧기 때문이고, 지수분포(exponential distribution)가 가장 엉성해 보이지 않는 까닭은 \(\sigma^2\)이 같은 \(16\)이기 때문이다.
세 번째 열이 이 쪽에서 가장 쓸모 있는 수다. \(\operatorname{Var}(S^2)\)가 \(11.6\)에서 \(146\)까지 열세 배나 벌어진다. 모든 모집단에서 \(S^2\)이 똑같이 불편이지만, 똑같이 믿을 만하지는 않다. 분산을 추정할 때 4차 적률이 조용히 뒤에서 모든 것을 정하고 있다.
분포와 무관한 결과
\(E[S^2] = \sigma^2\)의 증명은 항등식 \(\sum(X_i - \bar{X})^2 = \sum(X_i - \mu)^2 - n(\bar{X} - \mu)^2\)과 기댓값의 선형성만 쓴다. 분산이 유한하다는 것 외에 분포에 대한 가정은 필요 없다.
보기 3. 카이제곱분포 확인. \(N(0, 3^2)\)에서 \(n = 5, 10, 25, 50\)씩 뽑아 \((n-1)S^2/\sigma^2\)을 10만 번 기록하고 \(\chi^2_{n-1}\) 밀도를 겹쳐 그린다.
(1) 이 통계량의 평균·분산·왜도를 \(n\)의 함수로 적으시오. 거기서 \(\operatorname{Var}(S^2)\)를 끌어내시오.
(2) 그림이 네 칸에서 어떻게 달라 보여야 하는지 (1)로 설명하고, 수로 확인하시오.
풀이
(1) 해석적으로. \(X_i \sim N(\mu,\sigma^2)\)이면 \((n-1)S^2/\sigma^2 \sim \chi^2_{n-1}\)이고, 자유도 \(k\)인 카이제곱의 적률은 잘 알려져 있다.
\(k = n-1\)을 넣으면 네 칸의 이론값이 바로 나온다.
| \(n\) | 평균 \(n-1\) | 분산 \(2(n-1)\) | 왜도 \(\sqrt{8/(n-1)}\) |
|---|---|---|---|
| \(5\) | \(4\) | \(8\) | \(1.4142\) |
| \(10\) | \(9\) | \(18\) | \(0.9428\) |
| \(25\) | \(24\) | \(48\) | \(0.5774\) |
| \(50\) | \(49\) | \(98\) | \(0.4041\) |
\(S^2\)으로 되돌리면 \(S^2 = \dfrac{\sigma^2}{n-1}\chi^2_{n-1}\)이므로
다. 불편성이 여기서는 덤으로 따라 나온다. 보기 2에서는 분포 가정 없이 힘들여 얻은 것을 정규성 하나로 공짜로 얻는 셈인데, 그 대신 정규가 아니면 이 줄은 통째로 쓸 수 없다.
(2) 그림이 어떻게 달라 보여야 하는가. 왜도가 \(\sqrt{8/(n-1)}\)이므로 \(n\)이 커지면 \(1/\sqrt n\) 속도로 대칭에 가까워진다. \(n = 5\) 칸은 왜도 \(1.41\)로 오른쪽으로 길게 끌리고, \(n = 50\) 칸은 \(0.40\)으로 거의 종 모양이어야 한다. 동시에 가로축의 범위가 \(0\)–\(20\)에서 \(0\)–\(100\)으로 옮겨 가고 넓어진다(\(\sigma\)가 약분되므로 \(\sigma = 3\)은 그림에 아무 영향도 주지 않는다).
그림을 그리면서 세 적률을 함께 잰다.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

def chi_squared_verification(sigma=3.0, n_sim=100_000, seed=42):
    """정규모집단에서 (n-1)S^2/sigma^2 이 카이제곱을 따름을 확인한다.

    앞 보기와 달리 여기서는 정규성이 꼭 필요하다. 불편성은 모든 분포에서
    성립하지만, 분포의 모양까지 알려면 모집단이 정규여야 한다.
    """
    rng = np.random.default_rng(seed)
    sample_sizes = [5, 10, 25, 50]

    fig, axes = plt.subplots(2, 2, figsize=(12, 10))
    print(f"{'n':>4} {'모의 평균':>9} {'n-1':>5} {'모의 분산':>9} {'2(n-1)':>7} "
          f"{'모의 왜도':>9} {'√(8/(n-1))':>11}")
    for ax, n in zip(axes.flat, sample_sizes):
        samples = rng.normal(0, sigma, (n_sim, n))
        s2 = np.var(samples, axis=1, ddof=1)
        # (n-1)S^2/sigma^2 을 만들면 sigma가 약분되어 사라진다.
        # 그래서 이 통계량의 분포는 자유도 n-1 하나로만 결정되며,
        # sigma를 몰라도 이것으로 검정과 신뢰구간을 만들 수 있다.
        # 이런 성질을 갖는 양을 추축량(pivotal quantity)이라 한다.
        chi2_vals = (n - 1) * s2 / sigma**2

        ax.hist(chi2_vals, bins=80, density=True, alpha=0.6, color='steelblue')
        x = np.linspace(0, stats.chi2.ppf(0.999, n-1), 200)
        ax.plot(x, stats.chi2.pdf(x, n-1), 'r-', linewidth=2, label=f'chi²(df={n-1})')
        ax.set_title(f'n = {n}')
        ax.legend()
        # 눈으로 겹쳐 보는 대신 세 적률을 이론값과 맞춰 둔다.
        print(f"{n:>4} {chi2_vals.mean():>9.4f} {n-1:>5} {chi2_vals.var(ddof=1):>9.4f} {2*(n-1):>7} "
              f"{stats.skew(chi2_vals):>9.4f} {np.sqrt(8/(n-1)):>11.4f}")
    plt.suptitle('(n-1)S²/σ² ~ chi²(n-1) for Normal Data')
    plt.tight_layout()
    plt.show()
chi_squared_verification()
출력:
   n     모의 평균   n-1     모의 분산  2(n-1)     모의 왜도  √(8/(n-1))
   5    4.0037     4    8.0681       8    1.4272      1.4142
  10    9.0012     9   18.0701      18    0.9415      0.9428
  25   23.9858    24   47.6345      48    0.5643      0.5774
  50   48.9677    49   97.7039      98    0.4161      0.4041
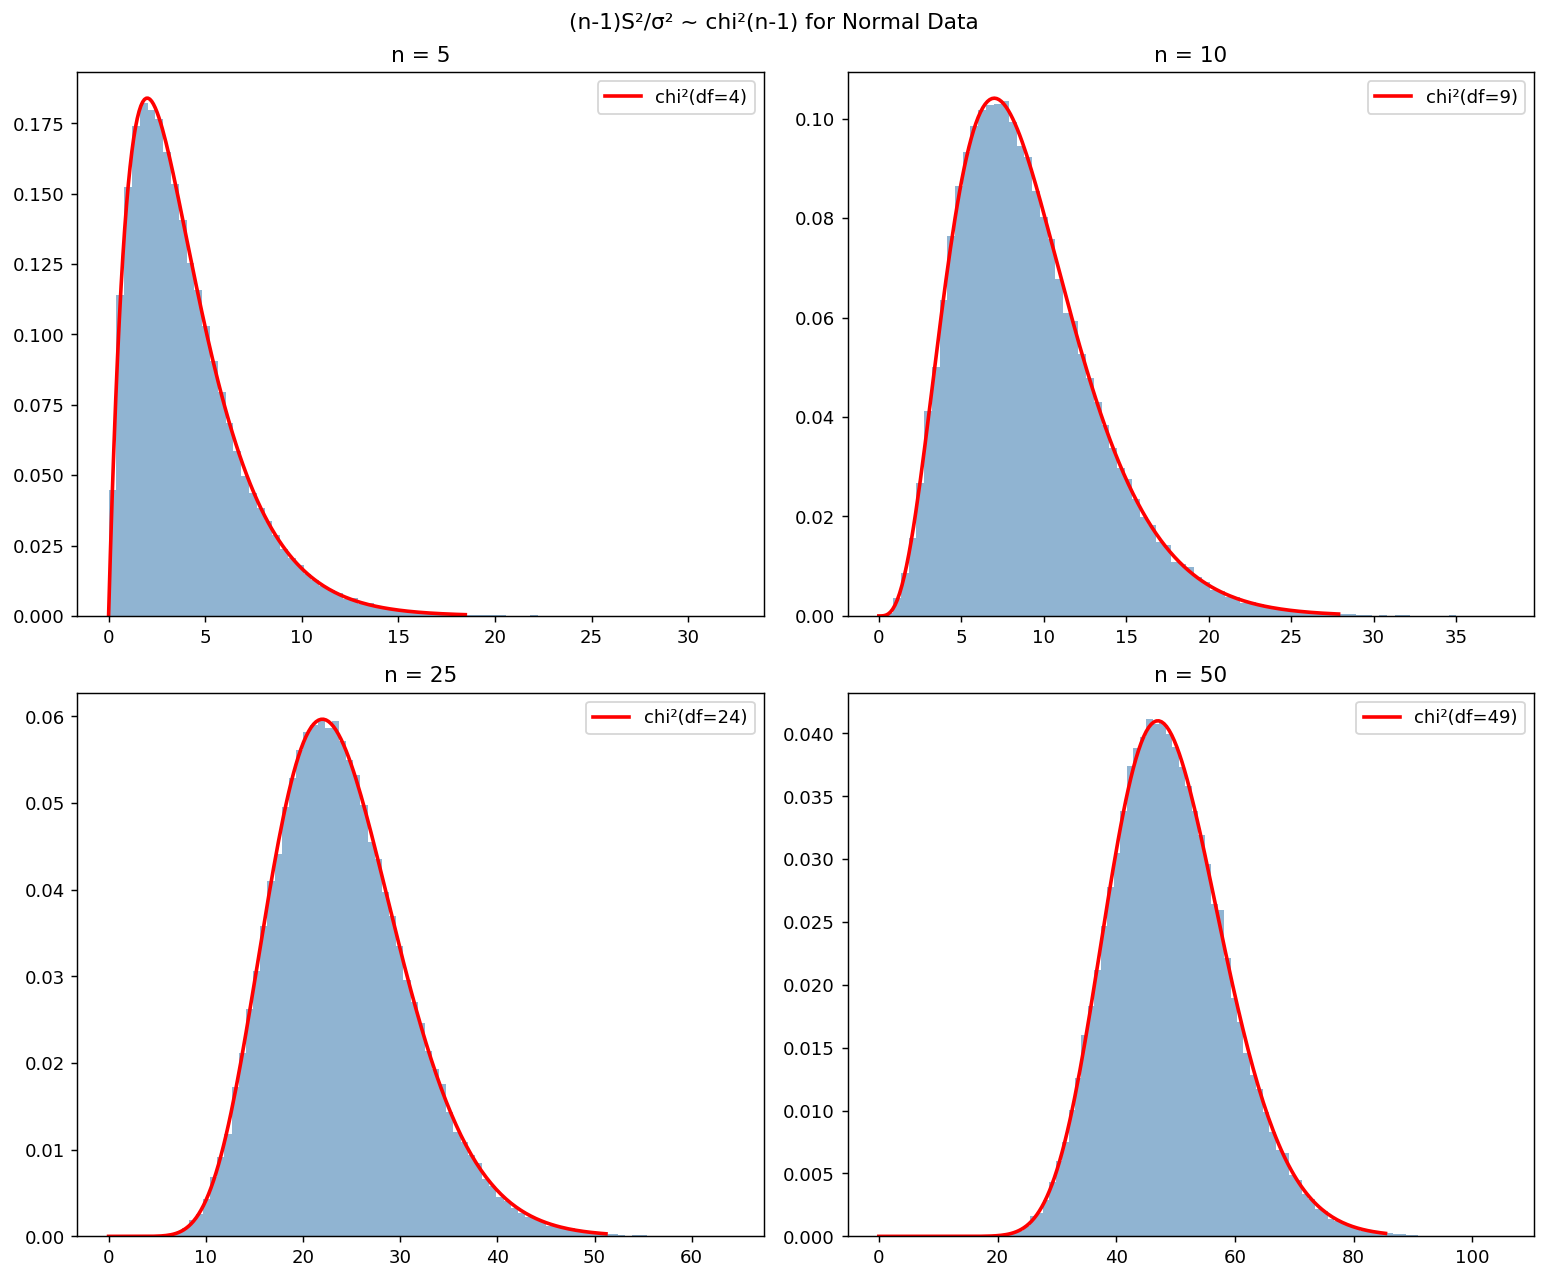
열두 칸이 모두 (1)과 맞는다. 평균은 \(4.0037\), \(9.0012\), \(23.9858\), \(48.9677\)로 \(4\), \(9\), \(24\), \(49\) 둘레에 있다. 10만 번에서 평균의 몬테카를로(Monte Carlo) 표준오차가 \(\sqrt{2(n-1)/10^5}\)이므로 \(n = 50\)에서 \(0.031\)이고, \(48.9677\)은 \(1.0\) 표준오차 거리다.
분산은 \(8.07\), \(18.07\), \(47.63\), \(97.70\)으로 \(8\), \(18\), \(48\), \(98\) 둘레다. 분산의 상대 몬테카를로 오차가 \(\sqrt{2/10^5} = 0.45\%\)인데(카이제곱은 정규보다 꼬리가 두꺼워 실제로는 이보다 조금 크다) 가장 멀리 간 \(n = 50\)의 \(-0.30\%\)도 그 안이다.
왜도 열이 가장 또렷하다. \(1.4272 \to 0.9415 \to 0.5643 \to 0.4161\)이 이론값 \(1.4142 \to 0.9428 \to 0.5774 \to 0.4041\)을 따라간다. 10만 번에서 왜도의 표준오차가 \(\sqrt{6/10^5} = 0.0077\)이므로 네 불일치가 각각 \(+1.7\), \(-0.2\), \(-1.7\), \(+1.5\) 표준오차다.
그림에서도 이 수가 그대로 보인다. 왼쪽 위 칸(\(n=5\))은 왼쪽 벽에 붙어 오른쪽으로 길게 끌리고, 오른쪽 아래 칸(\(n=50\))은 거의 대칭인 종 모양이다. 네 칸 모두 붉은 곡선이 히스토그램 위에 정확히 얹혀 있다.
\(\sigma = 3\)이 네 칸 어디에도 나타나지 않는다는 점이 중요하다. \((n-1)S^2/\sigma^2\)에서 \(\sigma\)가 약분되어 분포가 자유도 하나로만 정해지기 때문이고, 이것이 코드 주석이 말하는 추축량의 뜻이다. 모르는 \(\sigma\)가 통계량의 분포에서 사라지므로 \(\sigma\)를 모른 채로도 구간을 만들 수 있다.
카이제곱분포로부터 곧바로 다음을 얻는다.
보기 4. 표본평균(sample mean)과 표본분산의 독립성. \(N(5, 3^2)\)와 \(\text{Exp}(\text{scale} = 3)\)에서 \(n = 20\)씩 뽑아 \(\operatorname{corr}(\bar X, S^2)\)를 10만 번 반복으로 잰다.
(1) \(\operatorname{Cov}(\bar X, S^2)\)를 일반 분포에 대해 유도하시오. 거기서 정규와 지수의 상관계수를 수로 예측하시오.
(2) 출력과 맞추시오. 상관이 \(0\)인 것과 독립인 것은 같은 말인가.
풀이
(1) 해석적으로. 평균을 \(0\)으로 옮겨도 두 통계량이 바뀌지 않으므로 \(\mu = 0\)으로 두자. \(\operatorname{Cov}(\bar X, S^2) = E[\bar X S^2]\)이고, 보기 1의 항등식에서 \((n-1)S^2 = \sum_i X_i^2 - n\bar X^2\)이므로
이다. 두 항을 따로 센다. 앞 항은 \(\bar X = \frac1n\sum_j X_j\)를 넣어 펼치면 \(j = i\)인 \(n\)개 항만 \(E[X^3] = \mu_3\)를 남기고 나머지는 독립성과 \(E[X] = 0\)에서 사라지므로 \(\frac1n \cdot n\mu_3 = \mu_3\)다. 뒤 항은 \(\bar X\)의 3차 중심적률이 \(\mu_3/n^2\)이므로 \(n \cdot \mu_3/n^2 = \mu_3/n\)이다. 따라서
공분산이 모집단의 3차 중심적률 하나로 정해진다. 그러므로
- 대칭분포(\(\mu_3 = 0\)): 언제나 \(\operatorname{Cov}(\bar X, S^2) = 0\). 정규뿐 아니라 균등·\(t\)·라플라스도 그렇다.
- 치우친 분포: \(\mu_3 \ne 0\)이므로 상관이 남는다. 지수분포는 \(\mu_3 = 2\theta^3 > 0\)이라 양의 상관이고, 평균이 큰 표본일수록 산포도 크다는 뜻이다.
상관계수를 수로 내려면 두 분산이 더 필요하다. \(\operatorname{Var}(\bar X) = \sigma^2/n\)이고 보기 2의 \(\operatorname{Var}(S^2)\) 식을 쓴다. \(\theta = 3\)인 지수분포는 \(\sigma^2 = 9\), \(\mu_3 = 2\theta^3 = 54\), \(\mu_4 = 9\sigma^4 = 729\)이므로 \(n = 20\)에서
정규는 \(\mu_3 = 0\)이므로 정확히 \(0\)이다.
(2) 수치적으로.
def independence_xbar_s2(sigma=3.0, n_sim=100_000, seed=42):
    """X-bar 와 S^2 의 독립이 정규분포만의 성질임을 보인다.

    t 통계량은 분자에 X-bar, 분모에 S 를 둔다. 둘이 독립이라야 그 비의
    분포를 t 로 말할 수 있다. 정규모집단이 아니면 이 전제가 깨진다.
    """
    rng = np.random.default_rng(seed)
    n = 20

    # 정규모집단: 상관이 0 이다. 게다가 정규에서는 무상관이 곧 독립이다.
    samp_n = rng.normal(5, sigma, (n_sim, n))
    xbar_n = samp_n.mean(axis=1)
    s2_n   = np.var(samp_n, axis=1, ddof=1)
    corr_n = np.corrcoef(xbar_n, s2_n)[0, 1]

    # 지수모집단: 상관이 0 이 아니다. 평균이 큰 표본일수록 산포도 크다.
    samp_e = rng.exponential(sigma, (n_sim, n))
    xbar_e = samp_e.mean(axis=1)
    s2_e   = np.var(samp_e, axis=1, ddof=1)
    corr_e = np.corrcoef(xbar_e, s2_e)[0, 1]

    print(f"Normal:      Corr(X̄, S²) = {corr_n:.6f}  (≈ 0)")
    print(f"Exponential: Corr(X̄, S²) = {corr_e:.6f}  (≠ 0)")
independence_xbar_s2()
출력:
Normal:      Corr(X̄, S²) = 0.005076  (≈ 0)
Exponential: Corr(X̄, S²) = 0.700128  (≠ 0)
지수 쪽 예측이 셋째 자리까지 맞는다. \(0.700128\) 대 \(0.7025\)다. 10만 번에서 상관계수의 표준오차가 \((1 - r^2)/\sqrt{B} = 0.51/316 = 0.0016\)이므로 \(-1.5\) 표준오차 거리다. 정규 쪽 \(0.005076\)도 참값 \(0\)에서 \(1.6\) 표준오차(\(1/\sqrt{B} = 0.0032\)) 안이다.
(2)의 둘째 물음이 이 보기의 핵심이다. 상관이 \(0\)인 것과 독립인 것은 같은 말이 아니다. 상관은 선형 관계만 재므로, 상관이 \(0\)이어도 얼마든지 세게 종속일 수 있다. 위 유도가 보인 것은 "대칭분포이면 \(\operatorname{Cov}(\bar X, S^2) = 0\)"뿐이고, 그것은 균등분포에서도 \(t\) 분포에서도 성립한다. 그런데 \(\bar X\)와 \(S^2\)이 실제로 독립인 것은 정규분포뿐이다.
까닭은 기하에 있다. 정규표본 \(\mathbf X\)를 \(n\)차원 벡터로 보면 그 분포가 회전불변이고, \(\bar X\)는 \(\mathbf 1\) 방향의 사영, \(S^2\)은 그에 직교하는 \((n-1)\)차원 부분공간에서의 길이다. 회전불변인 분포에서는 직교하는 두 성분이 독립이 되며, 이것이 코크런 정리이고 아래 연습문제 1의 분해이기도 하다. 직교가 곧 독립이 되는 분포는 정규뿐이다.
그래서 균등분포처럼 대칭이지만 정규가 아닌 모집단에서는 상관이 \(0\)으로 나오는데도 \(t\) 통계량이 정확히 \(t\) 분포를 따르지 않는다. \(t\) 분포의 유도에 필요한 것은 무상관이 아니라 독립이다.
왜 중요한가
\(\bar{X}\)와 \(S^2\)의 독립성이 \(t\)-분포의 유도를 가능하게 한다. \(t\)-통계량 \(T = \frac{\bar{X} - \mu}{S/\sqrt{n}}\)은 (정규와 관련된) \(\bar{X} - \mu\)와 (카이제곱과 관련된) \(S\)의 비이다. 독립성이 이 비가 \(t\)-분포를 따르도록 보장한다.
보기 5. 표준편차의 편향과 보정상수. \(N(0, 3^2)\)에서 \(n\)을 \(3\)에서 \(500\)까지 바꾸며 \(S\)를 20만 번 기록하고 \(c_4\)로 나눈 값과 견준다.
(1) \(E[S] = c_4(n)\,\sigma\)를 보기 3의 카이제곱 결과로부터 유도하시오. \(n\)이 크면 편향이 얼마나 빨리 사라지는가.
(2) 출력의 마지막 줄에서 \(c_4 = \texttt{nan}\)이 나왔다. \(n = 500\)에서 \(c_4\)가 존재하지 않는 것인가.
풀이
(1) 해석적으로. 보기 3에서 \((n-1)S^2/\sigma^2 \sim \chi^2_{n-1}\)이므로
이다. 자유도 \(k\)인 카이제곱의 제곱근, 곧 카이분포의 평균은 밀도를 직접 적분해 얻는다.
적분은 \(x^{(k+1)/2 - 1}\)을 감마적분으로 읽으면 끝난다. \(k = n-1\)을 넣으면
다. \(c_4 < 1\)임은 적분을 하지 않고도 알 수 있다. \(\sqrt{\cdot}\)가 엄밀히 오목하고 \(S^2\)이 상수가 아니므로 옌센 부등식이 엄밀한 부등호로 성립한다.
\(S\)는 언제나 \(\sigma\)를 과소추정한다. 그리고 이것은 "불편성이 변환에 보존되지 않는다"는 일반 사실의 한 보기다. \(S^2\)이 \(\sigma^2\)에 불편이어도 \(g(S^2)\)이 \(g(\sigma^2)\)에 불편일 까닭은 \(g\)가 선형일 때뿐이다.
편향이 사라지는 속도는 감마함수의 점근전개가 준다.
뒤의 간단한 꼴이 실용적으로 아주 정확하다. \(n = 10\)에서 \(0.972973\) 대 참값 \(0.972659\)이고, \(n = 100\)부터는 소수 다섯째 자리까지 맞는다. 편향이 \(1/(4n)\)으로 줄므로 \(n = 25\)면 \(1\%\), \(n = 250\)이면 \(0.1\%\)다.
이 \(c_4\)는 4.2절 \(t\) 분포에 나오는 \(\Gamma\) 비와 같은 식구다. \(t\) 통계량이 \(\bar X\)를 \(S\)로 나누어 만들어지므로, \(S\)의 분포에서 나온 감마 비가 \(t\) 밀도의 상수로 그대로 옮겨 간다.
(2) 수치적으로.
from scipy.special import gamma as gamma_func

def std_deviation_bias(sigma=3.0, n_sim=200_000, seed=42):
    """S^2 은 불편인데 S 는 왜 불편이 아닌지, 보정상수 c4 까지 확인한다."""
    rng = np.random.default_rng(seed)
    sample_sizes = [3, 5, 10, 20, 50, 100, 500]

    for n in sample_sizes:
        samples = rng.normal(0, sigma, (n_sim, n))
        # S^2 은 불편이지만 그 제곱근 S 는 불편이 아니다.
        # 제곱근이 오목함수라 옌센 부등식 E[√X] < √E[X] 가 성립하기 때문이며,
        # 따라서 S 는 sigma 를 **과소추정**한다.
        # "불편성은 변환에 대해 보존되지 않는다"는 일반 원리의 사례다.
        s = np.std(samples, axis=1, ddof=1)
        c4 = np.sqrt(2 / (n - 1)) * gamma_func(n / 2) / gamma_func((n - 1) / 2)
        print(f"n={n:>4}  E[S]={s.mean():.4f}  σ={sigma:.4f}  "
              f"Bias={s.mean()-sigma:.4f}  c₄={c4:.4f}  E[S/c₄]={(s/c4).mean():.4f}")
std_deviation_bias()
출력:
n=   3  E[S]=2.6576  σ=3.0000  Bias=-0.3424  c₄=0.8862  E[S/c₄]=2.9987
n=   5  E[S]=2.8190  σ=3.0000  Bias=-0.1810  c₄=0.9400  E[S/c₄]=2.9990
n=  10  E[S]=2.9169  σ=3.0000  Bias=-0.0831  c₄=0.9727  E[S/c₄]=2.9989
n=  20  E[S]=2.9599  σ=3.0000  Bias=-0.0401  c₄=0.9869  E[S/c₄]=2.9991
n=  50  E[S]=2.9844  σ=3.0000  Bias=-0.0156  c₄=0.9949  E[S/c₄]=2.9996
n= 100  E[S]=2.9922  σ=3.0000  Bias=-0.0078  c₄=0.9975  E[S/c₄]=2.9998
n= 500  E[S]=2.9987  σ=3.0000  Bias=-0.0013  c₄=nan  E[S/c₄]=nan
여섯 줄은 (1)과 깨끗하게 맞는다. \(E[S]\)가 \(2.6576 \to 2.9987\)로 올라오고, 이론값 \(c_4\sigma\)가 \(0.886227 \times 3 = 2.6587\), \(0.939986 \times 3 = 2.8200\), \(\ldots\)로 각각 소수 둘째 자리까지 맞는다. \(E[S/c_4]\) 열은 여섯 줄 모두 \(2.9987\)–\(2.9998\)로 \(\sigma = 3\)을 맞힌다. \(S/c_4\)가 \(\sigma\)의 불편추정량이라는 것이 확인되었다.
마지막 줄의 \(\texttt{nan}\)은 통계가 아니라 부동소수점의 사고다. \(c_4(500)\)은 멀쩡히 존재하고 값이 \(0.999499\)다. 코드가 \(\Gamma(250)\)을 직접 계산하려다 넘친 것뿐이다.
# Γ 를 직접 부르지 말고 로그감마의 차를 지수로 되돌린다.
from scipy.special import gammaln

def c4_safe(n):
    return np.sqrt(2 / (n - 1)) * np.exp(gammaln(n / 2) - gammaln((n - 1) / 2))

print(f"{'n':>5} {'gamma 로':>10} {'gammaln 로':>11} {'4(n-1)/(4n-3)':>14}")
for n in (3, 20, 100, 342, 343, 344, 500):
    direct = np.sqrt(2 / (n - 1)) * gamma_func(n / 2) / gamma_func((n - 1) / 2)
    print(f"{n:>5} {direct:>10.6f} {c4_safe(n):>11.6f} {4*(n-1)/(4*n-3):>14.6f}")
print(f"Γ(250) 의 자릿수 = {gammaln(250)/np.log(10):.0f}, "
      f"float64 가 담을 수 있는 자릿수 = 308")
출력:
    n    gamma 로   gammaln 로  4(n-1)/(4n-3)
    3   0.886227    0.886227       0.888889
   20   0.986934    0.986934       0.987013
  100   0.997478    0.997478       0.997481
  342   0.999267    0.999267       0.999267
  343   0.999269    0.999269       0.999270
  344        inf    0.999271       0.999272
  500        nan    0.999499       0.999499
Γ(250) 의 자릿수 = 490, float64 가 담을 수 있는 자릿수 = 308
\(n = 343\)까지는 멀쩡하다가 \(344\)에서 갑자기 무너진다. \(\Gamma(x)\)는 \(x \approx 171.6\)에서 float64의 한계 \(1.8 \times 10^{308}\)을 넘으므로, \(n/2 > 171.6\) 곧 \(n > 343\)에서 분자가 \(\infty\)가 된다. \(n = 344\)에서는 분자만 넘쳐 \(\infty\)가 나오고, \(n = 500\)에서는 분모도 함께 넘쳐 \(\infty/\infty = \texttt{nan}\)이 된다. \(\Gamma(250)\)은 자릿수가 \(490\)이라 담을 그릇이 없을 뿐 값이 없는 것이 아니다.
고치는 법은 한 줄이다. 큰 수의 비를 구할 때는 로그에서 빼고 지수로 되돌린다. \(\exp(\ln\Gamma(a) - \ln\Gamma(b))\)는 중간에 \(10^{490}\)을 만들지 않으므로 넘칠 일이 없다. 셋째 열의 간단한 근사 \(4(n-1)/(4n-3)\)도 \(n \ge 100\)에서는 소수 다섯째 자리까지 같으니, 급할 때는 그것으로도 충분하다.
그리고 이 사고가 조용하다는 점이 가장 나쁘다. \(\texttt{nan}\)은 예외를 던지지 않고 표 한 칸에 앉아 있다가, 그 값으로 나눈 결과까지 \(\texttt{nan}\)으로 물들였다. 여섯 줄이 맞았다고 일곱째 줄을 믿으면 안 된다는 것이 보기 6(소프트웨어 기본값)과 함께 읽을 교훈이다.
편향은 작은 표본에서 가장 크다
\(n = 3\)이면 \(c_4 \approx 0.886\)이므로 \(E[S] \approx 0.886\sigma\) — 표준편차를 약 11% 과소추정한다. \(n = 50\)이면 편향이 0.5% 미만이다.
그림으로 보는 통계학 1. 전화국 기술부장이 퇴근하고 쓴 부등식
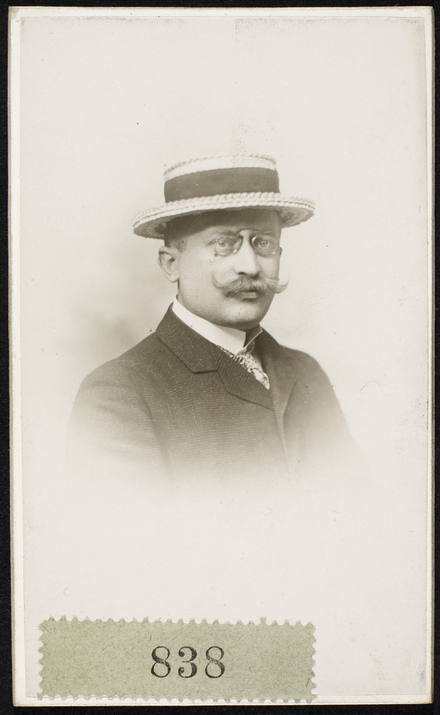
요한 루드비 빌헬름 발데마르 옌센(\(1859\)–\(1925\)). 덴마크 왕립도서관 소장 카드 사진으로, 아래 띠에 소장 번호 \(838\) 이 찍혀 있다(그림에서 직접 읽었다). (Theodor Vilhelm Rieger 촬영, Wikimedia Commons, PD-Denmark50)
방금 \(E[\sqrt{S^{2}}] < \sqrt{E[S^{2}]}\) 를 적는 데 쓴 것이 옌센 부등식이다. 눈여겨볼 것은 \(\sqrt{\cdot}\) 의 도함수를 한 번도 쓰지 않았다는 점이다. 볼록(또는 오목)을 이계도함수로 정의하지 않고 「두 점을 잇는 현이 곡선보다 위에 있다」로 정의하면 미분이 아예 없어도 뜻이 통하기 때문이다. 이렇게 적는 쪽을 고른 사람이 사진의 옌센이다.
그리고 그는 수학자가 아니었다. \(1881\) 년부터 \(1924\) 년까지 코펜하겐 전화회사에서 일했고 \(1890\) 년에 기술부장이 되었다. 대학에 자리를 얻은 적이 한 번도 없고, 높은 수학은 혼자 익혔다. 지금 그의 이름이 붙은 부등식도, \(1899\) 년에 내놓은 복소해석의 공식도 모두 일과가 끝난 뒤에 쓴 것이다.
그가 그 꼴을 고른 값은 점을 늘릴 때 돌아온다. 현이 위에 있다는 조건을 점 두 개가 아니라 여러 개로 늘리면
가 되고, 「평균을 넣은 값 \(\le\) 값의 평균」 한 줄이 된다. 점을 더 늘려 분포 전체로 가면 \(f(E[X])\le E[f(X)]\) 이고, \(f\) 가 오목이면 부등호가 뒤집혀 위의 \(E[\sqrt{S^{2}}] < \sqrt{E[S^{2}]}\) 가 된다. \(S\) 가 \(\sigma\) 를 아래로 치우쳐 재는 까닭이 이 한 줄이다 — 분모를 \(n-1\) 로 고쳐도 제곱근을 씌우는 순간 다시 편향이 들어오고, 그래서 \(c_4\) 라는 또 하나의 보정이 따로 필요하다.
이 한 줄이 품는 것이 많다. \(f(x)=-\log x\) 로 두면 양변에 붙은 음의 로그를 벗기면서 부등호가 뒤집혀 가중 기하평균 \(\le\) 가중 산술평균, 곧 산술–기하 평균 부등식이 그대로 나온다. 무게와 수를 이십만 벌 난수로 뽑아 확인해 보았는데 어긋나는 경우가 한 번도 없었다. \(x=(1,\ 4,\ 9)\) 를 고르게 섞으면 기하평균 \(3.3019\), 산술평균 \(4.6667\) 이다.
볼록을 「굽은 방향」이 아니라 「현과 곡선의 위아래」로 적어 두면, 미분할 수 없는 함수에도 그대로 쓸 수 있고 점을 몇 개로 늘려도 식이 그대로 간다. 볼록을 굳이 그 꼴로 적는 까닭이고, 전화국에서 일하던 사람이 남긴 것이 그 꼴이다.
확인한 곳 — Wikipedia 「Johan Jensen (mathematician)」 — 본명과 생몰(\(1859\)-\(05\)-\(08\) ~ \(1925\)-\(03\)-\(05\)), 「\(1881\) 년부터 \(1924\) 년까지 코펜하겐 전화회사의 기술자였고 \(1890\) 년에 기술부장이 되었다」, 학계 자리를 갖지 않고 높은 수학을 혼자 익혔다는 것 · 옌센 공식의 연도는 그 전기 문서가 「\(1915\)」라 적지만 논문 자체는 \(1899\) 년이어서 원본을 따랐다 — Acta Mathematica \(22\)(\(1899\)), \(359\)–\(364\) 스캔 · Commons 파일 쪽 — 촬영자와 덴마크 왕립도서관 소장, 라이선스 틀은 PD-Denmark50 + PD-US · 이십만 벌의 난수 확인과 두 평균값은 직접 계산해 맞추어 보았다

보기 6. 소프트웨어 기본값의 함정. 자료 \(\{2, 4, 4, 4, 5, 5, 7, 9\}\)를 np.var 의 기본값과 ddof=1 로 각각 요약한다.
(1) 두 값을 손으로 구하시오. 분산에서 몇 퍼센트, 표준편차에서 몇 퍼센트 차이가 나는가.
(2) 그 차이가 \(n\)에 따라 어떻게 줄어드는지 적고, 몇 개부터 무시해도 되는지 판단하시오.
풀이
(1) 해석적으로. \(n = 8\)이고 합이 \(2+4+4+4+5+5+7+9 = 40\)이므로 \(\bar x = 5\)다. 제곱합은
이고, 분모만 바꾸면 된다.
두 값의 비는 언제나 \(\dfrac{n}{n-1}\)이다. 여기서는 \(8/7 = 1.1429\)이므로 분산이 \(14.3\%\) 차이 난다. 표준편차는 그 제곱근이므로
로 \(6.9\%\) 차이다. 제곱근을 거치면 차이가 대략 절반으로 줄어든다.
(2) \(n\)에 따른 감소. 상대 차이가
이므로 \(1/n\)로 줄어든다. \(n = 8\)에서 \(14.3\%\)·\(6.9\%\), \(n = 30\)에서 \(3.4\%\)·\(1.7\%\), \(n = 100\)에서 \(1.0\%\)·\(0.5\%\), \(n = 1000\)에서 \(0.1\%\)·\(0.05\%\)다.
"몇 개부터 무시해도 되는가"에는 보편적인 답이 없다. 기준은 \(n\)이 아니라 그 차이가 다른 불확실성에 견주어 작은가여야 한다. 보기 5의 \(c_4 \approx 1 - 1/(4n)\)에서 \(\operatorname{Var}(S) = \sigma^2(1 - c_4^2) \approx \sigma^2/(2n)\), 곧 \(S\) 자체의 상대 표준오차가 정규자료에서 대략 \(1/\sqrt{2n}\)이므로, 두 값을 견주면
로 언제나 \(S\) 자체의 변동보다 작다. \(n = 8\)에서도 \(6.9\%\) 대 \(25\%\)다. 그러니 한 번의 추정값만 놓고 보면 어느 쪽을 써도 큰일이 나지 않는다.
문제는 다른 데 있다. 두 도구가 같은 자료에 다른 수를 내놓으면 결과를 재현할 수 없고, \(n\)으로 나눈 값을 여러 자료에 걸쳐 반복해 쓰면 체계적으로 낮은 쪽으로 쌓인다. 변동은 평균 내면 지워지지만 편향은 지워지지 않는다. 그래서 답은 "\(n\)이 작을 때만 조심하라"가 아니라 "언제나 ddof 를 명시하라"다.
코드로 확인한다.
import numpy as np

# numpy 와 pandas 의 기본값이 서로 다르다는 것이 여기서 걸리는 지점이다.
# np.var 는 ddof=0 (n으로 나눔), pandas 의 .var() 는 ddof=1 이 기본이다.
# 같은 자료를 두 도구로 요약하면 다른 숫자가 나오는 흔한 함정이다.
data = np.array([2.0, 4.0, 4.0, 4.0, 5.0, 5.0, 7.0, 9.0])
n = len(data)

print(f"np.var(data)          = {np.var(data):.4f}  <- divides by n={n}  (BIASED)")
print(f"np.var(data, ddof=1)  = {np.var(data, ddof=1):.4f}  <- divides by n-1={n-1}  (UNBIASED)")
출력:
np.var(data)          = 4.0000  <- divides by n=8  (BIASED)
np.var(data, ddof=1)  = 4.5714  <- divides by n-1=7  (UNBIASED)
(1)의 두 값이 그대로 나왔다. 이 자료는 \(\texttt{ddof=0}\) 쪽이 \(4\)로 딱 떨어지게 꾸며져 있어 교과서 예제로 자주 쓰이는데, 그 깔끔한 \(4\)가 바로 편향된 쪽이라는 점이 얄궂다.
# 두 분모의 차이를 n 에 따라 적고, S 자체의 변동과 견준다.
print(f"{'n':>6} {'분산 차이':>9} {'표준편차 차이':>12} {'S 의 상대 표준오차':>16}")
for n in (8, 30, 100, 1000):
    print(f"{n:>6} {(n/(n-1)-1)*100:>8.2f}% {(np.sqrt(n/(n-1))-1)*100:>11.2f}% "
          f"{1/np.sqrt(2*n)*100:>15.1f}%")
출력:
     n     분산 차이      표준편차 차이      S 의 상대 표준오차
     8    14.29%        6.90%            25.0%
    30     3.45%        1.71%            12.9%
   100     1.01%        0.50%             7.1%
  1000     0.10%        0.05%             2.2%
네 줄 모두 마지막 열이 가장 크다. \(n = 8\)에서 두 분모의 차이가 \(6.9\%\)인데 \(S\) 자체는 \(25\%\)씩 흔들리고, \(n = 1000\)에서도 \(0.05\%\) 대 \(2.2\%\)다. 비가 \(1/\sqrt{2n}\)이므로 \(n\)이 커질수록 오히려 더 벌어진다. 한 번의 값만 보면 분모 선택은 언제나 잡음에 묻힌다.
그러니 \(\texttt{ddof}\) 를 명시해야 하는 이유는 "그 수가 많이 달라서"가 아니라 "달라졌다는 사실을 아무도 알려 주지 않아서"다.
분모를 항상 확인하라
NumPy의 기본값은 ddof=0(편향)인 반면 R과 pandas의 기본값은 ddof=1(불편)이다. NumPy로 표본분산을 계산할 때는 항상 ddof=1을 명시하라.
보기 7. 금융 응용 — 추적오차. 참 월별 추적오차가 \(1\%\)인 펀드의 \(3\)년치(\(n = 36\)) 초과수익률로 연율화 추적오차를 추정하는 일을 5만 번 반복하고, 분모를 \(n\)으로 둘 때와 \(n-1\)로 둘 때를 견준다.
(1) 두 추정량의 기댓값·편향·표준편차·평균제곱오차를 모두 해석적으로 구하시오.
(2) 출력에서 편향은 \(\texttt{ddof=1}\) 쪽이 세 배 작은데 RMSE 는 두 쪽이 \(0.413\%\)로 같다. 우연인가.
풀이
(1) 해석적으로. 추정량이 둘 다 \(S\)의 상수배다. \(\texttt{ddof=1}\) 쪽을 \(S\)라 하면
이므로, 둘을 한꺼번에 \(a S\)로 두고 \(a\)만 다르게 하면 된다. 여기서 \(a = 1\) 또는 \(a = \sqrt{35/36} = 0.986013\)이다. 연율화는 \(\sqrt{12}\)를 곱하는 것이고 참값은 \(\sigma_a = 0.01\sqrt{12} = 3.4641\%\)다.
보기 5에서 \(E[S] = c_4\sigma\)이고 보기 2에서 \(E[S^2] = \sigma^2\)이므로
다. 편향과 평균제곱오차를 한 줄로 묶으면 깔끔한 꼴이 나온다.
\(a\)가 \(c_4\)에서 얼마나 떨어져 있는지만 보는 식이다. \(n = 36\)에서 \(c_4(36) = 0.992884\)이므로
| 배수 \(a\) | \(E[\widehat{\mathrm{TE}}]\) | 편향 | \(\operatorname{sd}\) | RMSE |
|---|---|---|---|---|
| \(\sqrt{35/36} = 0.986013\) (\(\texttt{ddof=0}\)) | \(3.391\%\) | \(-0.073\%\) | \(0.407\%\) | \(0.413\%\) |
| \(1\) (\(\texttt{ddof=1}\)) | \(3.439\%\) | \(-0.025\%\) | \(0.413\%\) | \(0.413\%\) |
| \(c_4 = 0.992884\) (MSE 최소) | \(3.415\%\) | \(-0.049\%\) | \(0.410\%\) | \(0.413\%\) |
(2)의 답이 이 표 안에 있다. 우연이 아니다. MSE 식이 \((a - c_4)^2\)에만 달려 있고
이므로 \(c_4\)가 두 후보의 거의 정확한 한가운데에 있다. \(n = 36\)에서 재면 \((1 - c_4)^2 = 5.06\times10^{-5}\)이고 \((0.986013 - c_4)^2 = 4.72\times10^{-5}\)로 \(7\%\)밖에 다르지 않다. 두 거리가 거의 같으니 MSE 도 거의 같고, 소수 셋째 자리에서는 아예 구별되지 않는다.
그리고 세 번째 줄이 덧붙이는 것이 있다. MSE 를 가장 작게 하는 배수는 \(a = c_4\), 곧 \(c_4 S\)이며 이는 \(\sigma\)를 더 낮추어 잡는 추정량이다. 그 RMSE 조차 \(0.413\%\)라 나머지 둘과 다르지 않다. \((a-c_4)^2\) 항이 \(1 - c_4^2 = 0.0142\)에 견주어 \(300\)배 작기 때문이고, \(n = 36\)쯤 되면 분모를 어떻게 고르든 추적오차 추정의 품질은 \(S\) 자체의 변동이 정한다.
모의실험과 맞춰 본다.
def tracking_error_estimation(seed=42):
    """추적오차 추정에서 ddof 선택이 실제로 얼마나 차이를 내는지 본다.

    추적오차는 펀드 수익률과 지수 수익률의 차이가 갖는 표준편차다. 3년치
    월별 자료면 n=36 이라 두 분모의 차이가 눈에 띄는 크기로 남는다.
    편향이 작은 쪽과 RMSE 가 작은 쪽이 갈리는 점도 함께 본다.
    """
    rng = np.random.default_rng(seed)
    n_months = 36            # 3년치 월별 자료
    te_true_monthly = 0.01
    te_true_annual = te_true_monthly * np.sqrt(12)
    n_sim = 50_000

    te_n, te_n1 = [], []
    for _ in range(n_sim):
        excess = rng.normal(0.002, te_true_monthly, n_months)
        te_n.append(np.std(excess, ddof=0) * np.sqrt(12))
        te_n1.append(np.std(excess, ddof=1) * np.sqrt(12))

    te_n, te_n1 = np.array(te_n), np.array(te_n1)
    for name, est in [('ddof=0', te_n), ('ddof=1', te_n1)]:
        print(f"{name:<10} Mean={est.mean()*100:.3f}%  "
              f"Bias={(est.mean()-te_true_annual)*100:.3f}%  "
              f"RMSE={np.sqrt(np.mean((est-te_true_annual)**2))*100:.3f}%")
    print(f"True TE: {te_true_annual*100:.3f}%")
tracking_error_estimation()
출력:
ddof=0     Mean=3.392%  Bias=-0.072%  RMSE=0.413%
ddof=1     Mean=3.440%  Bias=-0.024%  RMSE=0.413%
True TE: 3.464%
(1)의 표와 네 수가 모두 맞는다. 평균 \(3.392\%\) 대 이론 \(3.391\%\), \(3.440\%\) 대 \(3.439\%\)이고, RMSE 는 양쪽 \(0.413\%\)로 이론과 소수 셋째 자리까지 같다. 5만 번에서 평균의 몬테카를로 표준오차가 \(0.413/\sqrt{50000} = 0.0018\%\)이므로 \(0.001\%\)의 불일치는 \(0.5\) 표준오차다.
# (1) 의 MSE 식이 맞는지, 배수 a 를 바꿔 가며 직접 확인한다.
from scipy.special import gammaln

n, sig, ann = 36, 0.01, np.sqrt(12)
c = np.sqrt(2/(n-1)) * np.exp(gammaln(n/2) - gammaln((n-1)/2))
true = sig * ann
print(f"c4(36) = {c:.6f},  √(35/36) = {np.sqrt((n-1)/n):.6f},  참 TE = {true*100:.3f}%")
print(f"{'배수 a':>10} {'E[TE]':>9} {'편향':>9} {'sd':>8} {'RMSE':>8} {'(a-c4)²':>10}")
for name, a in [("√(35/36)", np.sqrt((n-1)/n)), ("1", 1.0), ("c4", c)]:
    mean = a * c * true
    bias = mean - true
    sd = a * true * np.sqrt(1 - c**2)
    print(f"{name:>10} {mean*100:>8.3f}% {bias*100:>+8.3f}% {sd*100:>7.3f}% "
          f"{np.sqrt(bias**2 + sd**2)*100:>7.3f}% {(a-c)**2:>10.2e}")
출력:
c4(36) = 0.992884,  √(35/36) = 0.986013,  참 TE = 3.464%
      배수 a     E[TE]        편향       sd     RMSE    (a-c4)²
  √(35/36)    3.391%   -0.073%   0.407%   0.413%   4.72e-05
         1    3.439%   -0.025%   0.413%   0.413%   5.06e-05
        c4    3.415%   -0.049%   0.410%   0.413%   0.00e+00
마지막 열이 (2)의 답을 그림처럼 보여 준다. \(\texttt{ddof=0}\) 과 \(\texttt{ddof=1}\) 의 \((a - c_4)^2\)가 \(4.72\)와 \(5.06\)으로 거의 같고, 그래서 세 RMSE 가 모두 \(0.413\%\)다.
그러니 분모 논쟁은 이 자리에서 실속이 없다. 셋 다 참값을 \(0.4\%\)p 안팎으로 빗나가는데, 그 \(0.4\%\)p는 어느 분모를 골라서 생긴 것이 아니라 \(36\)개월이 짧아서 생긴 것이다. 참 추적오차가 \(3.46\%\)인데 추정값이 \(3.46 \pm 0.41\%\)로 나오니, 추적오차 \(3.0\%\)인 펀드와 \(3.9\%\)인 펀드를 \(3\)년 성과로는 가를 수 없다.
그럼에도 \(\texttt{ddof=1}\) 을 쓰는 까닭은 편향 쪽에 있다. 펀드 수백 개의 추적오차를 모두 \(\texttt{ddof=0}\) 으로 재면 산포는 평균 내어 지워지지만 \(-0.073\%\)p의 편향은 그대로 남아, 업계 전체의 추적오차가 체계적으로 낮게 보고된다. 한 펀드를 볼 때는 어느 쪽이든 괜찮고, 많은 펀드를 모을 때는 그렇지 않다.
읽는 법 — 불편성과 독립성은 다른 가정에 기댄다
- 베셀 수정은 임의의 분포에서 \(\sigma^2\)의 불편 추정량을 주지만, \(\chi^2\) 분포 결과에는 정규성이 필요하다.
- \(\bar{X}\)와 \(S^2\)의 독립성은 정규모집단에만 해당하며 스튜던트 \(t\) 검정의 핵심 재료이다.
- \(S^2\)이 불편이라고 해서 \(S\)가 불편인 것은 아니다. 옌센 부등식 때문에, 특히 작은 \(n\)에서 \(S\)는 \(\sigma\)를 과소추정한다.
- 조용한 오류를 피하려면 NumPy의
ddof매개변수를 항상 명시하라. - 금융에서 짧은 구간으로 추적오차를 추정할 때는 베셀 수정의 이득이 의미 있다.
연습문제
연습문제 1. 정규 자료에서 \(S^2\)의 카이제곱분포. (a) \((n-1)S^2/\sigma^2 \sim \chi^2_{n-1}\)임을 보여라. (b) \(n = 20, S^2 = 16\)일 때 \(\sigma^2\)의 95% 신뢰구간. (c) 왜 비대칭인가?
풀이
(a) \(\sum(X_i - \bar X)^2/\sigma^2 = \sum(X_i - \mu)^2/\sigma^2 - n(\bar X - \mu)^2/\sigma^2\). 첫 항은 \(\chi^2_n\), 둘째 항은 \(\chi^2_1\)이며 (코크런 정리에 의해) 서로 독립이다. 따라서 그 차이는 \(\chi^2_{n-1}\)이다.
(b) \(\chi^2_{0.025,\,19} = 8.907\), \(\chi^2_{0.975,\,19} = 32.852\). 신뢰구간: \((19 \cdot 16/32.852, 19 \cdot 16/8.907) = (9.25, 34.13)\).
(c) 카이제곱분포는 오른쪽으로 치우쳐 있어 분위수(quantile)가 비대칭이다. 상한이 하한보다 \(S^2\)에서 멀다. \(n \to \infty\)이면 비대칭성이 줄어든다(표준정규 제곱에 중심극한정리(central limit theorem)를 적용하면 카이제곱이 정규에 가까워진다).
연습문제 2. \(S\)의 편향. (a) \(\mathbb{E}[S] < \sigma\)인 이유. (b) \(n = 5\)일 때 \(c_4\)를 계산하라. (c) 실무에서 쓰이는가?
풀이
(a) \(\sqrt{\cdot}\)는 오목이다. 옌센: \(\mathbb{E}[\sqrt{S^2}] < \sqrt{\mathbb{E}[S^2]} = \sigma\). \(S^2\)의 분산이 0이 아니므로 부등호는 엄격하다.
(b) \(c_4 = \sqrt{2/(n-1)} \cdot \Gamma(n/2)/\Gamma((n-1)/2)\). \(n = 5\)일 때: \(c_4 = \sqrt{2/4} \cdot \Gamma(2.5)/\Gamma(2) = (1/\sqrt 2) \cdot (3\sqrt\pi/4)/1 \approx 0.940\).
편향 보정 표준편차: \(S/c_4\).
(c) 거의 쓰이지 않는다. 편향이 작기 때문이다(\(n = 5\)에서 약 6%, \(n \ge 30\)에서 1% 미만). 통계적 공정관리의 슈하트(Shewhart) 관리도는 \(c_4\)를 쓰지만, 다른 대부분의 응용에서는 보정하지 않은 \(S\)를 보고한다.
연습문제 3. 실현변동성. 하루에 5분 수익률 78개. (a) 소박한 추정량의 편향 비율. (b) 베셀 수정이 중요한가? (c) 21일 이동창은?
풀이
(a) 소박한 추정량의 편향 = \(-\sigma^2/n = -\sigma^2/78\)로 참 분산의 약 \(-1.3\%\). 무시할 만하다.
(b) 베셀 수정의 인자는 \(78/77 \approx 1.013\)이다. 미시구조 잡음이나 일중 변동성 패턴보다 작다. 중요하지 않다.
(c) 21일 이동창은 일별 분산추정값 21개이다. 평균 분산추정값의 표준오차: \(\sqrt{2 \sigma^4/(n_{\text{day}} - 1)}/\sqrt{21}\). 트레이드오프(trade-off): 추정값이 매끄러워지지만 변동성 국면 전환을 평균 10일 뒤늦게 반영한다. 국면 전환의 반감기: 약 10일.
연습문제 4. 베셀 수정의 일반화. 모수가 \(p\)개인 회귀에서 잔차분산추정량은 \(n - p\)로 나눈다. 왜인가?
풀이
잔차 \(e_i = Y_i - \hat Y_i\)는 선형 제약(정규방정식(normal equations): \(\mathbf X^\top \mathbf e = 0\))을 만족한다. \(\mathbf X\)의 열이 \(p\)개이므로 선형 제약이 \(p\)개이고, 유효 자유도는 \(n - p\)가 남는다.
\(\mathbb{E}[\mathrm{SSE}/\sigma^2] = n - p\)이다(정규성 아래에서 카이제곱분포). 따라서 \(\hat\sigma^2 = \mathrm{SSE}/(n - p)\)는 불편이다.
베셀 수정의 일반화이다: \(n - 1\)은 \(p = 1\)(절편(intercept)만)인 경우이다.
t-검정/F-검정과의 연결: 자유도가 \(n - p\)인 잔차분산이 적절한 \(t\) 임계값(자유도 \(= n - p\))을 결정한다.
연습문제 5. 하필 \(n - 1\)로 나누는 이유는? 다른 분모를 정당화할 수 있는가?
풀이
불편성: \(n - 1\)은 \(S^2\)을 불편으로 만드는 유일한 분모이다.
평균제곱오차 최적: \(n + 1\)이 평균제곱오차를 최소화한다(앞 절의 연습문제).
MLE: (정규 자료에서) \(n\)이 MLE의 분모이다.
\(n - 1\)의 정당화: 불편성은 "깔끔한" 성질이다 — 불편추정량들의 평균은 불편이고, 기댓값은 해석하기 쉽다. 평균제곱오차 최적은 아니지만 통계학의 관례는 \(n - 1\)을 선호한다.
분야마다 선택이 다르다.
- 공학 / 통계적 공정관리: 표본분산에 \(n - 1\), 표준편차에 \(c_4\) 보정.
- 기계학습: 편향을 신경 쓰지 않고 흔히 \(n\)(MLE)을 쓴다.
- 베이즈: \(\chi^2_{n-1}\)에 기반한 사후 신용구간.
- 로버스트 통계: 중앙값 절대편차 — 분모 선택이 무관하다.
연습문제 6. 아주 작은 표본에서는 편향 보정이 중요하지만 큰 표본에서는 그렇지 않은 이유. \(n = 3, 10, 100\)으로 구체적으로 보여라.
풀이
소박한 추정량과 불편추정량의 차이: \(\hat\sigma^2_{\text{naive}}/\hat\sigma^2_{\text{unbiased}} = (n-1)/n\).
| \(n\) | \((n-1)/n\) | 차이 |
|---|---|---|
| 3 | 0.667 | 33% |
| 10 | 0.900 | 10% |
| 100 | 0.990 | 1% |
| 1000 | 0.999 | 0.1% |
\(n = 3\)일 때: 베셀 수정을 빠뜨리면 분산을 1/3만큼 과소추정한다 — 심각한 오류이다.
\(n = 100\)일 때: 1% — 대부분의 측정에서 반올림 오차 수준이다. 베셀 수정은 거의 관례에 가깝다.
실무적 함의: 작은 표본(30 미만)에서는 항상 베셀 수정을 쓰라. 큰 표본(100 초과)에서는 선택이 거의 학술적이다. 실제 자료의 잡음이 이 작은 편향 보정을 대개 압도한다.
연습문제 7. 베셀 수정은 평균을 추정했기 때문에 필요하다. 평균 대신 중앙값을 중심으로 편차를 재면 분모를 어떻게 해야 하는가? 일반적인 답이 있는가?
풀이
왜 \(n-1\)인가 다시 보기. \(\sum(X_i-\bar X)^2\)의 기댓값이 \((n-1)\sigma^2\)인 것은 \(\bar X\)가 그 제곱합을 최소로 하는 값이기 때문이다. 어떤 고정된 \(c\)에 대해서도
이고, 그 "절약된" 양이 정확히 \(n(\bar X-\mu)^2\)이며 기댓값이 \(\sigma^2\)이다. 자유도 하나를 잃는다.
중앙값으로 바꾸면. \(\sum(X_i-\tilde X)^2\)은 \(\sum(X_i-\bar X)^2\)보다 크다. 중앙값은 제곱합이 아니라 절대편차합을 최소로 하기 때문이다. 따라서
이고, 정규분포에서 계산하면 \(n\)이 클 때 대략
이다. \(\bar X\) 대신 \(\tilde X\)를 쓴 대가로 \(\pi/2-1 \approx 0.571\)만큼 더 늘어난다(\(\tilde X\)의 점근분산이 \(\pi\sigma^2/(2n)\)이므로).
일반적인 답은 없다. 보정 인수가
- 모집단 분포에 의존한다(위 계산은 정규 가정).
- 표본크기에 의존한다(점근이 아니라 유한표본에서는 더 복잡).
즉 \(n-1\)처럼 분포와 무관한 깔끔한 보정이 존재하지 않는다.
실무적 함의.
- 중심을 중앙값으로 바꾸면서 분산은 제곱편차로 재는 혼합 방식은 권장되지 않는다. 중심과 척도를 일관되게 고르는 편이 낫다.
- 로버스트 중심을 쓰려면 로버스트 척도를 함께 쓴다. 중앙값 + MAD가 자연스러운 짝이고, 그때 보정 인수 1.4826이 정규분포에서의 일치성을 준다.
- 일반적으로 "자유도 \(n-k\)"라는 규칙이 성립하는 것은 최소제곱 계열에서뿐이다. 최대가능도나 로버스트 추정에서는 편향 보정을 따로 유도하거나 부트스트랩(bootstrap)에 맡겨야 한다.
연습문제 8. \(\sigma^2\)이 아니라 \(\sigma\)를 보고해야 할 때 베셀 수정만으로는 부족하다. 필요한 추가 보정과 그 크기를 적어라.
풀이
문제. \(E[S^2]=\sigma^2\)이지만 \(E[S] \ne \sigma\)다. 제곱근이 오목함수이므로 옌센 부등식에서
로 과소추정한다.
보정 인수. 정규모집단에서
이므로 \(S/c_4\)가 불편이다.
| \(n\) | \(c_4\) | 편향 |
|---|---|---|
| 2 | 0.7979 | \(-20.2\%\) |
| 5 | 0.9400 | \(-6.0\%\) |
| 10 | 0.9727 | \(-2.7\%\) |
| 25 | 0.9896 | \(-1.0\%\) |
| 50 | 0.9949 | \(-0.5\%\) |
근사 공식. \(c_4 \approx 1-\dfrac{1}{4(n-1)}\)로, \(n\ge10\)이면 소수 넷째 자리까지 맞는다. 편향이 대략 \(-1/\{4(n-1)\}\)이다.
언제 중요한가.
- \(n\)이 아주 작을 때. \(n=2\)면 20%나 된다. 쌍 자료나 반복 측정이 두 번뿐인 경우.
- 여러 작은 표본의 \(s\)를 평균낼 때. 편향이 상쇄되지 않고 그대로 쌓인다. 관리도에서 부분군별 \(s\)를 평균해 \(\bar s/c_4\)로 \(\sigma\)를 추정하는 관행이 이 때문이다.
- 공정능력지수 계산. \(C_p = (\text{USL}-\text{LSL})/(6\sigma)\)에서 \(\sigma\)를 과소추정하면 \(C_p\)를 과대평가해 공정이 실제보다 좋아 보인다.
언제 무시해도 되는가. \(n\ge25\)면 1% 미만이라 실무적으로 무의미하다. 게다가 \(S/c_4\)는 불편이지만 평균제곱오차는 \(S\)보다 클 수 있다. 편향을 없애면서 분산이 늘기 때문이다.
주의. \(c_4\)는 정규모집단 공식이다. 다른 분포에서는 값이 다르며, 일반적인 보정 인수는 존재하지 않는다.
연습문제 9. 여러 표본의 분산을 합칠 때 베셀 수정이 어떻게 작용하는지 설명하라. 합동분산(pooled variance)의 분모가 \(\sum(n_i-1)\)인 이유는?
풀이
합동분산.
여기서 \(N=\sum n_i\)다.
왜 \(N-k\)인가. 집단마다 평균을 하나씩 추정했으므로 자유도를 \(k\)개 잃는다. 각 집단에서 \(n_i-1\)씩 남고 그 합이 \(N-k\)다.
불편성. 각 \(s_i^2\)이 불편이므로
로 어떤 \(\{n_i\}\)에서도 불편이다.
왜 자유도로 가중하는가. 정규모집단에서 \(\operatorname{Var}(s_i^2)=2\sigma^4/(n_i-1)\)이므로 정밀도가 자유도에 비례한다. 앞서 본 정밀도 가중 원리에 따라 자유도 가중이 최소분산을 준다.
단순평균 \(\frac1k\sum s_i^2\)도 불편이지만 분산이 더 크다. \(n_i\)가 크게 다를수록 차이가 벌어진다.
일반화. 같은 원리가 곳곳에 나타난다.
| 맥락 | 분모 |
|---|---|
| 한 표본 | \(n-1\) |
| \(k\)개 집단(분산분석 MSE) | \(N-k\) |
| 회귀(\(p\)개 모수) | \(n-p\) |
| 이원배치 분산분석 | \(N-(\text{모수 수})\) |
한 문장으로. 자료에서 추정한 모수 하나마다 자유도를 하나씩 뺀다. 이것이 "자유도"라는 개념의 실용적 정의이며, 분산 추정을 불편으로 만드는 장치다.
주의. 합동분산은 모든 집단의 참 분산이 같다는 가정 위에 있다. 그렇지 않으면 \(s_p^2\)이 무엇을 추정하는지 불분명해지고, 앞서 본 대로 스튜던트 \(t\) 검정의 오류율이 어긋난다. 등분산이 의심스러우면 합동하지 않는 웰치식 접근을 쓴다.
연습문제 10. 베셀 수정이 불편성을 주지만 평균제곱오차를 최소로 하지는 않는다. 이 긴장을 정리하고, 실무에서 \(n-1\)이 표준으로 남은 이유를 적어라.
풀이
세 후보의 비교(정규모집단, \(\hat\sigma^2_c = \text{SS}/c\)).
| \(c\) | 편향 | MSE(\(\sigma^4\) 단위) | \(n=10\) |
|---|---|---|---|
| \(n-1\) | 0 | \(2/(n-1)\) | 0.2222 |
| \(n\) | \(-\sigma^2/n\) | \((2n-1)/n^2\) | 0.1900 |
| \(n+1\) | \(-2\sigma^2/(n+1)\) | \(2/(n+1)\) | 0.1818 |
불편추정량이 셋 중 가장 나쁘다. MSE 기준으로는 \(n+1\)이 최적이다.
그럼에도 \(n-1\)이 표준인 이유.
-
불편성이 결합될 때 좋은 성질을 준다. 합동분산, 분산분석표, 변량효과 모형에서 여러 분산 추정값을 더하고 나눈다. 불편이면 그 조합도 불편이지만, 편향이 있으면 누적되고 상쇄되지 않는다.
-
\(n+1\)의 최적성은 정규 가정에 의존한다. 앞서 본 대로 일반 모집단에서 최적 \(c\)는 첨도(kurtosis)에 의존해 \(c^* \approx n+1+n\gamma_2/2\)다. 꼬리가 두꺼우면 \(n+1\)도 부족하고 가벼우면 과하다. 분포에 무관하게 불편인 \(n-1\)이 더 보편적이다.
-
차이가 빠르게 사라진다. \(n=10\)에서도 MSE 차이가 18%이고, \(n=50\)이면 4%다. 실무적으로 대개 무시할 만하다.
-
해석과 소통. "\(n-1\)로 나눈다"는 규칙이 자유도라는 일관된 개념으로 설명되고, 회귀·분산분석과 통일된다. \(n+1\)은 그런 해석이 없다.
-
관습의 힘. 모든 소프트웨어의 기본값(R의
var, NumPy의ddof=1관행)이고, 교과서와 논문이 이를 전제한다. 바꾸면 비교와 재현이 어려워진다.
한 문장으로. \(n-1\)은 MSE 최적이 아니지만, 분포에 무관하고 조합에 안전하며 해석이 일관되다는 점에서 더 나은 기본값이다. MSE가 정말 중요한 특수한 상황(단일 추정, 정규성 확신, 작은 \(n\))에서는 \(n+1\)이나 축소 추정을 고려할 수 있다.
연습문제 11. \(X_i \sim N(\mu, \sigma^2)\)일 때 제곱합을 독립인 표준정규들로 표현하여 \(\frac{(n-1)S^2}{\sigma^2} \sim \chi^2_{n-1}\)임을 보여라.
풀이
\(Z_i = (X_i - \mu)/\sigma \sim N(0,1)\)이 i.i.d.라 하자. 그러면 이렇게 된다.
여기서 \(\bar{Z} = \frac{1}{n}\sum Z_i\)이다. 이제 \(\sum Z_i^2 \sim \chi^2_n\)이고, \(\sqrt{n}\bar{Z} \sim N(0,1)\)이므로 \(n\bar{Z}^2 = \left(\sqrt{n}\bar{Z}\right)^2 \sim \chi^2_1\)이다.
이 이차형식들이 \(\mathbb{R}^n\)을 차원 \(n-1\)과 \(1\)인 서로 보완적인 부분공간으로 직교분해한 것에 기반하므로, 코크런 정리에 의해 이렇게 된다.
이고 두 성분은 독립이다. 따라서 \((n-1)S^2/\sigma^2 \sim \chi^2_{n-1}\)이다. \(\square\)
연습문제 12. 옌센 부등식을 써서 \(E[\sqrt{S^2}] < \sigma\)인 이유를 설명하라. \(n = 5\)인 정규 자료에서 \(c_4\)의 정확한 값과 \(\sigma\)의 추정량으로서 \(S\)의 백분율 편향을 계산하라.
풀이
옌센 부등식은 (\(g(x) = \sqrt{x}\) 같은) 오목함수 \(g\)에 대해
임을 말하며, \(X\)가 퇴화되어 있지 않으면 부등호가 엄격하다. 이를 \(S^2\)에 적용하면 이렇게 된다.
\(n = 5\)이면 이렇게 된다.
계산하면 \(\Gamma(5/2) = \frac{3}{2}\cdot\frac{1}{2}\cdot\sqrt{\pi} = \frac{3\sqrt{\pi}}{4}\)이고 \(\Gamma(2) = 1! = 1\)이다.
백분율 편향은 \((c_4 - 1) \times 100\% \approx -6.0\%\)이다. 즉 \(n = 5\)일 때 \(S\)는 평균적으로 \(\sigma\)를 약 6% 과소추정한다. \(\square\)
연습문제 13.
어떤 포트폴리오 추적자가 36개월치 초과수익률을 갖고 있다. ddof=1로 추정한 연율화 추적오차가 3.8%이다. 정규성을 가정하고 참 연율화 추적오차의 95% 신뢰구간을 구성하라.
풀이
월별 추적오차 추정값: \(\hat{\sigma}_m = 3.8\%/\sqrt{12} \approx 1.097\%\). 표본분산은 \(\hat{\sigma}_m^2\)이다.
\(n = 36\)개월, 자유도 \(\nu = n - 1 = 35\)일 때 이렇게 된다.
\(\sigma_m^2\)의 95% 신뢰구간은 이렇게 된다.
\(\chi^2_{0.975,\,35} = 53.20\), \(\chi^2_{0.025,\,35} = 20.57\)을 쓰면 이렇게 된다.
제곱근을 취하고 연율화하면(\(\sqrt{12}\)를 곱하면):
구간이 넓은데, 이는 3년치 월별 자료만으로 얻은 변동성 추정값이 얼마나 부정확한지를 보여준다. \(\square\)
연습문제 14. 자유도의 "일반 원리"를 설명하라: 모수가 \(k\)개인 모형을 적합한 뒤 분산을 추정할 때는 \(n - k\)로 나눈다. 예를 세 가지 들라.
풀이
일반 원리: 추정한 모수가 \(k\)개인 모형을 적합하면 잔차에 \(k\)개의 제약이 걸린다(\(k=1\)일 때의 \(\sum(X_i - \bar{X}) = 0\)과 같은 꼴이다). 잔차의 자유도는 \(n - k\)뿐이므로 잔차제곱합을 \(n - k\)로 나누면 불편 분산추정값을 얻는다.
예 1: 일표본 분산. \(k = 1\)(\(\bar{X}\)로 \(\mu\)를 추정)이면 제약이 \(\sum(X_i - \bar{X}) = 0\)이고 \(n - 1\)로 나눈다.
예 2: 단순선형회귀. \(Y_i = \beta_0 + \beta_1 x_i + \epsilon_i\)에서는 모수 \(k = 2\)개를 추정한다. 잔차분산은 이렇게 된다.
예 3: 예측변수가 \(p\)개인 다중회귀(multiple regression). \(\mathbf{Y} = \mathbf{X}\boldsymbol{\beta} + \boldsymbol{\epsilon}\)에서 (절편을 포함하여) 계수가 \(k = p\)개이면 이렇게 된다.
각 경우에 분모는 잔차공간(설계행렬의 열공간의 직교여공간)의 차원과 같으며, 이것이 불편성을 보장한다. \(\square\)
연습문제 15. \(\operatorname{Var}(S^2)\)이 정규모집단에서 \(2\sigma^4/(n-1)\)이지만 일반적으로는 첨도에 의존한다. 일반 공식을 쓰고, 금융 수익률처럼 첨도가 큰 자료에서 변동성 추정의 불확실성이 얼마나 커지는지 계산하라.
풀이
일반 공식.
이고 \(\gamma_2\)는 초과첨도다. 정규분포(\(\gamma_2=0\))에서 \(2\sigma^4/n\)으로 돌아온다.
금융 수익률. 일별 주가 수익률의 초과첨도는 흔히 5~10이다. \(\gamma_2=6\)이라 하면
분산이 네 배, 표준오차가 두 배다.
상대 표준오차.
| \(n\)(거래일) | 정규 가정 | \(\gamma_2=6\) |
|---|---|---|
| 21(1개월) | 31% | 62% |
| 63(3개월) | 18% | 36% |
| 252(1년) | 8.9% | 17.8% |
1개월 자료로 변동성을 추정하면 60% 넘게 흔들린다. 연율화 변동성이 20%로 나왔어도 실제로는 8%일 수도 32%일 수도 있다.
실무적 함의.
- 변동성 추정에는 긴 기간이 필요하다. 정규 가정으로 계산한 표본크기는 절반 이하로 과소평가한 것이다.
- 고빈도 자료가 도움이 된다. 앞서 본 대로 평균과 달리 변동성은 관측 수에 직접 의존하므로, 5분 수익률로 계산한 실현변동성이 일별보다 훨씬 정밀하다.
- 변동성의 변동성을 무시하면 안 된다. VaR나 옵션 가격이 \(\hat\sigma\)에 민감한데, \(\hat\sigma\) 자체의 불확실성이 크면 그 결과도 크게 흔들린다.
연습문제 16. \(\bar X\)와 \(S^2\)이 정규모집단에서만 독립이다. 지수분포에서 \(\operatorname{Cov}(\bar X, S^2)\)을 구하고, 이 종속성이 \(t\) 통계량에 어떤 영향을 주는지 설명하라.
풀이
일반 공식.
여기서 \(\mu_3 = E[(X-\mu)^3]\)는 3차 중심적률이다. 정규분포에서는 \(\mu_3=0\)이라 공분산이 0이고, 정규분포에서만 무상관이 곧 독립이 되어 완전한 독립이 따라 나온다.
지수분포. \(\text{Exp}(\lambda)\)에서 \(\mu_3 = 2/\lambda^3\)이므로
양의 상관이다. 상관계수를 계산하면(\(\operatorname{Var}(\bar X)=1/(n\lambda^2)\), \(\operatorname{Var}(S^2)\approx8/(n\lambda^4)\))
로 대단히 높다.
\(t\) 통계량에 미치는 영향.
에서 분자와 분모가 양으로 상관되어 있다. \(\bar X\)가 우연히 크게 나온 표본에서는 \(S\)도 함께 크게 나와 분자의 증가를 상쇄한다. 반대로 \(\bar X\)가 작으면 \(S\)도 작아 \(t\)가 과장된다.
그 결과 \(t\)의 분포가 왼쪽으로 치우친다(오른쪽으로 치우친 모집단에서). 앞서 본 대로
- 단측 검정의 오류율이 한쪽으로 쏠린다.
- 왜도가 만드는 오차가 \(O(n^{-1/2})\)로 첨도의 \(O(n^{-1})\)보다 크다.
왜 정규분포가 특별한가. \(\bar X \perp S^2\)은 정규분포를 특징짓는 성질이다(루카치의 정리, Lukacs 1942). 따라서 \(t_{n-1}\) 분포의 정확성은 정규성과 논리적으로 동치이며, 다른 분포에서는 근사일 수밖에 없다.
대처. 치우친 자료에서는 변환(로그), 부트스트랩-\(t\), 존슨의 왜도 보정 \(t\), 또는 순열검정(permutation test)을 쓴다.
연습문제 17. 변동성의 신뢰구간을 카이제곱으로 만들 때 정규성 가정이 깨지면 얼마나 어긋나는지 논하고, 대안을 적어라.
풀이
카이제곱 구간. 정규 가정 아래에서
어긋나는 정도. 이 구간의 폭은 \(\operatorname{Var}(S^2)=2\sigma^4/(n-1)\)을 전제한다. 실제 분산이 \((\gamma_2+2)/2\)배이므로, 구간의 폭이 \(\sqrt{(\gamma_2+2)/2}\)배만큼 좁다.
\(\gamma_2=6\)이면 실제로 필요한 폭의 절반이다. 명목 95% 구간의 실제 포함확률을 모의실험으로 재면 70~80% 수준으로 떨어진다.
더 나쁜 점. 이 불일치는 \(n\)을 키워도 사라지지 않는다. 카이제곱 구간이 잘못된 분산을 쓰고 있기 때문이며, \(n\to\infty\)에서도 포함확률이 명목값으로 수렴하지 않는다. 평균에 대한 \(t\) 구간이 중심극한정리로 구제되는 것과 대조적이다.
대안.
- 첨도를 반영한 정규근사.
$$ s^2 \pm z_{0.975}\,s^2\sqrt{\frac{\hat\gamma_2+2}{n}} $$
\(\hat\gamma_2\)를 표본에서 추정한다. 간단하지만 \(\hat\gamma_2\) 자체가 불안정하다(4차 적률이 필요하고, 그 분산에는 8차 적률이 필요하다).
-
로그 척도. \(\ln s^2\)의 점근분산이 \((\gamma_2+2)/n\)으로 \(\sigma\)에 무관하므로, 로그 척도에서 대칭 구간을 만들고 되돌린다. 비대칭 구간이 자동으로 나오고 양수가 보장된다.
-
부트스트랩. 가장 실용적이다. BCa 구간이 왜도까지 보정한다. \(n\)이 작으면 성능이 떨어지지만 카이제곱보다는 낫다.
-
모형을 바꾼다. 수익률이라면 \(t\) 분포나 GARCH를 적합해 그 안에서 변동성을 추정한다. 이상치(outlier)를 잡음으로 처리하는 대신 모형에 담는 접근이다.
권고. 정규성을 확신할 수 없으면 카이제곱 구간을 쓰지 않는다. 분산 추론은 평균 추론보다 정규성에 훨씬 민감하다는 점을 기억해야 한다.
연습문제 18. 실현변동성과 표본표준편차의 관계를 설명하고, 고빈도 자료에서 시장 미시구조 잡음이 어떤 편향을 만드는지 적어라.
풀이
실현변동성. 하루를 \(M\)개 구간으로 나눠 구간별 수익률 \(r_j\)를 관측하면
가 그날의 변동성 추정값이다. 평균을 빼지 않는다는 점이 표본분산과 다르다. 일중 평균 수익률이 0에 가깝고 \(M\)이 크면 차이가 무시할 만하다.
왜 좋은가. 이론적으로 \(M\to\infty\)이면 RV가 적분변동성에 수렴한다.
변동성이 시간에 따라 변해도 그 적분을 일치성 있게(consistently) 추정한다. 일별 수익률 하나로는 불가능한 일이다. 정밀도가 \(O(M^{-1/2})\)로 개선되므로 5분 자료(\(M\approx78\))면 일별 자료보다 훨씬 낫다.
미시구조 잡음의 문제. 관측된 로그가격이
로 잡음을 담는다(호가 스프레드 반동, 가격 이산화, 비동기 거래). 그러면
으로 \(M\)에 비례하는 편향이 생긴다. 구간을 잘게 나눌수록 편향이 커진다.
트레이드오프. \(M\)을 키우면 분산은 줄지만 편향은 커진다. 최적 \(M\)이 존재하며, 실무에서 5분 간격이 널리 쓰이는 것이 이 절충의 경험적 결과다. 1초 간격을 쓰면 잡음이 신호를 압도한다.
잡음을 다루는 방법.
- 성긴 표본(sparse sampling). 그냥 5분이나 15분으로 늦춘다. 가장 단순하다.
- 이단계 실현변동성(TSRV). 서로 다른 빈도의 RV를 결합해 잡음 항을 상쇄한다.
- 실현커널. 자기공분산에 커널 가중치를 주어 편향을 제거한다. 현재 표준적인 방법이다.
- 사전 평균화. 인접 수익률을 평균해 잡음을 줄인 뒤 RV를 계산한다.
일반적 교훈. 관측 빈도를 높이는 것이 언제나 이득은 아니다. 신호 대비 잡음의 비가 빈도에 따라 달라지며, 그 구조를 모형에 넣지 않으면 더 많은 자료가 더 나쁜 추정을 낳는다.
연습문제 19. 분산을 추정할 때 자유도 개념이 회귀와 분산분석으로 어떻게 확장되는지 세 가지 예로 정리하라.
풀이
일반 원리. 자료에서 추정한 모수 하나마다 자유도를 하나 뺀다.
예 1 — 단순선형회귀. \(\hat y_i = \hat\beta_0+\hat\beta_1x_i\)로 모수 2개를 추정했으므로
\(n=2\)면 두 점을 지나는 직선이 유일하게 존재해 잔차가 모두 0이고 \(\hat\sigma^2\)이 정의되지 않는다. 자유도가 0이라는 사실이 "두 점으로는 산포를 알 수 없다"는 직관과 맞는다.
예 2 — 일원배치 분산분석(one-way analysis of variance). \(k\)개 집단의 평균을 추정했으므로
\(k=1\)이면 \(N-1\)로 보통의 표본분산이다. 집단이 늘수록 자유도를 더 잃는다.
예 3 — 평활 방법. 커널 회귀나 스플라인에서는 모수의 "개수"가 정수가 아니다. 유효 자유도를 모자행렬의 대각합으로 정의한다.
선형회귀에서는 \(\operatorname{tr}(H)=p\)로 정확히 모수 개수가 나오고, 능형회귀에서는 \(\sum_j d_j^2/(d_j^2+\lambda)\)로 \(\lambda\)에 따라 연속적으로 변하는 실수가 된다. 그러면
으로 같은 형태를 유지한다.
왜 이 확장이 중요한가. 유효 자유도 덕분에 모형 복잡도를 하나의 연속적인 수로 다룰 수 있고, AIC나 \(C_p\) 같은 기준을 정칙화 모형에 그대로 적용할 수 있다. 변수를 넣고 빼는 이산적 선택에서 벗어나 매끄러운 조절이 가능해진다.
주의. 유효 자유도의 정의가 하나만 있는 것은 아니다. \(\operatorname{tr}(H)\), \(\operatorname{tr}(HH^\top)\), \(2\operatorname{tr}(H)-\operatorname{tr}(HH^\top)\)이 각각 다른 맥락에서 쓰이며, 선형 평활자에서는 대개 비슷하지만 라소처럼 비선형인 경우에는 따로 유도해야 한다.
연습문제 20. 지수 자료 \(X_i \sim \text{Exp}(\lambda)\)에서 표본평균 \(\bar{X}\)와 표본분산 \(S^2\)이 독립이 아님을 증명하라. (힌트: 3차 중심적률을 써서 \(\text{Cov}(\bar{X}, S^2)\)을 계산하라.)
풀이
비율이 \(\lambda\)인 지수분포에서 \(\mu = 1/\lambda\), \(\sigma^2 = 1/\lambda^2\)이고 3차 중심적률은 \(\mu_3 = E[(X - \mu)^3] = 2/\lambda^3\)이다.
다음을 보일 수 있다.
이는 일반적인 결과이다. 증명은 다음을 쓴다.
\(S^2 = \frac{1}{n-1}\sum(X_i - \bar{X})^2\)을 전개하고 \(\bar{X} = \frac{1}{n}\sum X_i\)를 쓴 뒤 정리하면 이렇게 된다.
지수분포는 오른쪽으로 치우쳐 있어 \(\mu_3 \neq 0\)이므로 \(\text{Cov}(\bar{X}, S^2) \neq 0\)이고, 따라서 둘은 독립이 아니다.
정규분포에서는 (대칭이므로) \(\mu_3 = 0\)이어서 이 공분산이 0이다. 공분산이 0이라는 사실과 바탕 이차형식들의 결합정규성이 합쳐져 완전한 독립성을 준다. \(\square\)
정리하며
베셀 수정은 분모를 \(n-1\) 로 바꾸어 편향을 정확히 상쇄한다.
- 분산이 유한한 모든 분포에서 성립한다. 정규성은 필요 없다. 증명에 쓰이는 것은 \(\mathbb{E}[(X_i-\bar X)^2]\) 의 대수뿐이다.
- \(n-1\) 이 자유도다. 편차들이 합이 \(0\) 이라는 제약을 받아 독립적인 방향이 하나 줄어든 것이며, 부록 A에서 본 사영의 기하와 같은 이야기다.
- 소프트웨어 기본값이 갈린다.
numpy.var()는ddof=0(즉 \(n\))이고pandas.var()와 R 의var()는 \(n-1\) 이다. 같은 자료에서 다른 값이 나오므로 반드시 확인해야 한다. - \(S\) 는 \(\sigma\) 의 불편추정량이 아니다. 제곱근이 오목하므로 옌센 부등식에 의해 \(\mathbb{E}[S]<\sigma\) 다. 불편성은 제곱 척도에서만 성립하며 변환을 견디지 못한다.
- 불편이라고 최선은 아니다. 다음 절에서 보듯 MSE 를 기준으로 삼으면 \(n-1\) 이 이기지 못한다.
다음 절 분산추정량의 평균제곱오차로 넘어간다.